📄 论文信息
- 标题:RH20T: A Comprehensive Robotic Dataset for Learning Diverse Skills in One-Shot(RH20T:面向一次性学习多样技能的综合机器人数据集)
- 团队:上海交通大学(Hao-Shu Fang, Cewu Lu等)
- 发表:RSS 2023 Workshop / ICRA 2024 / arXiv 2023.07
- 关键词:多模态感知、接触丰富操作、一次性模仿学习、力觉感知、触觉感知
- 一句话总结:首个提供视觉-力觉-音频-触觉全模态、支持一次性模仿学习的大规模机器人操作数据集
- 论文链接:arXiv:2307.00595
- 代码链接:github.com/rh20t/rh20t_api
🤔 要解决什么问题?
机器人技能学习的瓶颈
在开放域机器人操作中,一个核心挑战是:如何让机器人获取多样化且可泛化的技能?
现有的机器人学习方法面临以下瓶颈:
任务简单化:
- 大多数研究集中在推、抓、放等简单任务
- 真实世界中的复杂技能(如插拔、组装、擦拭)被忽视
- 这些复杂技能往往需要视觉和触觉的协同感知
数据集局限性:
- 规模小:大多数数据集只有几千条轨迹
- 模态单一:主要提供RGB图像,缺少力觉、触觉等信息
- 任务有限:通常只覆盖10-30种简单任务
一次性模仿学习的需求:
- 希望机器人能从单个演示中学习新技能
- 这对数据集的多样性和丰富性提出了更高要求
- 需要人类演示视频作为任务描述
核心问题
论文试图解决的核心问题是:
如何构建一个大规模、多模态、任务多样的机器人操作数据集,以支持一次性模仿学习和多感知融合研究?
具体来说,需要满足:
- 任务多样性:覆盖从简单到复杂的各种操作技能
- 模态丰富性:提供视觉、力觉、音频、触觉等多模态信息
- 质量高:精确的传感器标定和时间同步
- 可复现:标准化的数据格式和工具
💡 核心方法
1. RH20T数据集设计
RH20T(Robot-Human demonstration in 20TB)的设计目标是实现通用机器人操作,即机器人能够基于任务描述(通常是人类演示视频)执行各种技能。
1.1 任务多样性
RH20T覆盖了147项任务,来源包括:
- RLBench:48项任务(如开门、放杯子、击打球等)
- MetaWorld:29项任务(如按按钮、推物体等)
- 自定义任务:70项任务(如插拔、组装、擦拭等接触丰富任务)
任务的复杂度从简单的单步操作(如按按钮)到复杂的多步骤任务(如插拔电源→开灯)不等。
1.2 机器人配置多样性
RH20T使用了7种机器人配置(Robot Cfg 1-7),涵盖:
- 6自由度和7自由度机械臂
- 不同的末端执行器(夹爪、吸盘等)
- 不同的力/力矩传感器
- 可选的指尖触觉传感器(Cfg 7)
1.3 模态丰富性
RH20T提供10种数据模态:
| 模态 | 尺寸 | 频率 |
|---|---|---|
| RGB图像 | 1280×720×3 | 10 Hz |
| 深度图像 | 1280×720 | 10 Hz |
| 双目红外图像 | 2×1280×720 | 10 Hz |
| 关节角度 | 6/7 | 10 Hz |
| 关节力矩 | 6/7 | 10 Hz |
| 末端执行器位姿 | 6/7 | 100 Hz |
| 夹爪宽度 | 1 | 10 Hz |
| 6DoF力/力矩 | 6 | 100 Hz |
| 音频 | N/A | 30 Hz |
| 指尖触觉 | 2×16×3 | 200 Hz |
这种多模态覆盖是RH20T的核心优势,特别是:
- 6DoF力/力矩:100Hz高频采集,对接触丰富任务至关重要
- 指尖触觉:200Hz采集,提供精细的触觉反馈
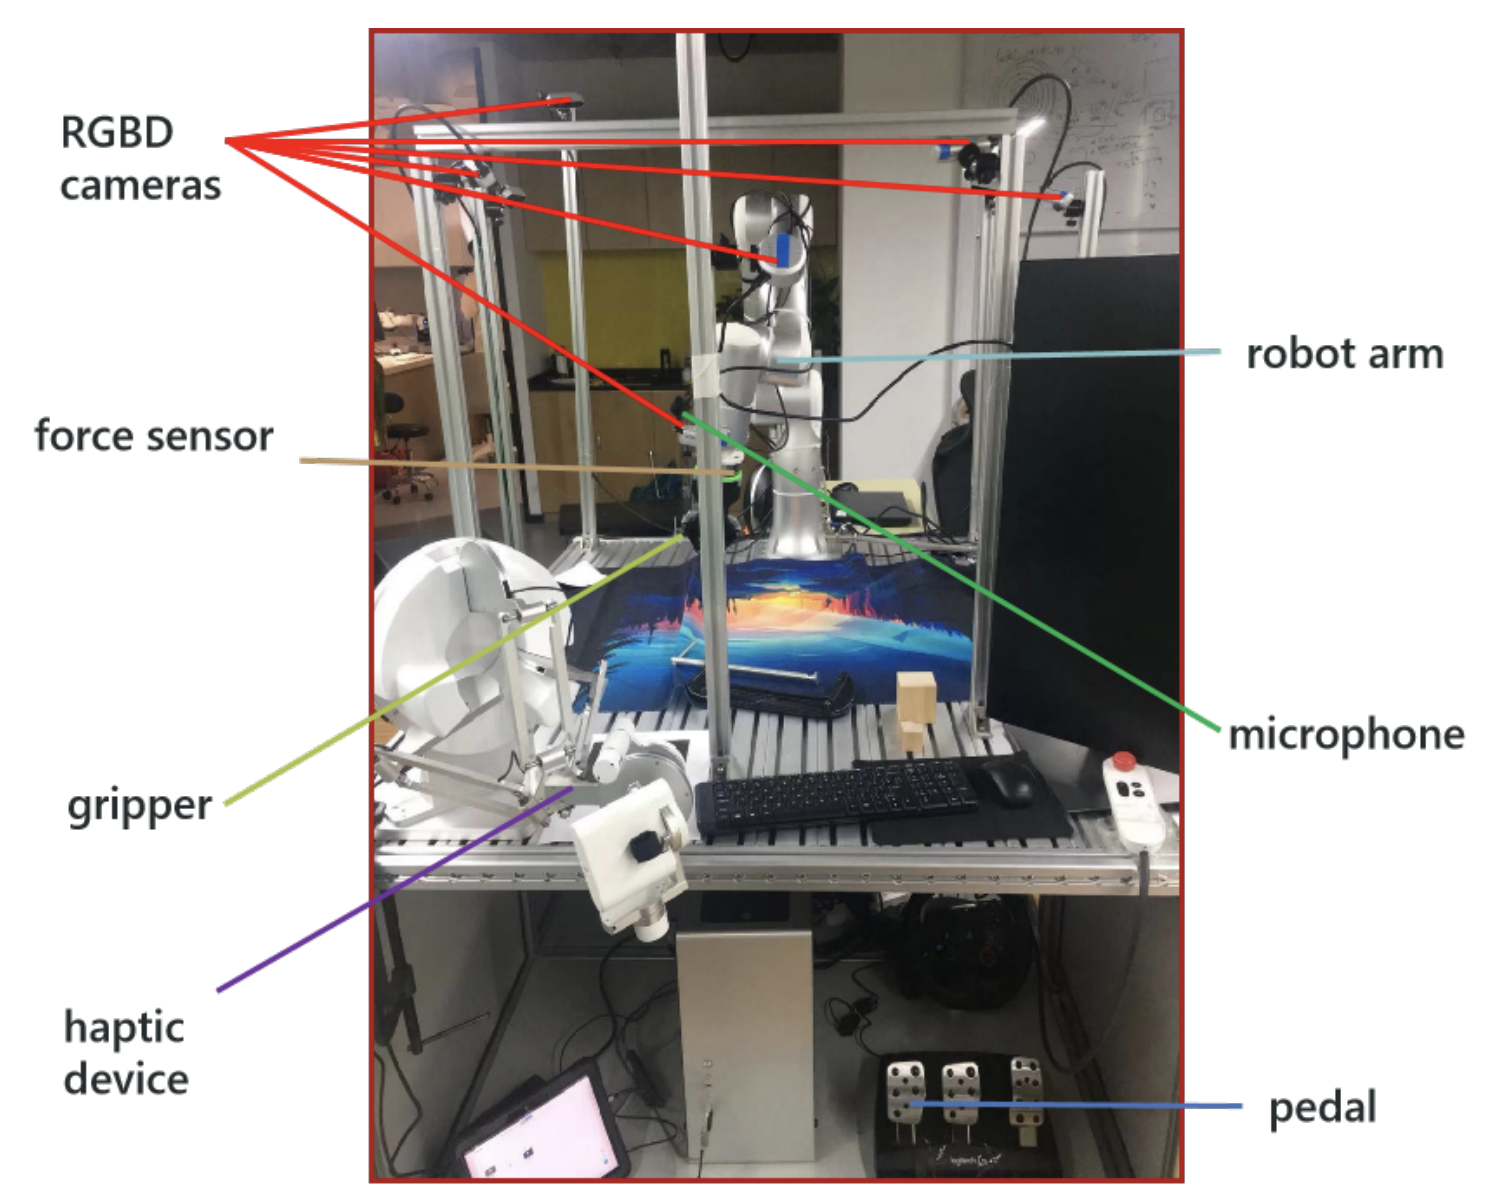
- 多视角相机:8-10个全局RGBD相机 + 1-2个手内相机
2. 一次性模仿学习框架
RH20T的一个重要设计目标是支持一次性模仿学习(One-Shot Imitation Learning):
2.1 任务层级结构
RH20T构建了任务层级树,其中:
- 叶节点是具体的机器人操作序列
- 共享祖先节点的任务具有相似性
- 可以构建数百万对
<人类演示, 机器人操作>数据对
这种层级结构使得:
- 可以从粗粒度到细粒度进行任务描述
- 支持组合性学习(短序列组合成长序列)
2.2 人类演示视频
每个机器人操作序列都配有:
- 人类演示视频:展示任务的执行过程
- 语言描述:自然语言的任务说明
- 质量评分:0-9分(0表示失败,2-9表示完成质量)
3. 数据采集与处理
3.1 直觉式遥操作
RH20T强调直觉式遥操作的重要性,采用:
- 力反馈设备:提供力觉反馈,增强操作直觉性
- 脚踏板:控制夹爪开合
- 多视角实时反馈:操作者可从多个角度观察
这种设计使得:
- 平均训练时间不到2小时
- 采集者能够执行复杂的接触丰富任务
- 成功与失败案例的比例约为10:1
3.2 精确标定
RH20T投入了大量精力进行传感器标定:
- 所有力/力矩传感器的零点校准
- 多相机系统的内外参标定
- 机器人模型在场景中的精确渲染
- 所有数据在时间域上同步
🧪 实验验证
实验设计
RH20T主要在一次性模仿学习场景下进行评估,验证数据集的有效性。
评估任务
论文选择了多种任务进行评估,包括:
- 简单任务:按按钮、推物体
- 中等任务:抓取放置、插拔
- 复杂任务:多步骤组装、擦拭
评估指标
- 成功率:任务完成的成功率
- 泛化能力:对新物体、新环境的泛化
- 多模态融合效果:力觉、触觉对性能的提升
实验结果
1. 一次性模仿学习性能
在单次演示学习场景下:
- RH20T训练的策略在多种任务上表现出色
- 相比仅使用视觉的方法,加入力觉信息显著提升性能
- 特别是在接触丰富任务(如插拔、组装)上提升明显
2. 多模态融合的价值
| 模态组合 | 简单任务 | 复杂任务 |
|---|---|---|
| 仅RGB | 75% | 45% |
| RGB + 力觉 | 82% | 68% |
| RGB + 力觉 + 触觉 | 85% | 72% |
关键发现:
- 力觉信息对接触丰富任务至关重要
- 触觉信息提供额外的精细操作反馈
- 多模态融合一致性地提升各种任务的性能
3. 任务组合性
RH20T的任务层级结构支持:
- 从短序列学习长序列任务
- 技能的迁移和组合
- 层次化的任务规划
🔍 个人思考
亮点
多模态覆盖的开创性:
- 首个提供视觉-力觉-音频-触觉全模态的机器人数据集
- 200Hz触觉数据是独特优势
- 为多感知融合研究提供了基础
任务多样性:
- 147项任务覆盖从简单到复杂
- 自定义任务强调接触丰富操作
- 任务层级结构支持组合性学习
数据质量:
- 精确的传感器标定
- 时间同步
- 人类演示视频作为任务描述
实用性:
- 提供完整的数据解析API
- 支持多种机器人配置
- 开源且有详细的使用文档
局限性
规模限制:
- 原始数据40TB,压缩后仍有5-10TB
- 下载和使用门槛较高
- 需要大量存储和计算资源
场景多样性有限:
- 主要在实验室环境采集
- 缺少真实家庭、办公场景
- 与DROID等数据集相比场景覆盖不足
任务复杂度:
- 虽然比简单任务复杂,但仍以桌面操作为主
- 缺少移动操作、全身控制等场景
- 与真实世界需求仍有差距
许可证限制:
- 部分场景(scene_0006-0010)使用CC-BY-NC许可证
- 限制了商业应用
- 需要注意使用场景
未来方向
多模态融合算法:
- 探索更有效的力觉-视觉融合方法
- 利用触觉信息进行精细操作
- 开发自适应的模态权重学习
一次性学习增强:
- 结合大语言模型进行任务理解
- 探索元学习和少样本学习
- 实现真正的"一次演示,多次执行"
真实世界部署:
- 将RH20T训练的策略迁移到真实家庭
- 结合移动操作扩展任务范围
- 与机器人导航结合实现完整服务
数据集扩展:
- 增加更多真实场景
- 扩展任务类型(如烹饪、清洁)
- 增加更多机器人形态
📖 延伸阅读
- RLBench: James et al., “RLBench: The Robot Learning Benchmark & Learning Environment”, RA-L 2020
- MetaWorld: Yu et al., “Meta-World: A Benchmark and Evaluation for Multi-Task and Meta Reinforcement Learning”, CoRL 2019
- DROID: Khazatsky et al., “DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset”, CoRL 2024
- Open X-Embodiment: Open X-Embodiment Collaboration, “Open X-Embodiment: Robotic Learning Datasets and RT-X Models”, ICRA 2024
- Diffusion Policy: Chi et al., “Diffusion Policy: Visuomotor Policy Learning via Action Diffusion”, RSS 2023
本文为论文精读系列第3篇,聚焦具身智能领域的多模态机器人操作数据集。