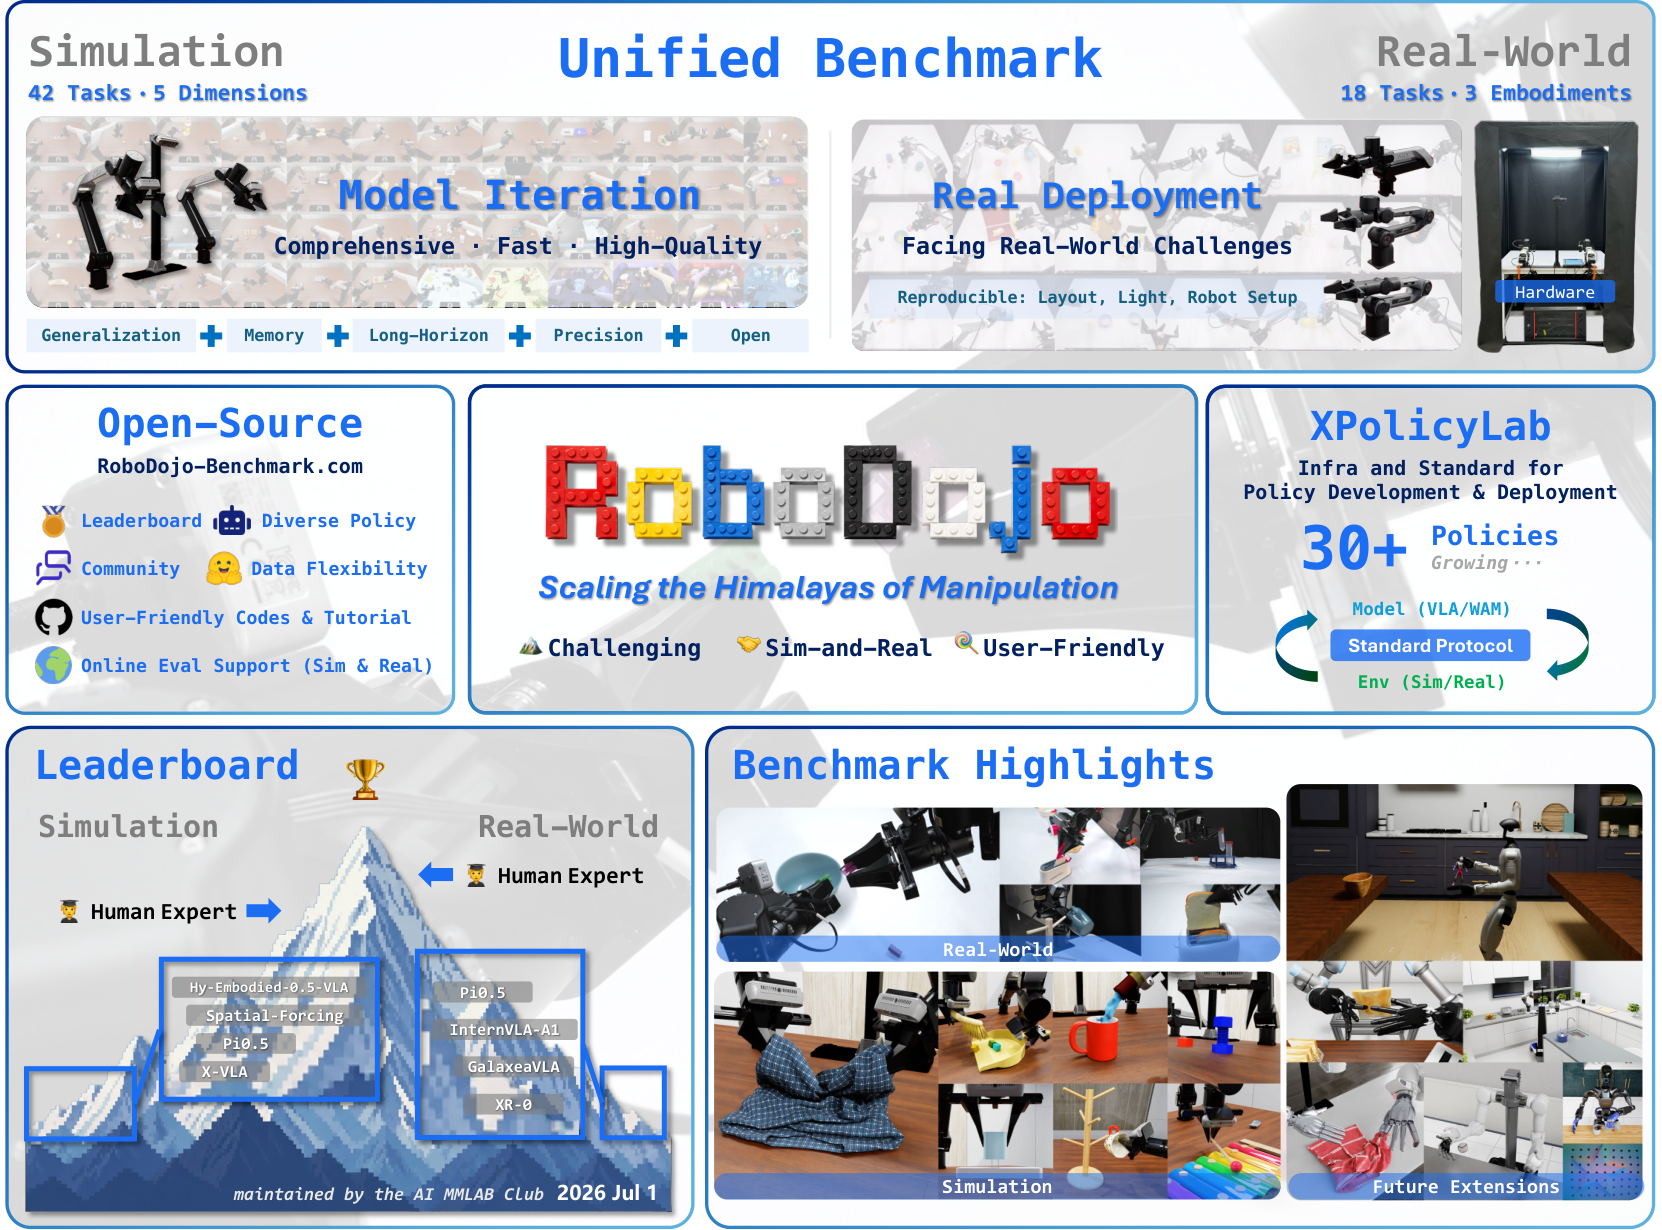
配图说明:本文收录论文全部 10 张插图(Figure 1 ~ Figure 10,其中 Figure 6 含 (a) 资产库 / (b) 并行仿真两个子图),放在站内 /images/robodojo/,逐张讲解,文末附图表总索引表。论文 RoboDojo: A Unified Sim-and-Real Benchmark for Comprehensive Evaluation of Generalist Robot Manipulation Policies(arXiv 2607.04434 v3),榜单由 AI MMLab Club(非营利基金会)运营,官网 robodojo-benchmark.com。站内多篇精读(HexaShell、EmbodiedEvo、WorldScape、VPP2、Flash-WAM)的分数全部来自 RoboDojo——本篇就是「考场本身」的说明书。
📄 论文信息
- 标题:RoboDojo: A Unified Sim-and-Real Benchmark for Comprehensive Evaluation of Generalist Robot Manipulation Policies
- 机构 / 治理:AI MMLab Club(非营利基金会)维护榜单;全球高校机构共同治理,明确无商业公司参与(含赞助与运营)
- 时间:2026-07(arXiv 2607.04434;v3);榜单自 2026-07-03 快照起持续更新
- 关键词:通才操纵策略、统一仿真-真机评测、五能力维度、异构并行仿真、RoboDojo-RealEval、XPolicyLab、隐藏布局、反刷榜协议
- 一句话总结:把「仿真快速诊断」和「真机可复现验证」装进同一套任务与协议:42 个仿真任务按五维能力拆分、18 个真机任务跨三个本体,策略只需实现一次统一接口(XPolicyLab)就能两边都测;榜单用公开布局评测 + 隐藏布局复核 + 强制开源工件来防刷。
🎯 一句话版本:核心数字
| 指标 | 数值 | 说明 |
|---|---|---|
| 仿真基准 | 42 任务 × 50 episodes = 2,100 episodes | 五维:Generalization(12) / Precision / Long-Horizon / Memory / Open(8) |
| 仿真训练数据 | 3,500 条轨迹 / 1,859,602 帧 / 20.66 小时 @25Hz | 34 训练任务 + 100 条 DLC 域随机化辅助轨迹;Open 维不给训练数据 |
| 真机基准 | 18 任务(ARX X5 / Piper / Piper X 各 6 任务) | 每任务 10 次试验,3 名评审双盲打分取均值 |
| 真机演示数据 | 1,800 条 / 1,611,841 帧 / 17.91 小时 @25Hz | 每任务 100 条、4 名操作员,同构 leader-follower 遥操作 |
| 榜单快照(2026-07-03,仿真) | 最佳 Hy-Embodied-0.5-VLA 13.07 分 / 8.80% SR | 人类专家 80.42 / 76.03%——差距悬殊 |
| 榜单快照(真机) | 最佳 π0.5 22.9 分 / 12.8% SR | 人类专家 100 / 100% |
| 随机化打击 | Hy-Embodied 标准 21.98 → 随机 1.57(-92.9%) | 场景级随机化造成普遍崩溃 |
| 已接入策略 | 30 个(XPolicyLab 一次接入) | 快照 2026-07-03,持续更新 |
🗺️ 仿真 vs 真机:一眼分清
| 基准 | 类型 | 规模与协议 |
|---|---|---|
| RoboDojo Simulation(Isaac Sim / Isaac Lab) | 仿真 | 42 任务;Gen 维拆 25 标准 + 25 随机 episodes;总分为五维均值(不是按任务数加权) |
| RoboDojo-RealEval(ARX X5 / Piper / Piper X) | 真机 | 18 任务;每任务 10 trials;预采集布局重放保证初始一致;三评审双盲 + 申诉机制 |
| 云端远程评测 | 真机(云) | 参与者跑远程 policy server,经标准化协议与官方评测客户端通信,不必开源即可私有迭代 |
| 隐藏验证布局 | 仿真(复核) | 官方发布前在隐藏布局上复核,防公开布局过拟合;是辅助一致性检查而非主测试集 |
注意论文明确:仿真与真机任务不是一一配对的——真机基准不是测 sim-to-real 迁移,而是补仿真测不到的接触噪声、执行误差与部署挑战。
🧭 读前 5 分钟:五个概念
- 五能力维度:Generalization(视觉/布局/光照分布偏移下拾取放置)、Precision(细对准、轨迹误差敏感)、Long-Horizon(多阶段顺序执行)、Memory(保持对先前状态/指令的记忆)、Open(训练中没见过的任务规格——技能见过、目标没见过,考语义接地与技能重组)。
- 异构并行仿真:常规向量化仿真并行的克隆环境只换位姿/种子;RoboDojo 让不同任务、不同几何、不同杂乱布局并发执行——这是通才策略评测的算力前提。
- XPolicyLab:统一策略接口(观测更新、动作预测、策略重置、批量查询),策略接入一次,仿真与真机两边都能测,策略侧改动最小。
- RoboDojo-RealEval:标准化真机评测系统——统一硬件(头部 Gemini 335L + 两腕 Gemini 305 相机、可换夹爪)、工作台、光照、重置流程、评分协议与部署接口,支持本地与云端。
- 反刷榜协议:公开布局为主测试 + 隐藏布局复核;正式上榜必须 ①走官方评测系统 ②仿真三随机种子报均值±方差、真机覆盖全部三本体 ③过隐藏布局 ④开源 checkpoint+训练/部署代码+配置+复现说明(经 XPolicyLab)⑤公布评测视频。
🗂️ 数据与评测设置
仿真侧
- 任务构成:35 个任务目录 = 34 个训练任务(Gen/Precision/Long-Horizon/Memory 四维)+ 1 个辅助 DLC 数据目录;Open 维 8 任务不进训练集——它们考的是「技能重组 + 新语言接地」,给演示就泄题了。
- 数据收集:每任务 100 条轨迹,自动化轨迹合成或 VR 遥操作;Gen 维不加域随机化收集,另配 100 条 DLC 辅助轨迹(复杂域随机化:多样背景/光照/杂乱布局),与评测任务独立避免任务解法泄漏。
- 评测:每任务 50 episodes;Gen 维拆成 25 标准 + 25 随机(背景、布局、任务物体、光照变化);报告 成功率 + 平均分(分=部分进度),总分 = 五维均值——任务多的维度不能压垮聚合指标。
- 数字资产库:刚体(在线仓库 + Meshy AI 重建)、铰接体、可变形体(含 ClothesNet 部分资产),全部标注语言描述、放置区域、成功检查与操作可供性(affordance),并经仿真 rollout 验证物理稳定。
- 配置驱动:每个任务用模块化 YAML 定义资产、布局、初始化分布、随机化范围、成功条件——任务规格与模拟器执行解耦,同一运行时换 YAML 即换任务,确定性种子保证可复现。
真机侧
- 遥操作:同构 leader-follower(leader 与 follower 同本体),指令空间与部署本体对齐;每任务 100 条演示 × 4 操作员,含机器人状态、语言标注、1 头 + 2 腕部 RGB;人工质检(完成度、质量、重置协议一致性)。
- 评分:10 trials/任务;重放预采集布局保证初始一致;3 名独立评审双盲打分,兼顾最终成功与中间子步骤完成度,取三人均值;公开评测视频与分数 + 申诉机制。
📸 逐图讲解(Figure 1 ~ 10)
Figure 1:总览——统一仿真诊断与可复现真机验证
(即文首头图。)开篇总图:左侧是仿真侧(Isaac Sim 里异构并行的多任务场景),右侧是真机侧(标准化工作台上的双臂操作),中间是评测协议与榜单闭环。一图点题:sim 负责快速反馈与能力诊断,real 负责部署条件下的可信验证,两者共用一套任务设计哲学与统一策略接口。
Figure 2:任务总览——42 仿真 + 18 真机
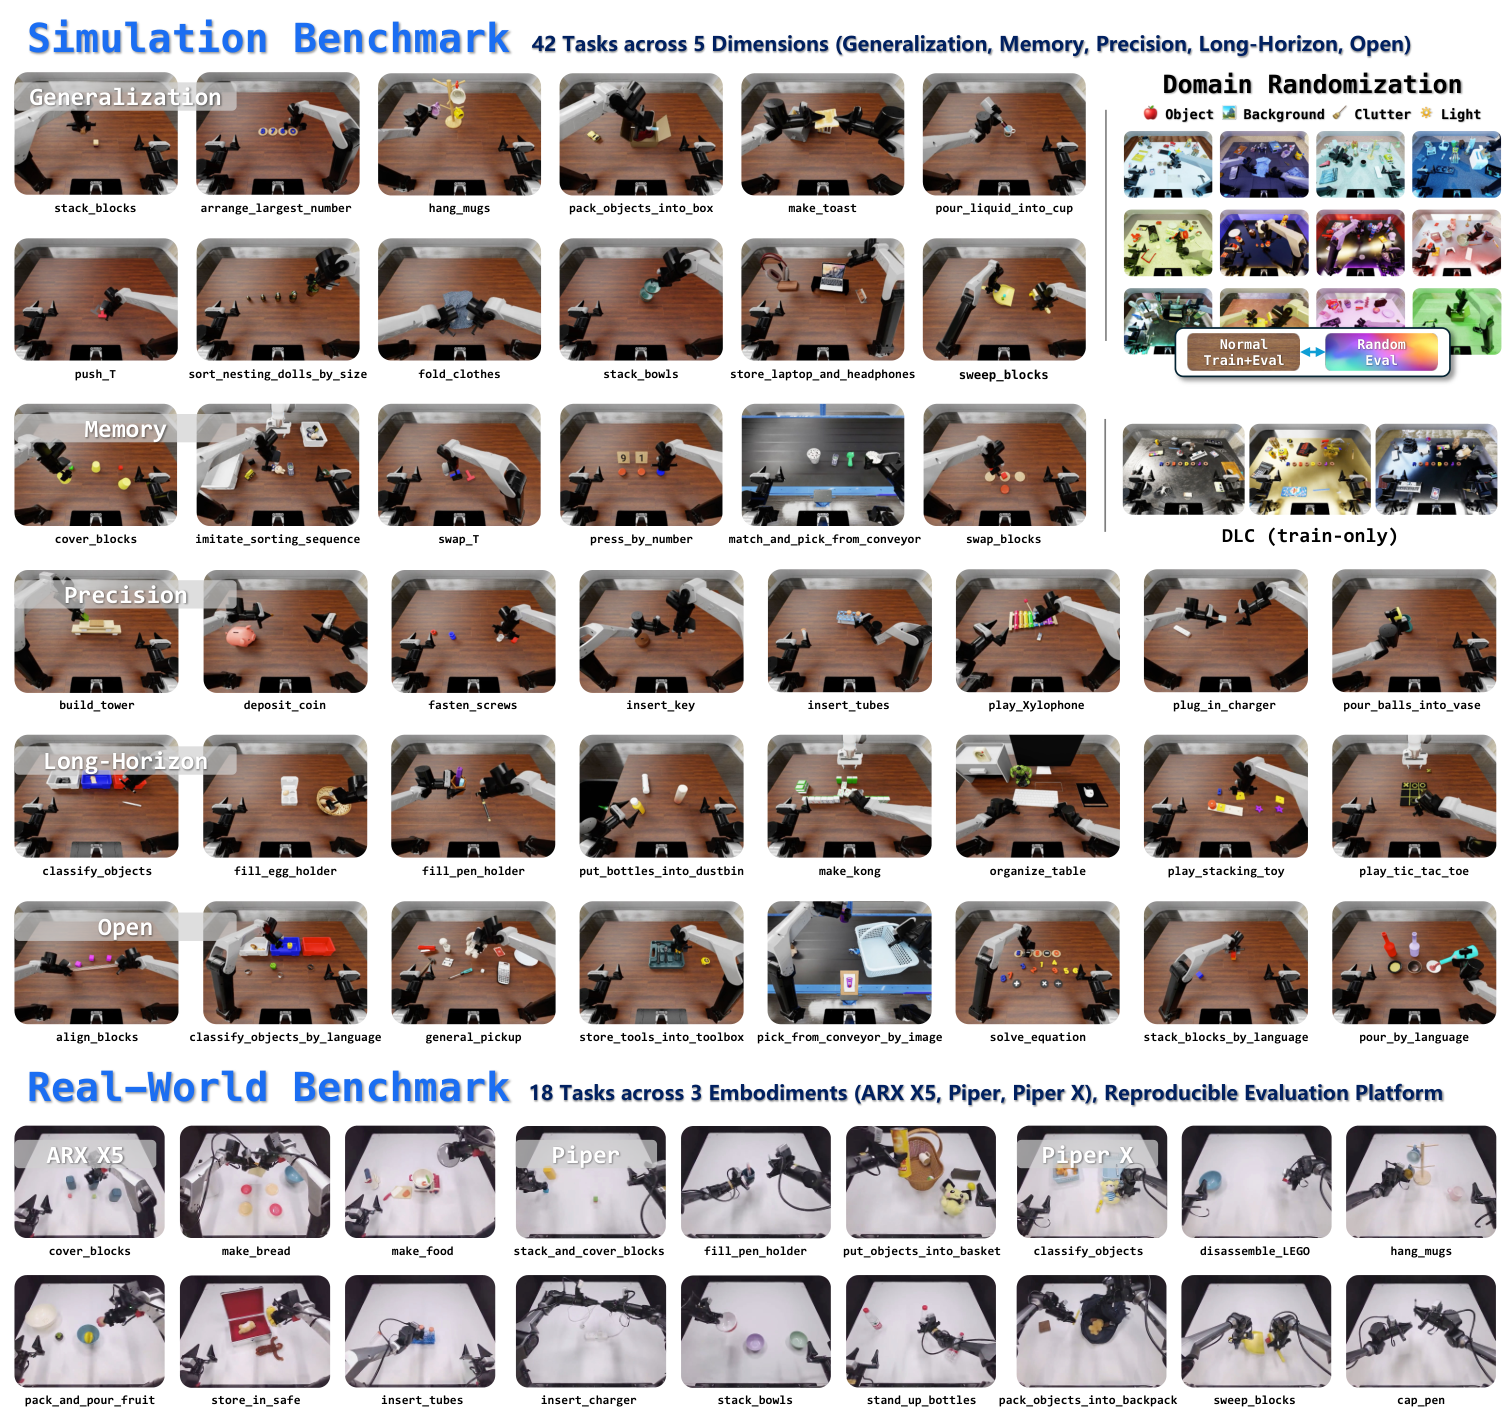
全景式列出仿真五维任务与三本体真机任务的分布。读图要点:
- 仿真 42 任务按五能力维度着色分组,Open 维独立于训练集;
- 真机 18 任务 = 3 本体 × 6 任务,覆盖长程、精密、记忆、泛化的代表子集;
- 该图是理解后续两张榜单的「地图」——每个分数格子都能回到这里的某个任务组。
Figure 3:技能多样性——24 种操作技能
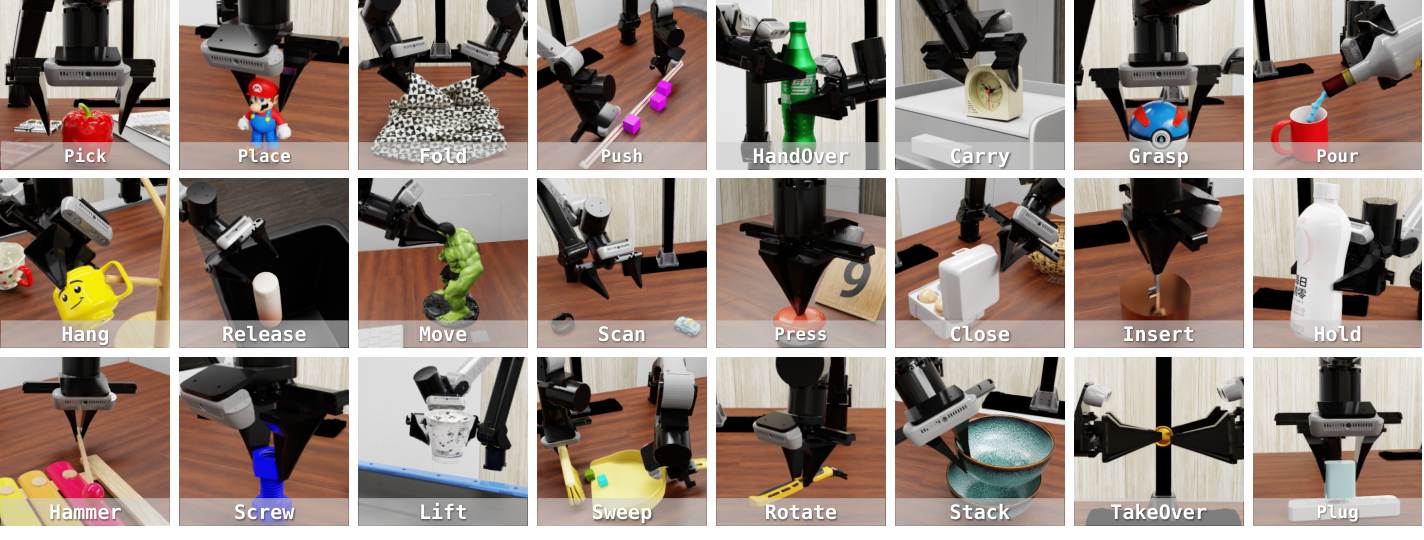
图中点名 24 种技能:Pick / Place / Fold / Push / HandOver / Carry / Grasp / Pour / Hang / Release / Move / Scan / Press / Close / Insert / Hold / Hammer / Screw / Lift / Sweep / Rotate / Stack / TakeOver / Plug——从抓放、堆叠、插入到工具使用与接触敏感操作。设计意图:超出「重复性 pick-and-place」的技能谱,让评测能做技能级诊断(哪个技能类型是全行业短板),而不是只看一个总成功率。
Figure 4:真机任务高光——跨本体的关键帧
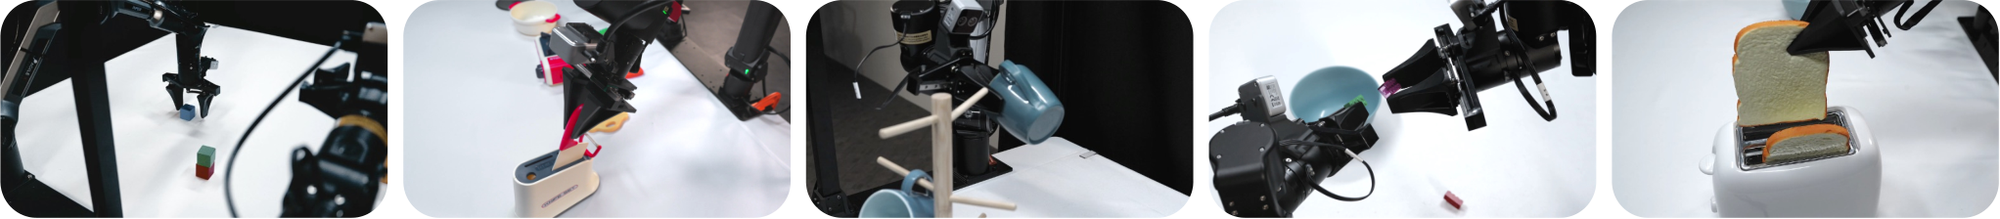
三本体(ARX X5、Piper、Piper X)代表性困难任务的关键帧拼图。看点:不同臂展/负载/夹爪精度下,同一类任务的动作形态差异明显——这正是「同一策略跨三本体各自跑 6 任务」能暴露迁移脆弱性的原因。真机任务强调接触密集交互、细粒度空间对准、多物体操作、部分可观测与本体运动约束。
Figure 5:全球学术机构联合评测,无商业参与
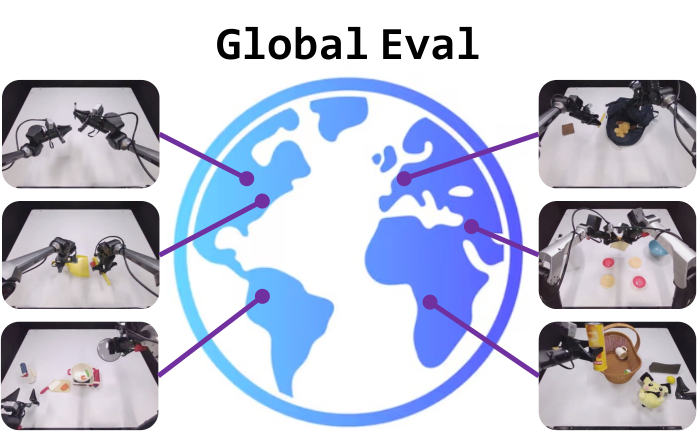
治理结构图:官方评测由全球学术机构伙伴联合支持,榜单归 AI MMLab Club 非营利基金会运营,不接受商业公司参与(无论以赞助、资金还是运营形式)。这是 RoboDojo 对「基准中立性」的正面回答——榜单公信力本身就是基础设施。
Figure 6:(a) 资产库 与 (b) 异构并行仿真
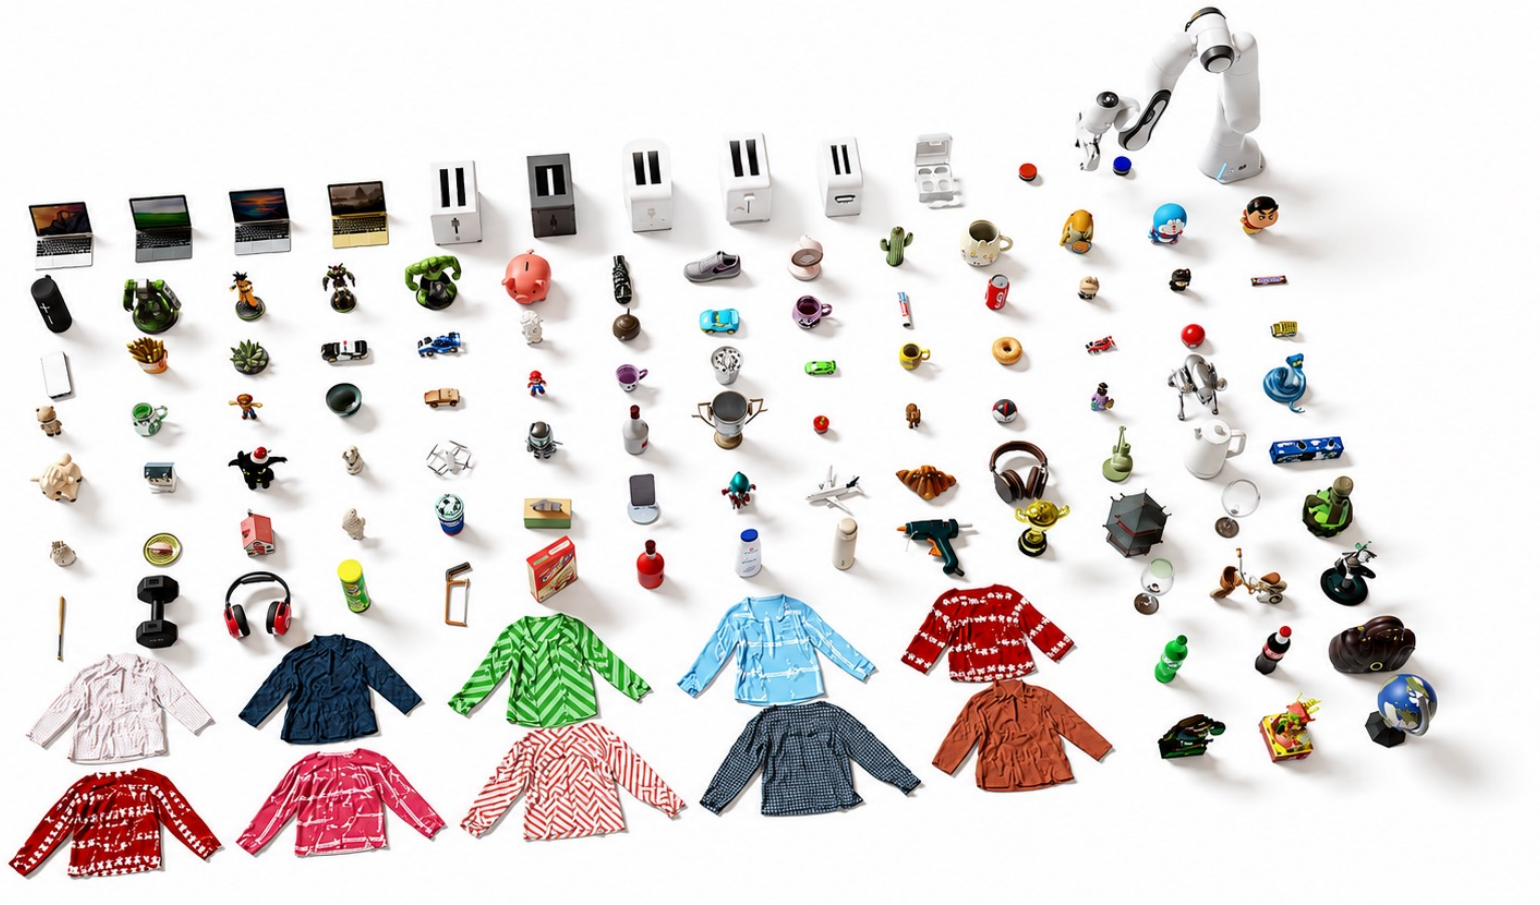
(a) 资产库样本:刚体、铰接体、可变形体三类。刚体来自在线仓库与 Meshy AI 参考图/文本重建,转 USD 后人工在 Isaac Sim 检查;铰接体核验运动链、关节限位与物理稳定;可变形体赋估计材料参数与真实纹理(部分来自 ClothesNet)。每个资产带语言描述、放置/成功检查标注、可供性——资产标注直接支撑自动演示生成与任务成功判定。
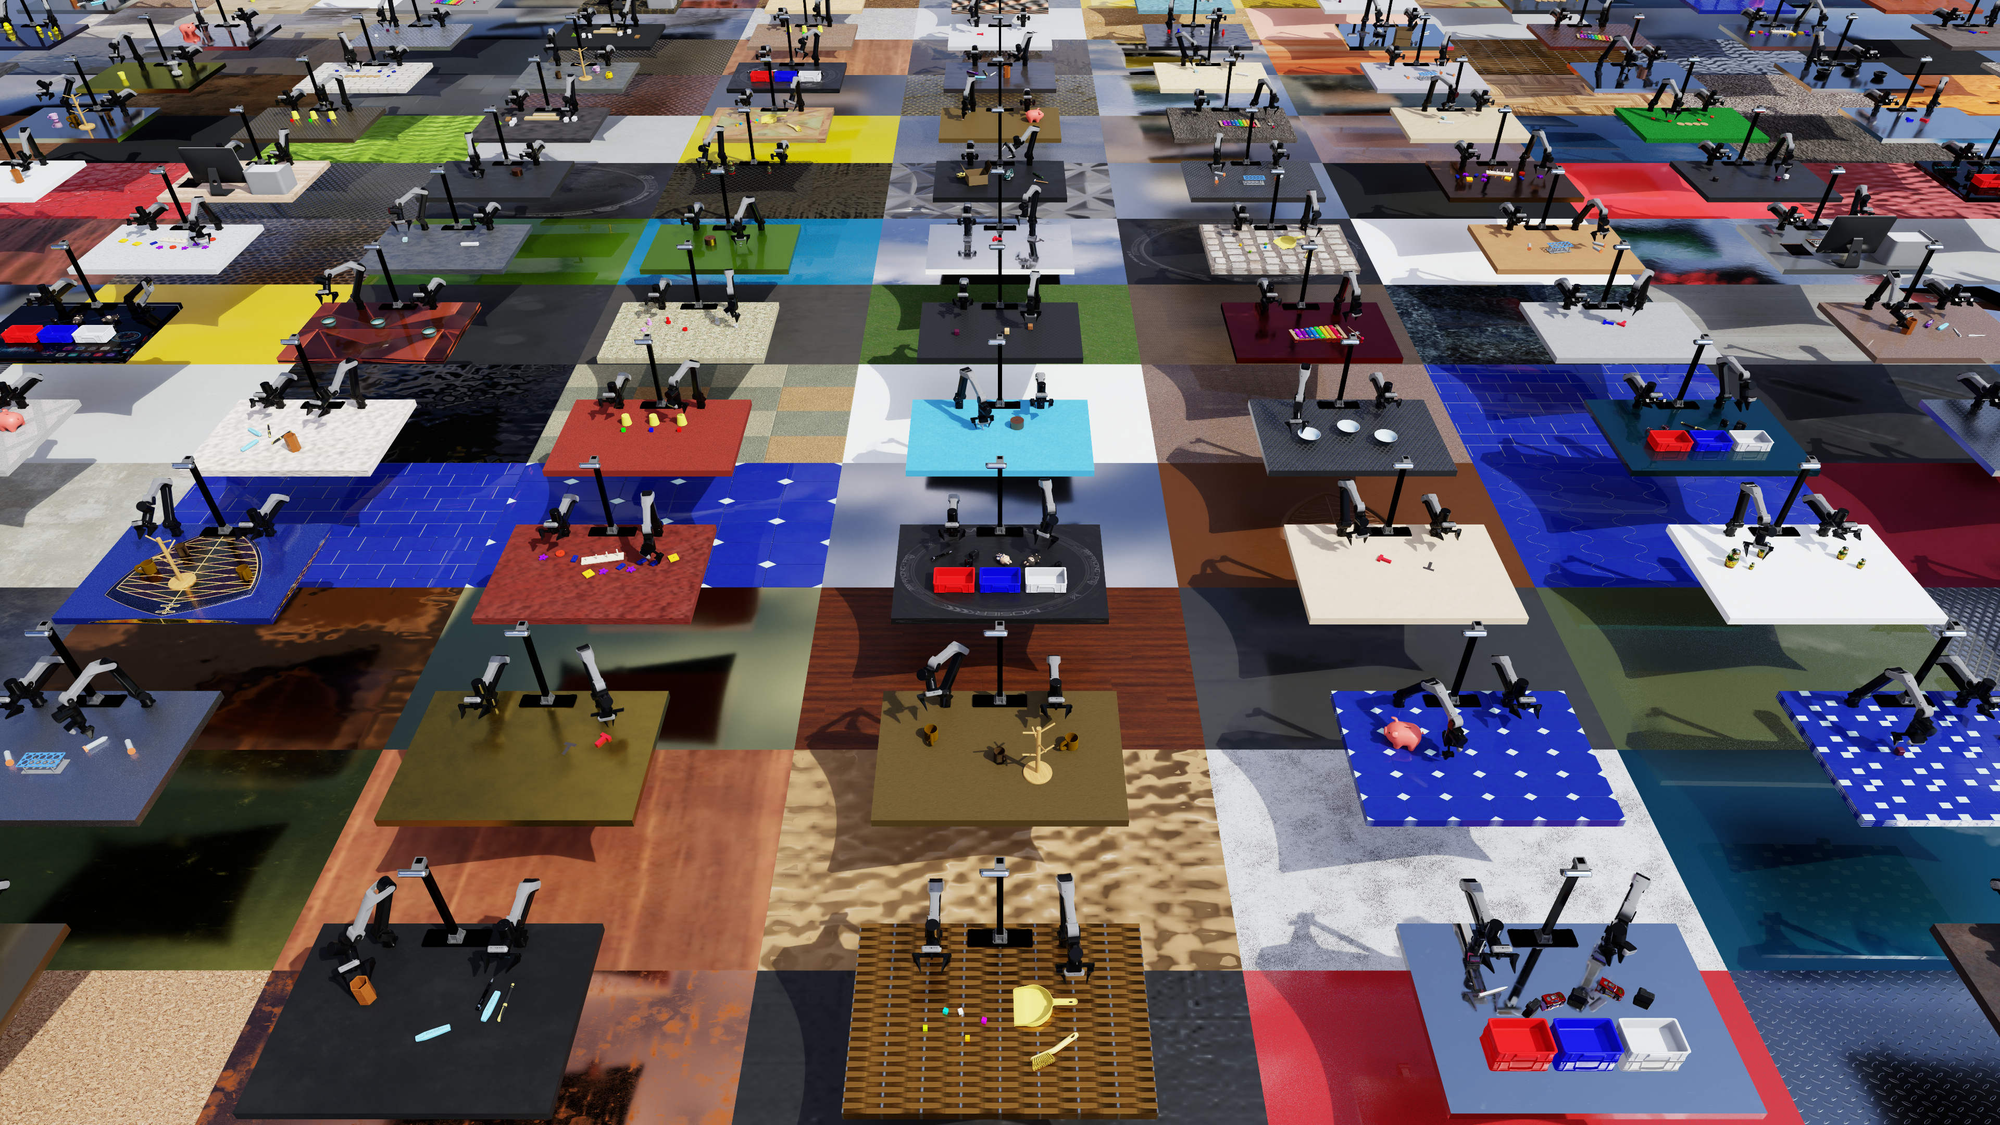
(b) 并行仿真:多个环境在共享向量化接口下并发执行不同任务——注意不是同一场景模板的克隆,而是不同几何、不同物体数、不同杂乱布局、不同铰接结构与背景。意义:通才策略需要跨场景多样评测,同质克隆环境测不了这件事;异构并行把「多样性」和「吞吐」同时拿到(论文报告在 8×RTX 4090 上运行,见 Table 4)。
Figure 7:RoboDojo-RealEval 系统总览
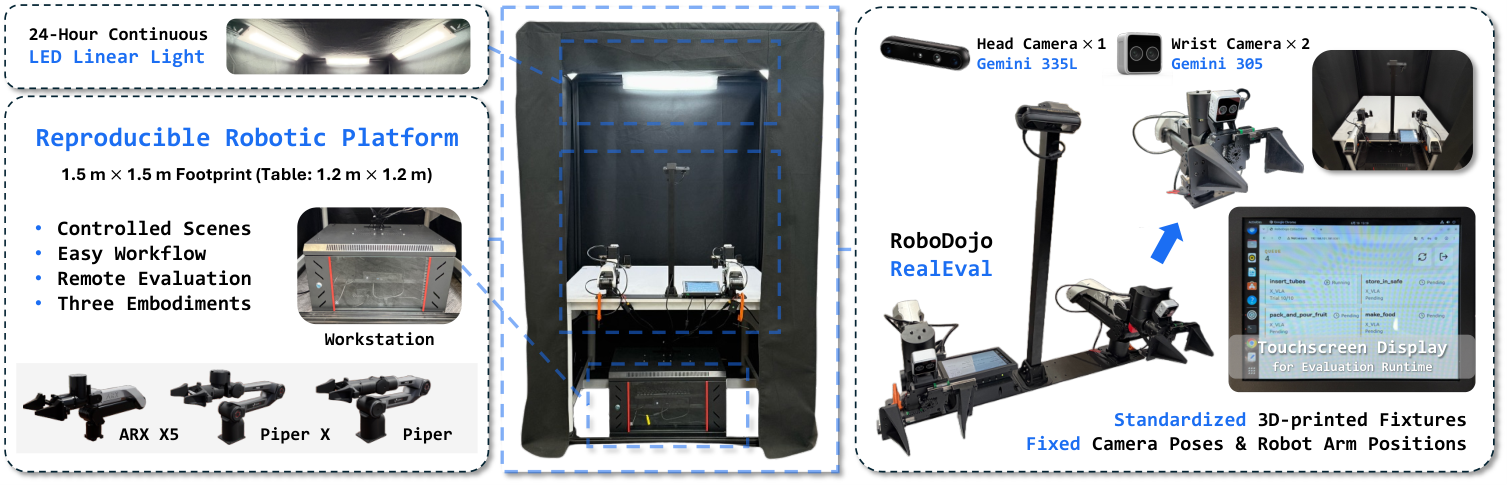
真机评测系统架构:标准化硬件配置、工作台布局、光照条件、场景重置流程、评测协议与部署接口六大要素统一;支持本地部署与云端远程评测——策略通过标准协议(论文附录 H)与真机客户端通信。对提交方的关键价值:不必把机器人搬进自家实验室,也能在与所有人完全一致的物理条件下被测。
Figure 8:仿真域随机化效果

可视化随机化维度:背景、光照、杂乱布局、物体外观、场景配置的变化。这组图直接对应 Finding 2 的「标准 vs 随机」对照——训练集刻意不做随机化(另有 DLC 辅助数据管视觉多样性),就是为了让随机化评估真正测量分布偏移下的鲁棒性,而不是自我印证。后面榜单会看到:这一列几乎把所有策略打崩。
Figure 9:未来扩展方向
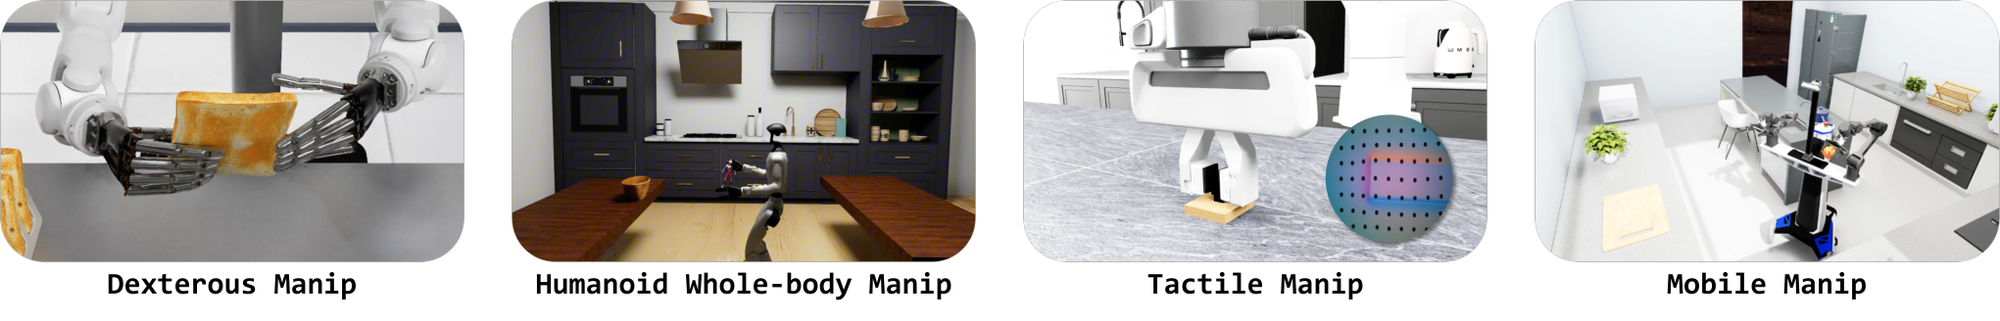
路线图式插图:向更广的操纵场景与更多本体扩展,包括灵巧手操作等。解读:当前 18 真机任务是「紧凑但难」的最小可信集合(受硬件成本、时长、人工重置与安全约束),设计上刻意不做穷举——扩展靠持续加入而非一次做满。
Figure 10:RealEval 硬件组件
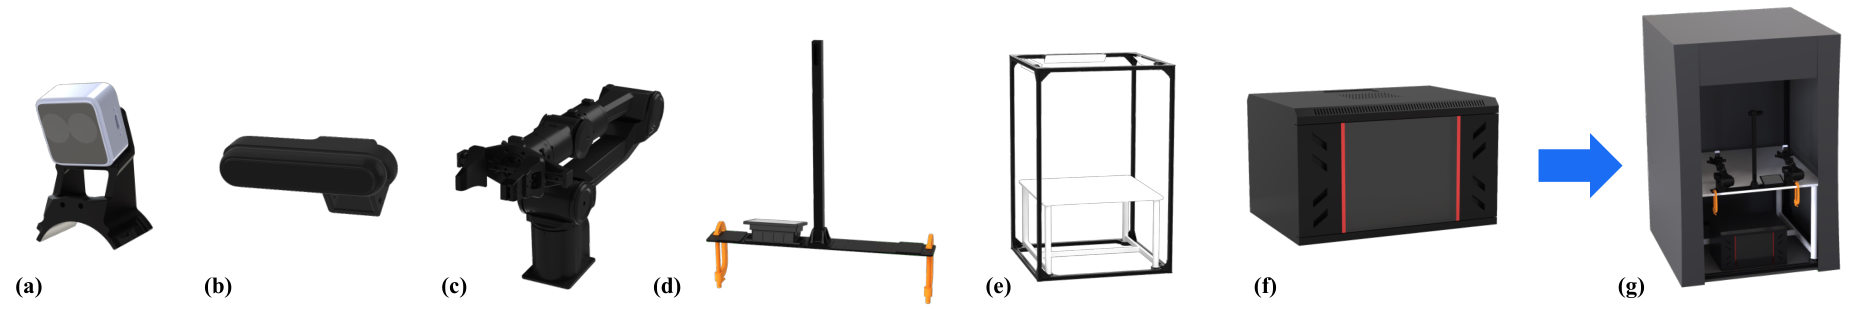
(a) 两台 Gemini 305 腕部相机、(b) 一台 Gemini 335L 头部相机、(c) 可更换夹爪等模块。标准化到相机型号与夹爪可换,意味着:跨本体差异只保留「臂/工作空间/负载」这些本质差异,视觉输入与夹爪接口被协议抹平——评测分数的本体差异才能被归因到策略本身。
🧪 榜单与四大发现(2026-07-03 快照)
仿真榜(Table 1,30 策略 + 人类参考)
| 策略 | Gen | Precision | Long-Horizon | Memory | Open | 平均 |
|---|---|---|---|---|---|---|
| Hy-Embodied-0.5-VLA | 11.77 / 8.39% | 13.81 / 8.00% | 25.74 / 14.92% | 13.37 / 12.11% | 0.65 / 0.58% | 13.07 / 8.80% |
| Spatial Forcing | 14.12 / 9.33% | 17.33 / 10.58% | 23.26 / 14.58% | 5.43 / 4.11% | 1.78 / 1.58% | 12.38 / 8.04% |
| π0.5 | 13.37 / 8.17% | 12.40 / 5.50% | 23.54 / 14.67% | 5.78 / 4.56% | 1.98 / 1.67% | 11.41 / 6.91% |
| X-VLA | 10.48 / 6.78% | 18.32 / 12.00% | 16.53 / 9.75% | 4.76 / 3.56% | 0.55 / 0.50% | 10.13 / 6.52% |
| Xiaomi-Robotics-0 | 7.43 / 5.56% | 8.42 / 4.58% | 13.51 / 6.92% | 5.07 / 3.67% | 0.22 / 0.17% | 6.93 / 4.18% |
| π0 | 3.94 / 2.56% | 3.56 / 0.75% | 6.19 / 2.00% | 3.47 / 2.11% | 0.25 / 0.25% | 3.48 / 1.53% |
| GR00T-N1.7 | 2.16 / 1.22% | 2.54 / 0.67% | 8.30 / 3.58% | 1.06 / 0.89% | 0.18 / 0.17% | 2.85 / 1.31% |
| 人类专家(遥操作) | 90.05 / 87.83% | 68.06 / 64.00% | 83.63 / 74.25% | 75.25 / 74.33% | 85.13 / 79.75% | 80.42 / 76.03% |
(格式:平均分 / 成功率;人类不参与策略排名。更多尾部策略(RDT-1B、OpenVLA-OFT、TinyVLA 等不足 1% SR)见论文。)
真机榜(Table 2 摘要,10 策略 + 人类)
| 策略 | 三本体均分 / SR | 备注 |
|---|---|---|
| π0.5 | 22.9 / 12.8% | 最佳;ARX X5 27.7/13.3、Piper 32.0/21.7、Piper X 9.1/3.3 |
| InternVLA-A1 | 12.0 / 7.2% | — |
| GalaxeaVLA (G0) | 9.0 / 4.4% | — |
| Xiaomi-Robotics-0 | 7.9 / 3.9% | — |
| GR00T-N1.7 | 5.9 / 1.7% | — |
| 人类专家 | 100 / 100% | 三本体全满分 |
四大发现(仿真侧 Finding 1–4 + 真机侧)
- 离「均衡通才」还很远:最佳 8.80% SR vs 人类 76.03%;且能力维度割裂——Spatial Forcing 强在泛化、X-VLA 强在精密、π0.5 强在 Open、Hy-Embodied 强在长程/记忆/总分,但没有谁能把优势带全;即便「相对强」的 Gen/Long 维,最高 SR 也不到 15%。
- 场景级随机化 = 大崩溃,视觉-空间接地只救一点:Hy-Embodied 标准 21.98 → 随机 1.57(-92.9%);Spatial Forcing 绝对随机分最高(6.98 vs π0.5 的 5.82),相对保持率从 72.2% 降到 67.2%——3D 空间接地有帮助但绝对值仍低。要点:失败不只是「认不出物体」——度量定位、动作接地、偏轨恢复在分布偏移下一起退化。
- 长程只有部分进步,技能组合不可靠:Hy-Embodied 长程 14.92% / π0.5 14.67% / Spatial Forcing 14.58%——比精密/记忆/Open 好,但仍是「部分进度」水平。
- 精密是最大瓶颈:X-VLA 12.00% / Spatial Forcing 10.58% / Hy-Embodied 8.00%——接触感知控制弱、偏轨纠正弱,不只是对准问题,还要在紧容差下生成空间准确、时间平滑、接触敏感的动作。
- 真机额外暴露执行不稳定与安全关键行为(真机 Finding 3):分数普遍高于成功率 = 常能推进但完不成;这些是纯聚合指标看不到的失败形态。
时间线备注:本篇数字是论文 2026-07-03 快照。到 2026-10,站内其他精读引用的 RoboDojo 快照中,编码 agent(HexaShell 46.9%、EmbodiedEvo 37.82%)与新 WAM(WorldScape-R2SI 39.4%、Awomo-0.5 等)已把纪录推高一个量级——榜单持续更新是设计使然(RoboDojo-Benchmark.com),看榜务必带上日期。
💡 评析:三个亮点,三条边界
三个亮点
- 仿真-真机协议真正统一:XPolicyLab 一次接入 + RealEval 标准化硬件/重置/评分/接口 + 云端远程——「真机评测不可复现」这个老大难被工程化拆掉了。
- 反刷榜设计成体系:隐藏布局复核、三种子统计、全本体覆盖、强制开源工件 + 视频、双盲评分 + 申诉——比多数榜单更接近「评测治理」的完整形态。
- 诊断维度而不是一个总分:五维拆分 + 标准/随机对照 + 技能级覆盖(24 技能),让榜单能回答「行业卡在哪」(本篇答案:精密与随机化鲁棒性),而不只是「谁第一」。
三条边界
- 真机任务刻意紧凑(18 任务、每任务 10 trials):受成本/时长/安全约束,是「最小可信集」而非穷举;统计功效有限,单任务 10 次试验的分数解读要谨慎。
- 仿真与真机不配对:无法直接回答 sim-to-real 迁移问题;两侧分数只可分别解读。
- 五维总分掩盖维度内异质性:同一维度内任务难度、随机种子效应仍大(论文另用 Table 6/7 报稳定性);对新策略来说,单看总分容易误判能力画像。
🗺️ 在「评测谱系」里的位置
- 对上:LIBERO / RoboCasa / RLBench 等单仿真基准只覆盖部分维度;本篇把五维能力 + 真机验证合并成一个体系。
- 对下:站内所有 RoboDojo 分数类精读(HexaShell 46.9%、EmbodiedEvo 37.82%、WorldScape R2SI 39.4%、VPP2、Flash-WAM)的「考场」都是它。
- 榜单快照史:2026-07 论文快照最佳 8.80% SR → 2026-10 快照 22–47% 区间——提升同时来自 agent/工具路线与更强 WAM,评测协议保持连续。
- 谱系标签:基准 / 榜单治理 / 仿真-真机统一协议。
📊 图表总索引
| 图 | 内容 | 本站文件 |
|---|---|---|
| Figure 1 | 总览:统一仿真诊断 + 真机验证 | 本文插图 |
| Figure 2 | 任务总览(42 仿真 + 18 真机) | 本文插图 |
| Figure 3 | 技能多样性(24 技能) | 本文插图 |
| Figure 4 | 真机任务关键帧(三本体) | 本文插图 |
| Figure 5 | 全球学术评测、无商业参与 | 本文插图 |
| Figure 6(a) | 数字资产库 | 本文插图 |
| Figure 6(b) | 异构并行仿真 | 本文插图 |
| Figure 7 | RoboDojo-RealEval 系统 | 本文插图 |
| Figure 8 | 域随机化效果 | 本文插图 |
| Figure 9 | 未来扩展方向 | 本文插图 |
| Figure 10 | RealEval 硬件组件 | 本文插图 |
(核心数据表:Table 1 仿真榜、Table 2 真机榜、Table 3 标准/随机对照、Table 4–7 效率与稳定性、Table 8 与同类基准对比、Table 10–11 数据统计、Table 12 统一接口——正文已复现关键数字。)
❓ 自测 Q&A
Q1:为什么 Open 维不能进训练集?
Open 维考「技能见过、任务规格没见过」的重组与语言接地;给对应演示等于把答案放进训练分布,测不出泛化。
Q2:总分为什么按五维均值而不是按任务平均?
任务数多的维度(如 Generalization 12 个)会主导聚合指标;按维均值让每个能力拥有相同话语权。
Q3:隐藏布局和公开布局各扮演什么角色?
公开布局是主测试(可复现、可对比),隐藏布局是防「手工调参刷公开榜」的一致性复核,不作为主要发布依据。
Q4:真机分数为什么普遍高于成功率?
分数记录部分进度(中间子步骤),成功率要求全流程完成——「能推进但完不成」正是当前策略的典型形态。
Q5:为什么论文最佳 8.8%,站内别的精读却报 40%+?
日期不同:论文是 2026-07-03 快照,站内其他文引用 2026-10 快照;RoboDojo 榜单持续更新,横向比较必须对齐日期。
📚 资源与延伸
- 姊妹篇图鉴:14 个具身仿真 Benchmark 全精读(Meta-World/RLBench/CALVIN/RoboCasa/SimplerEnv/BEHAVIOR-1K/VLABench/ManiSkill3/RoboTwin2.0/RoboCasa365/MagicSim/XPolicyLab/HumanCLAW-Bench/RoboCurve 逐图全解)
- 论文:arXiv 2607.04434
- 榜单与协议:robodojo-benchmark.com(Leaderboard 持续更新)
- 分数来源精读:HexaShell 精读、EmbodiedEvo 精读、WorldScape 精读、VPP2 精读、Flash-WAM 精读
- 榜单上的模型:π0.5 开放世界泛化精读、π0.7 精读、GR00T-N1.7 精读
- 知识铺垫:LIBERO 精读、WAM 世界行动模型全景分析