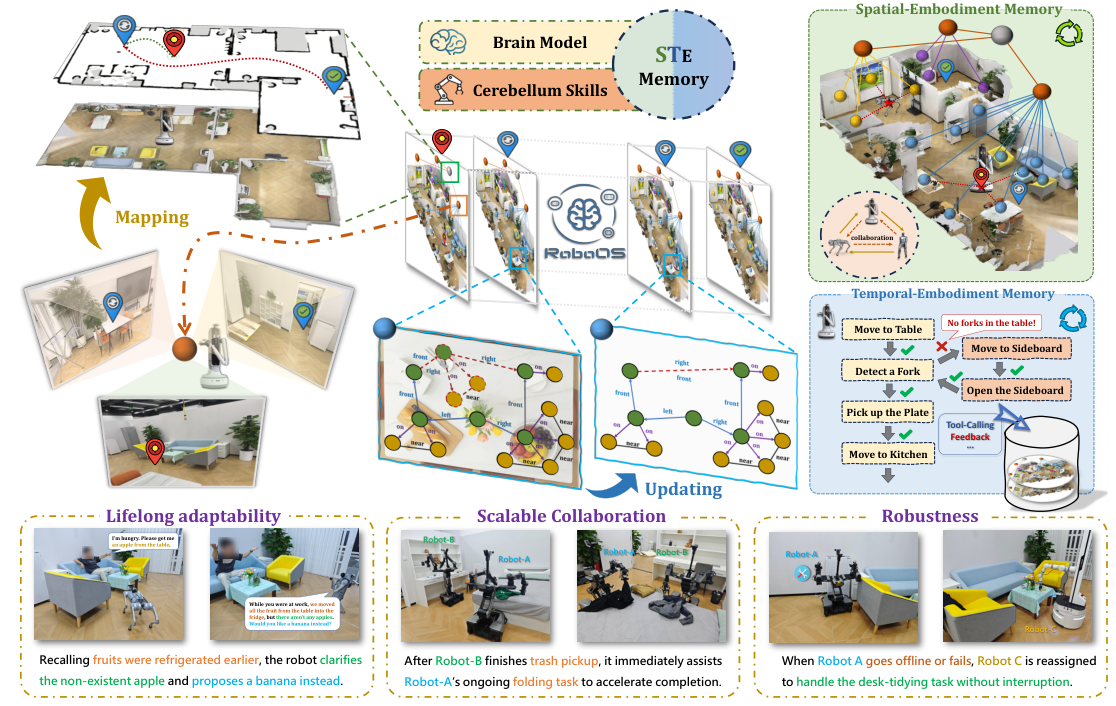
配图说明:本文收录论文全部 4 张插图(Fig. 1 ~ Fig. 4),放在站内 /images/roboosnext/,逐张讲解,文末附图表总索引。论文 RoboOS-NeXT: A Unified Memory-based Framework for Lifelong, Scalable, and Robust Multi-Robot Collaboration(arXiv 2510.26536,2025-10-30),北京大学王培/张胜涵组 + 北京智源(BAAI)+ 中科院自动化所 + 北航。姊妹篇:ABot-AgentOS 精读(单机「机器人大脑 OS」视角)。
🧒 小白 5 分钟:到底什么是「具身机器人大脑系统」?
先分清两层。 你见过的那种「相机进、动作出、直接抓杯子」的模型(VLA:视觉-语言-动作模型)其实相当于机器人的小脑——反射快,但只会眼前这一下。而大脑系统管的是小脑不管的事:
- 听懂话:「我饿了,去桌上拿个苹果」→ 不是一条动作,而是一句要被拆解的意图;
- 拆任务:走过去 → 找苹果 → 发现没有 → 问主人 → 换香蕉(每步还可能再失败);
- 调度:家里有 3 台机器人,谁去拿?A 挂了谁顶上?——这是多机器人调度;
- 记忆:水果昨天放进冰箱了、「上次这个抽屉是坏的」——没有记忆的机器人每次都像初次见面;
- 验证:碗真的放进柜子了吗?没放对就回去重做。
一个好懂的类比:大脑系统 ≈ 公司的「CEO + 共享台账 + 交接班制度」;VLA ≈ 手上干活的员工。员工再熟练,没有台账和调度,公司(家)照样乱。「OS(操作系统)」这个词借得也形象:操作系统管进程、内存、文件,机器人大脑 OS 管技能调用(进程)、记忆(内存)、任务与工具(文件系统),并把云上大模型和端侧小模型路由起来。
本篇 RoboOS-NeXT 关心其中最难的组合:多台异构机器人 + 共享记忆 + 长期使用不退化;下一章的姊妹篇 ABot-AgentOS 则把「单个机器人也配上完整 OS 内存」。带着这五件事(听懂-拆解-调度-记忆-验证)读下去,每章技术点都能对号入座。
📄 论文信息
- 标题:RoboOS-NeXT: A Unified Memory-based Framework for Lifelong, Scalable, and Robust Multi-Robot Collaboration
- 机构:北京大学(PKU)、北京智源人工智能研究院(BAAI)、中科院自动化所、北航
- 时间:2025-10-30(arXiv 2510.26536v1);有项目主页
- 关键词:STEM 记忆(Spatio-Temporal–Embodiment)、大脑-小脑框架、多机器人协作、终身适应、容错调度、工具调用
- 一句话总结:给多机器人团队配一块「共享白板」(STEM 记忆:空间几何+事件史+本体档案),大脑(VLM 规划)读写白板做全局分解与调度,小脑(技能库+工具)低延迟执行;白板持续更新 → 长序列不崩、编队越大越快、掉线能接管。
🎯 一句话版本:核心数字
| 指标 | 数值 | 说明 |
|---|---|---|
| 长序列崩溃对照 | 餐厅 L2、SQ=5:基线 0.0% vs 本文 75.0% MSR | 无记忆基线越做越崩 |
| 执行效率 | AEST 普降 20–70%;家庭 L2/SQ=5 从 41.4 → 15.5(-63%) | AEST=平均每次任务执行步数(越低越熟练) |
| 高难度 L3 | 超市 MSR +63.5%、家庭 +58.3%,AEST 再降 >70% | 全局复合技能仍有效 |
| 编队扩展 | 同构轮式 1→3→5 台:AEST -58% / -76% | 人越多越快,近单调 |
| 任务难度标定 | 简单 <20 节点、中 20–30、难 40–50 节点 | 场景树/关系图节点数 |
| 失败归因 | 45.3% 错误来自工具调用 | 其余为记忆操作与子任务生成敏感性 |
| 场景 × 难度 × 序列 | 餐厅/超市/家庭 × L1–L3 × SQ=1/3/5 | 三轴评测矩阵 |
🗺️ 仿真 vs 真机:一眼分清
| 场景 | 类型 | 说明 |
|---|---|---|
| 餐厅 / 超市 / 家庭 三场景 | 仿真(多机器人) | 主实验:L1–L3 难度、SQ=1/3/5 任务序列、轮式/人形/四足编队 |
| 记忆消融与错误模式 | 仿真 | Table III/IV:掉记忆会怎样、拆 STEM 各组件会怎样 |
| Fig. 4 真机演示 | 真机(演示) | 餐厅、家庭、超市三类真机多机器人协同实拍——展示可部署性,非大表刷榜 |
🧭 读前 5 分钟:四个概念
- STEM(时空-本体记忆):Spatial(场景几何:房间/区域/物体位置)+ Temporal(事件史:刚做过什么、状态变过什么)+ Embodiment(本体档案:这台机器人的能力/位置/状态),三合一、全员共享,自上而下按「队列」式组织、支持持续写入更新。
- 大脑-小脑:大脑=高层 VLM 模型,只通过检索/更新 STEM 做全局推理与任务分解;小脑=技能库(导航、抓取、放置……工具可插拔),负责低延迟局部执行。
- MSR / AEST / SS:MSR=边际成功率(序列里维持稳定的成功能力);AEST=平均每任务执行步数(越低越熟练);SS=每步成功比(效率与正确性的复合指标)。
- 无记忆基线:只感知「当前房间」的对照组——本论文所有增益都以它为尺子。
🛠️ 方法:共享记忆 + 四阶段流水线
STEM 记忆怎么组织
- 三类信息入同一表示:空间(场景树:区域/载体节点 + 物体关系图)、时间(事件队列:执行状态事件刷新)、本体(能力档案:谁会干什么、在哪);
- 机器人完成子任务后主动写事件(如「B 收完垃圾」→ 立刻可被检索来支援 A 的叠衣任务);
- 任何机器人都能查同一份记忆 → 「Robot-A 掉线,Robot-C 无缝顶班」成为可能。
四阶段工作流(Fig. 2)
- 全局任务分解:大脑读 STEM,把「给我拿苹果」这类全局任务拆成可执行子任务链;
- 拓扑子任务分配:按场景拓扑(谁离得近、谁有能力)把子任务派给具体机器人;
- 分布式子任务 Agent:各机器人本地小脑执行(工具调用:移动/检测/开柜/抓取……),不必回传每一步;
- 动态记忆更新:执行结果与状态事件写回 STEM,闭环。
容错与长程
- 子任务生成与工具调用都带反馈回路;失败模式被显式建模(E1 掉线/失效、E2 工具故障等,见实验);
- 「回忆起水果在冰箱」这类跨时间澄清由 Temporal 记忆支撑(Fig. 1 右上示例:没有苹果 → 提议香蕉)。
📸 逐图讲解(Fig. 1 ~ 4)
Figure 1:总览——STEM 白板上的三特性
(即文首头图。)上半左右分列三大承诺:终身适应 / 可扩展协作 / 鲁棒调度;中央是共享的 Spatial-Embodiment Memory + Temporal-Embodiment Memory,左侧大脑(Brain Model)+ 小脑技能(Cerebellum Skills:Move to Table、Pick up the Plate、Detect a Fork……)与工具调用-反馈环。下半三个漫画格是记忆的三种用法:
- 动态增援:B 收完垃圾立刻去帮 A 叠衣服;
- 跨时间澄清:主人要苹果 → 机器人答「水果早放进冰箱了,没有苹果,香蕉行吗」;
- 掉线接管:A 离线 → C 顶上桌面整理。
读图抓手:记忆不是某个机器人的私产,而是团队的共享白板——这是全文所有结论的前提。
Figure 2:四阶段流水线
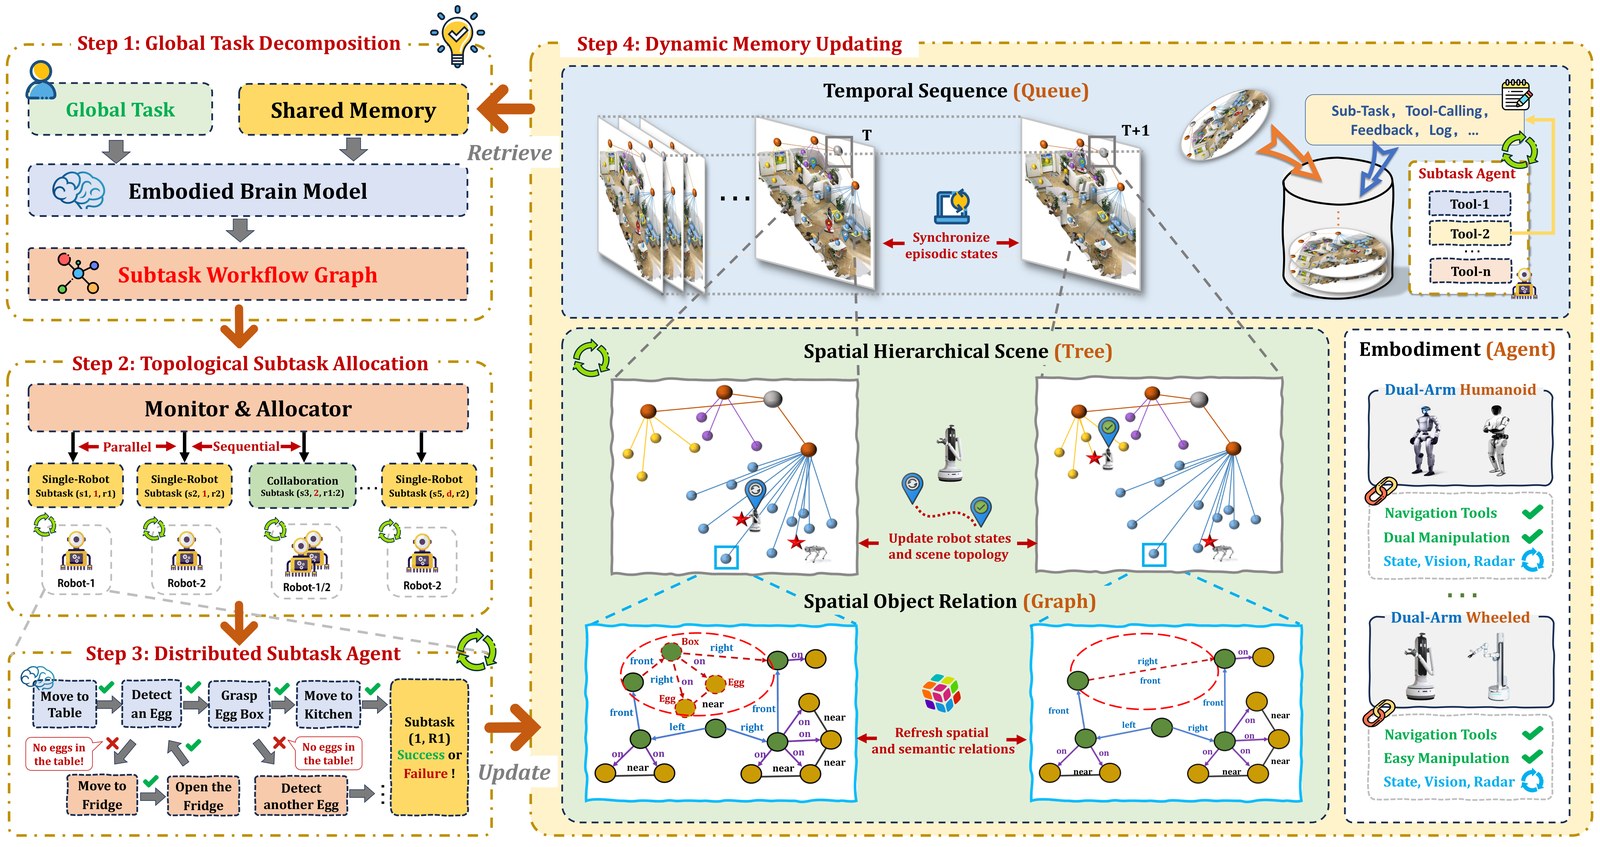
一条全局任务从左到右过四关:(1) 全局任务分解(大脑+STEM 拆链)→ (2) 拓扑子任务分配(按场景拓扑派单)→ (3) 分布式子任务 Agent(各本体小脑+工具并行执行)→ (4) 动态记忆更新(结果写回)。图中还能看到子任务、工具调用与反馈箭头如何回到记忆层。评测视角:阶段 1/2 出错=子任务生成错误,阶段 3 出错=工具调用错误(后者占 45.3%,见 Fig. 3)——这张图就是失败归因的坐标系。
Figure 3:餐厅场景失败分布
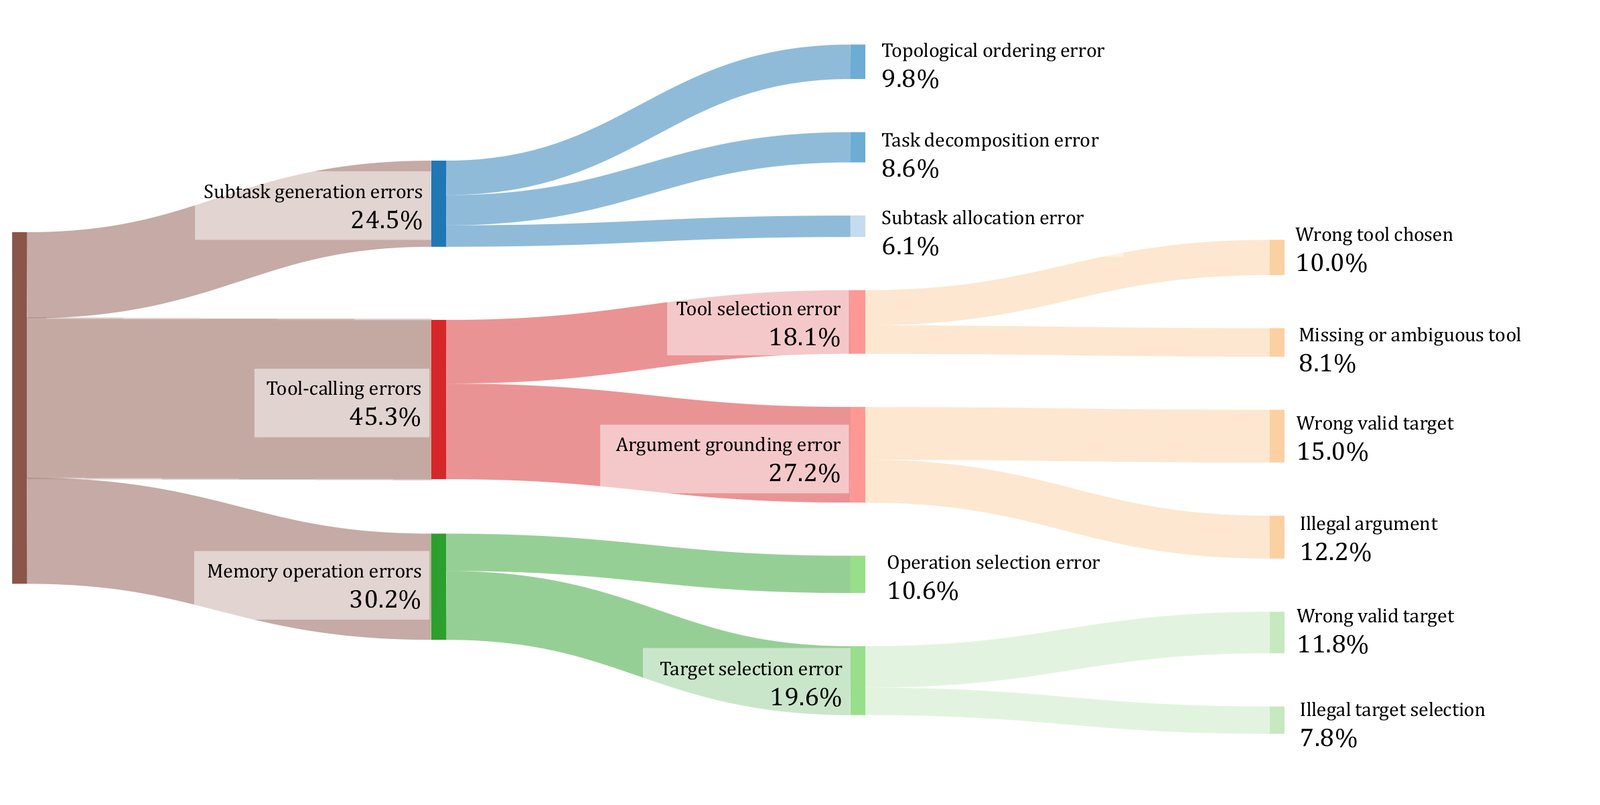
餐厅场景下各类错误的占比条图:大头在工具调用(约 45.3%)与记忆操作,子任务生成也有一定敏感性。解读:在共享记忆框架里,「想对了但做错动作」仍是最脆弱环节——调度层再好,抓取/导航工具不稳照样输;这也说明大脑系统不能替代底层技能质量,只是把错误暴露得更清楚。
Figure 4:真机三场景演示
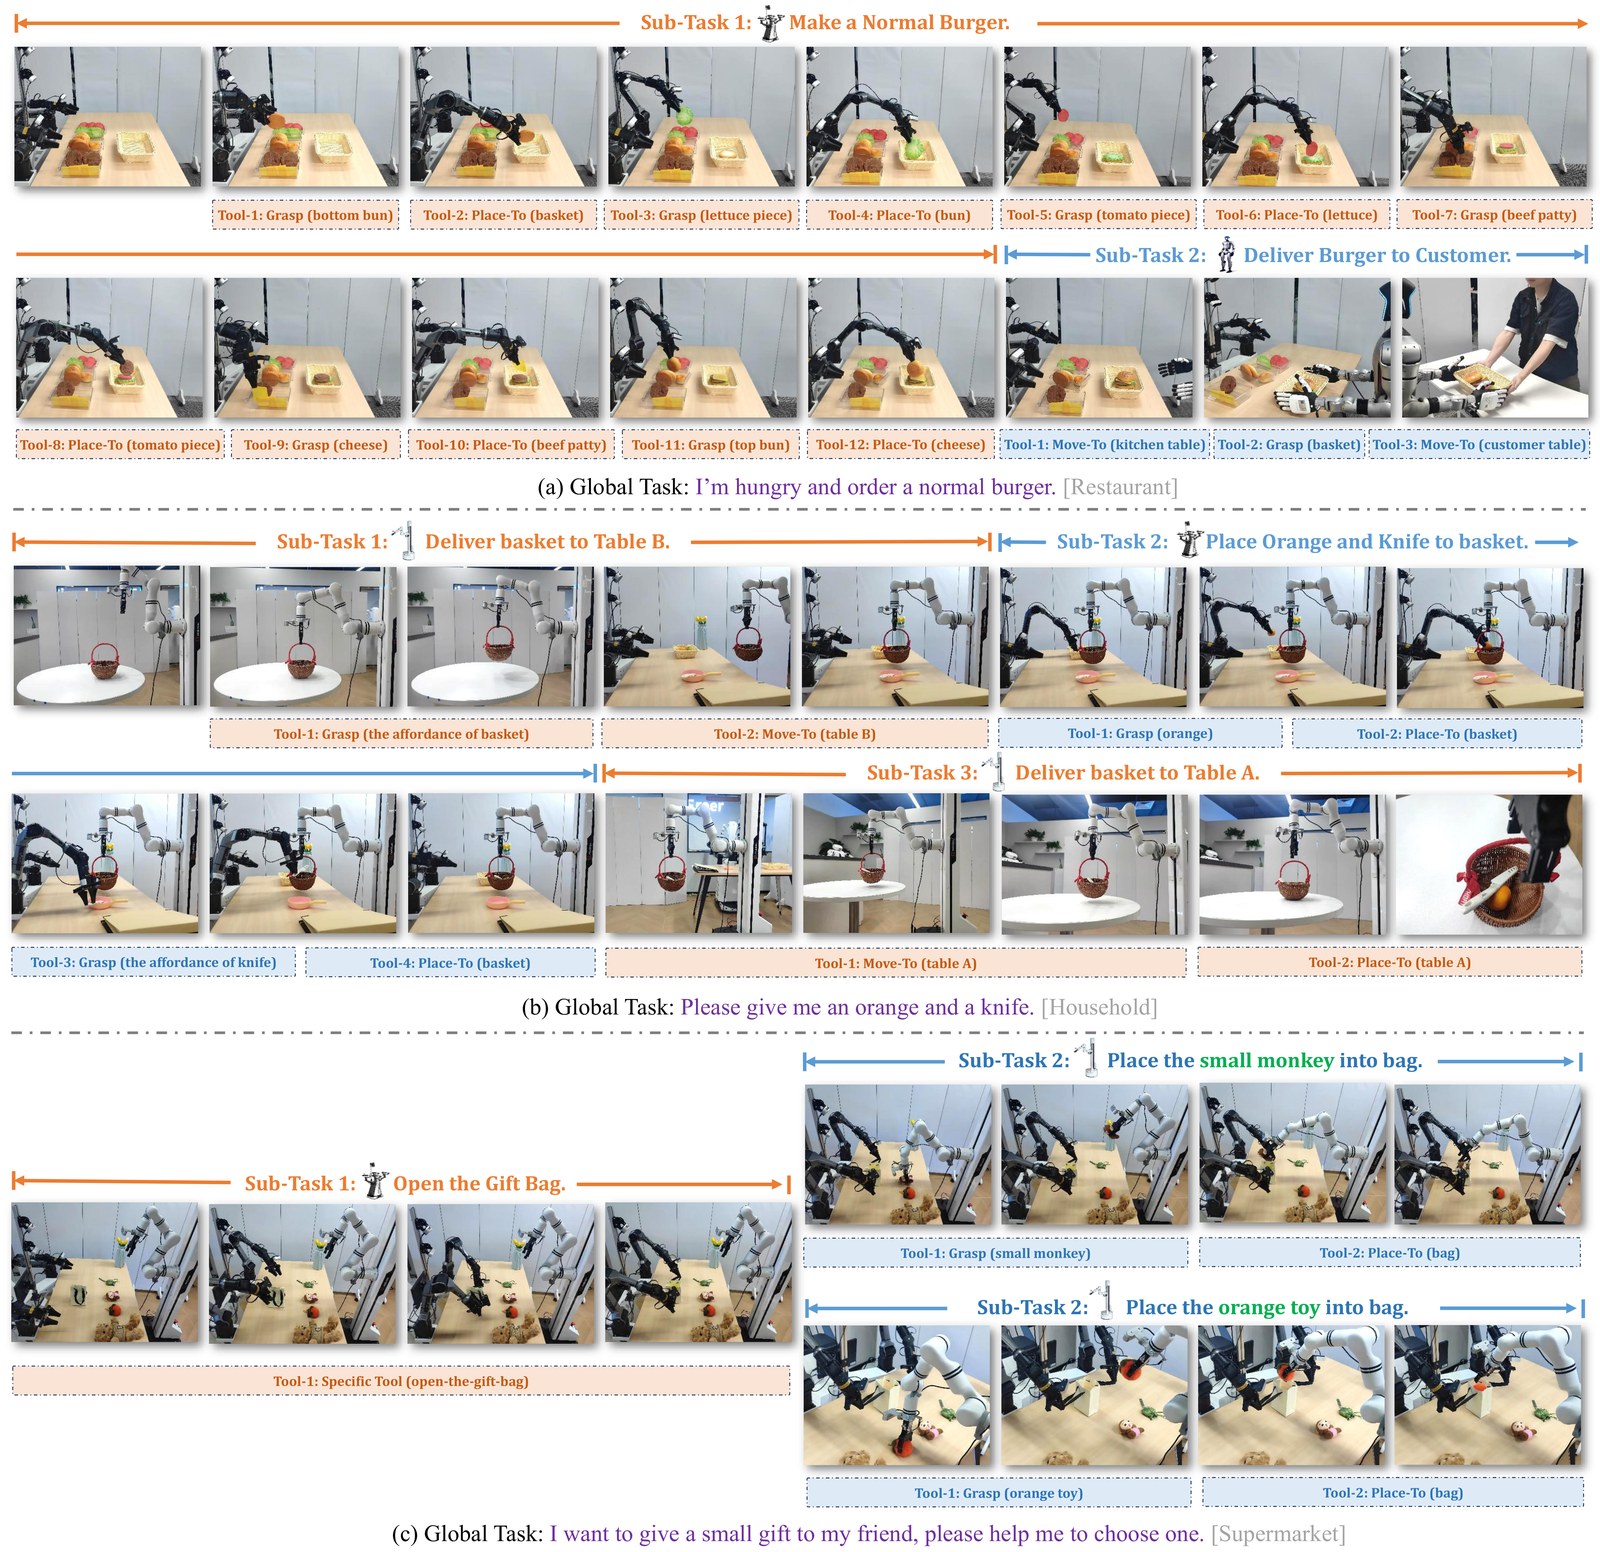
真机实拍三联:(a) 餐厅(多台机器人传菜/收桌协作)、(b) 家庭(桌面整理等家务协同)、(c) 超市(货架取放/补货类协作),均为多本体(轮式为主)同场。注意论文定位:这是可部署性展示,量化结论以仿真实验为准——读榜时把「演示」与「成绩」分开。
🧪 实验:三个轴回答三个问题
RQ1 终身适应(Table I)——记忆是否扛得住长序列
矩阵 = 三场景 × L1–L3 × SQ=1/3/5,指标 MSR↑ / AEST↓,对照「只看当前房间」的无记忆基线:
- 崩溃差:SQ=5 时基线归零级(餐厅 L2:0% vs 75%)——长序列没有记忆必崩;
- 越用越熟:AEST 降 20–70%(家庭 L2/SQ=5:41.4→15.5);
- 难任务同样成立:L3 超市 MSR +63.5%、家庭 +58.3%。
RQ2 协作扩展(Table II)——人越多是否越乱
同构轮式 1→3→5 台相对单机 AEST -58% / -76%(近单调);异构编队(轮式+人形+四足)报告 SR/SS——分配拓扑随本体档案自动变化。结论:共享记忆摊平了协调开销,规模化是净收益。
RQ3 鲁棒性(Table III/IV + Fig. 3)
- 错误模式注入(掉线、工具故障……)下仍显著优于无记忆基线;
- STEM 组件消融:拆掉空间/时间/本体任一环,AEST/SR/SS 同步变差——「三合一」缺一不可;
- 失败分布(Fig. 3)指明下一步该修工具层。
💡 评析:三个亮点,三条边界
三个亮点
- 把「多机器人」的难题收敛成一个表示问题:调度、容错、长程全部落在「读写同一块 STEM」上——机制少、可消融、可解释(Table IV 直接拆给你看)。
- 指标设计贴实际:MSR 专抓「序列里稳不稳」,AEST 抓「熟不熟」——比单点成功率更能体现「终身」。
- 失败分析不留面子:45.3% 错误在工具调用——明确告诉读者调度层的天花板在哪。
三条边界
- 大脑仍是「外挂大模型」:规划质量依赖 VLM;论文未深挖大脑本身换代的影响(ABot-AgentOS 有主 LLM 换代实验,见姊妹篇)。
- 量化以仿真为主,真机是演示级;跨楼栋/跨楼层的「超长程」未覆盖。
- 记忆写入靠工具事件:传感噪声下的记忆污染(写错白板)没有系统实验。
🗺️ 在「具身大脑系统」谱系里的位置
- 单机 vs 多机:EmbodiedEvo / HexaShell 是「一台机器人的经验演化」;本文是「多台机器人的共享记忆与调度」;ABot-AgentOS 是「单机的 OS 化运行时 + 终身自进化」。
- 大脑系列:同线还有 RoboBrain/EmbodiedGPT 等「具身大脑」VLM(论文相关工作一节梳理);本文差异在记忆中心 + 多机调度而非又一个大脑模型。
- 与小脑(VLA/WAM)关系:大脑下发子任务与工具调用,π0.7 类策略可当其小脑;RoboDojo 榜测的正是一端能力,大脑调度测的是另一端。
- 谱系标签:多机器人调度 / 共享记忆 / 大脑-小脑分层。
📊 图表总索引
| 图 | 内容 | 本站文件 |
|---|---|---|
| Fig. 1 | 总览:STEM 白板 + 大脑-小脑 + 三特性漫画 | 本文插图 |
| Fig. 2 | 四阶段流水线 | 本文插图 |
| Fig. 3 | 餐厅场景失败分布 | 本文插图 |
| Fig. 4 | 真机餐厅/家庭/超市演示 | 本文插图 |
(Table I 终身适应、Table II 扩展性、Table III 错误模式、Table IV STEM 消融——正文已复现关键数字。)
❓ 自测 Q&A
Q1:STEM 和普通「任务日志」差在哪?
日志只有时间线;STEM 还有空间几何(东西在哪)与本体档案(谁能干什么),且是所有机器人共享、可检索的结构化表示——调度与澄清都靠后两者。
Q2:为什么基线在 SQ=5 会崩到 0%?
基线只看当前房间:第 4、5 个任务的前提状态(谁做过什么、物品去向)全部丢失,子任务生成越走越偏;本文靠 Temporal 记忆维持前提。
Q3:大脑-小脑是谁快谁慢?
小脑(技能+工具)低延迟每步执行;大脑(VLM)低频介入做分解/分配/纠偏——与「快慢双系统」VLA 的分工同构,只是这里大脑还管跨机器人。
Q4:45.3% 工具调用错误说明什么?
调度与记忆已经把「想错」的概率压低,剩下主要是「做错」——下一步收益在技能/工具层,而不是继续堆规划复杂度。
Q5:和 ABot-AgentOS 选哪个?
多机协同、共享记忆、编队调度 → 本文;单机全功能 OS(边云双模型、图记忆、自进化、可部署学生策略)→ ABot-AgentOS。
📚 资源与延伸
- 论文:arXiv 2510.26536
- 姊妹篇:ABot-AgentOS 精读
- 同主题精读:EmbodiedEvo 精读、HexaShell 精读、RoboDojo 精读、π0.7 精读
- 知识铺垫:什么是世界模型、WAM 世界行动模型全景分析