📄 论文信息
- 标题:RT-1: Robotics Transformer for Real-World Control at Scale(RT-1:面向大规模真实世界控制的机器人Transformer)
- 团队:Google Robotics at Google, Everyday Robots(Anthony Brohan, Noah Brown, Justice Carbajal, Yevgen Chebotar, Chelsea Finn, Karol Hausman, Sergey Levine 等51位作者)
- 发表:arXiv 2022.12(CoRL 2023接收)
- 关键词:Transformer、机器人策略学习、模仿学习、大规模数据、泛化
- 一句话总结:通过在13万+真实机器人轨迹上训练Transformer策略,RT-1首次在机器人领域展示了类似NLP/CV中观察到的scaling law,实现了对新任务、新物体、新环境的强泛化能力。
- 论文链接:arXiv:2212.06817
- 代码链接:robotics_transformer
🤔 要解决什么问题?
机器人领域的"数据饥渴"困境
在计算机视觉(CV)和自然语言处理(NLP)领域,大规模预训练模型已经展示了一种强大的范式:从大规模、多样化、任务无关的数据集中学习通用表示,然后通过少量数据微调或零样本迁移来解决下游任务。GPT系列、CLIP、ViT等模型的成功无不依赖于这一范式。
然而,机器人领域长期面临一个根本性挑战:真实世界机器人数据的收集极其昂贵且困难。与互联网上唾手可得的文本和图像数据不同,机器人需要在物理世界中与物体交互,每次数据采集都需要:
- 物理设备成本:机器人硬件本身昂贵
- 时间成本:每条轨迹需要实时执行
- 安全性约束:机器人可能损坏物体或自身
- 标注成本:需要人类遥操作或演示
这导致机器人数据集规模通常只有数千条轨迹,远远无法支撑大规模模型的训练。之前的方法如BC-Z(Google 2021)虽然也收集了较多数据,但其模型架构(如ResNet+Transformer)的容量有限,无法有效吸收海量多样化数据。
核心问题
能否找到一种模型架构,能够像大语言模型吸收文本数据一样,有效地吸收大规模、多样化的机器人数据,并展现出类似的scaling性质?
具体来说,RT-1试图回答三个关键问题:
- 什么样的架构能够随着数据量和模型规模的增长而持续提升性能?
- 能否在真实机器人上收集足够规模的数据来验证这一假设?
- 训练好的模型能否泛化到未见过的任务、物体和环境?
💡 核心方法
整体思路
RT-1的核心思想非常直观:借鉴NLP/CV领域的成功经验,用高容量Transformer架构配合大规模真实数据来训练机器人策略。
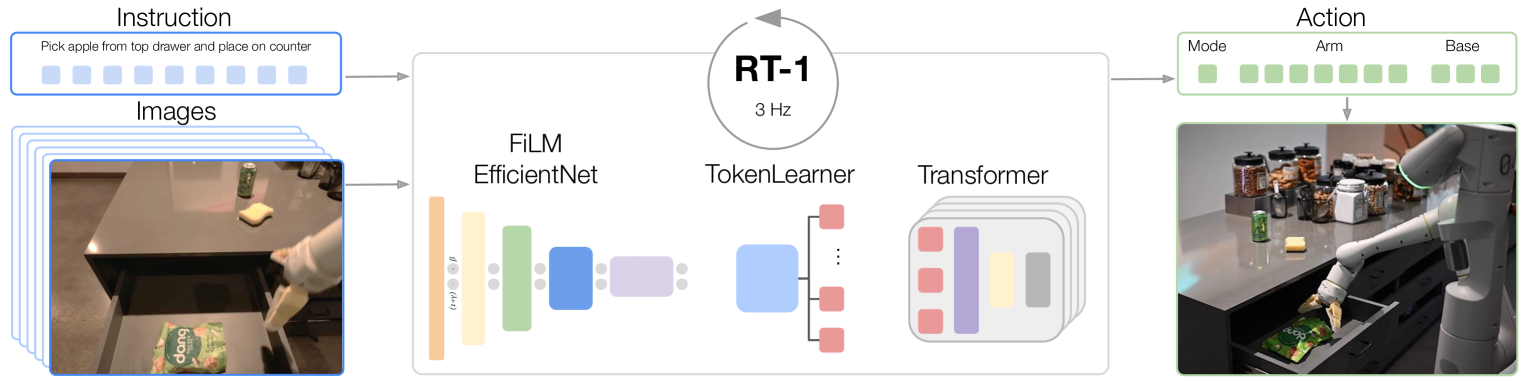
上图是RT-1的核心架构图,展示了完整的数据处理流程:
- 输入层:机器人在每个时间步接收3帧连续图像 $I_t, I_{t-1}, I_{t-2}$(300×300分辨率)和自然语言指令 $l$(如"pick up the Coke can")
- 视觉编码:每帧图像通过FiLM-Conditioned EfficientNet-B3进行编码,语言指令通过FiLM层注入视觉特征,使模型"根据指令选择性关注"相关视觉信息
- Token压缩:Token Learner模块将每帧约900个视觉token压缩为16个学习到的token(3帧共48个),大幅降低计算成本
- Transformer解码:压缩后的视觉token与语言指令token一起送入8层Transformer解码器
- 动作输出:Transformer输出经过分类头预测11维离散化动作(机械臂7维 + 底盘3维 + 模式切换1维)
给定一组图像观测 $o_t = \{I_t, I_{t-1}, I_{t-2}\}$(当前帧和历史帧)以及自然语言指令 $l$,策略 $\pi$ 需要输出机器人动作 $a_t$:
$$a_t \sim \pi(\cdot | o_t, l)$$模型架构详解
RT-1的架构由三个核心组件构成:
1. 视觉编码器:FiLM-Conditioned EfficientNet
首先,使用预训练的EfficientNet-B3作为视觉编码器来处理图像输入。为了让视觉编码器关注与指令相关的视觉特征,RT-1采用了FiLM(Feature-wise Linear Modulation)条件化机制:
$$\gamma(l) = W_\gamma \cdot \text{Embed}(l) + b_\gamma$$$$\beta(l) = W_\beta \cdot \text{Embed}(l) + b_\beta$$$$\text{FiLM}(F_i) = \gamma(l) \cdot F_i + \beta(l)$$其中 $F_i$ 是EfficientNet中间层的特征图,$\text{Embed}(l)$ 是通过预训练语言模型(如Universal Sentence Encoder)得到的指令嵌入。FiLM层在EfficientNet的多个中间层插入,通过仿射变换将语言信息注入视觉特征,使得模型能够根据指令"选择性关注"相关视觉信息。
2. Token Learner模块
经过EfficientNet编码后,每帧图像会产生 $H \times W$ 个视觉token(例如对于300×300的输入,约有900个token)。为了降低计算成本,RT-1引入了Token Learner模块:
Token Learner使用两层自注意力(self-attention)网络,将大量视觉token压缩为少量(16个)“学习到的"token:
$$T_{\text{learned}} = \text{Softmax}(W_2 \cdot \text{ReLU}(W_1 \cdot T_{\text{visual}})) \cdot T_{\text{visual}}$$其中 $T_{\text{visual}}$ 是视觉token序列,$W_1 \in \mathbb{R}^{16 \times N}$,$W_2 \in \mathbb{R}^{N \times 16}$ 是可学习参数。这一模块的核心价值在于:
- 降低计算复杂度:从 $O(N^2)$ 降低到 $O(16^2)$ 的注意力计算
- 保留关键信息:通过可学习的注意力机制保留最重要的视觉信息
- 统一输入长度:无论输入图像分辨率如何,输出token数量固定
3. Transformer解码器
压缩后的视觉token(每帧16个,3帧共48个)加上语言指令token,送入一个标准的Transformer解码器。该解码器包含8层Transformer,隐藏维度为512,使用8个注意力头。
Transformer的输出经过分类头(MLP)预测离散化的动作token。RT-1将连续动作离散化为256个bin,每个动作维度独立离散化,总动作空间维度为:
$$a_t = [x_{\text{arm}}, y_{\text{arm}}, z_{\text{arm}}, \text{roll}, \text{pitch}, \text{yaw}, \text{gripper}, x_{\text{base}}, y_{\text{base}}, \text{yaw}_{\text{base}}, \text{mode}]$$其中:
- 机械臂动作:7维(x, y, z, roll, pitch, yaw, gripper)
- 底盘动作:3维(x, y, yaw)
- 模式切换:1维(控制机械臂/控制底盘/终止)
训练方法
RT-1采用**行为克隆(Behavioral Cloning)**进行训练,损失函数为:
$$\mathcal{L} = -\sum_{i=1}^{T} \log \pi_\theta(a_t^{(i)} | o_t^{(i)}, l^{(i)})$$其中每个动作维度独立计算交叉熵损失。训练使用Adam优化器,学习率 $3 \times 10^{-4}$,并采用cosine学习率衰减。模型在TPU v4 pods上训练约17天。
推理流程
在推理时,RT-1执行闭环控制(closed-loop control):
- 以3Hz频率接收图像观测
- 将最近3帧图像与语言指令送入模型
- 模型输出离散化动作
- 动作解码为连续值后发送给机器人执行
- 重复直到模型输出"终止"动作或达到时间步上限
🧪 实验验证
数据集:大规模真实机器人数据
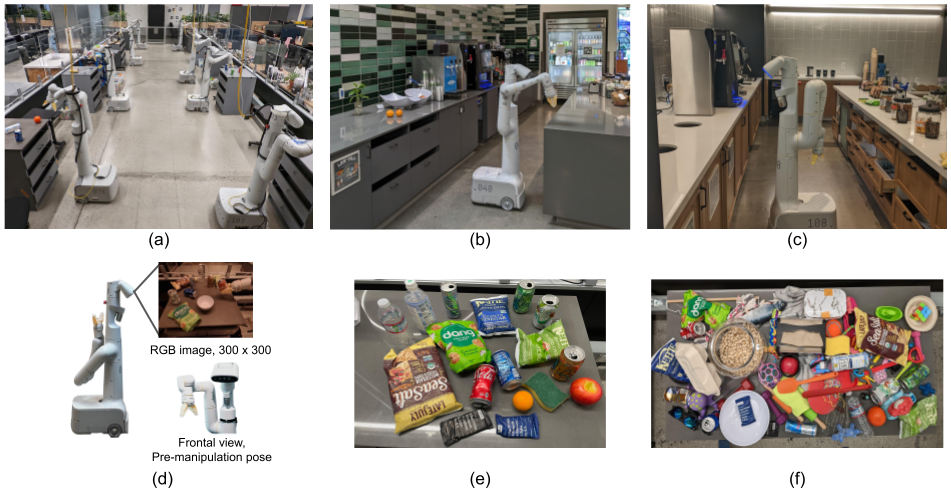
RT-1最重要的贡献之一是构建了当时最大的真实机器人操作数据集:
| 属性 | 数值 |
|---|---|
| 总轨迹数 | 130,000+ |
| 任务种类 | 700+ |
| 机器人数量 | 13台 |
| 收集时间 | 17个月 |
| 机器人类型 | Everyday Robots移动操作机器人 |
| 动作空间 | 11维(含模式切换) |
| 控制频率 | 3Hz |
数据集覆盖了多种技能类别:
- 抓取(Pick):从桌面/抽屉中抓取物体
- 放置(Place):将物体放到指定位置
- 开关抽屉(Open/Close Drawer):操作抽屉
- 抽屉取物(Get from Drawer):从抽屉中取出物品
- 竖立放置(Place Upright):将细长物体竖立放置
- 推倒(Knock Over):将物体推倒
- 抽取纸巾(Pull Napkin):从纸巾盒中抽取纸巾
- 拧开罐子(Open Jar):拧开罐子盖子
对比基线
RT-1与以下基线进行了对比:
- BC-Z(2021):Google此前最大的机器人模仿学习模型,基于ResNet+Transformer
- BC-Z XL:与RT-1参数量相当的BC-Z变体
- Gato(DeepMind 2022):多模态多任务模型
核心实验结果
1. 基础性能对比
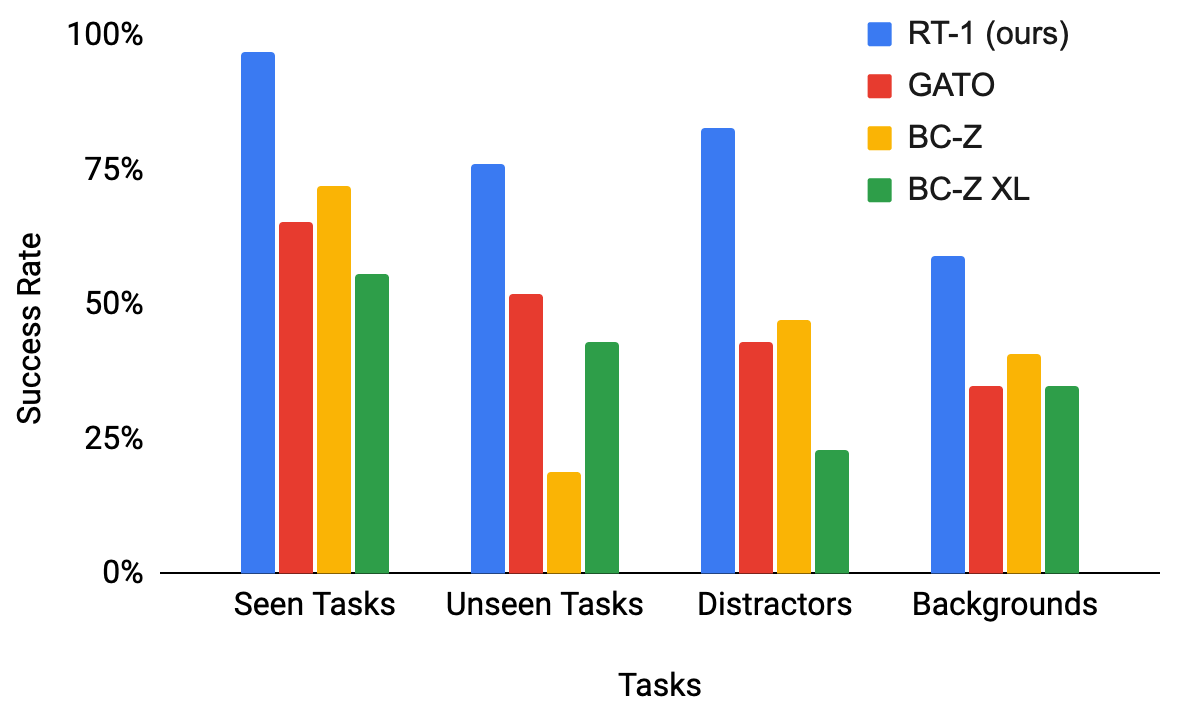
在已见任务(Seen Tasks)上的成功率:
- RT-1: 97%(700+指令中的绝大多数)
- BC-Z: 72%
- BC-Z XL: 66%
- Gato: 65%
RT-1在已见任务上达到了97%的成功率,显著超过所有基线。这表明RT-1能够有效地从大规模数据中学习多种技能。
2. 未见任务泛化(Novel Tasks)
在从未见过的新指令上的成功率:
- RT-1: 76%
- BC-Z: 52%
- BC-Z XL: 44%
- Gato: 38%
RT-1在未见任务上达到了76%的成功率,比次优基线高出24个百分点。这证明了Transformer架构的强大泛化能力。
3. 干扰物鲁棒性(Distractor Robustness)
在桌面存在额外干扰物体时的成功率:
- RT-1: 83%
- BC-Z: 47%
- Gato: 38%
4. 背景鲁棒性(Background Robustness)
在未见过的新厨房环境中的成功率:
- RT-1: 59%
- BC-Z: 41%
- Gato: 28%
5. 真实厨房部署(Real Kitchen Deployment)

在真实的办公厨房中测试三个递进难度的任务:
- L1:适应新的台面布局和光照条件
- L2:额外适应未见过的干扰物体
- L3:额外适应全新的任务设置、新物体或物体在新位置
| 方法 | L1 | L2 | L3 |
|---|---|---|---|
| RT-1 | 90% | 70% | 50% |
| BC-Z | 60% | 40% | 20% |
| Gato | 70% | 30% | 10% |
RT-1在所有难度级别上都显著优于基线,展示了强大的跨域泛化能力。
6. 异构数据吸收能力
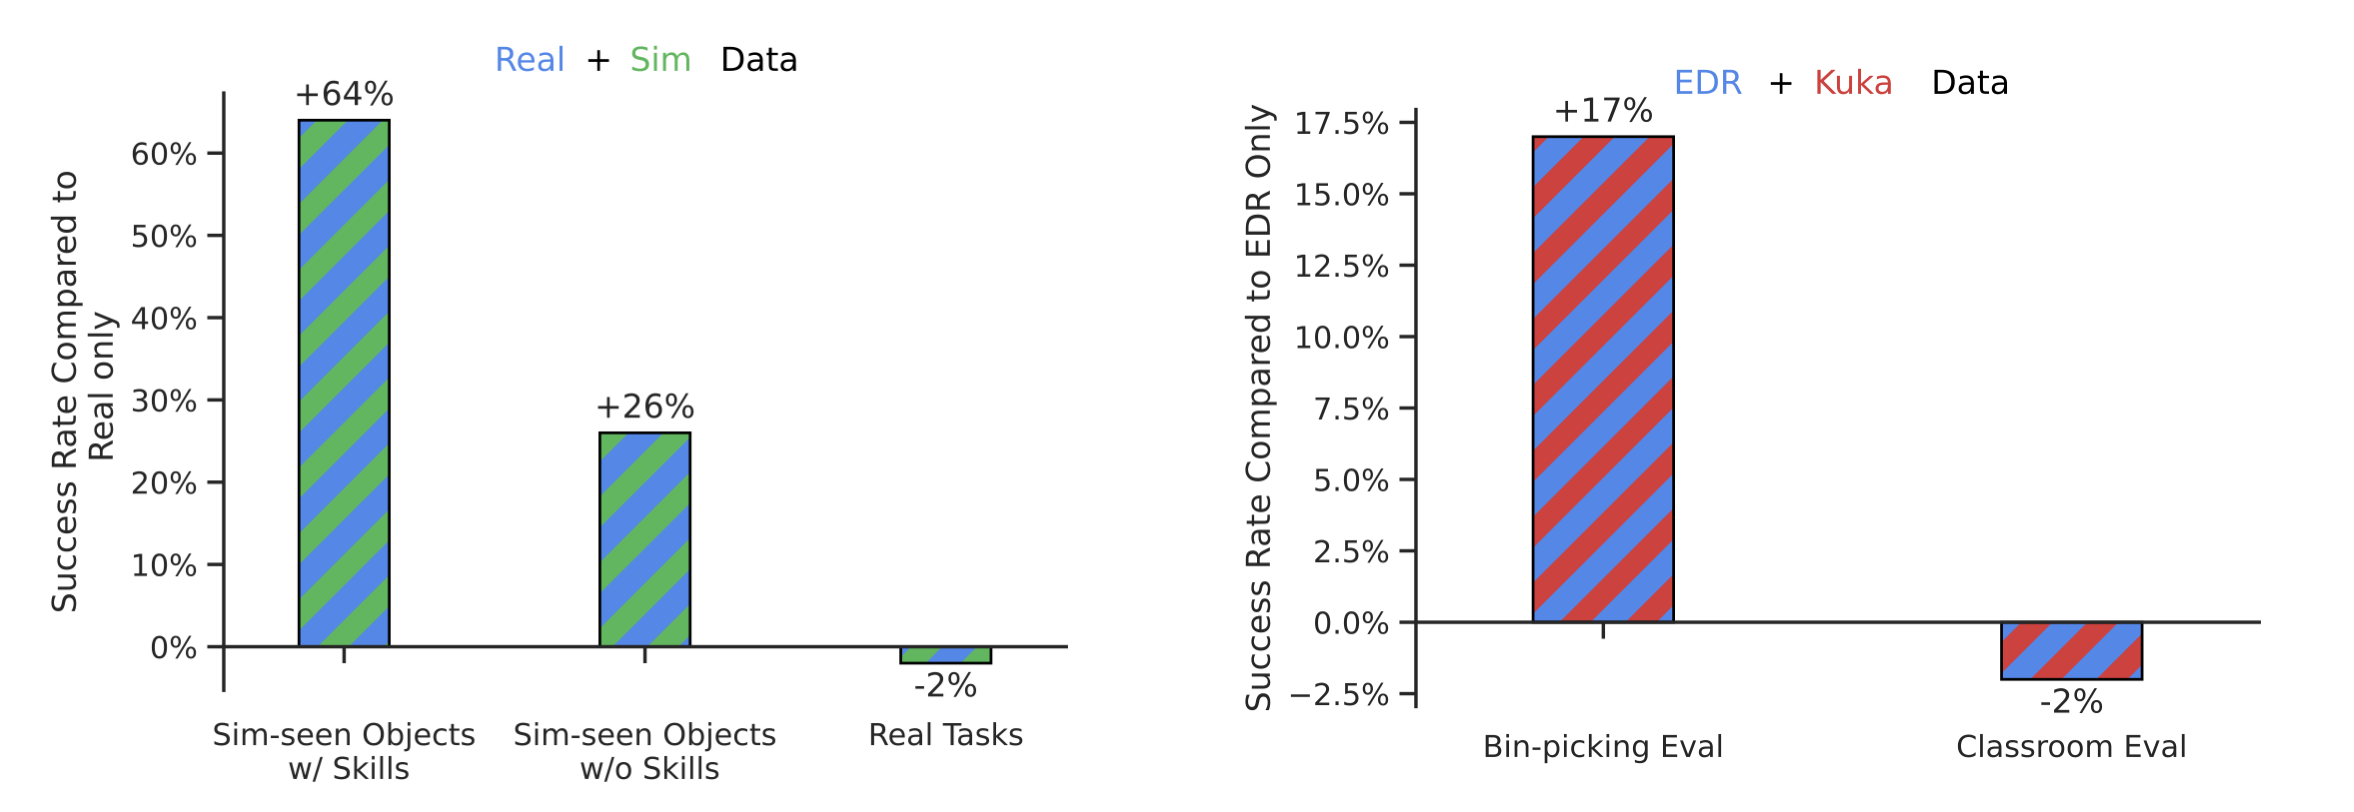
RT-1展示了吸收异构数据的能力:
仿真数据融合:将仿真环境中收集的数据与真实数据混合训练,在仿真中见过但真实中未见过的物体上,成功率从44%提升到65%(+21%),且在其他物体上的性能仅下降2%。
跨机器人数据融合:将Kuka IIWA机器人收集的抓取数据与原始数据混合训练,在特定任务上的成功率从22%提升到39%(+17%,近2倍提升)。这展示了跨机器人形态的有效迁移,是一个激动人心的方向。
7. 与SayCan框架的集成
RT-1还可以与SayCan(语言模型规划框架)集成,执行长 horizon 任务。在Kitchen1中,SayCan+RT-1达到67%的执行成功率;在未见过的Kitchen2中,SayCan+Gato和SayCan+BC-Z性能急剧下降,而RT-1没有明显下降。
🔍 个人思考
亮点
数据驱动的范式验证:RT-1最重要的贡献是首次在机器人领域验证了scaling law的存在。通过精心设计的消融实验(不同数据量、模型大小、数据多样性),论文清晰地展示了数据和模型规模与性能之间的正相关关系。这为后续的RT-2等工作奠定了坚实基础。
工程规模令人印象深刻:13万条真实轨迹、13台机器人、17个月的数据收集——这在机器人学习领域是前所未有的。这种工程能力本身就构成了极高的门槛。
Token Learner的设计巧妙:通过将视觉token压缩到16个,RT-1在保持性能的同时大幅降低了计算成本。这种设计使得模型能够在标准TPU上高效训练。
FiLM条件化的有效性:通过在EfficientNet中间层注入语言信息,模型能够根据指令选择性关注相关视觉特征,这是一种优雅的多模态融合方式。
异构数据吸收能力:RT-1展示了将仿真数据和其他机器人数据融入训练的能力,这对于解决机器人数据稀缺问题具有重要意义。
局限性
单一机器人形态:RT-1的所有数据都来自同一种机器人(Everyday Robots),虽然论文展示了跨机器人迁移的潜力,但验证范围有限。真正的多形态通用策略仍是开放问题。
动作空间受限:RT-1的11维动作空间是为特定机器人设计的,缺乏对力控、接触力等精细操作的支持。这限制了其在需要精细力控的任务中的应用。
数据收集的可扩展性:虽然13万条轨迹已经很多,但要训练真正通用的机器人策略可能需要数百万甚至更多轨迹。如何高效地收集这些数据仍是挑战。
缺乏长horizon规划能力:RT-1本身是一个单步策略,需要与SayCan等外部规划器集成才能执行长序列任务。这增加了系统的复杂性。
仿真到真实的迁移有限:虽然论文展示了仿真数据的融合,但仿真到真实的gap仍然存在,特别是在涉及接触和力交互的任务中。
未来方向
RT-2的直接延续:RT-1的作者团队在2023年发布了RT-2,将视觉语言模型(VLM)直接用作机器人策略,进一步探索了预训练知识在机器人任务中的应用。
多形态数据融合:扩展到更多类型的机器人(如灵巧手、人形机器人),构建真正的多形态机器人基础模型。
更高效的数据收集:结合仿真、互联网视频、人类视频等多种数据源,降低真实数据收集的成本。
在线学习与适应:当前RT-1是离线训练的,如何让模型在部署后持续学习和适应新环境是重要方向。
与世界模型结合:将RT-1的策略学习与世界模型(world model)结合,实现更高效的规划和想象式推理。
📖 延伸阅读
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control(Brohan et al., 2023)- RT-1的直接后续工作,将VLM用于机器人控制
- BC-Z: Zero-Shot Task Generalization with Robotic Imitation Learning(Jang et al., 2021)- RT-1的重要基线和前驱工作
- Gato: A Generalist Agent(Reed et al., 2022)- DeepMind的多模态多任务模型
- Scaling Robot Learning with Semantically Imagined Experience(Mees et al., 2022)- 探索如何通过语义想象扩展机器人数据
- Do As I Can, Not As I Say: Grounding Language in Robotic Affordances(Ahn et al., 2022)- SayCan工作,展示了如何将语言模型与机器人技能结合
- PaLM-E: An Embodied Multimodal Language Model(Driess et al., 2023)- 将PaLM扩展为具身多模态模型
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion(Chi et al., 2023)- 基于扩散模型的机器人策略学习