📄 论文信息
- 标题:Do As I Can, Not As I Say: Grounding Language in Robotic Affordances(照我说的做,但要量力而行:将语言接地到机器人可供性中)
- 团队:Google Robotics at Google, Everyday Robots(Michael Ahn, Anthony Brohan, Noah Brown, Yevgen Chebotar, Chelsea Finn, Karol Hausman, Sergey Levine, Andy Zeng 等45位作者)
- 发表:CoRL 2022(arXiv 2022.04,v2更新PaLM版本 2022.08)
- 关键词:大语言模型、机器人规划、可供性、语言接地、长horizon任务
- 一句话总结:SayCan通过将LLM的语言知识(什么应该做)与机器人技能的affordance(什么能做)结合,首次实现了让LLM在真实机器人上规划和执行复杂的多步任务。
- 论文链接:arXiv:2204.01691
- 代码链接:saycan
🤔 要解决什么问题?
LLM的"眼高手低"困境
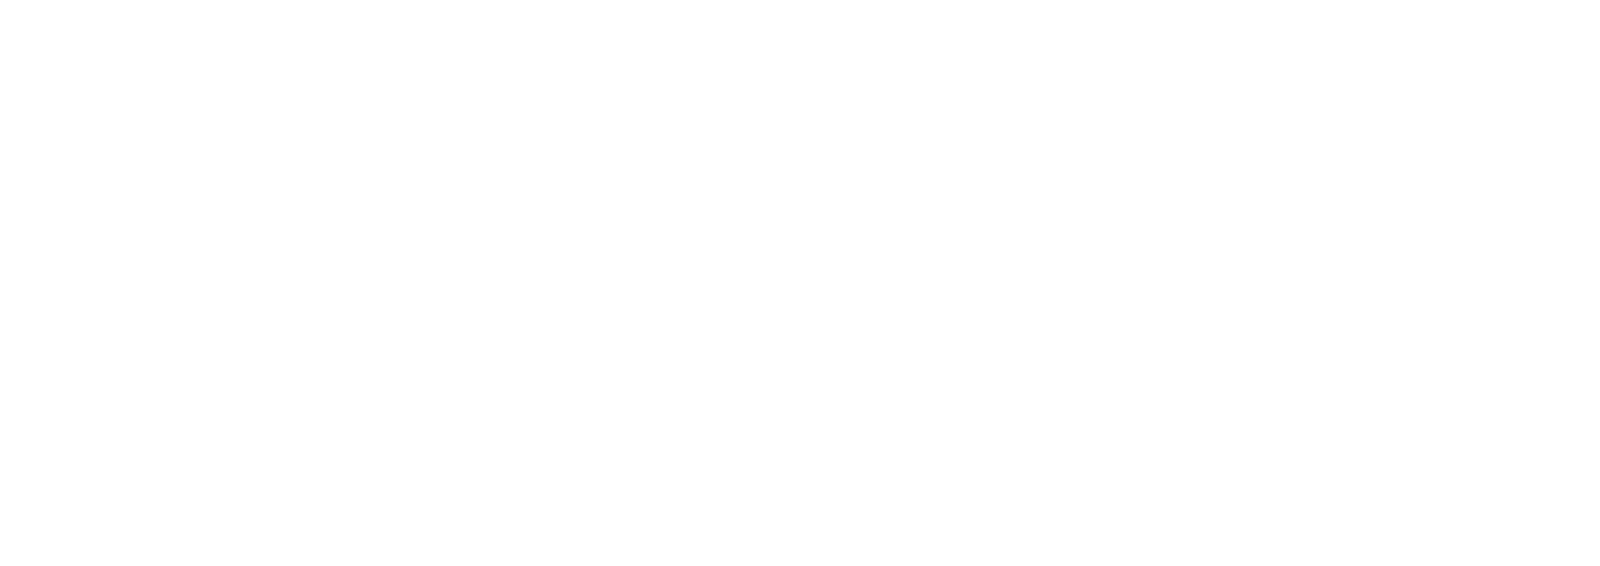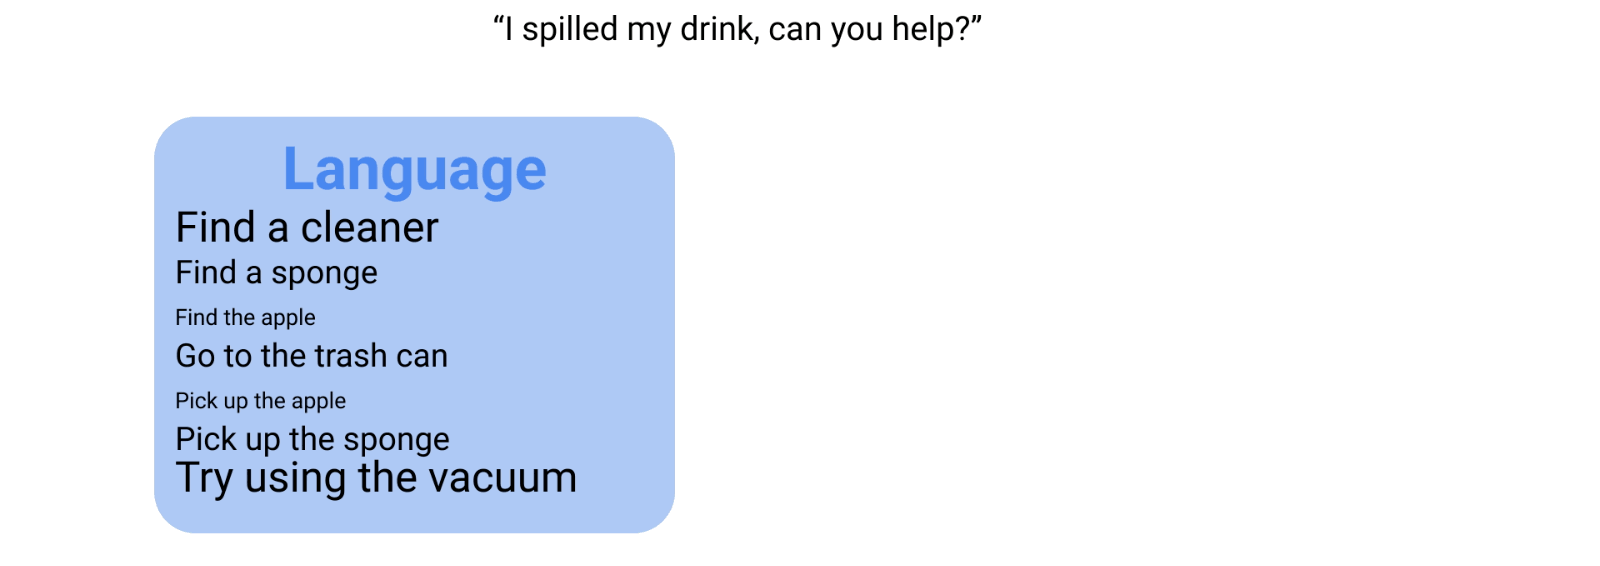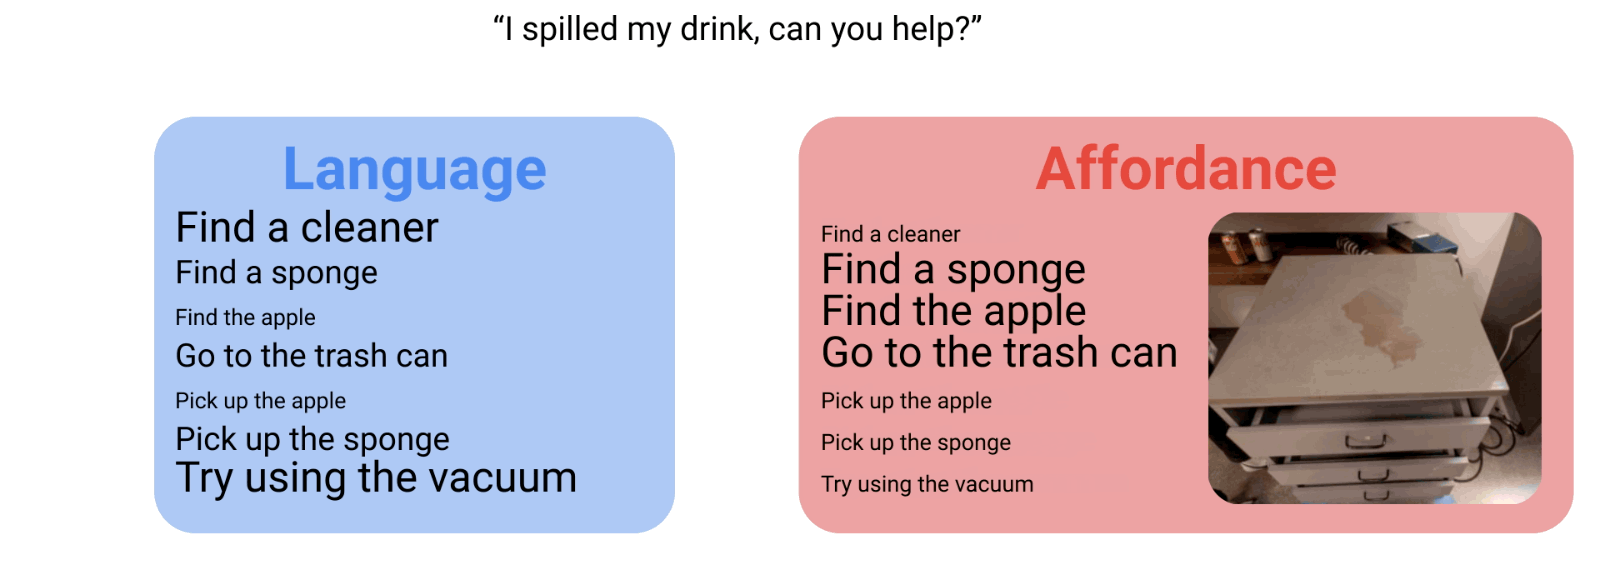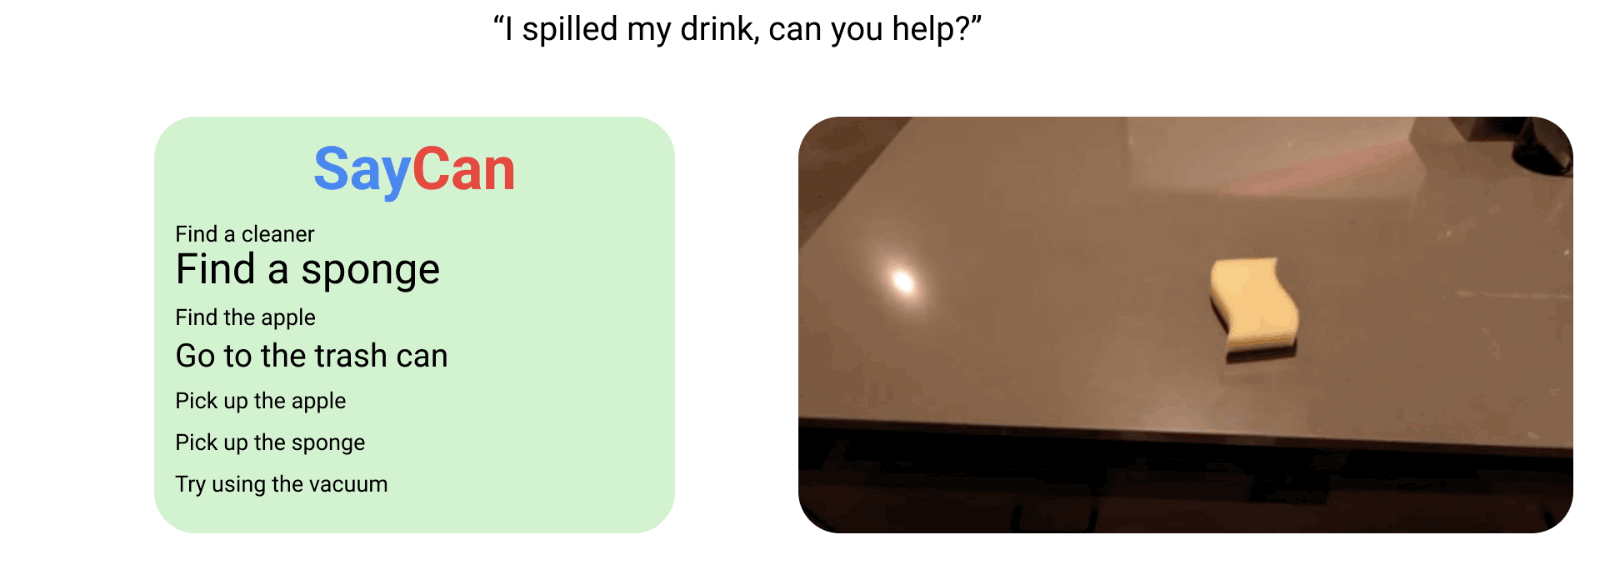
大型语言模型(LLM)如GPT-3、PaLM已经展示了惊人的知识储备和推理能力。当被问到"我洒了饮料,你能帮忙吗?“时,LLM可以给出合理的回答:
“你可以尝试用吸尘器清理” “对不起,我不是故意洒的”
这些回答在语义上是合理的,但对于一个机器人来说,这些回答完全不可执行:
- 机器人没有吸尘器
- 机器人无法理解"对不起"的含义
- 这些回答没有考虑机器人的实际能力
- 这些回答没有考虑当前环境中的可用物体
这就是所谓的**“接地问题”(Grounding Problem)**:LLM的知识是抽象的、脱离物理现实的,而机器人需要在具体环境中执行物理动作。LLM"知道"清洁溢出饮料的一般步骤,但它不知道:
- 当前环境中有哪些物体可用
- 这些物体在哪里
- 机器人能否物理上接触到它们
- 执行某个动作的成功概率是多少
传统方法的局限
之前的方法通常采用以下两种策略之一:
端到端学习:直接从语言指令学习到动作映射(如BC-Z)。这种方法缺乏语义推理能力,难以处理复杂指令。例如,BC-Z需要为每个任务收集大量演示数据,无法处理未见过的指令组合。
模块化系统:将语言理解、任务规划、运动控制分开处理。这种方法虽然可解释,但模块间的接口往往脆弱且不灵活。例如,语言理解模块可能输出"拿起红色的杯子”,但运动规划模块可能无法处理这种抽象描述。
纯LLM方法:直接让LLM生成动作序列。但LLM缺乏物理世界的接地知识,生成的动作可能不可行(如"飞到天花板上拿东西")。
SayCan的核心洞察
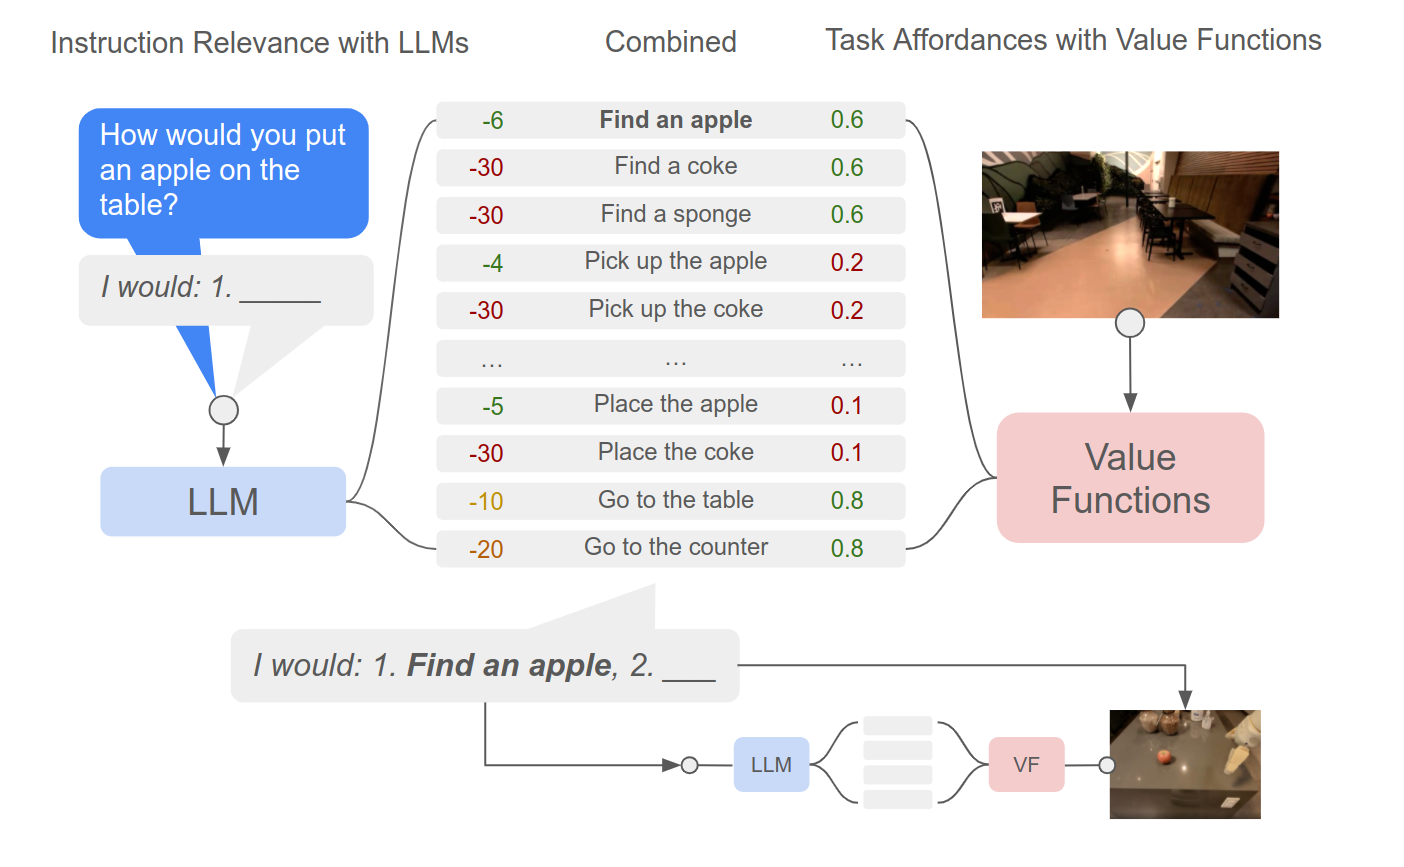
SayCan的核心思想是:LLM提供"应该做什么"的知识,而affordance函数提供"能做什么"的信息。两者结合,机器人就能做出既合理又可行的决策。
这个洞察来源于一个简单但深刻的观察:人类在执行任务时,也是同时考虑"我想做什么"和"我能做什么"。当我们说"帮我拿一下那个杯子"时,我们会自动评估:杯子在哪里?我能走到那里吗?我的手能抓住它吗?SayCan将这种人类的决策过程形式化为概率框架。
具体来说,给定一个高层指令(如"我洒了饮料,能帮忙吗?"),SayCan通过以下步骤处理:
- LLM提供语言概率:评估每个候选技能对完成任务的有用程度(如"找海绵"比"找杯子"更相关)
- Affordance函数提供可行性概率:评估每个技能从当前状态成功执行的概率(如"找海绵"需要先知道海绵在哪里)
- 两者加权选择:选择综合得分最高的技能执行
- 迭代执行:将执行结果反馈给系统,继续选择下一个技能,直到任务完成
💡 核心方法
整体框架
SayCan的核心公式非常简洁:
$$a^* = \arg\max_{a \in \mathcal{A}} P_{\text{LLM}}(a | l) \cdot P_{\text{affordance}}(a | s)$$其中:
- $a^*$ 是选择的最优技能
- $\mathcal{A}$ 是可用技能集合
- $l$ 是用户的高层自然语言指令
- $s$ 是当前环境状态
- $P_{\text{LLM}}(a | l)$ 是LLM给出的技能 $a$ 对完成指令 $l$ 的有用程度
- $P_{\text{affordance}}(a | s)$ 是从当前状态 $s$ 成功执行技能 $a$ 的概率
1. 语言模型(LLM):提供语义知识
LLM的角色是评估每个候选技能对完成用户指令的有用程度。具体来说,SayCan使用LLM计算条件概率:
$$P_{\text{LLM}}(a | l) = \frac{\exp(\text{score}(l, a))}{\sum_{a' \in \mathcal{A}} \exp(\text{score}(l, a'))}$$其中 $\text{score}(l, a)$ 是LLM对"给定指令 $l$,执行技能 $a$“的打分。
关键设计:提示工程(Prompt Engineering)
SayCan通过精心设计的提示词来获取LLM的概率估计。提示词包含:
- 角色设定:告诉LLM它是一个能执行特定技能的机器人
- 技能列表:列出所有可用技能及其描述
- 示例:提供1-2个输入输出示例
- 当前指令:用户的高层指令
例如,对于"我洒了饮料,能帮忙吗?“的提示词可能如下:
You are a robot operating in an office kitchen. When a human asks
you to do a task, you will respond with the sequence of actions
you would do to accomplish the task.

You can do the following:
- go to the sink
- go to the counter
- pick up the sponge
- pick up the cup
- wipe the counter
- ...

Human: I spilled my coke, can you help?
Robot: I would:
1.
LLM会生成如"1. find a sponge 2. pick up the sponge 3. wipe the counter 4. done"的序列,SayCan从中提取每个技能的概率。
2. Affordance函数:提供可行性评估
Affordance函数(也称为价值函数,value function)评估从当前状态执行某个技能的成功概率。这通常通过强化学习或模仿学习预先训练得到:
$$P_{\text{affordance}}(a | s) = \exp(Q_a(s) / \tau)$$其中 $Q_a(s)$ 是技能 $a$ 在状态 $s$ 下的Q值(预期回报),$\tau$ 是温度参数。
Affordance函数的关键作用:
- 可行性约束:LLM可能建议"拿起吸尘器清理”,但如果机器人没有吸尘器,affordance会给出极低的概率
- 环境感知:affordance函数基于真实传感器输入(图像、状态),能感知当前环境
- 物理约束:考虑机器人运动学、碰撞检测等物理限制
3. 迭代规划
SayCan采用迭代式规划策略,而非一次性生成完整计划:
- 用户给出高层指令 $l$
- LLM和affordance函数评估所有候选技能
- 选择综合得分最高的技能 $a_1$ 执行
- 将 $a_1$ 追加到对话历史中
- 重新查询LLM和affordance函数,选择下一个技能 $a_2$
- 重复直到输出"done"或达到最大步数
这种迭代式规划的优势在于:
- 允许中途调整:每一步都可以根据新的环境状态调整计划
- 处理不确定性:技能执行可能失败,迭代式规划可以重新规划
- 更自然的交互:模拟了人类逐步思考的过程
4. PaLM-SayCan:升级到更强的LLM
在v2版本中,SayCan从FLAN升级到PaLM,带来了显著的性能提升:
| 指标 | FLAN-SayCan | PaLM-SayCan |
|---|---|---|
| 计划成功率 | 70% | 84% |
| 执行成功率 | 61% | 74% |
PaLM-SayCan的改进:
- 更强的语义理解能力
- 更好的多步推理能力
- 支持Chain of Thought提示
- 支持多语言指令
5. 新能力:Chain of Thought与多语言
PaLM-SayCan展示了多种新能力:
Chain of Thought推理:通过提示"Let’s think step by step”,模型能够处理需要推理的任务。例如:“帮我准备运动后的恢复餐”——模型需要推理出"运动后需要补充水分和能量"。
多语言支持:虽然未专门设计,PaLM-SayCan能够处理中文、法语、西班牙语等多语言指令,且规划成功率几乎无下降。
新技能集成:只需在提示词中添加新技能描述和示例,PaLM-SayCan就能使用新技能(如抽屉操作)。
🧪 实验验证
实验设置
SayCan在两个真实厨房环境中进行了评估:
- Kitchen1:训练数据收集的主要环境
- Kitchen2:未见过的新环境(用于测试泛化)
评估了101个自然语言指令,涵盖多种技能组合和难度级别。
核心实验结果
1. 定性分析
任务1:“I spilled my coke, can you bring me something to clean it up?”
SayCan的决策过程:
- LLM认为"pick up sponge"最相关(概率最高)
- Affordance确认从当前位置可以执行"find sponge"
- 执行:find sponge → pick up sponge → bring to you → done ✓
任务2:“I spilled my coke, can you bring me a replacement”
语义细微差别导致完全不同的计划:
- LLM认为"find coke can"最相关
- 执行:find coke can → pick up coke can → bring to you → done ✓
任务3:Affordance的"否决权"
当LLM建议"pick up sponge"但当前位置无法执行时,affordance函数会降低其概率,转而选择"find sponge"。这展示了affordance对LLM的约束作用。
2. 定量结果
| 指标 | FLAN-SayCan | PaLM-SayCan |
|---|---|---|
| 计划成功率(Plan Success) | 70% | 84% |
| 执行成功率(Exec Success) | 61% | 74% |
| 任务完成率(Task Success) | 56% | 74% |
PaLM-SayCan相比FLAN-SayCan减少了约一半的错误。
3. 长Horizon任务
SayCan能够处理需要16步甚至更多步骤的长horizon任务。例如:
任务:“I just worked out, can you bring me a drink and a snack to recover?”
规划步骤:
- go to coke can
- pick up coke can
- go to drawer
- open drawer
- pick up chips
- go to human
- give coke can
- give chips
- done
4. Chain of Thought效果
通过Chain of Thought提示,PaLM-SayCan能够处理需要推理的任务:
任务:“I am hungry, but I can’t eat固体食物”
没有CoT:可能建议拿薯片(错误) 有CoT:推理出"不能吃固体食物→需要液体→拿果汁"(正确)
5. 消融实验
论文进行了详细的消融实验,验证各组件的贡献:
| 组件 | 移除后的计划成功率下降 |
|---|---|
| Affordance函数 | -31% |
| LLM(换为随机) | -40% |
| 技能描述 | -15% |
| 示例(few-shot) | -12% |
Affordance函数是不可或缺的组件,移除后成功率下降31%。
🔍 个人思考
亮点
优雅的框架设计:SayCan的框架极其简洁——两个概率的乘积。这种设计既有强大的表达能力,又易于理解和实现。$P_{\text{LLM}} \times P_{\text{affordance}}$ 的公式堪称经典。
解耦的模块化架构:LLM负责语义理解,affordance负责物理可行性。这种解耦使得每个模块可以独立优化和升级。从FLAN升级到PaLM时,只需替换LLM模块,无需重新训练affordance。
可解释性强:由于LLM和affordance的概率是可解释的,用户可以清楚地看到为什么选择某个技能。这种可解释性对于机器人部署至关重要。
迭代式规划的实用性:相比一次性生成完整计划,迭代式规划更鲁棒,能够处理执行失败和环境变化。
PaLM升级带来的性能飞跃:PaLM-SayCan的实验首次展示了LLM能力的提升可以直接转化为机器人性能的提升,这是一个非常重要的发现。
局限性
技能库的限制:SayCan需要预先定义一个有限的技能库。如果用户的指令超出了技能库的能力范围,系统将无法处理。如何动态扩展技能库是开放问题。
缺乏闭环反馈:SayCan在规划时考虑了当前状态,但在执行过程中缺乏持续的环境反馈。如果技能执行失败或环境发生变化,系统可能无法及时调整。
LLM的幻觉问题:LLM可能生成看似合理但实际不可行的计划。虽然affordance可以过滤一部分,但仍可能有遗漏。
计算延迟:LLM的推理延迟较高,可能影响实时性要求高的任务。特别是在迭代式规划中,每一步都需要重新查询LLM。
对affordance函数质量的依赖:affordance函数需要预先训练,其质量直接影响系统性能。训练高质量的affordance函数本身就是一个挑战。
缺乏物理常识:LLM可能不理解某些物理约束(如物体的重量、摩擦力等),导致不合理的计划。
未来方向
闭环规划:后续工作Inner Monologue(Huang et al., 2022)通过引入环境反馈(成功检测器、场景描述、人类反馈)来实现闭环规划。
动态技能扩展:如何让系统自动发现和学习新技能,而非依赖预定义的技能库。
与RT-1/RT-2结合:SayCan作为高层规划器,与RT-1/RT-2等低级策略结合,形成完整的机器人系统。
多模态感知:将视觉、语言、触觉等多模态信息融合到affordance评估中。
人类反馈学习:通过人类反馈不断改进LLM和affordance函数。
跨具身迁移:将SayCan扩展到不同类型的机器人,实现真正的通用机器人助手。
📖 延伸阅读
- Inner Monologue: Embodied Reasoning through Planning with Language Models(Huang et al., 2022)- SayCan的闭环扩展,引入环境反馈
- PaLM-E: An Embodied Multimodal Language Model(Driess et al., 2023)- 将PaLM直接与传感器输入结合
- RT-1: Robotics Transformer for Real-World Control at Scale(Brohan et al., 2022)- SayCan的低级策略实现
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control(Brohan et al., 2023)- 端到端的VLA模型
- CaP: Correctability and Affordance for Manipulation Policy(Huang et al., 2023)- 改进affordance学习
- SayCan的Google AI Blog文章:Towards Helpful Robots: Grounding Language in Robotic Affordances
- Socratic Models(Zeng et al., 2022)- 相关的多模态推理方法