📄 论文信息
- 标题:SparseDriveV2: Scoring is All You Need for End-to-End Autonomous Driving
- 团队:清华大学 × 地平线(SparseDrive 原班人马)
- 方向:打分式(Scoring-based)多模态规划
- arXiv:2603.29163(2026 年 4 月发布)
- 一句话总结:与其纠结"词表够不够密",不如把轨迹词表本身拆开——用几何路径和速度剖面两张紧凑子词表笛卡尔积式组合出超密集轨迹词表(1024×256 ≈ 26 万条),再用粗打分筛 + 精打分选的大规模可扩展打分策略,让打分式规划的精度与可扩展性同时拉满。
⚠️ 更新说明:本文初版误把 SparseDrive V1(稀疏感知/质量感知记忆库等)的内容当作 V2 讲解。经核对官方论文,V2 的核心贡献是"可扩展词表表示 + 可扩展打分策略",本文已按官方论文重写。
🤔 要解决什么问题?打分式规划的"词表天花板"
端到端多模态规划有两大流派:
| 流派 | 代表 | 做法 | 瓶颈 |
|---|---|---|---|
| 词表打分式 | VADv2、Hydra-MDP | 预置一批固定候选轨迹,学一个评分器挑最优 | 词表太大则打分算力爆炸,太小则覆盖不足 |
| 动态生成式 | DiffusionDrive、GoalFlow | 用扩散/流匹配按场景现场生成候选 | 需要额外的生成网络,系统更复杂 |
两者背后的根本矛盾是:词表要密(覆盖好)就得大(打分贵)。VADv2 用 4096 条静态 anchors,Hydra-MDP 甚至到 8192 条,但研究者普遍发现:静态词表离散化粗糙,继续堆数量又很快触碰显存/算力上限。
作者的判断:打分式方法的天花板不是"静态词表天生不行",而是你们没把词表做得够密、没把打分做得够快。本文先对代表方法 Hydra-MDP 做一次 systematic scaling study(Table 1):把锚点(anchors)一路加密,EPDMS 持续上升、在触及算力上限之前都不见饱和(原摘要原话:consistently improves / without saturation)——瓶颈确实是"记忆体装不下 + 打分算不过来",而不是语义上"静态表就到此为止"。
这张表是全文的题眼:26 万候选还不是上限——只要你把表示做到紧凑、把打分做到可扩展,压根不用换范式,分数可以一路吃到底。
💡 核心思想:把"轨迹"拆成"路径 × 速度"
一句话核心:时空轨迹 = 空间几何(路径)+ 时间进度(速度),把两套子词表做笛卡尔积,就能用很小的词库覆盖极大的动作空间。
为什么整体轨迹词表这么贵?
一条轨迹 $\tau=\{(x_t,y_t)\}_{t=1}^{T}$ 同时编码了"去哪"(几何形状)和"多快"(时间演化)。想用一堆完整的时空轨迹覆盖所有驾驶行为,词表要极其庞大——比如"向左变 1m / 变 2m / 变 3m"×ד加速/匀速/减速/停车"这几种组合,完整列表就要 M×N 条,实际行为空间比这细腻得多。
分解(Factorization):路径 + 速度
把轨迹拆成两个正交的部件:
- 几何路径 geometry path:$p=\{(x_i,y_i)\}_{i=1}^{S}$,沿路径等空间间隔 $\Delta s$ 采样的空间点序,只描述形状、不含时间;
- 速度剖面 velocity profile:$v=\{v_t\}_{t=1}^{T}$,等时间间隔 $\Delta t$ 的标量速度序列,只描述快慢、不含空间。
用 $\mathcal{D}(\tau)=(p,v)$ 可以把任意轨迹拆开;反过来用组合算子 $\mathcal{C}(p,v)=\tau$ 又能重构回一条完整时空轨迹(累加位移沿路径插值)。分解-重构是无损的,重点在它解锁了组合爆炸:
$$\mathcal{T}=\{\,\mathcal{C}(p_i,v_j)\ \big|\ p_i\in\mathcal{P},\ v_j\in\mathcal{V}\,\}$$只有 $N_p$ 条路径 + $N_v$ 条速度剖面,却能组合出 $N_p\times N_v$ 条轨迹!论文取 $N_p=1024$、$N_v=256$,得到 26 万+ 的超密集词表,是此前 8192 的 32 倍,记忆开销却仍是紧凑的两张子词表。
为什么这条路行得通? 直觉上,驾驶行为的多样性恰恰来自这两个维度的乘法组合:同样的"靠左变道"几何,配上"快加速"和"慢滑行"就是两种截然不同的驾驶风格;同样的"匀速直行"速度,配上"超车"与"规规矩矩走"也是两种完全不同的意图。两者在物理上本就是可控变量(方向盘控形状、踏板控速度),分开建表既不丢信息、又各自干净,正是这条"分解"路径能成立的根本原因。
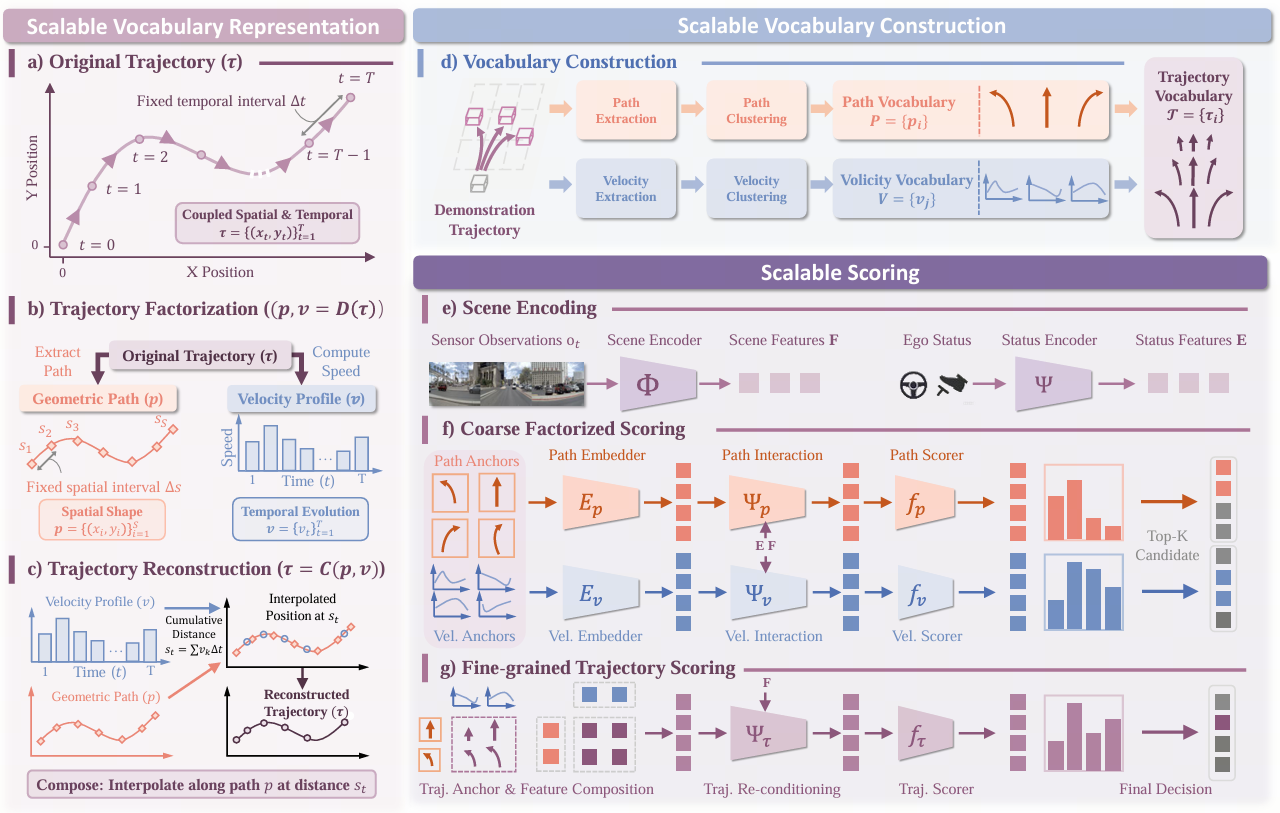
🏗️ 整体框架:超密集词表 + 可扩展打分
数据流一句话:
场景特征(六路相机 → ResNet 骨干 → 稀疏感知)➜ 超密集轨迹词表(路径词表 × 速度词表)➜ ① 粗粒度分解打分 ② 精粒度组合打分 ➜ 最高分轨迹作为规划输出
下面拆解三个板块。
1. 词表构造:可扩展词表表示(Scalable Vocabulary Representation)
- 路径词表:从训练数据提取足够长(覆盖 50m)的未来轨迹 → 按路径几何空间重采样 → K-Means 聚类出 $N_p=1024$ 条路径 anchors。
- 速度词表:同理,对每条轨迹算速度剖面 $\{v_t\}$ → 聚类出 $N_v=256$ 条速度 anchors。
- 两条子词表经过 $\mathcal{C}$ 组合构成可重构的、无形状冗余的超密集轨迹集——空间维度用路径覆盖,时间维度用速度覆盖,互不耦合,所以词表能指数级扩展。
2. 打分:可扩展打分策略(Scalable Scoring)
打分也不能直接对 26 万条全算,所以分两层:
| 阶段 | 打分对象 | 复杂度 | 作用 |
|---|---|---|---|
| 粗粒度分解打分 | 每条路径 $p_i$、每条速度 $v_j$ 各打一次分 | $O(N_p+N_v)$ | 全靠原始打分快速筛掉垃圾候选 |
| 精粒度组合打分 | 只对保留下的 top-K 组合轨迹 | $O(K)$,K≈64 | 对组合轨迹做时空一致的精细评估 |
两块合起来才是"精算”——先在分解空间用低维打分快速并入,再在组合空间做高维精确评估。这就是打分与词表规模 解耦 的关键机制:粗打分是 1 维向量、9 维输入,精打分只在少数轨迹上算,所以词表做到 26 万也无所谓。
打分器用什么特征? 论文让路径/速度嵌入与场景 condition(实例 queries、地图查询)做跨注意力交互,理解"这条路径是否符合当前路况、这个速度是否跟得上前车、是否符合路权"——打分器学的是"开得对不对",而不是背模板。
3. 训练与推理
- 粗-精两阶段打分训练:
- 阶段一(coarse):用预测分数与校准过的老师分数(如真值轨迹的 L2 距离度量)做监督,训练一个可泛化的粗打分器。
- 阶段二:对组合轨迹做精打分,只对 top-k 候选回归精确分数,避免对 26 万条都算。
- 推理:
场景 words → 分解:所有路径/速度各自粗打分 → top-k 组合轨迹精打分 → 取分数最高一条下发控制。
为什么要这么干?三大收益
| 收益 | 对比 |
|---|---|
| 词表 32 倍扩张,不爆显存 | 两张紧凑子词表代替一张巨表,组合在推断时才生成 |
| 打分 O(词表) → O(Np+Nv+K) | 粗打分把所有候选一次性打分完,精打分推算极少,词表再大也只是多两次打分 |
| 覆盖细粒度 | 静态表粒度粗的问题被 26 万细分解决,无须动态生成网络 |
与各路方案的横向对比
| 方法 | 候选来源 | 词表/生成规模 | 打分成本 | 特点 |
|---|---|---|---|---|
| VADv2 | 静态 anchors | 4096 | O(4096) | 参数少、好部署,但覆盖粗 |
| Hydra-MDP | 静态 anchors | 8192 | O(8192) | 引入更多训练技巧 |
| SparseDriveV2 | 路径×速度组合 | 262144 | O(Np+Nv+K) | 词表最密、打分最省 |
| DiffusionDrive | DDIM 扩散生成 | 每帧现场采样 | 采样 N 步 | 细粒度好,但要生成网络 |
结论:打分式范式"天然适合端到端规划",只要把词表做对、打分做快,就能既拿到动态生成式的精细覆盖,又保留打分式的简单性与可解释性。表中可见 VAD2 / Hydra-MDP 的瓶颈其实在于"单张稠密表"撑不起密度,而密度恰恰是打分质量的地基。
📊 实验结果:双基准 SOTA
要点(完整数值见原论文表 2-4):
- NAVSIM v2 navtest:SparseDriveV2 在 ResNet-34 骨干下达到 90.1 EPDMS(官方更新评测版本),同时位列打分式与动态式两派第一,反超 Hydra-MDP++(V2-99, 85.1 EPSM) / DriveSuprim(V2-99, 86.0)。
- NAVSIM v1:92.0 PDMS,同样处于第一梯队。
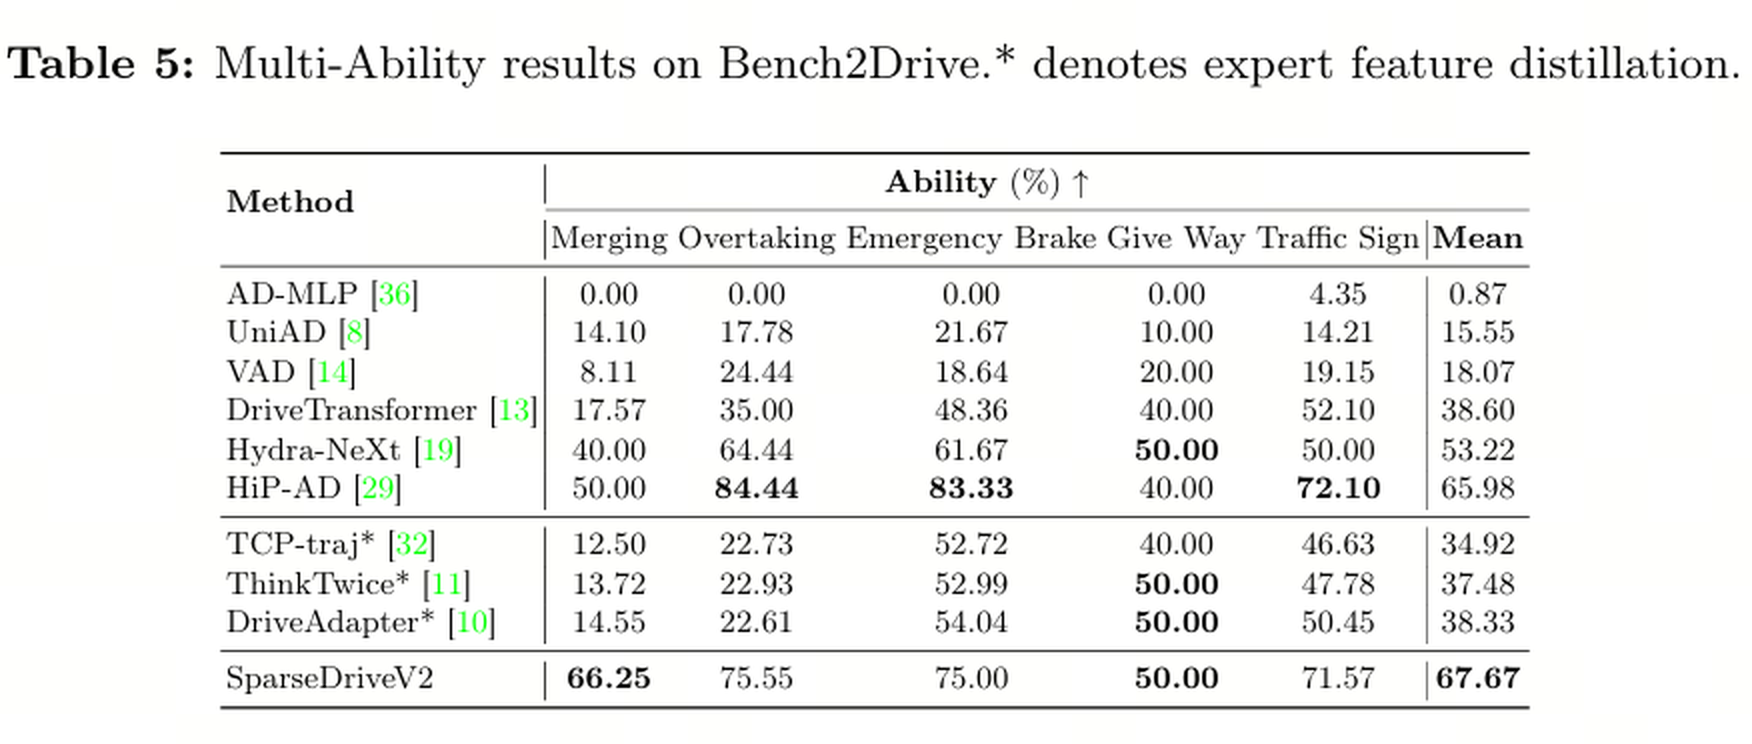
- Bench2Drive 闭环:在 220 条测试路线、44 类交互场景上 Driving Score 89.15 / Success Rate 70.00,全面领先(部分用专家蒸馏特征
*)。Bench2Drive 上直接把轨迹拆成路径+速度剖面做控制(路径横向 + 速度纵向),进一步验证了"分解表示"不仅利于打分,也利于把规划转成底层控制指令。
官方排行榜可视化
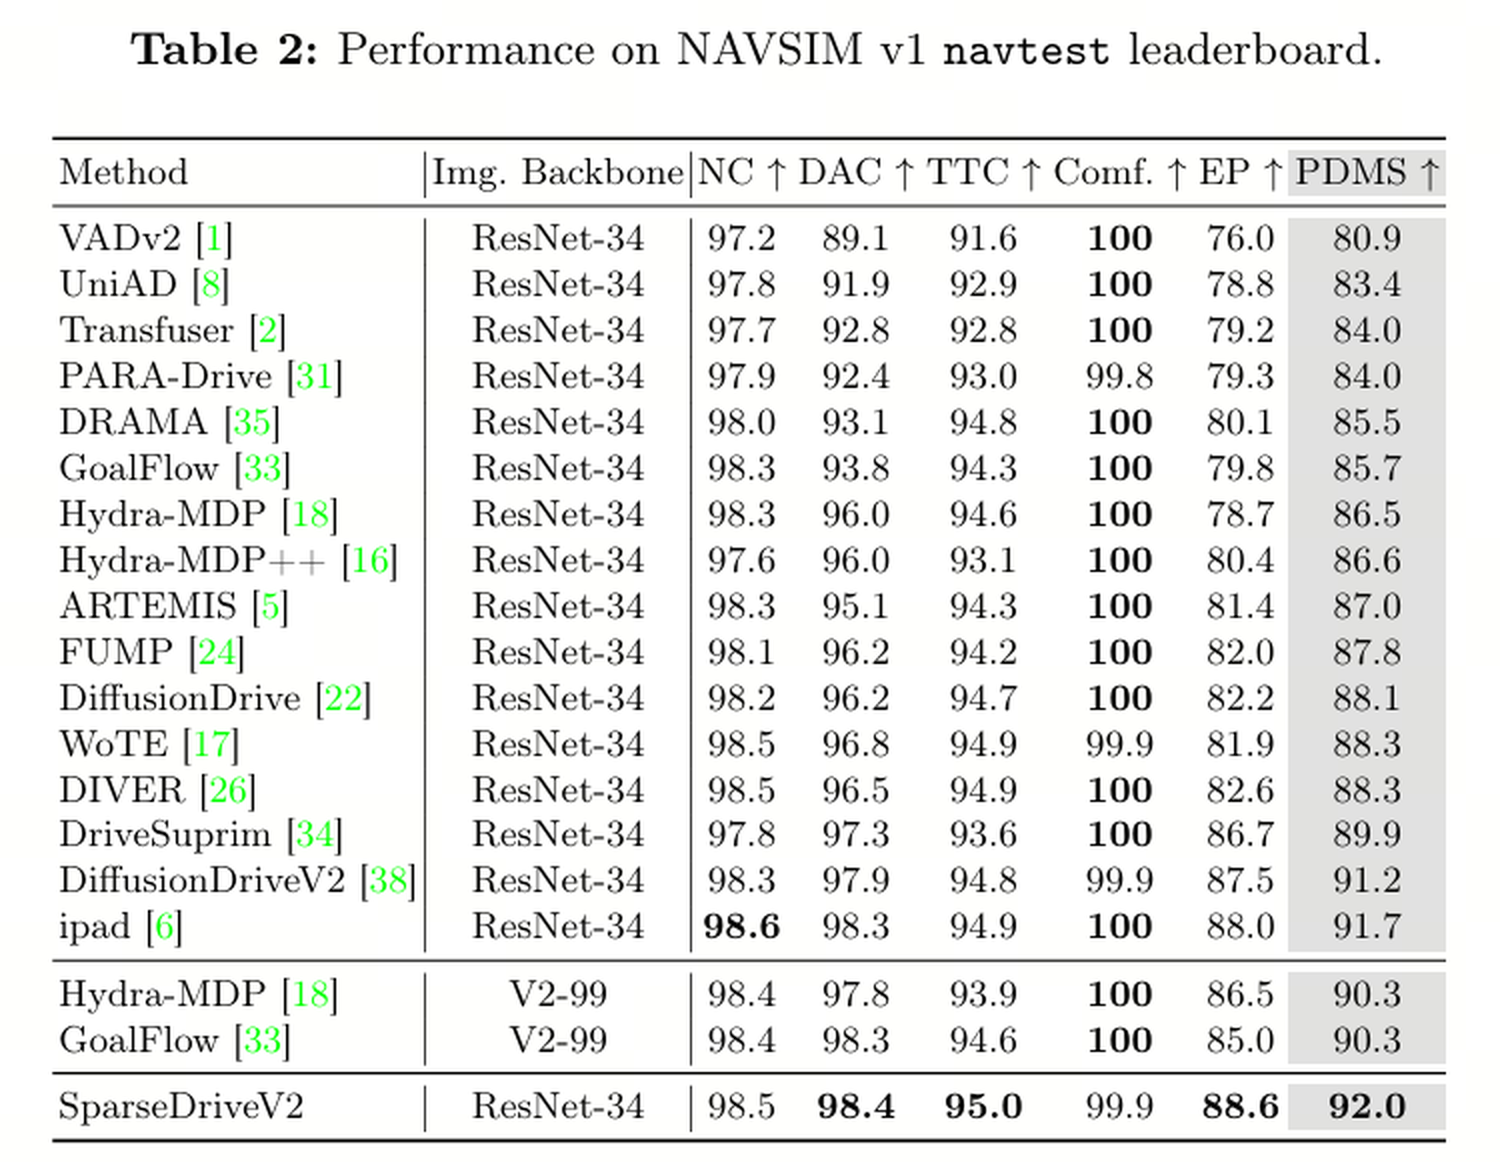
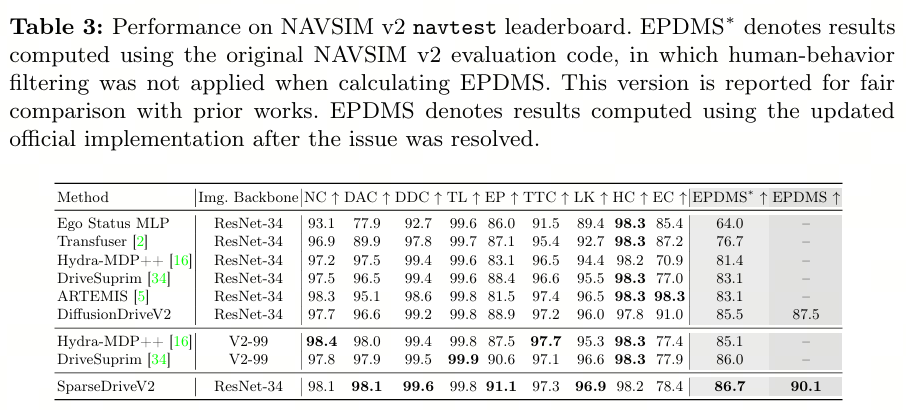
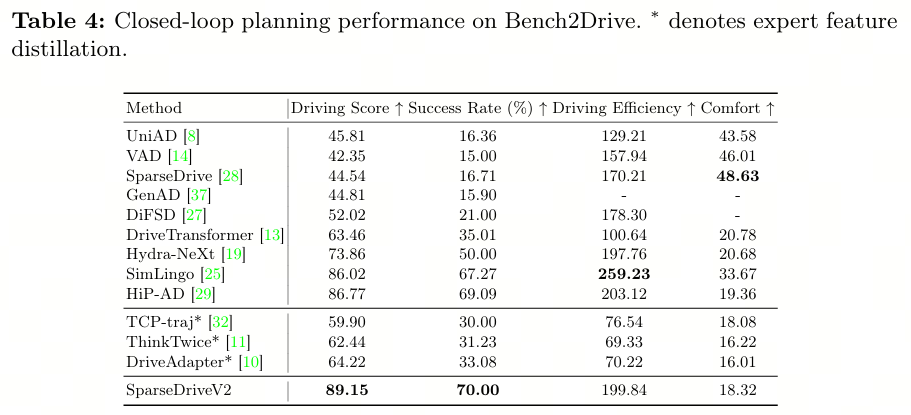
消融(Table 6)
- 左图:词表扩展性——连续增大 $N_p$(路径锚)与 $N_v$(速度锚)时,EPDMS 单调上升、未见尖峰,验证"词表越密越好"的假设。
- 右图:可扩展打分有效性——把粗打分换成全部候选打分,效果不升反降/需更多计算;粗-精两阶段显著省算力且不损精度。
🎨 定性可视化:关键场景对比
论文与官方仓库提供的四张定性图,展示了 V2 在行为层面的提升:它不止"能开",还会更顺、更高效、更贴合导航意图。对比基线为代表性静态词表打分方法(VADv2 / Hydra-MDP 风格)。
① 急弯更顺滑

解读:这张图是"分解表示"物理意义最直观的体现。把轨迹拆成路径 + 速度剖面后,几何路径天然具有光滑性(等弧长采样 + 插值保证曲率连续),两套子词表各自独立、组合时也不会拼出曲率突变。而基线方法直接回归完整时空轨迹,统计上容易出现瞬时抖动。一条平滑的过弯曲线,就说明了为什么"分解 + 超密组合"能让可开性显著提升。
② 堵车场景更高效

解读:这种行为差异反映的是打分器在"路权"与"通行效率"之间的权重取舍。V2 的粗-精打分器见过大量"等待 vs 抢行"的标注对,学到人类司机的效率偏好——前方出现可通行空当时不再死等。打分式方法学到的不是简单模仿,而是更"会钻"的驾驶风格,这正是"打分即策略"的体现。
③ 高层的导航意图对齐

解读:这张图的价值在于回答"跟导航走,还是躲障碍走"。打分器只有让高分轨迹去和真值对齐,才能学到"哪条路符合全局方向意图"。V2 对路径的显式几何建模,让输出轨迹在符合导航期望的方向上与大曲率避开障碍之间取得平衡——不再为了绕障碍而逆着导航意图乱绕。
④ 诚实的失败案例:导航信息不足
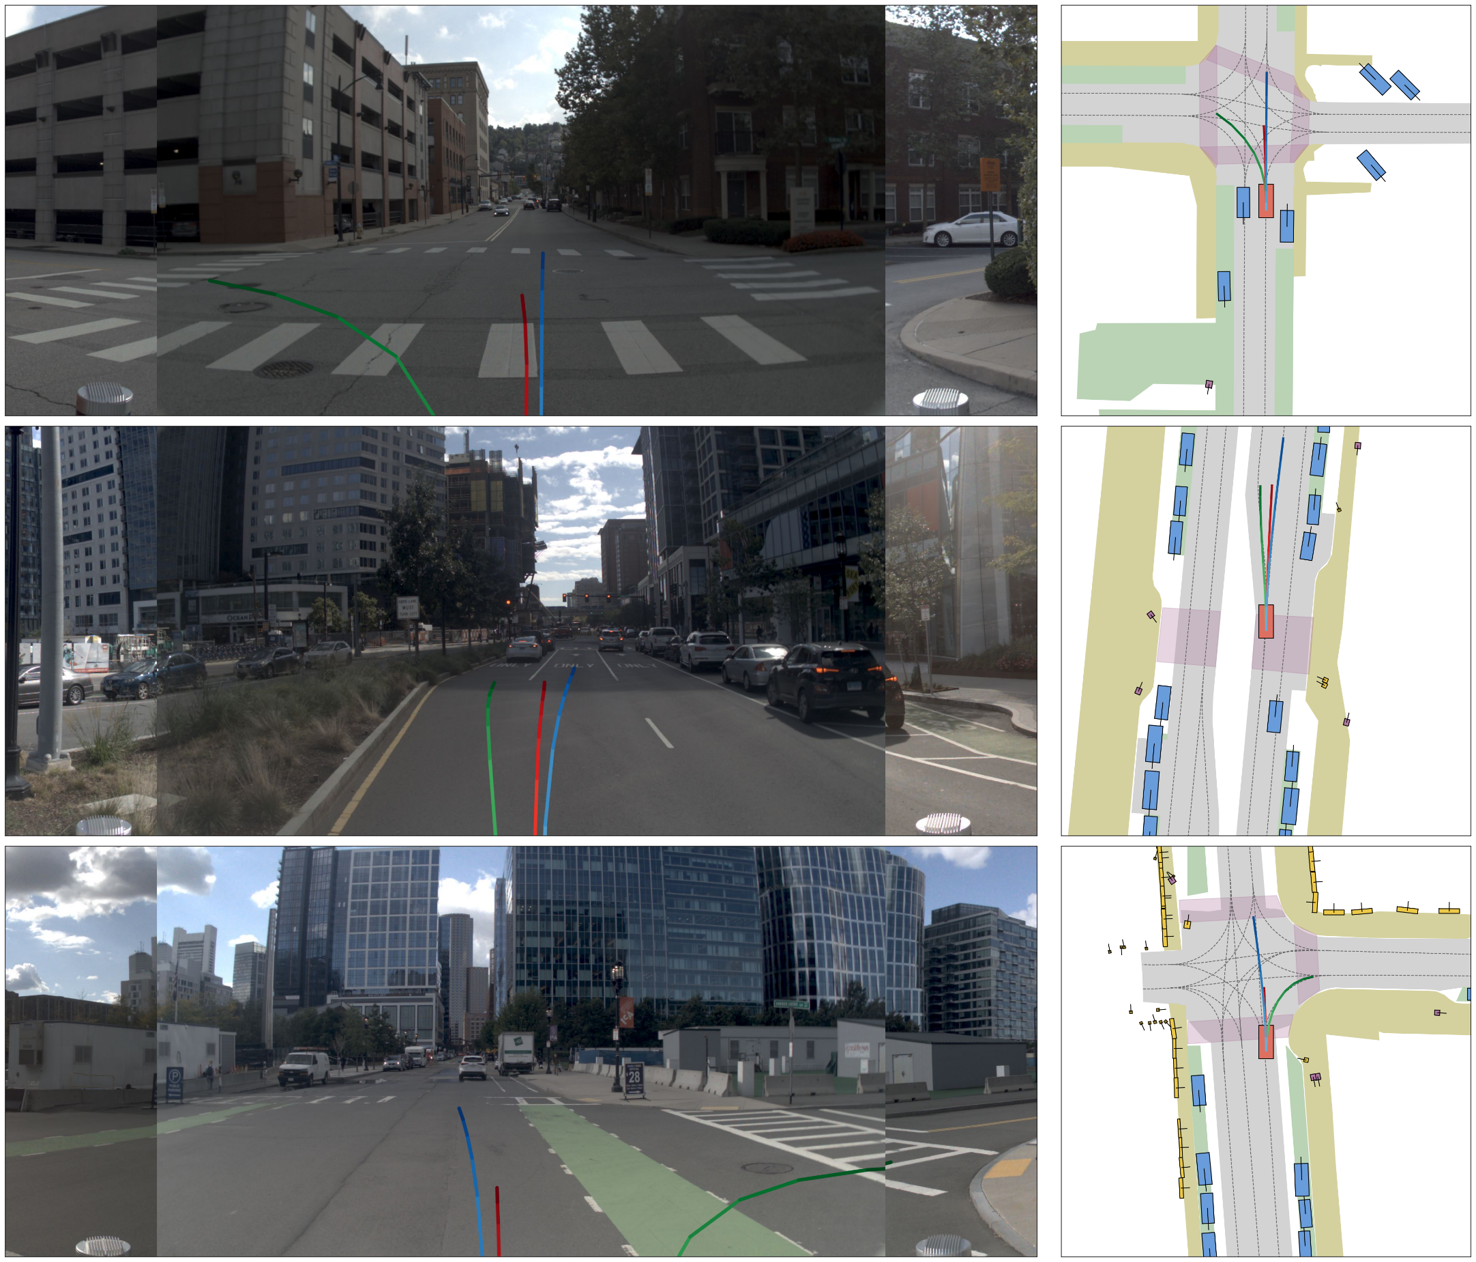
这组失败样本非常有价值:当全局路由信息供给不完整时,即使词表再密、打分再细,纯打分仍是"跟着数据模仿"的影子。它为后续"导航感知 / 全局意图注入"研究自然留下一道接口——也提醒读者,任何静态词表系统都依赖高质量的上下文特征。
🤔 局限性与未来方向
- 打分依赖路径/速度聚类质量:词表来自 K-Means,聚类涵盖不了的行为会被系统盲区。若训练分布里没有某种急弯组合,无论打分器多强都调不出对应路径——这是任何静态词表范式的硬边界。
- 导航敏感:Figure 5 显示强依赖全局路由/导航信号,供给不完整时即便词表再密也会挑错方向。这说明打分不能脱离全局上下文单独讨论,未来需要把导航意图显式注入打分特征。
- 打分器仍是"模仿"的影子:对真值轨迹模仿打分(L2 等)做监督,分布上限仍受训练数据质量约束;未来可结合 RL(如 GRPO 用可微奖励对齐驾驶偏好而非纯模仿),让打分学会"主动绕障"。
- 词表即先验:双刃剑——但正向看,每个候选都能拿到可解释分数、被下游安全层逐条审计,这是动态生成式(扩散)所欠缺的可解释性透明度。
- 动力学可行性:路径×速度组合在几何上光滑,但真实曲率/加速度限幅是否完全满足,仍需闭环实验进一步验证。
📝 个人思考
SparseDriveV2 最打动我的一点是它的**“反直觉判断”:当大家都在往"动态生成"方向上卷(扩散、流匹配),它却反身回去把"静态打分"做到极致,用分解词表 + 可扩展打分**两招把旧范式重度重做。这背后的洞见是——很多瓶颈并非假设不对,而是’表示与计算’没有解耦。轨迹这个对象本质是"空间 × 时间"的双因子结构,一旦你把它拆成两个正交分量,词表就获得组合自由度、打分就获得复杂度自由度。
一个人人觉得"静态表太糙"的问题,作者选择了"把表做大"而不是"换生成范式",并证明了大表 + 好打分就能赢。这种"反共识"的工程直觉,比堆新架构更值得学习。
第二个收获是**“粗-精两阶段"的工作流智慧**:烈士式地对 26 万条全精算,永远比不过"先用低维粗信号把候选收敛到 top-K,再对少量候选做高维精算”。这是检索-重排(retrieve-rerank)、级联分类、MDP 剪枝等一再出现的通用范式,在规划里落地成"分解打分 + 组合打分",很优雅。
第三个层面是它与 DiffusionDrive 的路线形成非常清晰的**“路线之争”:一个"当场生成候选"(Dynamic),一个"备好超密词表"(Static);但两者都在追求多模态 + 细粒度**。把 SparseDriveV2 与 DiffusionDrive 并排看,能更直观地理解"表示的选择"对端到端规划的牵动——这也是本系列第 5 篇和第 7 篇互为镜像的原因。
最后,V2 留了些尾巴给后续:如何用更强的世界/导航信号补齐 Figure 5 的"导航不足"短板、怎么让打分器脱离对模仿监督的依赖——这些都留给更自信的系统。打分式规划,或许是"简单而强大"路线的一个名字。 别忘了,词表即先验天然带可审计性,这恰恰是真实落地中最稀缺的安全资产。
📖 这是论文精读系列的第 7 篇。你会赌"打分无敌"的静态词表,还是"生成多模态"的动态扩散?欢迎留言讨论。