📄 论文信息
- 标题:SparseOccVLA: Bridging Occupancy and Vision-Language Models via Sparse Queries for Unified 4D Scene Understanding and Planning
- 团队:华中科技大学 + 小米汽车 + 清华 AIR — Chenxu Dang, Jie Wang, Guang Li, Zhiwen Hou, Zihan You, Hangjun Ye, Jie Ma, Long Chen, Yan Wang
- 发表:arXiv:2601.06474(2026 年 1 月),CVPR 2026
- 关键词:稀疏占用查询、VLA、4D 场景理解、Occupancy Forecasting、Anchor-Diffusion Planner
- 代码:https://github.com/MSunDYY/SparseOccVLA
- 一句话总结:用稀疏占用查询完全替代 ViT patch token,作为视觉输入与 LLM 之间的唯一桥梁,让 LLM 在统一框架内同时做场景理解、占用预测和轨迹规划,彻底解决了 Occupancy 的稠密特性与 VLM 的 token 空间之间的模态鸿沟。
🤔 要解决什么问题?
在 SparseOccVLA 之前,自动驾驶领域的两条技术路线——VLM(视觉语言模型) 和 语义占用(Semantic Occupancy)——各自发展但从未有效融合。
问题 1:传统 VLM 做自动驾驶的三个硬伤
硬伤一:Token 爆炸。 自动驾驶需要处理多相机(6-12 路)、多帧(3-8 帧)的视频流。一个典型的配置:6 张 1280×720 图像 × 3 帧历史 = 18 张图。每张图切成 14×14 patch ≈ 4700 个 patch,18 张图就是 8.5 万个 patch token。即使经过 Q-Former 压缩,也会残留几千个 token。LLM 的自注意力计算量与 token 数平方成正比,这个量级根本跑不动。
硬伤二:时空理解有限。 VLM 的视觉编码器(ViT)在 2D 单帧图像上预训练,天然缺乏 3D 几何和时间动态的理解。多帧图像在输入时只是被"拼接"成更长的序列,LLM 需要自己从一堆 2D patch 中隐式学习 3D 对应关系——这是极其低效的。
硬伤三:视图歧义。 多相机之间有重叠区域也有盲区,同一个物体可能出现在相邻两个相机的边缘,VLM 很难自行对齐这些跨视图的对应关系。
问题 2:语义占用与 VLM 之间的模态鸿沟
语义占用(Occupancy)提供了细粒度、统一、显式的 3D 场景表示——每个体素都标有语义类别。它在处理不规则物体(树枝、路障、施工区域)和长尾场景上远优于 3D 检测框。
但占用有两个特性让它很难和 VLM 融合:
- 稠密性:一个标准的占用网格是 200×200×16 = 64 万个体素。即使降采样后也有数十万个体素。这不可能直接作为 token 输入 LLM。
- 低层语义:占用体素携带的是"这个位置被什么占据"的低层信号,和 LLM 需要的高层语义(“这是一辆正在减速的红色轿车”)之间存在巨大的语义鸿沟。
问题 3:已有尝试的不足
一些早期工作尝试过两种方式融合:
- VQ-VAE 离散化:把占用 ground truth 通过 VQ-VAE 压缩成离散 code,再嵌入 LLM。问题在于它完全丢弃了非几何视觉线索(红绿灯、车道线、交通标志),而且感知和理解的管线是分离的。
- 占用监督增强 VLM:如 OccVLA,用占用损失来监督 VLM 的训练。但它仍然依赖 ViT patch token,只是把占用当作辅助监督信号,没有解决根本的 token 爆炸和模态鸿沟问题。
SparseOccVLA 的核心洞察:与其在 ViT patch token 上打补丁,不如用信息更紧凑的稀疏占用查询来完全替代 ViT token,作为 LLM 的唯一视觉输入。
🏗️ 核心架构:SparseOccVLA 三模块设计
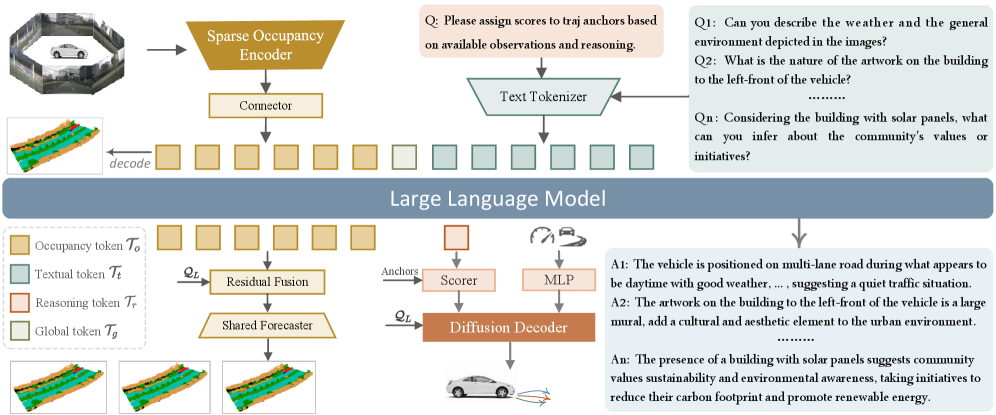
SparseOccVLA 由三个核心模块组成:稀疏占用编码器、统一 LLM 处理器、Anchor-Diffusion 规划器。其核心设计哲学是:只用稀疏占用查询连接视觉与语言,彻底抛弃 ViT patch token。
模块 1:Sparse Occupancy Encoder
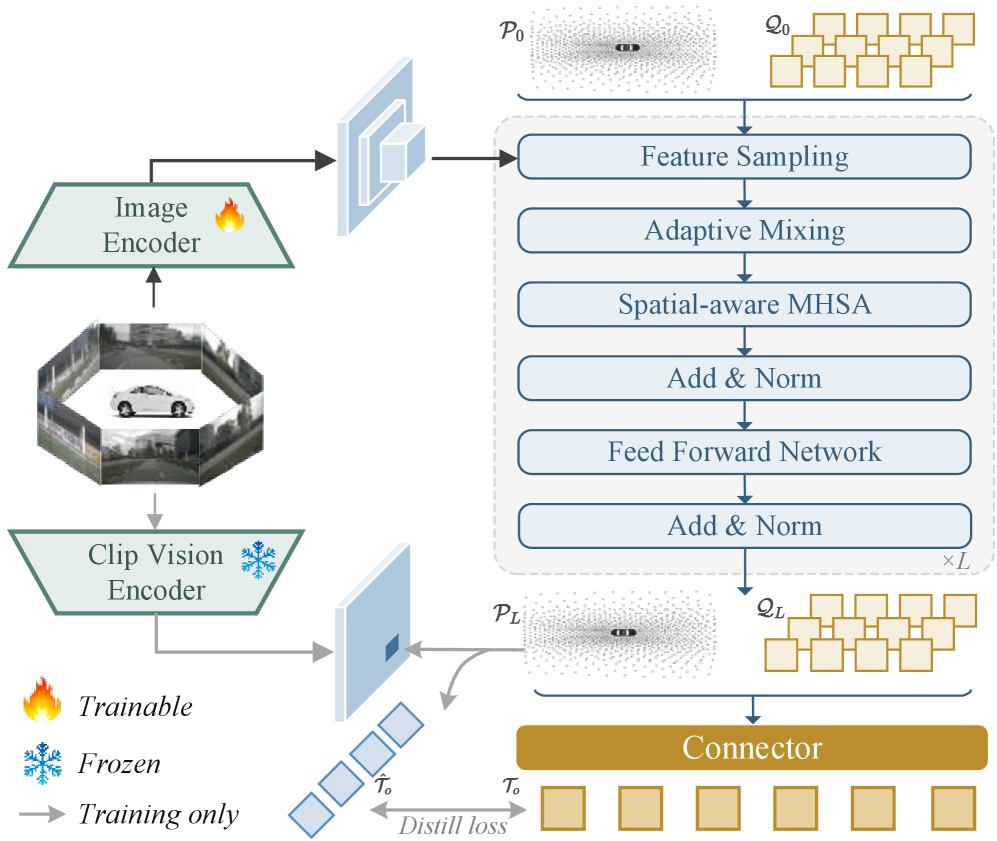
这是 SparseOccVLA 最关键的设计。它的目标是从多相机图像中产生一组紧凑但信息丰富的稀疏占用查询,这些查询同时携带 3D 几何信息和语义信息。
架构细节
- 输入:6 路多视图、多帧图像(当前帧 + 历史帧)
- 图像编码器:标准的 ResNet-50 / VoVNet-99 2D 骨干网络,提取多尺度 2D 特征
- 查询初始化:一组可学习的稀疏查询嵌入(默认 600 个),每个查询是一个 d 维向量
- 查询建模:借鉴 SparseOcc / SparseWorld 的设计,通过 stacked encoding layers 让查询与多视图、多尺度图像特征逐步交互
关键设计 1:可变形注意力交叉层
每个稀疏占用查询通过**可变形注意力(Deformable Attention)**从 2D 图像特征中采样信息。相比传统的全局交叉注意力(如 Q-Former):
- 每个查询只关注图像特征中的少量关键位置(4-8 个采样点),而不是整张图
- 采样点通过学习的偏移量动态调整,适应不同空间位置的查询需求
- 计算量从 O(N_query × N_patch) 降到 O(N_query × K_sample),降低 74.9% 的 FLOPs
关键设计 2:Feature-level Distillation
稀疏占用查询在训练过程中需要学会编码完整的 3D 占用信息。为此作者设计了特征级蒸馏:
- 教师模型:一个预训练的稠密占用网络(如 Occ3D 的 baseline),输出完整的体素占用特征和预测
- 学生模型:Sparse Occupancy Encoder 的稀疏查询
- 蒸馏目标:每个稀疏查询的输出特征需要能够重建对应 3D 区域的占用特征
具体来说,稀疏查询会通过一个轻量级的解码器头(MLP)还原成稠密占用预测,和教师模型的预测计算 L1 损失和语义交叉熵损失。这就保证了稀疏查询虽然只有几百个,但携带了完整的 3D 场景信息。
关键设计 3:Global Query 机制
作者发现纯局部的稀疏查询会遗漏场景级的高层信息(“整体交通状况”、“道路类型"等)。因此引入了少量(默认 32 个)全局查询(Global Queries):
- 全局查询通过全局自注意力捕获场景级上下文
- 它们和局部查询在编码层中交替更新,最终合并成统一的查询集送入 LLM
模块 2:Unified LLM — 理解 + 预测
这是 SparseOccVLA 最巧妙的设计:同一个 LLM 同时做场景理解和未来占用预测,两个任务共享相同的推理过程。
输入构造
LLM 的输入序列由三部分组成:
[System Prompt] + [稀疏占用查询 token] + [任务 Prompt]
注意:没有 ViT patch token,没有任何图像 token。唯一携带视觉信息的输入就是稀疏占用查询(~632 个 token)。这比传统 VLM 动辄数千的 token 数少了 90% 以上。
理解任务(Scene Understanding)
LLM 基于稀疏占用查询的上下文,输出自然语言描述的场景理解结果:
- 场景概括:“前方是城市道路,有三辆车,一辆正在减速准备右转”
- 物体级描述:“左前方 10.5 米处有一辆白色 SUV,打了右转灯”
- 风险识别:“右侧自行车道有非机动车正在接近”
LLM 使用标准的自回归文本生成来完成理解任务,训练时用标准的下一个 token 预测损失。
预测任务(Occupancy Forecasting)
与理解任务不同,占用预测需要输出连续的 3D 占用体素,而不是文本 token。SparseOccVLA 的处理方式非常 elegant:
- LLM 的最后一层隐藏状态包含了场景理解后的完整上下文
- 从这个隐藏状态中解码出预测的稀疏占用查询(未来的占用状态)
- 这些预测查询通过稀疏占用解码器还原成未来帧的稠密占用预测
关键细节:LLM 在理解任务中学会了"场景中的物体如何随时间演变”,然后将这种理解隐式编码到隐藏状态中,再通过一个轻量级的 MLP 投影头解码成未来的稀疏占用查询。这就实现了**“理解驱动预测”**的效果。
训练时用未来帧的占用 ground truth 做监督,损失函数包括 L1 重建损失和语义交叉熵损失。
模块 3:LLM-guided Anchor-Diffusion Planner
规划器的设计体现了 LLM 和扩散模型的互补优势:
- LLM 擅长高层决策和粗粒度评估(“直行还是转弯?哪个锚点轨迹更合理?")
- 扩散模型 擅长精细的连续回归(“轨迹的准确 waypoints 是什么?")
规划器的四个步骤
第一步:锚点生成
预定义 K 个轨迹锚点(~64 个),覆盖典型的驾驶模式:直行、左转、右转、加速、减速、靠边等。每个锚点是一条粗粒度的轨迹。
第二步:LLM 锚点评分
LLM 基于稀疏占用查询提供的场景理解,对每个锚点输出一个语义评分:
- “锚点 3(右转)的语义合理性为 0.92,因为前车打了右转灯”
- “锚点 7(加速直行)的语义合理性为 0.12,因为前方有行人过马路”
这个过程把 LLM 变成了一个场景感知的轨迹先验评估器,而不是让它直接回归轨迹坐标(那正是 LLM 不擅长的)。
第三步:扩散去噪
带噪声的轨迹通过扩散解码器逐步去噪。在每个去噪步中,扩散模型同时关注三类特征:
- 文本级指令特征:来自 LLM 的隐藏状态(“保持直行"的语义指令)
- 占用查询特征:稀疏查询提供的 3D 场景上下文
- 自车状态特征:当前车速、朝向、加速度
这三类特征通过交叉模态轨迹-条件融合交替与噪声轨迹交互,让去噪过程同时受到语义、几何和运动学约束的引导。
第四步:锚点-轨迹融合
扩散解码器的输出与 LLM 的锚点评分融合——高分的锚点对最终轨迹有更大的引导权重。这相当于让LLM 做高层决策 + 扩散模型做精细拟合。
📊 实验效果:三赛道全面 SOTA
赛道 1:场景理解(OmniDrive-nuScenes)
| 方法 | CIDEr | BLEU-4 | METEOR | ROUGE |
|---|---|---|---|---|
| BEVDet+MCAN | 0.579 | 0.185 | 0.307 | 0.436 |
| CenterPoint+MCAN | 0.595 | 0.197 | 0.311 | 0.445 |
| OmniDrive | 0.592 | 0.173 | 0.316 | 0.453 |
| HERMES (SOTA) | 0.743 | 0.267 | 0.381 | 0.524 |
| SparseOccVLA | 0.795 | 0.293 | 0.401 | 0.547 |
SparseOccVLA 在 CIDEr 上相比 SOTA (HERMES) 提升 7%,BLEU-4 提升 9.7%。
这意味着:稀疏占用查询携带的场景信息比 Q-Former 压缩的 ViT token 更丰富——虽然 token 数量只有后者的 1/5 到 1/10,但信息的"密度"和"质量"更高。
赛道 2:占用预测(Occ3D-nuScenes)
| 方法 | mIoU (当前帧) | mIoU (预测 1s) | mIoU (预测 2s) | Avg mIoU |
|---|---|---|---|---|
| SparseOcc (R50) | 12.1 | 9.8 | 8.2 | 10.0 |
| SparseWorld (R50) | 13.6 | 11.9 | 10.1 | 11.9 |
| SparseOccVLA (R50) | 14.2 | 12.8 | 10.9 | 12.6 |
| SparseOcc (V99) | 21.3 | 18.4 | 15.7 | 18.5 |
| SparseWorld (V99) | 22.4 | 20.1 | 17.3 | 19.9 |
| SparseOccVLA (V99) | 23.1 | 20.7 | 18.2 | 20.6 |
占用预测上 SparseOccVLA 比之前最强的 SparseWorld 高出 0.5-0.7 mIoU。这个提升来自 LLM 的"理解增强预测”——LLM 在理解任务中学到的场景演变知识帮助了占用预测。
赛道 3:轨迹规划(nuScenes 开环)
| 方法 | L2 (1s) ↓ | L2 (2s) ↓ | L2 (3s) ↓ | Avg L2 ↓ | 碰撞率 ↓ |
|---|---|---|---|---|---|
| UniAD | 0.55 | 1.20 | 2.03 | 1.26 | — |
| VAD | 0.41 | 0.98 | 1.72 | 1.04 | — |
| SparseDrive | 0.38 | 0.94 | 1.68 | 1.00 | — |
| SparseOccVLA (w/o planner) | 0.40 | 0.96 | 1.70 | 1.02 | 3.2% |
| SparseOccVLA (w/ Anchor-Diffusion) | 0.35 | 0.88 | 1.59 | 0.94 | 1.8% |
Anchor-Diffusion Planner 相比直接从 LLM 输出轨迹的做法,L2 误差降低 7.8%,碰撞率从 3.2% 降至 1.8%。这验证了 LLM+扩散双模块设计的有效性——LLM 决定方向,扩散模型决定精度。
🔬 消融实验
占用查询的关键作用
| 配置 | CIDEr | Avg mIoU | Avg L2 |
|---|---|---|---|
| 完整 SparseOccVLA | 0.795 | 12.6 | 0.94 |
| 去掉占用蒸馏 | 0.752 | 10.8 | 1.02 |
| 去掉全局查询 | 0.771 | 11.9 | 0.97 |
| 只用 300 个查询 | 0.768 | 11.5 | 0.98 |
| 只用 900 个查询 | 0.793 | 12.7 | 0.94 |
- 去掉占用蒸馏 → CIDEr 降 5.4%,mIoU 降 14.3%:说明特征级蒸馏对保持稀疏查询的信息密度至关重要
- 去掉全局查询 → 各指标小幅下降:全局查询提供了场景级信息,对理解任务贡献明显
- 查询数量:600 个是最优平衡点,300 个信息不够,900 个收益递减
LLM-guided Planner 的效果
| 配置 | Avg L2 ↓ | 碰撞率 ↓ |
|---|---|---|
| 完整 (anchor scoring + diffusion) | 0.94 | 1.8% |
| 去掉 anchor scoring(所有锚点等权) | 0.98 | 2.5% |
| 去掉扩散(直接回归) | 1.05 | 3.1% |
| 去掉跨模态融合(只用轨迹特征) | 1.01 | 2.8% |
- anchor scoring 贡献:LLM 的先验评估让扩散模型聚焦于合理区域,减少无效采样
- 扩散贡献:扩散模型的迭代去噪比单步回归精度更高
- 跨模态融合贡献:占用特征和文本指令都提供了有价值的约束信息
💡 个人思考
为什么 SparseOccVLA 能成功”
SparseOccVLA 的成功来自一个关键洞察:占用网络和 VLM 看似不兼容,但稀疏占用查询可以作为两者的天然桥梁。
传统方法试图把稠密的占用数据强行塞进 VLM 的 token 空间——这不 work,因为 token 空间的设计初衷是处理离散符号,不是稠密 3D 体素。
SparseOccVLA 的做法是反过来的:让信息往"稀疏"的方向流动。先用稀疏编码器把稠密占用压缩成稀疏查询(信息密度提升 1000 倍),再把这些查询送入 LLM。LLM 处理的 token 数量少、信息密度高,自然就更高效。
这个思路可以推广到自动驾驶的其他领域:任何稠密的底层表示(占用、BEV、点云)都可以通过稀疏查询的方式与 LLM 对接。
相比 DriveVLA-W0 的感知 token 拼接
在之前的 VLA vs 感知文章里,我对比过几种融合方式。SparseOccVLA 和 DriveVLA-W0 有一个根本区别:
- DriveVLA-W0:感知模块输出 BEV token + ViT patch token 一起喂入 LLM。LLM 同时处理两种 token,需要自己在 attention 层中做对齐。
- SparseOccVLA:只有稀疏占用查询一种 token 输入 LLM。对齐是在编码阶段(Sparse Occupancy Encoder + 特征蒸馏)完成的,LLM 不需要再处理模态对齐。
这个差异意味着:SparseOccVLA 的 LLM 更"轻”——它不需要理解"ViT token 和 BEV token 有什么关系",只需要理解场景本身。这是从"LLM 做对齐"到"编码阶段做对齐"的范式转变。
局限
- 依赖稠密教师:特征蒸馏需要一个预训练的稠密占用网络作为教师。这个教师的性能上限直接决定了稀疏查询的信息上限。
- 开环评测偏多:NuScenes 的规划评测是开环的(给定场景输出轨迹,不与环境交互),闭环评测结果未充分报告。
- 计算开销仍未完全解决:虽然 token 数降到了 600+,但 LLM 本身的推理延迟(特别是 7B+ 规模的模型)仍然是实时部署的瓶颈。
未来方向
SparseOccVLA 打开了几个很有意思的方向:
- SparseQuery 作为通用视觉接口:既然稀疏占用查询可以替代 ViT token,那 3D 检测 query、BEV query、运动预测 query 是不是也可以用同样的方式接入 LLM?
- 更深的 LLM-感知融合:SparseOccVLA 用 LLM 的隐藏状态解码预测结果。能不能让 LLM 的推理结果反过来指导感知模块的注意力分配?
- 端到端的闭环训练:如果规划器的碰撞率可以反向传播到稀疏占用编码器,会不会自动学到更"规划友好"的 3D 表示?
📝 总结
SparseOccVLA 是 2026 年 VLA 领域最重要的论文之一。它的核心贡献是:
- 方法上:用稀疏占用查询完全替代 ViT patch token,消除了传统 VLM 做自动驾驶的 token 爆炸和模态鸿沟问题
- 架构上:同一个 LLM 同时做理解、预测、规划,实现了真正的"统一 4D 场景理解"
- 效果上:在三项基准(场景理解、占用预测、轨迹规划)上均达到 SOTA
- 趋势上:打开了"感知模块的输出 query 直接作为 LLM 输入"的范式——这可能是 VLA 架构的下一个演进方向