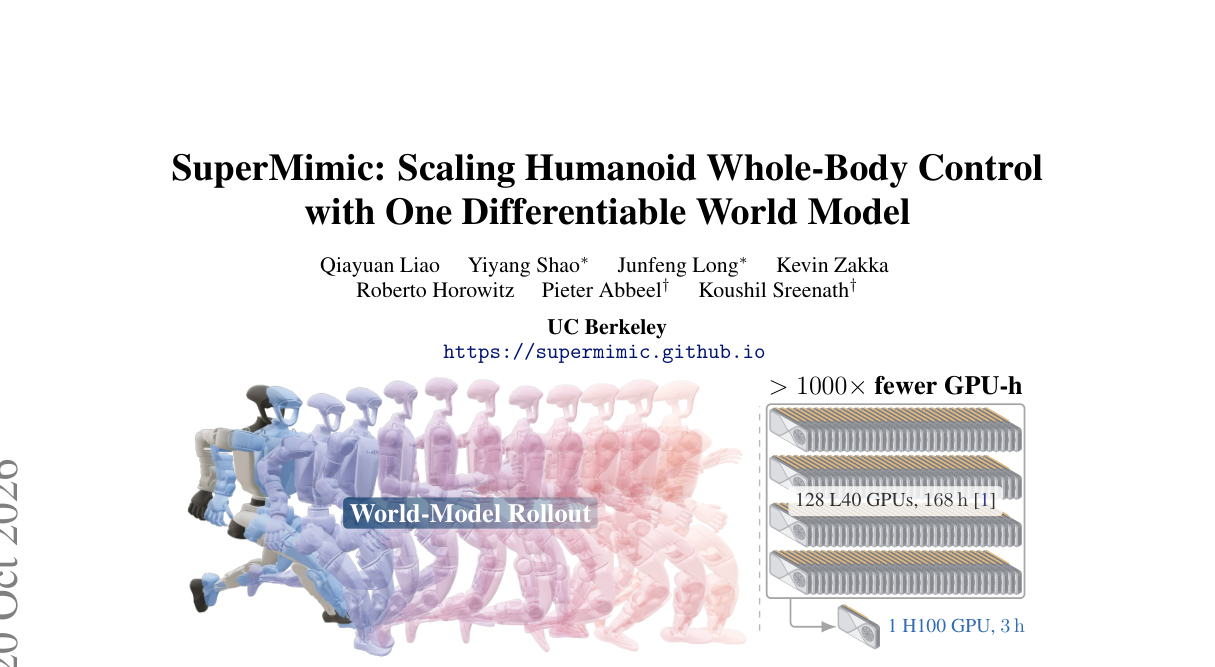
配图说明:本文收录 9 张插图——论文 PDF 裁剪 7 张(Fig. 1–7)+ 官网 2 张,均在站内 /images/supermimic/,逐张讲解,文末附图表总索引与 GitHub 生态表。论文 SuperMimic: Scaling Humanoid Whole-Body Control with One Differentiable World Model(arXiv 2610.28480,2026-10-20),CoRL 2026 Oral,UC Berkeley Hybrid Robotics(Qiayuan Liao;Yiyang Shao、Junfeng Long 共同一作;Kevin Zakka、Roberto Horowitz;Pieter Abbeel、Koushil Sreenath 共同指导);官网 supermimic.github.io。前情阅读:具身智能强化学习调研精读第 1 章(SONIC 同赛道详解)。
🧒 小白 3 分钟:这篇在打谁?
动捕库里有几十万条人类动作(走路、跳舞、翻滚……),让人形机器人逐条学会跟跳,是当前「全身控制」的主流路线。上一代答案是 SONIC(Science Robotics 2026,站内具身智能强化学习调研精读第 1 章已有讲解):把运动跟踪当可缩放任务,用模型免费 PPO + 密集奖励在 128 张 GPU 上硬训 7 天(≈21,000 GPU-时)。
SuperMimic 的一句话暴击:「所有动作长得不一样,但动力学是同一套」——与其让 PPO 从噪声仿真里反复摸每个动作的后果,不如学一个可微世界模型把这份共享结构显式装下,再让策略在想象 rollout 里用解析梯度(BPTT)升级。结果:1 张 H100 训 3 小时就超过 SONIC 发布 checkpoint 的回报——算力账本直接少三个数量级,「测动捕跟踪的缩放定律」从集群特权变成单卡实验。
📄 论文信息
- 标题:SuperMimic: Scaling Humanoid Whole-Body Control with One Differentiable World Model
- 机构:UC Berkeley(Hybrid Robotics 等)
- 时间:2026-10-20(arXiv 2610.28480v1);CoRL 2026 Oral;官网含算力账本、FAQ、真机影片
- 关键词:可微世界模型、模型基强化学习(MBRL)、BPTT、想象 rollout、人形全身控制、动作跟踪、缩放定律、Unitree G1
- 一句话总结:一个可微世界模型学「所有人形动作共享的动力学」,短想象 rollout 给策略解析梯度——1 GPU 3h > SONIC 128 GPU 7d;129,514 条动作失败数 25 vs 179;真机 G1 全库零调参;缩放定律从此可测。
🎯 一句话版本:核心数字
| 指标 | SuperMimic | 对照(SONIC / PPO-Sim) |
|---|---|---|
| 打平/超过 SONIC checkpoint(回报 0.90) | 1×H100,3 小时(3 GPU-h) | 128×L40,168 小时(≈21,000 GPU-h) |
| 墙钟/GPU 时加速 | >50× 墙钟;>1000× GPU 时 | — |
| 129,514 条基准动作失败数 | 25(3h/1 卡)→ 0(9.8h/2 卡) | SONIC checkpoint 179(含全部翻转与侧滚) |
| 动作数据规模 | 公开子集 BONES-SEED 264.56h(SONIC 全集 611h 的 43%) | 全量 611h |
| 缩放行为 | 数据 1→264h:世界模型 8 步预测误差稳定,达标 GPU 时缓增 | 模型免费路线近似随数据线性烧卡 |
| 世界模型吞吐 | 批量下 >10× MuJoCo Warp | 物理仿真器(不可微) |
| 真机 | Unitree G1 全动作库迁移,无逐动作调参 | — |
| 下游接口 | RL 训练的速度编码器 > 蒸馏基线 | F7 初步研究 |
🗺️ 仿真 vs 真机:一眼分清
| 场景 | 类型 | 说明 |
|---|---|---|
| LAFAN1 / BONES-SEED 动作库跟踪 | 仿真(训练+评测主战场) | 129,514 条基准动作;归一化回报 + 失败判定(终止条件) |
| 与 SONIC/PPO-Sim 的受控对比 | 仿真 | 同硬件口径(1/2×H100 vs PPO 1/4/8 卡;SONIC 用发布 checkpoint 账本) |
| 缩放定律实验 | 仿真 | 数据 1→264h、想象视野 H∈{8..128}、有无 critic |
| Unitree G1 真机 | 真机 | 多样与特技动作迁移,单策略全库通吃(Fig. 6) |
🛠️ 方法:共享动力学 × 解析梯度
核心循环(Fig. 2 三段式)
- Collect data:当前策略 πθ 在仿真里带探索噪声收集转移
(s_t, a_t+ε_t, ξ, s_{t+1})(ξ 为每 episode 的仿真上下文)——世界模型保持确定性:条件在 ξ 上,而不是靠随机性猜接触; - Fit world model:从 replay buffer B 采短窗口
(s_0, a_{0:k-1}, ξ)拟合L_WM——世界模型 fω 同时预测下一状态与终止概率(termination BCE); - Improve policy:策略在冻结的世界模型里做短视野想象 rollout(默认 H=32),对想象轨迹做 BPTT 得到解析梯度 ∇θ Ĵ(θ),更新 πθ(带 critic;消融显示无 critic 时低视野崩、高视野变慢)。
一句话:仿真只负责产日志(可不可微无所谓),想象负责产梯度——这就是「兼容 MuJoCo 这类非光滑接触仿真器」的原因:梯度走的是学习出来的光滑模型,不是物理引擎。
为什么快
- 摊销:一个动力学模型服务全部动作库——不再「每条动作重复摸奖」;
- 快:世界模型批量前向比 MuJoCo Warp 快 10×+(Fig. 5a);8 步预测误差在数据 1→264h 全程稳定(Fig. 3c)——「加数据不会把模型撑坏」;
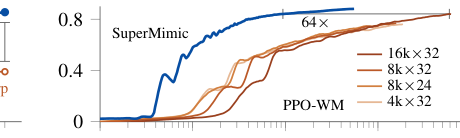
- 准:解析梯度替代 PPO 的高方差策略梯度——PPO-Sim 4 卡/8 卡墙钟 17h 都没到 0.82,SuperMimic 单卡 ~3h 就过 0.90 线(Fig. 4a)。
配套设计
- 目标条件:跟踪目标可来自速度指令、末端位姿或 SMPL 身体姿态(Appendix B)——下游「速度编码器」接口用它;
- 终止建模:跟踪失败判据(如根部/末端高度偏差)同时用于训练终止头与评测口径(与 SONIC 官方判据不完全相同——论文与社区 FAQ 都做了披露);
- 局限自陈:只在平地训练,无地形/物体交互;真实数据精修与系统辨识留作未来。
📸 逐图讲解(9 张:论文 7 + 官网 2)
Figure 1:算力对比总览(头图)
(即文首头图。)左:World-Model Rollout 示意——策略在学到的可微世界模型里滚动改进;右:两行算力条——128 张 L40 × 168 小时(SONIC) vs 1 张 H100 × 3 小时(本文),标注 >1000× fewer GPU-h。这是全文的电梯陈述:方法差异 = 用共享动力学换掉暴力采样。
Figure 2:训练循环三段式(论文 Fig. 2)
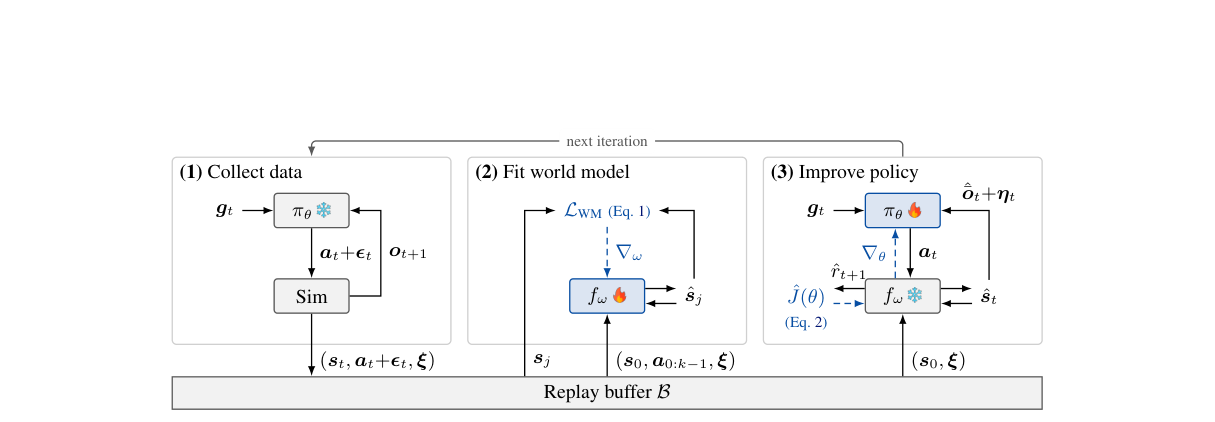
底部一条 Replay buffer B 贯穿三格:
- (1) Collect data:πθ(雪花=冻结?不——雪花表示该步不更新)带噪声 a+ε 进 Sim,产出 (s,a,ξ) 入库;
- (2) Fit world model:采样窗口更新 fω(火焰=可训练),损失 L_WM(Eq.1);
- (3) Improve policy:fω 冻结,πθ 在想象里收 ĥat{o}, η 与回报 ĥat{r}、状态 ĥat{s},BPTT 得 ∇θ 更新(Eq.2)。 读图抓手:每轮迭代都同时「更懂世界」与「更会控制」,但两者梯度路径完全分离——世界模型梯度来自数据拟合,策略梯度来自想象穿模。
Figure 3:主结果——GPU 时账本 + 缩放定律(论文 Fig. 3)
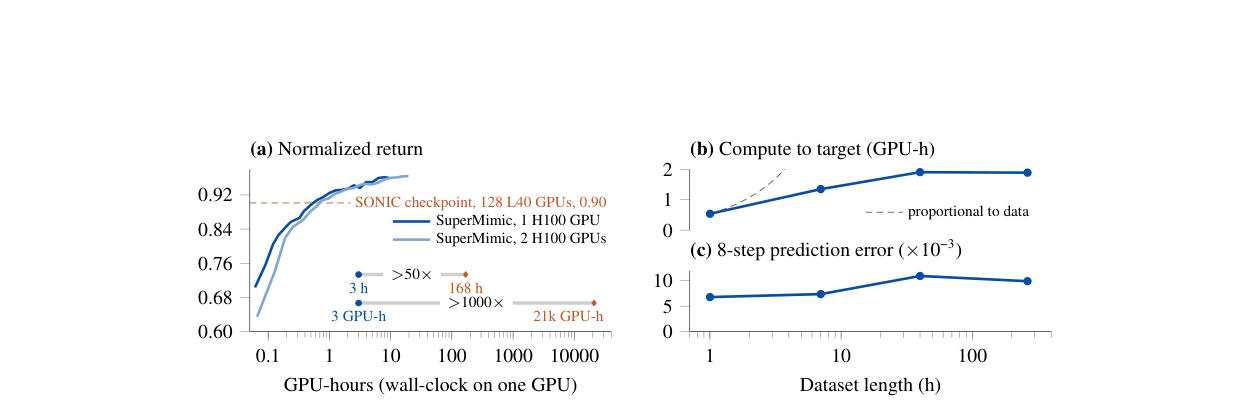
- (a) 归一化回报 vs GPU-时(对数轴):红色虚线 = SONIC checkpoint 0.90(128 L40、168h、21k GPU-h);深蓝 1×H100 约 3 GPU-h、浅蓝 2×H100 9.8h 便越过虚线——标注 >50×(墙钟)与 >1000×(GPU 时);
- (b) 达标 GPU-时 vs 数据时长:从 1h 到 264h,曲线只缓慢爬升(虚线「与数据成正比」作参照)——加数据的边际成本可控;
- (c) 8 步预测误差:全程 ~1×10⁻² 量级不发散——世界模型没有被大数据压垮。 这是「可测缩放定律」的证据链:误差稳、成本缓、回报高三者同时成立。
Figure 4:受控对比——打 PPO 与想象视野消融(论文 Fig. 4)
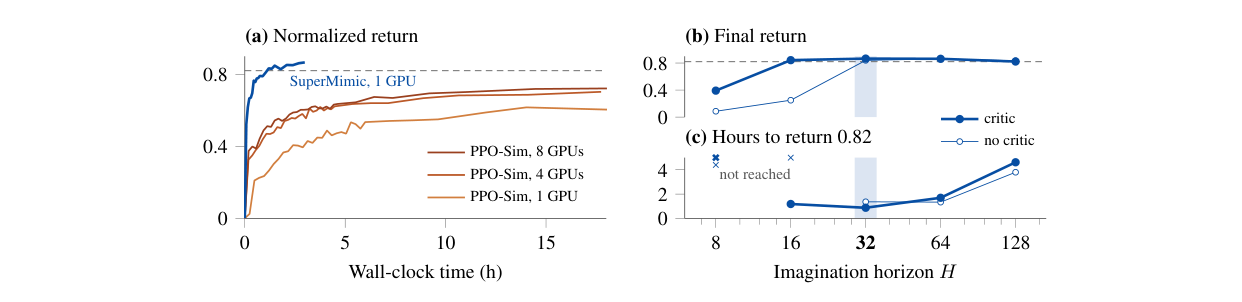
- (a) 墙钟时间:SuperMimic 单卡曲线一骑绝尘;PPO-Sim 1/4/8 卡跑到 ~17h 仍在 0.6–0.75 之间——同墙钟下单卡 MBRL 胜集群 PPO;
- (b) 最终回报 vs 想象视野 H:critic 版在 H=16 起冲到 ~0.8+,H=32 标高亮(默认);无 critic 时 H=8 直接崩、要 H=64 才追上——critic 是低视野稳定的必需品;
- (c) 达到 0.82 所需小时 vs H:H=32 最省(~1h 量级),H=8 无 critic「not reached」,H=128 反而更慢——视野不是越长越好,短视野+critic 才是甜点。
Figure 5:想象 rollout 又快又可微(论文 Fig. 5)
三小格:(a) H100 上批量想象吞吐——世界模型比 MuJoCo Warp 快 10×+;(b) 梯度流示意——∂ĥat{s}/∂θ̂ 与 ∂ĥat{s}/∂a 的 Jacobian 沿 H 步回传;(c) 8 步预测误差随数据稳定(与 Fig. 3c 呼应)。工程含义:「快」来自批量纯张量运算,「可微」来自模型本身——物理仿真器在这条梯度链路里彻底退居数据源。
Figure 6:真机 Unitree G1 全库迁移(论文 Fig. 6)
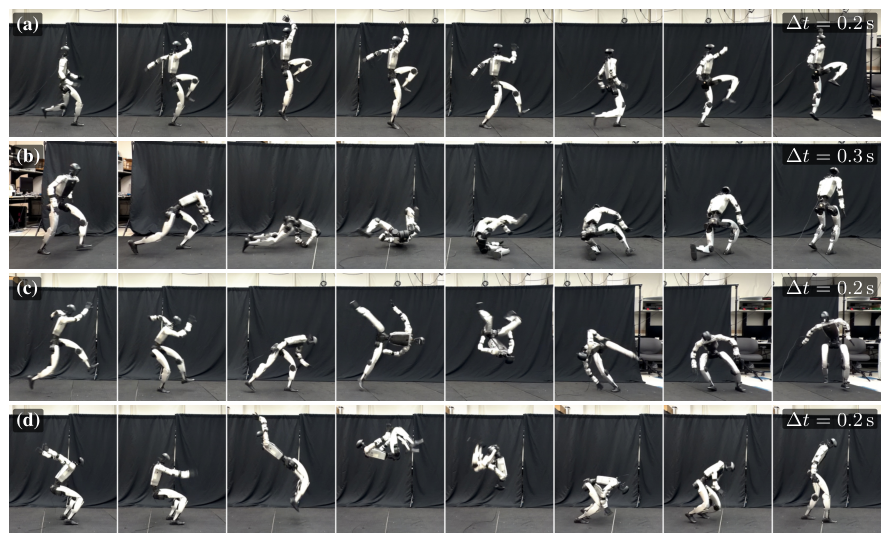
一个策略、多帧真机时序:走、跳、特技等多样动作直接上 Unitree G1——无逐动作微调。评测语境:仿真里 0.92+ 的跟踪策略,把根部平衡与落脚时序带进真实执行;与 SONIC 真机线同台时比的是「同一套动作库的可部署性」而非单项演示。
Figure 7:速度编码器——RL 训练胜过蒸馏(论文 Fig. 7)
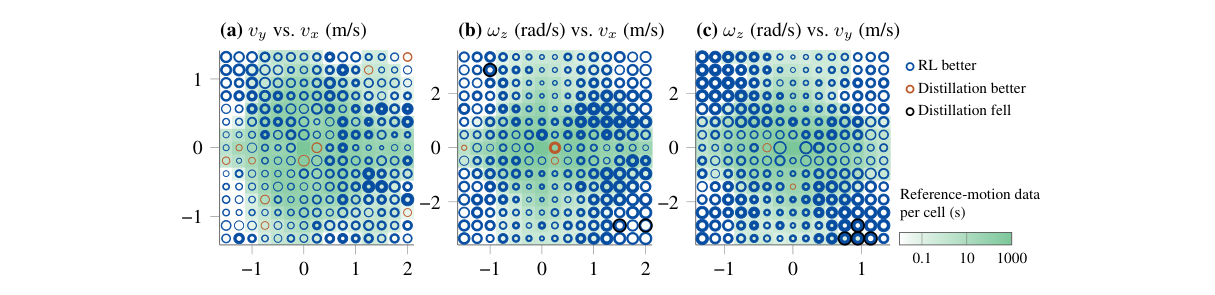
下游接口初步研究:把「速度指令 → 目标条件」的编码器分别用 RL(任务奖励直接训练) 与蒸馏基线获得,跟踪阶跃指令——RL 版误差更小、跟随更稳。含义:可微世界模型不仅训练本体策略,还能给下游接口供给快速训练环境(同一个模型当「接口的仿真器」)。
官网图 1:单卡墙钟账本(官网 media)
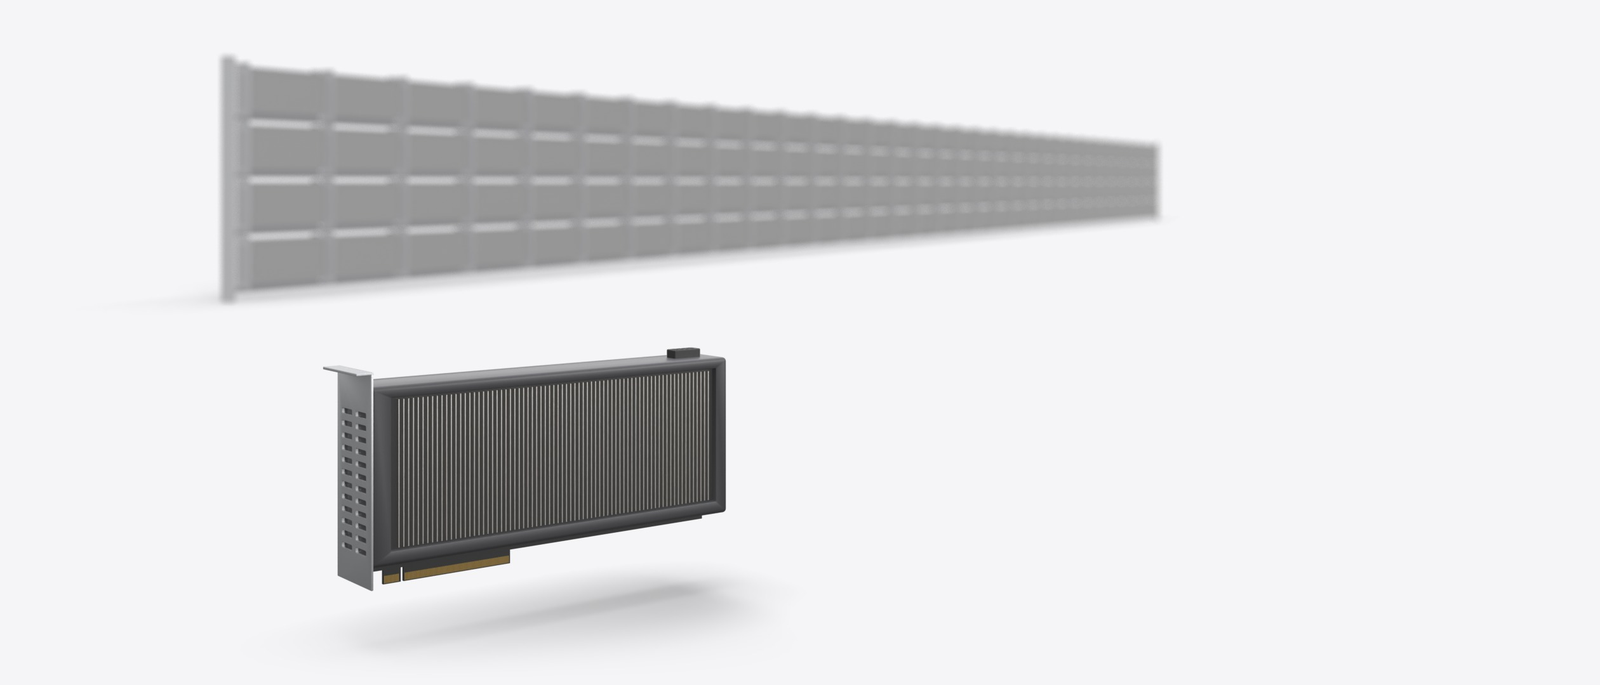
官网「Compute」区的墙钟对照条:168 h(7 天,SONIC)vs 3 h(SuperMimic),以及 GPU-时 ~21,000 vs 3、动作数据 611h vs 264.56h(公开子集)、失败数 179 vs 25→0——正文数字的可视化版,FAQ 还专门回答「比较公平吗」:硬件(L40 vs H100)与数据(43% 公开子集)差异都朝不利于 SuperMimic 的方向,结论仍成立。
官网图 2:演示海报(官网 media)
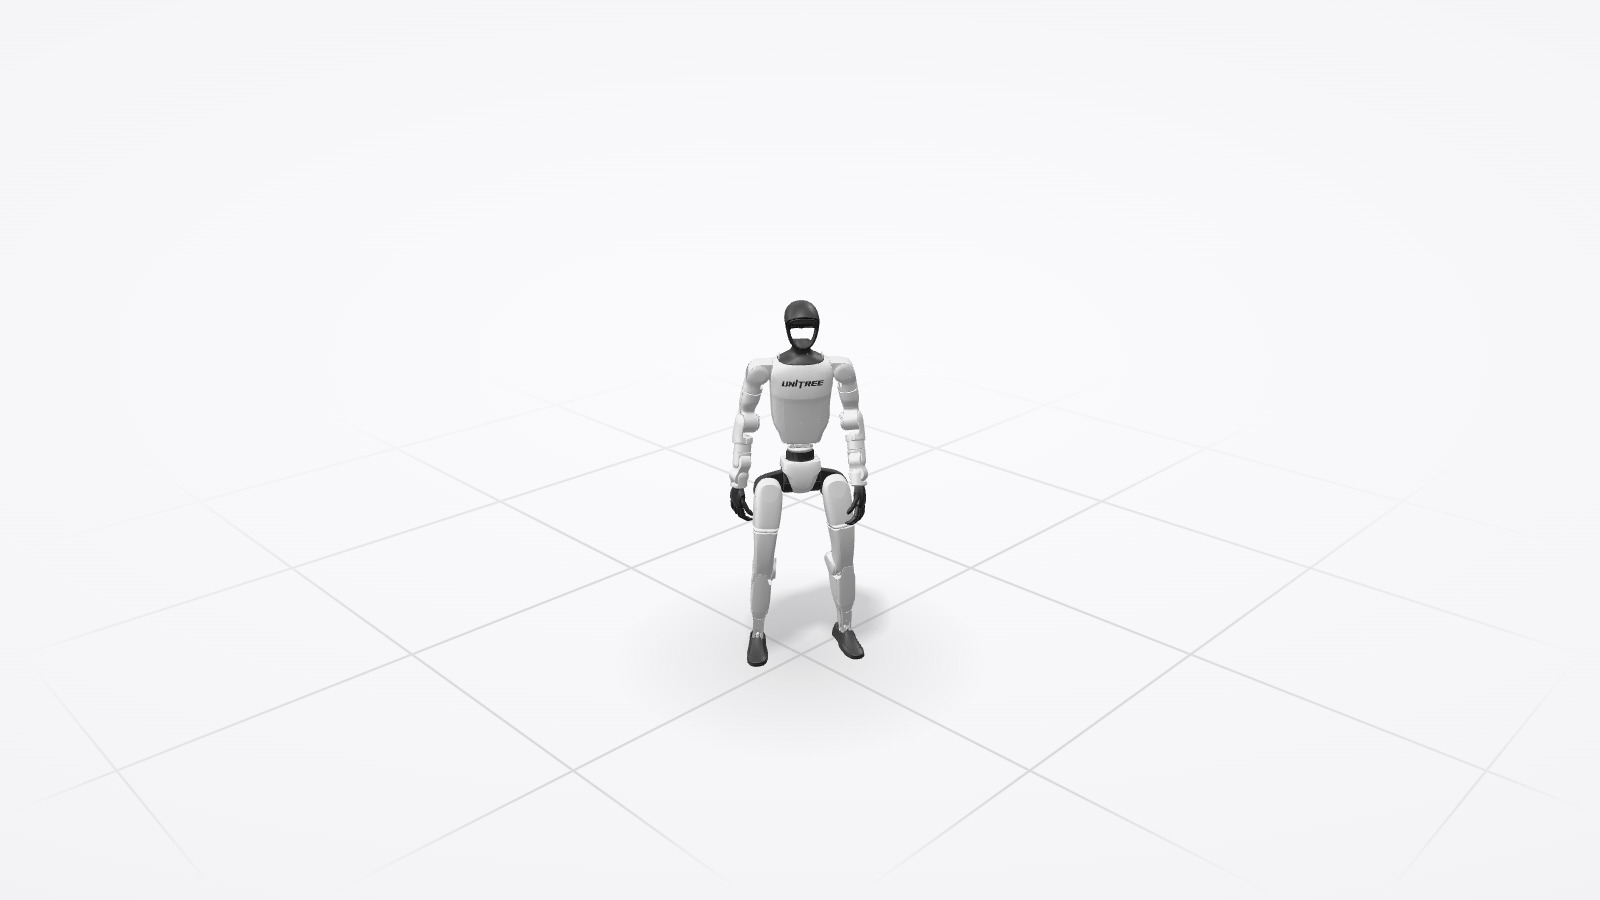
真机影片的封面海报(完整片见官网 film-1080.mp4)——G1 在真实空间执行库里动作的实拍剪影。阅读方式:先看方法数字,再看片子验证「没坏」;官方声明页面上每段真机视频都是同一策略、无逐动作调参。
🧪 实验速查
- 主对比(Fig. 3a):3 GPU-h 越过 SONIC 0.90 线;失败 25/129,514(SONIC 179);双卡 9.8h 失败清零——注意 alphaXiv 作者自评披露:两边失败判据不完全一致(SONIC 用其论文的根/末端高度 0.25m 判据、无朝向项;SuperMimic 用自身训练终止),比较时当「覆盖率代理」而非同口径竞技。
- 受控 PPO 对比(Fig. 4):同机同奖励族下,PPO-Sim 8 卡仍追不上单卡 MBRL 的墙钟效率;想象视野 H 与 critic 的交互给出可复用的超参结论(H=32+critic)。
- 缩放定律(Fig. 3b/c):数据 264×,模型误差不涨、成本缓涨——首次让「动捕规模 → 控制能力」的曲线变得可测(这是标题里 Scaling 的真正含义)。
- 真机 + 接口(Fig. 6/7):G1 全库迁移;RL 速度编码器初胜蒸馏。
💡 评析:三个亮点,三条边界
三个亮点
- 给 MBRL 正名:模型基方法长期「样本省但算不快」——SuperMimic 用可微学习模型 + 短 BPTT 把墙钟与 GPU 时双赢做实,动摇了「人形跟踪 = PPO 集群」的默认路线。
- 算力民主化:单卡 3 小时的设定意味着社区能做缩放消融(数据量、视野、奖励族),而不用等 128 卡排期——社区一周内井喷复现(见下节)正是被这一点点燃。
- 账本与口径公开:失败判据差异、公开子集比例、终止条件都写进论文/FAQ——对比虽「不对称硬件」但方向性偏袒被显式讨论。
三条边界
- 平地-only:无地形/物体交互,「全地形人形」仍要另一条线;
- 判据不对称:失败数 25 vs 179 不是同规则竞技(作者已声明);
- 世界模型误差 ≠ 闭环完美:8 步误差稳定不保证 H=32 想象下的复合误差处处无偏——长视野漂移仍是 MBRL 的经典幽灵(H=128 变慢是征兆之一)。
🧰 GitHub 生态:官方未挂代码,supermimic_vibed 领跑的复现潮
先回答两个常见疑问:①这是刚出的文章吗?——是:arXiv 2026-10-20 提交、CoRL 2026 Oral,本文写作时刚满一周;②官方有 GitHub 吗?——没有:论文、官网、arXiv 页面均未挂代码链接,社区 README 亦明言 “no official code is released”;官网只给 PDF、影片、算力账本与 BibTeX。但「没挂官方链接」≠「没人能跑」——论文上线次日起 GitHub 就进入复现潮,两天内形成事实标准。
0)zita-ch/supermimic_vibed(706★,MIT)——事实上的参考实现
- 身份:非官方复现(README 首行即声明 Unofficial),作者 Chong Zhang(ETH Zurich),论文发布次日(10-21)建库;自称 1 小时 AI 辅助 vibe-code 完成,并特意说明「不挂任何实验室 org,因为代码太 slop、未经审查,自担风险」——这份坦诚反而成了它的招牌;
- 技术栈:Isaac Lab 3(kit-less Docker,main@46d6cc3)+ Newton + MuJoCo-Warp 求解器(无 Kit/PhysX),50Hz 控制、4×5ms 子步;数据脚本拉取 LAFAN1 G1 retarget(HF)并生成
g1_29dof.xml/USD; - 结果:论文受控 LAFAN1 对比(Fig. 4a)设定——单卡 1.47h(RTX PRO 6000)评测回报 0.829、0/40 失败(论文目标 1.2h 达 0.82;PPO 基线 18h、最多 8 卡都到不了 0.82);
- 地位:Uni-SuperMimic 等后续仓库 README 直接写「参考
supermimic_vibed」——它就是这条生态线的事实标准,尽管作者自己叫它 slop。
1)miao-org/awesome-supermimic(312★)——复现目录
持续整理的实现/扩展/演示合集(awesome 体例):把 80+ 个仓库按主线复现、硬件移植、下游改造分类收录——「看全生态从这进」。
2)Motphys/Uni-SuperMimic(195★,Apache-2.0)——最完整独立复现
- 定位:在 UniLab 上对 SuperMimic 的独立下游复现——Unitree G1 全身跟踪 LAFAN1 动作库,mjwarp / MuJoCo / Motrix 三后端;
- 结构(README 目录树):
src/unisupermimic/rl/algos/supermimic/(世界模型、策略、critic、replay、learner)+tasks/motion_tracking/g1/supermimic/(Manager 环境、可微 MDP、确定性全片评测、对比视频导出、G1 注册)+ Hydra 配置 + G1 MJCF/LAFAN1 CSV 资产下载脚本 + sim2sim 一致性校验(策略 I/O、网络形状、动作库、MJCF 同一性); - 训练/评测命令:
uv run unisupermimic-train(Hydra 覆盖后端);确定性全库评测play_only=true;视频导出unisupermimic-video(默认对齐参考根部 XY,--global-ghost保留全局位移); - 结果(README):
- LAFAN1 40 条:ckpt 12000,mjwarp+4096 环境,norm_return 0.827,失败 0/40;
- BONES-SEED 全保留库 129,487 条(47.3M 帧):单张 RTX 4090 1.69h 训练,norm_return 0.9243,失败 350/129,487(0.27%);分布中位 0.9528、P10 0.8337、P90 0.9841;RTX 5090 独立复跑 0.9262(差 <0.002);
- 许可:代码 Apache-2.0,并保留参考实现的 MIT 声明——合规细节可当模板。
3)CuboiLeo/SuperMimic-Reproduced(308★)——「论文转录 + 从零实现」派
- 从零复现(mjlab/MuJoCo Warp 底座):LAFAN1/BONES-SEED 数据管线、可微 FK 与解析奖励头、世界模型与想象训练器、torchrun 数据并行、附录 F 基准、交互回放器;
- 文档即资产:
docs/PAPER_SPEC.md(论文全部数值/公式/协议逐条转录 + 「未指明」清单 U1–U20)、REPRODUCTION_PLAN.md(设计决策 D1–D20)、EXPERIMENTS.md(逐实验日志与踩坑)——中文文档,适合当「论文精读的配套注释」读; - 结果:LAFAN1 上 RTX 5090 单卡 1.66h 达论文 0.82(锚点相对观测;作者明确说明与论文 93 维纯本体观测口径的偏离及其导致的回报上限差异)。
4)索引与改造潮
除 awesome-supermimic 外还有 QinnyuLan/SuperMimicCarnival(复现进度追踪);改造方向两天内已外溢出人形跟踪本体:灵巧手(CumulusAlpha/Dex-Supermimic 67★)、四足(go2-supermimic 66★)、机械臂状态跟踪(supermimic_manipulation 38★)、G1 仿真到真机(南大组 SuperMimic-Repro-Sim2Real 33★)、肌肉驱动人形(muscle-supermimic 30★)、高动态动作特化(Baojch 前空翻/侧翻套件 21★)等数十个——「一个可微世界模型」正被当成通用训练器模板往外复用。
怎么用这节:想快速跑通 → supermimic_vibed(最流行、LAFAN1 1.5 GPU 时 0.829,但作者自认 slop);想工程化落地 → Uni-SuperMimic(三后端+全库评测+清晰许可);想抠论文细节 → CuboiLeo 的 PAPER_SPEC/实验日志;想看全名单 → awesome-supermimic / Carnival。官方代码一旦放出,以上均可作为对照实现。
❓ 自测 Q&A
Q1:为什么世界模型能比物理仿真「快 10 倍」?
物理引擎每步要解接触/约束(MuJoCo Warp 已是 GPU 极限优化版);学习到的 MLP 世界模型只有批量矩阵运算——且只预测短窗(8 步误差就够用),不做长程物理。
Q2:BPTT 会不会算力爆炸?
视野被压到 H=32 以内(消融:更长反而更慢),配合短 replay 窗口——梯度链路短,单卡才装得下。
Q3:和 SONIC 的比较公平吗?
硬件不同(L40×128 vs H100×1)、数据不同(611h vs 264.56h 公开子集)、失败判据不同——官网 FAQ 与论文附录逐条披露;作者立场:前两项差异都不利于自己,第三项当覆盖率代理看。
Q4:为什么无 critic 在 H=8 会崩?
低视野下回报信号更稀、 bootstrap 更重要——critic 提供的价值基线让短想象仍能估对动作好坏(Fig. 4b/c)。
Q5:速度编码器实验说明什么?
可微世界模型可以复用为下游接口的训练场:同一个模型里 RL 训编码器比蒸馏更快更准(Fig. 7)——MBRL 的红利不止本体策略。
📊 图表总索引(9 张)
| 图 | 内容 | 本站文件 |
|---|---|---|
| Figure 1(头图) | 世界模型训练 + 1000× GPU 时对比 | 本文插图 |
| Figure 2 | 训练循环三段式 + replay | 本文插图 |
| Figure 3 | 主结果账本 + 缩放定律(a/b/c) | 本文插图 |
| Figure 4 | PPO 受控对比 + 想象视野消融 | 本文插图 |
| Figure 5 | 想象 rollout 吞吐与可微性 | 本文插图 |
| Figure 6 | 真机 G1 全库迁移 | 本文插图 |
| Figure 7 | 速度编码器 RL vs 蒸馏 | 本文插图 |
| 官网图 | 单卡墙钟/GPU-时账本 | 本文插图 |
| 官网图 | 真机演示海报 | 本文插图 |
📚 资源与延伸
- 论文:arXiv 2610.28480;官网 supermimic.github.io(含 /demo 与算力 FAQ)
- GitHub 生态:zita-ch/supermimic_vibed(706★,事实标准参考实现)· miao-org/awesome-supermimic(312★ 目录)· Motphys/Uni-SuperMimic(195★)· CuboiLeo/SuperMimic-Reproduced(308★)· SuperMimicCarnival(进度索引)
- 同赛道精读:具身智能强化学习调研精读(SONIC 章 + VLA-RL 谱系)· GR00T-N1.7 精读(N1.7 亦接 SONIC 全身控制)
- 知识铺垫:PPO 强化学习方法详解、GRPO 强化学习方法详解