论文信息
- 标题:Planning-oriented Autonomous Driving(面向规划的自动驾驶)
- 作者机构:上海人工智能实验室 × 武汉大学 × 复旦大学
- arXiv:2212.10156(CVPR 2023 最佳论文奖,是该会议历史上首篇自动驾驶领域的最佳论文)
- 代码:github.com/OpenDriveLab/UniAD
- 一句话总结:首次把感知、预测、规划全部统一进一个可端到端联合训练的网络里,以规划为最终目标反向驱动所有任务,开创了显式端到端的新范式。
要解决什么问题?
在 UniAD 之前,自动驾驶工业界几乎清一色采用分模块拼接的方案:检测 → 跟踪 → 在线建图 → 运动预测 → 占用预测 → 规划与控制。每个模块单独训练、各自调优,最后用规则串联起来。这种 pipeline 成熟可靠,但有几个根本性顽疾:
| 痛点 | 表现 | 后果 |
|---|---|---|
| 误差累积 | 上游漏检一个目标,下游预测/规划全错 | 错误"滚雪球" |
| 信息丢失 | 模块间只传结构化结果(框/轨迹),丢掉了特征级信息 | 后段无法补救前段 |
| 目标错位 | 每个模块都在自己任务上刷分,跟"开得好不好"脱节 | 感知 SOTA ≠ 规划好 |
| 几何失配 | 不同任务用不同表示(栅格/矢量/网格),难以融合 | 系统复杂、难优化 |
而另一条隐式端到端路线(直接"图像进、控制出",典型如早期的行为克隆)虽然能联合优化,却完全黑盒、不可解释、不可调试,且难以吸收多年积累的感知预测知识。
UniAD 的灵魂拷问:既然所有任务最终都是为"把车开好"服务的,那为什么不以规划为导向,把感知预测都装进一个可训练的网络里?既享受端到端的梯度贯通,又保留显式的中间表示(轨迹、地图、占用)以维持可解释性——这就是论文标题 “Planning-oriented” 的含义。
核心思想:以规划为最终目标统一所有任务
UniAD 给出了一条折中路线,介于"纯分模块"与"纯黑盒端到端"之间:
多任务统一 + 显式中间表示 + 以规划为锚点的端到端联合优化
它的关键判断有三条:
- 规划是唯一终极目标:感知、预测的存在意义就是服务规划,所以训练时应当让规划的梯度一路回传到感知,而不是各模块各刷各的分。
- 中间表示不能丢:把检测框、轨迹、地图、占用栅格这些显式表示保留下来,既可解释、又可单独监督、还能复用已有知识。
- 用 query 把所有模块串起来:用同一套 Transformer query 机制贯穿全流程,让信息在特征级流动,避免"框/栅格"这种有损的硬传递。
先看 UniAD 的整体架构,再理解它为什么选择了这种设计。
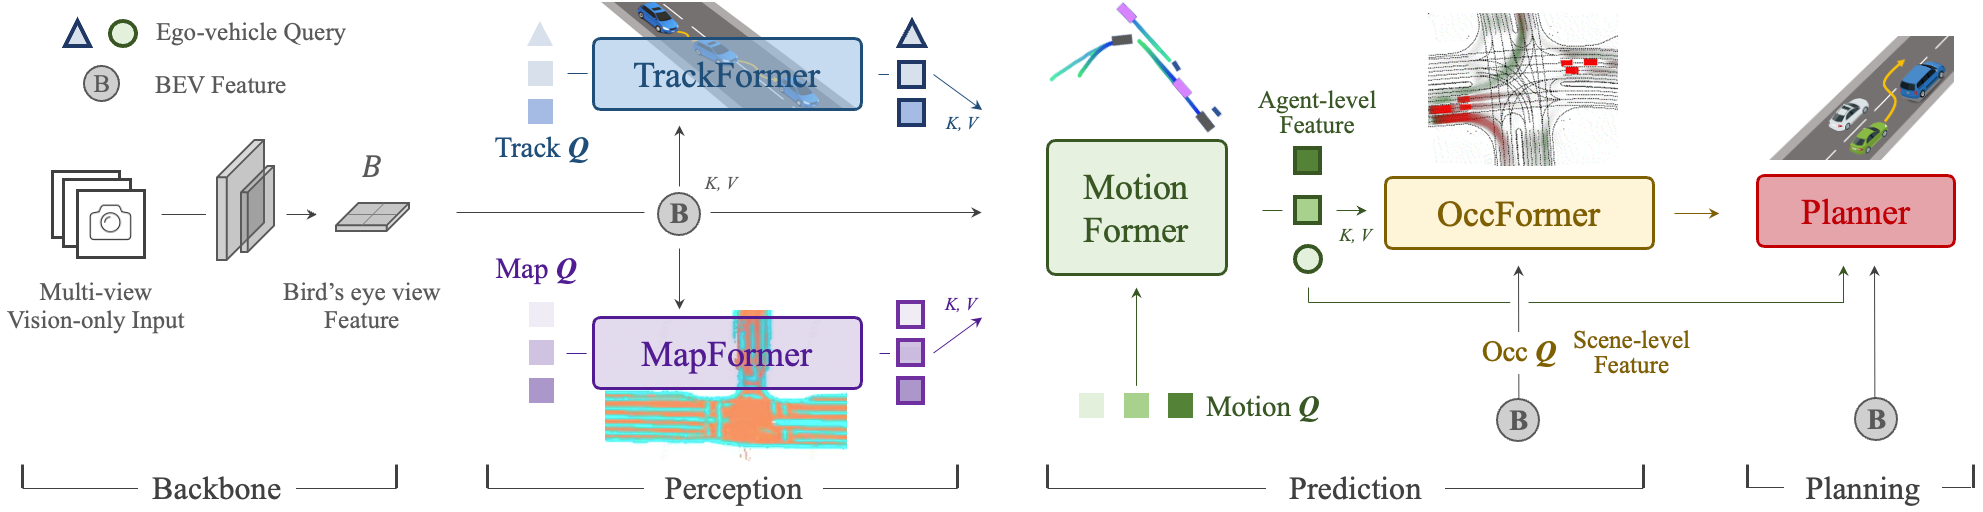
图 1:UniAD 整体架构。 环视六相机图像流式输入,经 BEVFormer 编码为 BEV 特征 B。随后五个 Transformer decoder 模块依次处理:TrackFormer 输出 agent query Q_A(跟踪到的智能体),MapFormer 输出 map query Q_M(地图元素),MotionFormer 输出多模态轨迹预测,OccFormer 输出未来占用栅格,Planner 结合自车 query 生成规划轨迹。所有模块通过 query 接口传递信息,梯度可从规划 loss 贯通至感知。
UniAD 的完整 pipeline:多相机图像 → TrackFormer(跟踪) → MapFormer(在线建图) → MotionFormer(轨迹预测) → OccFormer(占用预测) → Planner(规划)。关键在于:每一段的输入输出都是 query,而不是传统的框或栅格。这样梯度就能从最后的规划 loss 一路贯通回最前面的感知,真正做到"为规划而训练"。
作为对比,下图为论文给出的几种自动驾驶框架设计路线——从纯分模块、多任务学习到最终 UniAD 选择的显式端到端范式,展示了 UniAD 在设计哲学上的选择:
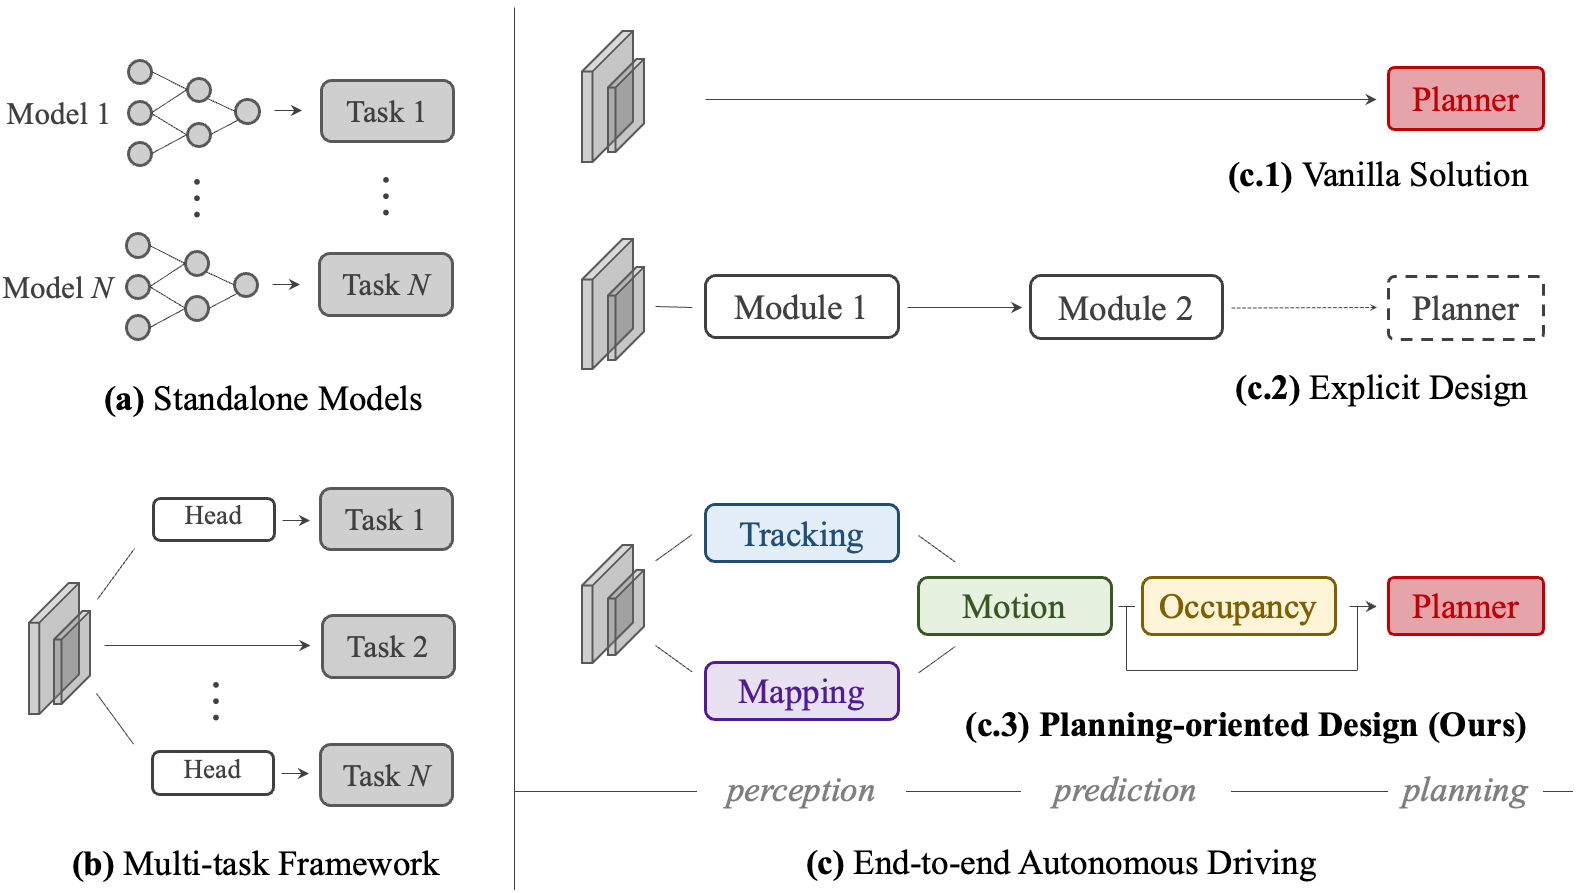
图 2:五种自动驾驶架构范式对比。 (a) 分模块独立模型:各任务独立训练,信息传递有损,误差累积严重。(b) 多任务学习(MTL):共享骨干但各任务 head 独立,缺乏任务间显式交互。(c.1) 黑盒端到端:传感器直出控制信号,完全不可解释。(c.2) 部分组件端到端:仅局部链路可微。(c.3) UniAD 的规划导向范式:所有感知/预测模块以 Transformer decoder 结构组织,通过 task query 交互,最终服务于规划。相比其他范式,UniAD 同时做到了"梯度贯通"和"可解释性"。
UniAD 各模块的核心配置:
| 模块 | Decoder 层数 | Query 数量 | 特征维度 |
|---|---|---|---|
| TrackFormer | 6 | 900 → N_a | 256 |
| MapFormer | 6 定位 + 4 mask | 300 (thing) + 1 (stuff) | 256 |
| MotionFormer | 3 | N_a × 6 (模态) | 256 |
| OccFormer | 5 个时间块 | N_a + 密集 BEV | 256 |
| Planner | 3 | 自车 query | 256 |
下面逐段拆解。
第一段:TrackFormer(跟踪模块)
TrackFormer 负责联合检测与多目标跟踪(MOT),不需要任何不可微的后处理(如传统的匈牙利匹配 + 卡尔曼滤波)。
设计机制
它采用两套 query 设计,继承自 MOTR:
- Detection queries:标准检测 query(900 个),负责在当前帧发现新目标。初始化为可学习的 positional embedding,通过 6 层 Transformer decoder 与 BEV 特征交互,输出检测框和类别。
- Track queries:跟踪 query(动态数量),负责跨帧追踪已跟踪的目标。每帧更新后传递到下一帧,保持 ID 连续性。
核心创新:query 的跨帧传播
TrackFormer 最关键的设计:每帧结束后,与 ground truth 匹配成功的 query 作为下一帧的 track query 保留,匹配失败的检测 query 被丢弃。新一帧输入时,上一帧的 track query + 新初始化的 detection query 一起输入,共同处理。
这种机制使得:
- 无需显式关联:query 本身就携带了身份信息,跨帧自动对应
- 端到端可微:整个跟踪过程没有硬性后处理
- 遮挡鲁棒:被遮挡的智能体可以通过 track query 的记忆特性维持跟踪
输出
TrackFormer 输出一组 agent query \(Q_A \in \mathbb{R}^{N_a \times 256}\),其中 \(N_a\) 是当前帧检测到的动态智能体数量(车、人、骑行者等)。每个 query 编码了该智能体的位置、朝向、尺寸、速度等属性,同时携带了 BEV 特征级信息。
除了 agent query 外,TrackFormer 还维护一个特殊的自车 query(ego-vehicle query),它不会参与预测-真值匹配,而是专门预测自车位置,供下游规划使用。
第二段:MapFormer(在线建图模块)
MapFormer 负责从 BEV 特征中实时提取矢量化地图元素,包括车道中心线、车道分隔线、道路边界、人行横道等。
设计机制
MapFormer 采用 MapTRv2 的结构,使用两类 query:
- Thing queries(300 个):负责实例级地图元素(车道线、边界、人行横道等),通过二分图匹配与 ground truth 配对
- Stuff query(1 个):负责语义级元素(可行驶区域),采用固定类别分配
结构为 6 层定位 decoder + 4 层 mask decoder。定位 decoder 预测地图点的坐标,mask decoder 预测每个地图元素的语义 mask。
输出
MapFormer 输出 map query \(Q_M \in \mathbb{R}^{N_m \times 256}\),\(N_m=300\),编码了周围道路的拓扑结构。这些 map query 将为 MotionFormer 提供"车该往哪开"的道路约束。
第三段:MotionFormer(运动预测模块)
MotionFormer 是 UniAD 的技术核心之一。它基于 agent query 和 map query,预测每个智能体未来 3 秒(12 个 waypoint,间隔 0.5s)的多模态运动轨迹,同时建模自车与其他智能体的交互。
三类交互建模
MotionFormer 的核心是其三重交互机制。每个 motion query \(Q_{i,k}\)(第 i 个 agent 的第 k 个模态)同时经历三类交互:
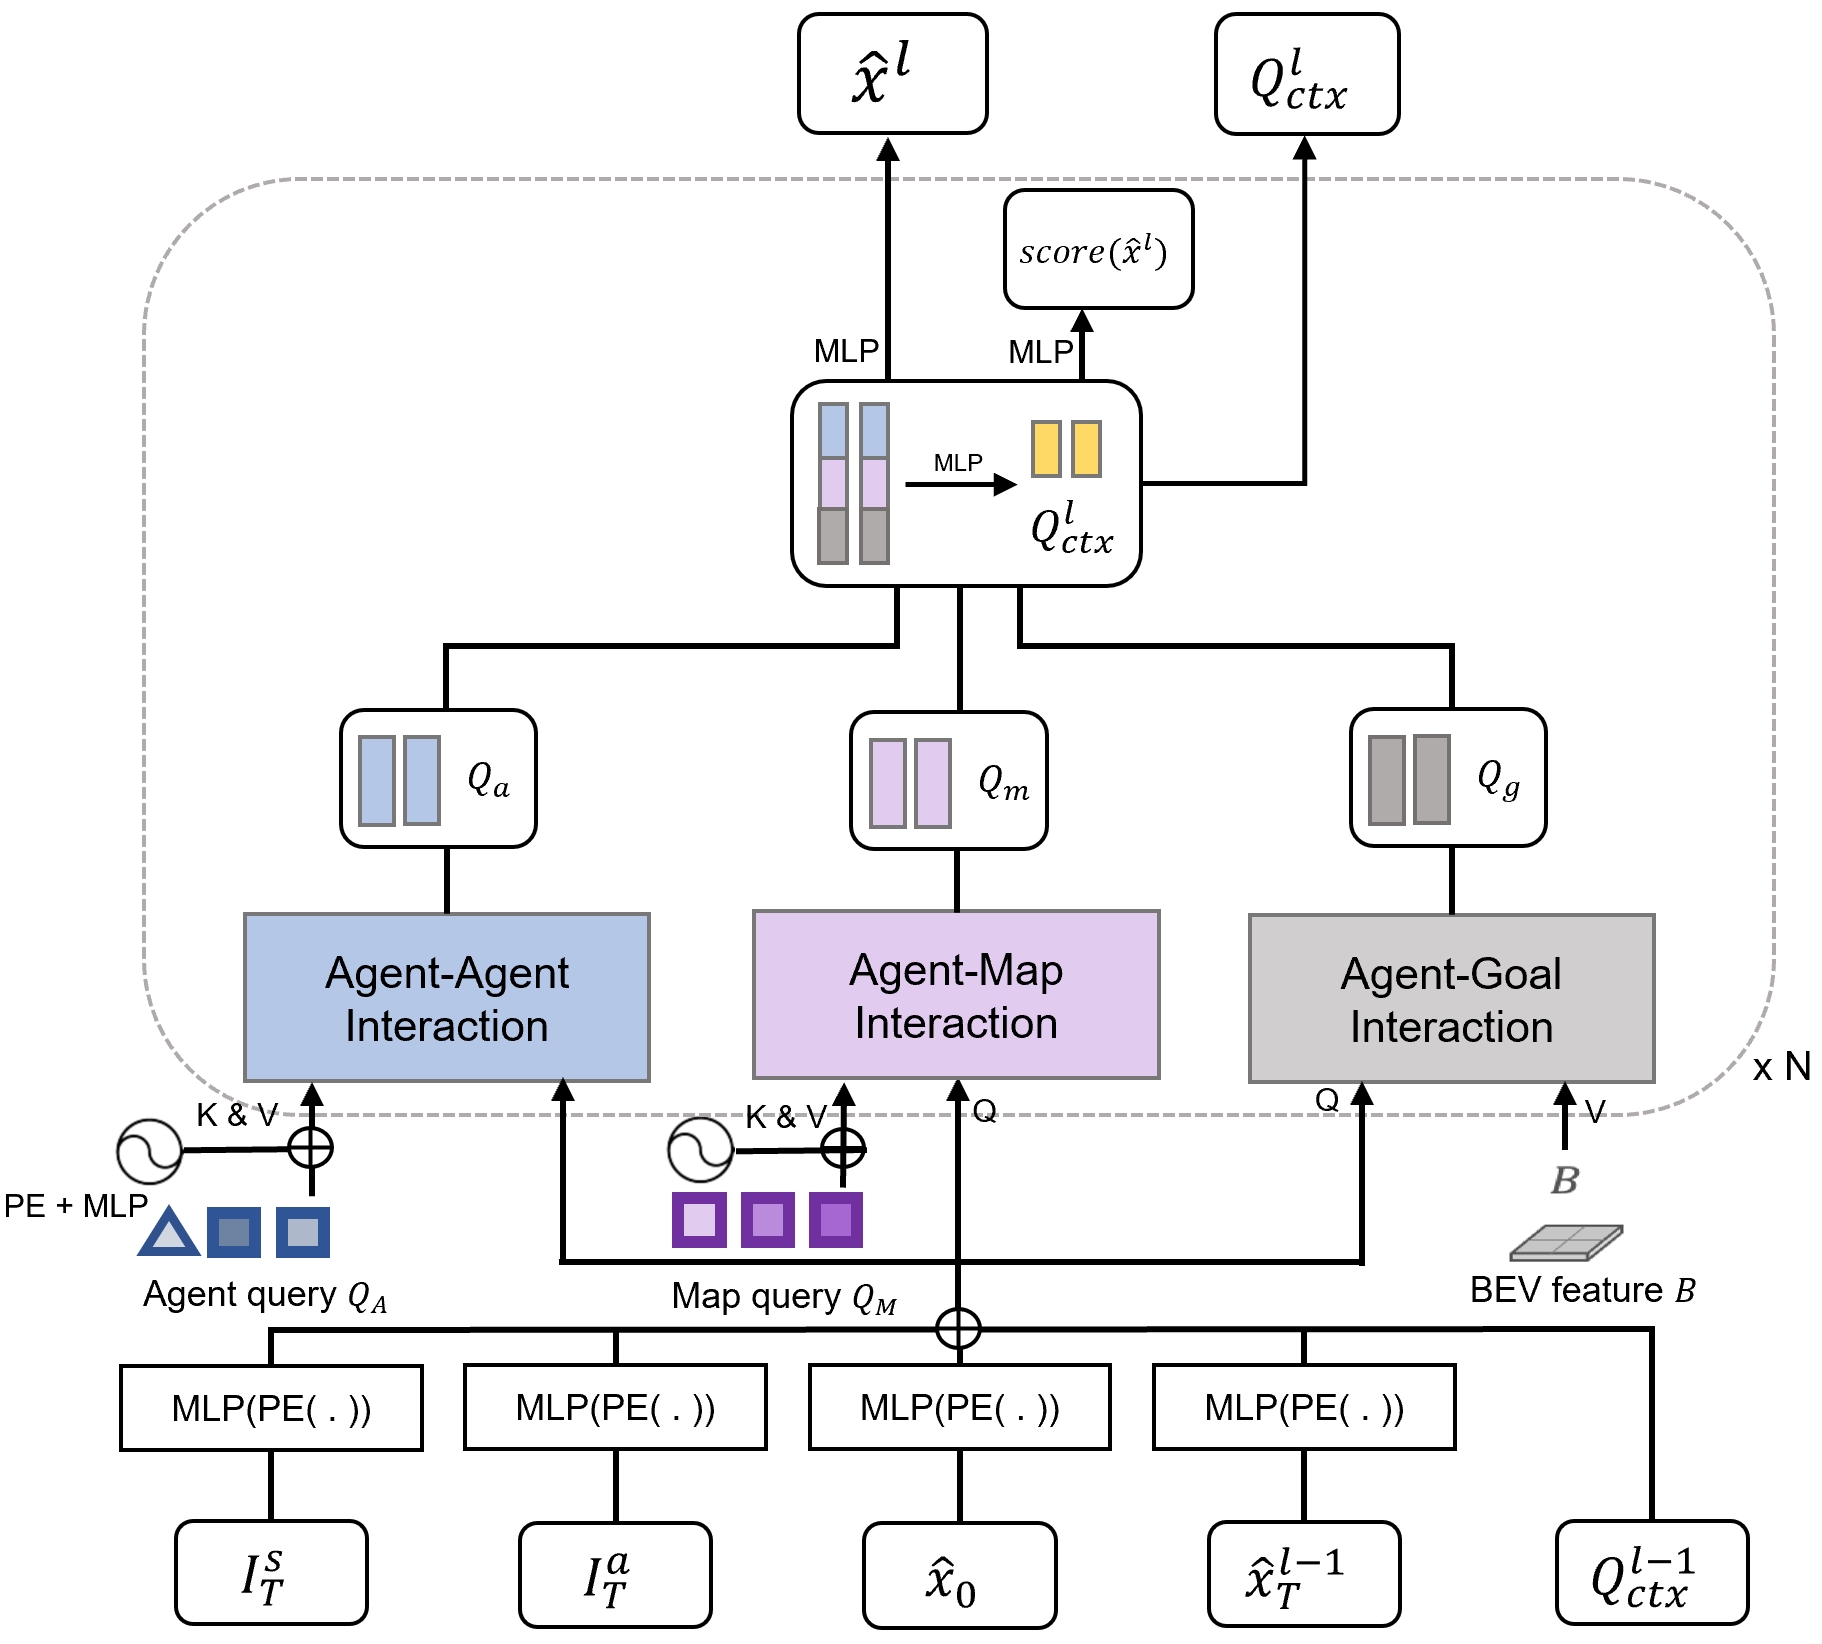
图 3:MotionFormer 详细结构。 由 N 层堆叠的 agent-agent、agent-map、agent-goal 交互 Transformer decoder 组成。agent-agent 和 agent-map 交互使用标准 Transformer decoder 层(MHSA + MHCA),agent-goal 交互基于可变形注意力(Deformable Attention)模块。每个 agent 有 K=6 个模态,各模态独立经历这三类交互后,通过 MLP 融合为 query context。
① Agent-Agent 交互(智能体间)
每个 agent 的 query 对其他所有 agent 做 MHSA + MHCA,建模"谁在关注谁"——自我车预测前车轨迹时,需要考虑前车是否被旁边车道的车辆影响。这种联合预测(joint prediction)而非独立预测(marginal prediction)是 UniAD 的重要特点。
② Agent-Map 交互(智能体与地图)
agent query 对 map query 做 MHSA + MHCA,让每个 agent 了解它受哪些车道线/道路边界约束。例如,一个 agent 在当前车道内行驶,它的注意力会集中在所在车道的地图元素上,从而知道"不能超出车道线"。
③ Agent-Goal 交互(智能体与终点)
这是 MotionFormer 最有特色的设计。使用可变形注意力(Deformable Attention),以上一层的预测终点 \(\hat{x}_T^{l-1}\) 为参考点,在 BEV 特征 B 上做稀疏注意力采样:
\[ Q_g = \text{DeformAttn}(Q, \hat{x}_T^{l-1}, B) \]这相当于告诉模型:“你认为你要去那里,仔细看看终点附近有什么”。通过逐层 refine,预测轨迹越来越精确。这借鉴了 DETR 中 iterative box refinement 的思想。
Motion Query 的构建
Motion query 由两部分组成:query context \(Q_{\text{ctx}}\) 和 query position \(Q_{\text{pos}}\)。
\(Q_{\text{pos}}\) 融合了四类位置信息:
\[ Q_{\text{pos}} = \text{MLP}(\text{PE}(I^s)) + \text{MLP}(\text{PE}(I^a)) + \text{MLP}(\text{PE}(\hat{x}_0)) + \text{MLP}(\text{PE}(\hat{x}_T^{l-1})) \]- \(I^s\):场景级锚点(scene-level anchor),对所有 agent 通用的 k-means 聚类轨迹(K=6),表示常见的运动模式
- \(I^a\):智能体级锚点(agent-level anchor),从训练集中对该类智能体聚类的轨迹
- \(\hat{x}_0\):智能体当前位置
- \(\hat{x}_T^{l-1}\):上一层预测的终点
MotionFormer 输出
每个被跟踪的 agent 得到 K=6 条多模态轨迹(每条 12 个 waypoint),附带各轨迹的置信度分数。所有 agent 的预测是联合优化的——每个 agent 的轨迹生成时已经考虑了其他 agent 的响应。
此外,自车 query 也通过 MotionFormer 的前向传播与场景中的所有 query 交互,从而携带了全局场景理解。
第四段:OccFormer(占用预测模块)
运动预测只对被检测到的、可跟踪的目标做轨迹预测。但真实世界里还有大量未观测到、不规则、难以归类的障碍物(散落物、异形车、施工围挡)。OccFormer 用一个 BEV 栅格去预测"未来某个时刻,每个格子会不会被占据",补上了运动预测的盲区。
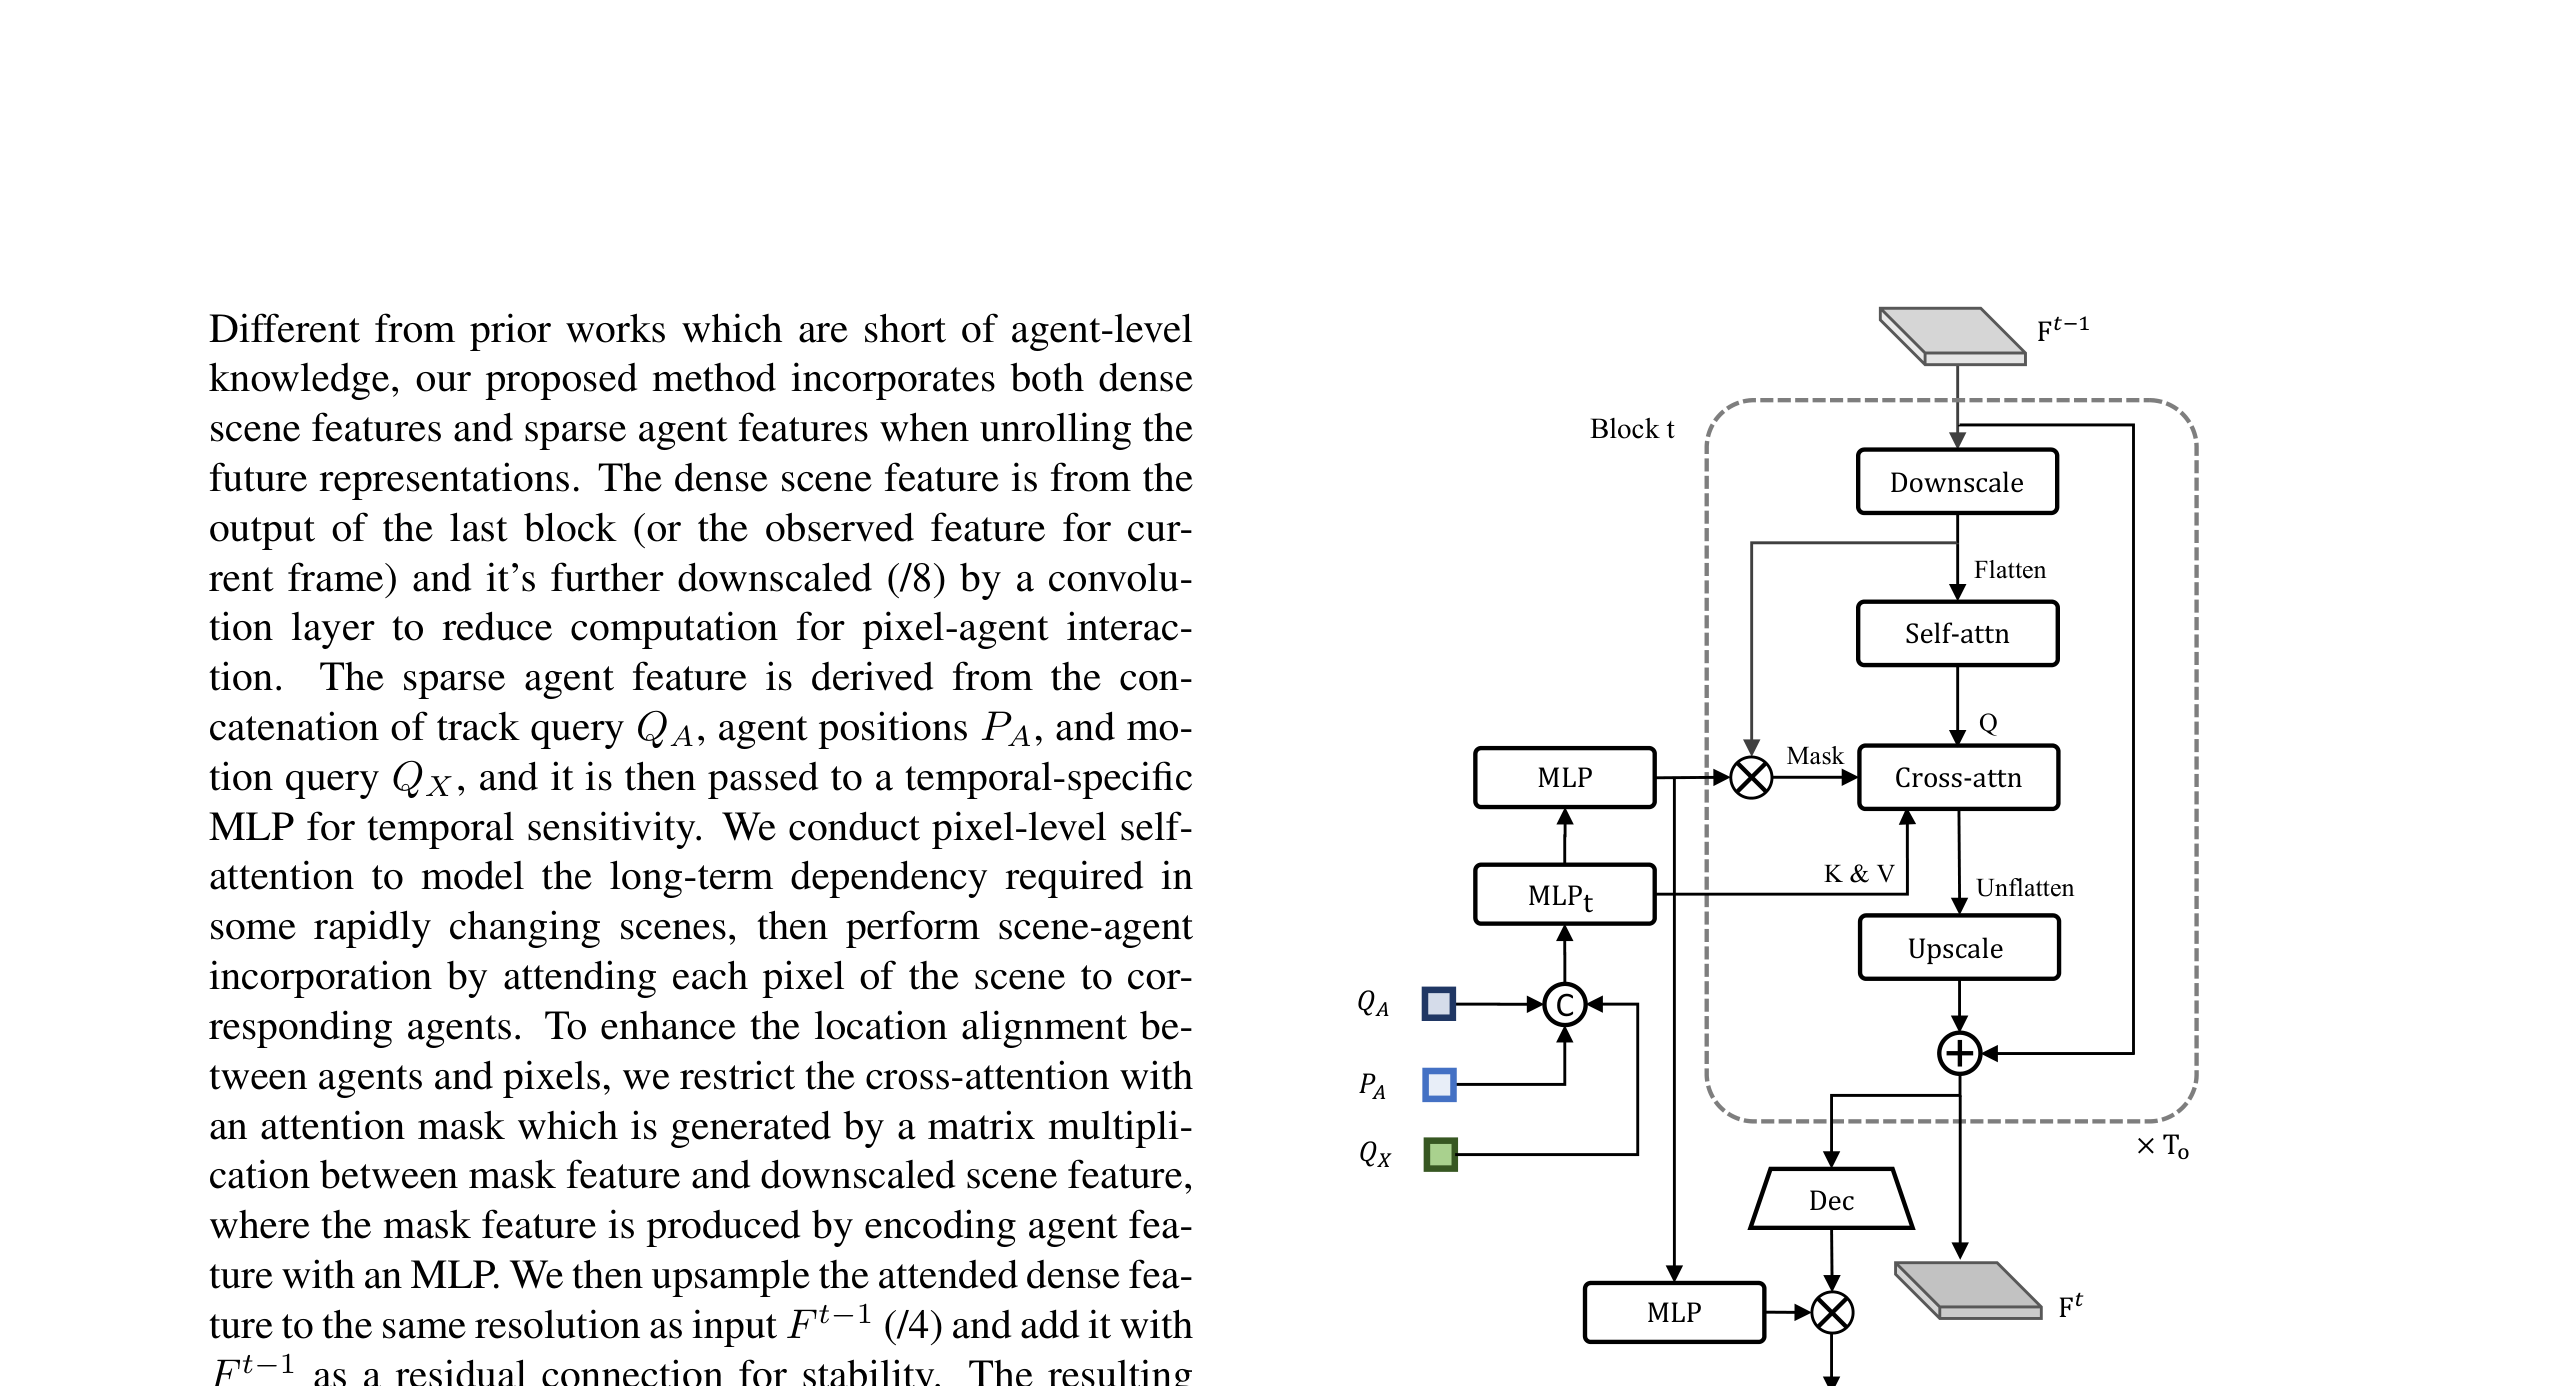
图 4:OccFormer 架构。 OccFormer 由 T_o=5 个时序块堆叠而成。每个块以 BEV 特征和 agent 特征为输入:BEV 特征依次经过下采样 → pixel self-attention → pixel-agent cross-attention(受注意力 mask 约束)→ 上采样 → 残差相加;agent 特征由 track query、agent 位置和 motion query 经时序特化 MLP 融合得到。每个块输出当前时间步的占用预测,同时传入下一块作为输入。
设计机制
OccFormer 在时间上展开——5 个时间块,每个块预测未来一个时间步的占用栅格。
Agent Feature 构建
首先,从 MotionFormer 最后一层的 motion query 中,在模态维度上做 max-pooling,得到每个 agent 的特征 \(Q_X \in \mathbb{R}^{N_a \times 256}\)。然后与 track query \(Q_A\)、位置编码 \(P_A\) 拼接,经时间特化的 MLP 融合:
\[ G^t = \text{MLP}_t([Q_A, P_A, Q_X]), \quad t = 1, \dots, 5 \]Pixel-Agent 交互
这是 OccFormer 的核心创新。它把密集的 BEV 特征与稀疏的 agent 特征统一起来:
- BEV 特征 B 下采样 4 倍(进入)→ 下采样 8 倍(做 attention)→ 上采样回 4 倍(输出)
- 在 1/8 分辨率下,对密集特征做 self-attention(建模远距离栅格间响应)
- 再以密集特征为 query,agent 特征为 key/value,做 cross-attention(每个栅格从相关 agent 取信息)
- cross-attention 受一个注意力 mask 约束——每个像素只能 attend 到占据该位置的 agent
注意力 mask \(O_m^t\) 通过 mask feature \(M^t = \text{MLP}(G^t)\) 与密集特征 \(F_{\text{ds}}^t\) 的矩阵乘法生成,语义上类似于当前的占用。这个 mask 确保 agent 和像素的空间对应关系是精确的。
输出
生成实例级占用概率图 \(\hat{O}_A^t \in \mathbb{R}^{N_a \times H \times W}\)(每个 agent 一个概率图),然后通过像素级 argmax 合并为整场景占用 \(\hat{O}^t \in \mathbb{R}^{H \times W}\)。这个合并后的占用图既用于占用评估,也传递给 Planner 做碰撞避免。
关键认知:MotionFormer 和 OccFormer 是互补的。Motion 假设世界由少数可跟踪的目标组成,对已知目标做精确预测;Occ 假设世界是稠密的栅格,对"不管是什么先看有没有"做兜底。一个看"已知目标怎么动",一个看"还有什么挡路"。
第五段:Planner(规划模块)
规划模块拿到上述所有信息后,输出自车未来轨迹。
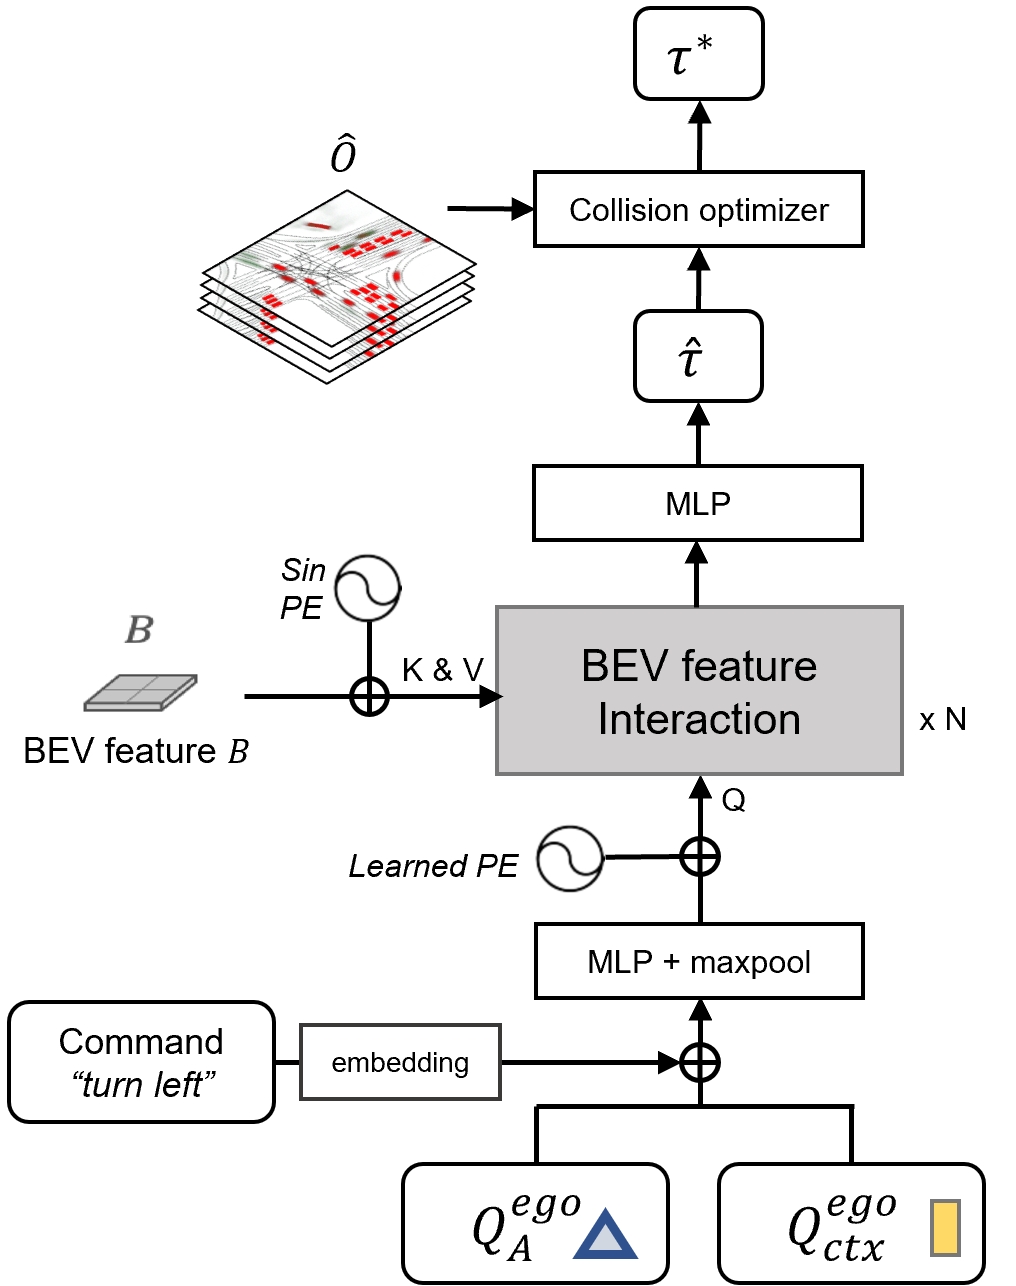
图 5:Planner 架构。 自车 query \(Q_{\text{ego}}\) 在 3 层 Transformer decoder 中依次与 BEV 特征 B 和 motion query 做交叉注意力,融合场景理解后输出规划轨迹。碰撞损失与占用优化在训练/推理时提供安全约束。
输入
- 自车 query(来自 MotionFormer)
- 密集 BEV 特征 B
- 占用预测结果 \(\hat{O}\)
机制
Planner 是一个 3 层 Transformer decoder。自车 query 作为 query,与 BEV 特征和 MotionFormer 的输出做交叉注意力,综合"周围车要怎么动、车道在哪、占用情况"来生成轨迹。
碰撞损失(Collision Loss)
为了把"安全"硬编码进优化目标,Planner 引入了一个碰撞损失——将规划轨迹投影回 BEV 坐标系,与 OccFormer 预测的占用栅格做约束,惩罚可能与障碍物重叠的轨迹:
其中 τ_t 是规划轨迹在时间 t 的位置,O_t 是时间 t 的占用栅格。这实际上去鼓励规划轨迹与所有预测的占用区域保持安全距离。
占用优化(Occupancy Optimization)
在推理时,Planner 还可以使用基于梯度的轨迹优化:将初始轨迹过一遍占用预测,对与占用冲突的 waypoint 做梯度下降微调。这种"learned cost function + gradient-based solver"的组合,兼顾了学习的灵活性和优化的安全性。
Query:端到端梯度贯通的关键
UniAD 最具方法论价值的创新,是用 query 作为贯穿全流程的统一接口。这带来三个本质好处:
- 特征级信息流动:模块之间不再传递"框/轨迹"这种离散有损信息,而是传递连续的特征向量,规划模块能看到感知的全部细节。
- 梯度可回传:因为整条链路都是可微的,规划 loss 可以一路反传到感知,真正实现"为规划而感知"。
- 统一调度:所有模块都遵循 query + 注意力的范式,便于在一个框架里联合训练、联合推理。
这正是它区别于传统 pipeline(不可微)和黑盒端到端(无中间表示)的根本所在——用 query 同时拿到了"端到端的可微性"和"显式表示的可解释性"。
UniAD 中所有重要的张量形状和含义:
| 符号 | 形状 | 含义 |
|---|---|---|
| B | 200×200×256 | BEV 特征 |
| Q_O | 900 | 初始化检测 query 数 |
| Q_A | N_a×256 | TrackFormer 输出的 agent 特征 |
| P_A | N_a×256 | Agent 位置编码 |
| Q_M | 300×256 | MapFormer 输出的地图特征 |
| N_m | 300 | Map query 数量 |
| K | 6 | MotionFormer 预测模态数 |
| T | 12 | 预测时间步长(0.5s×12=6s) |
| N_a | 动态 | 当前帧跟踪的 agent 数 |
| T_o | 5 | OccFormer 预测时间步长 |
| G^t | N_a×256 | 每时间步的 agent 特征 |
| \hat{O}^t | 200×200 | 整场景占用图 |
| τ | T_p×2 | 规划轨迹 |
| D | 256 | 所有 query 的特征维度 |
多任务联合 Loss 设计
UniAD 是典型的多任务学习系统,每个模块有自己的监督信号:
| 任务 | 主要 Loss |
|---|---|
| Track | 分类 Focal Loss + 框 L1 回归 Loss + 关联匹配 Loss |
| Map | Focal 分类 Loss + 点集 L1 回归 Loss(MapTRv2 方式) |
| Motion | 轨迹回归 L1 Loss(minADE/minFDE)+ 多模态分类 Focal Loss + 终点分类 Loss |
| Occ | 二值交叉熵 Loss + Dice Loss |
| Plan | 轨迹 L2 回归 Loss + 碰撞 Loss + 占用优化 Loss |
两阶段训练策略
训练上有一个重要工程经验:直接从头端到端联合训练会崩——各任务梯度尺度不一、相互打架,很难收敛。UniAD 采用两阶段策略:
- 阶段一:分别预训练各感知/预测模块,让每个子任务先到合理初始化。TrackFormer 和 MapFormer 在 nuScenes 上单独训练,MotionFormer 在 Track+Map 固定的情况下训练,OccFormer 再在 Motion 固定的情况下训练。
- 阶段二:端到端联合微调,把所有模块接起来,以规划为主导做联合优化。此时规划 loss 的梯度回传到所有上游模块,微调它们使其更好地服务于规划。
这种"先分后合"的做法,是后来几乎所有端到端工作(VAD、SparseDrive 等)默认采用的训练范式,可谓"立规矩"的贡献。
实验:nuScenes 全面评测
UniAD 在 nuScenes 上做了全面评测。下图展示了环视图像与 BEV 视角下的全任务输出——自车正在礼让前方黑色车辆,运动预测与占用预测保持一致。
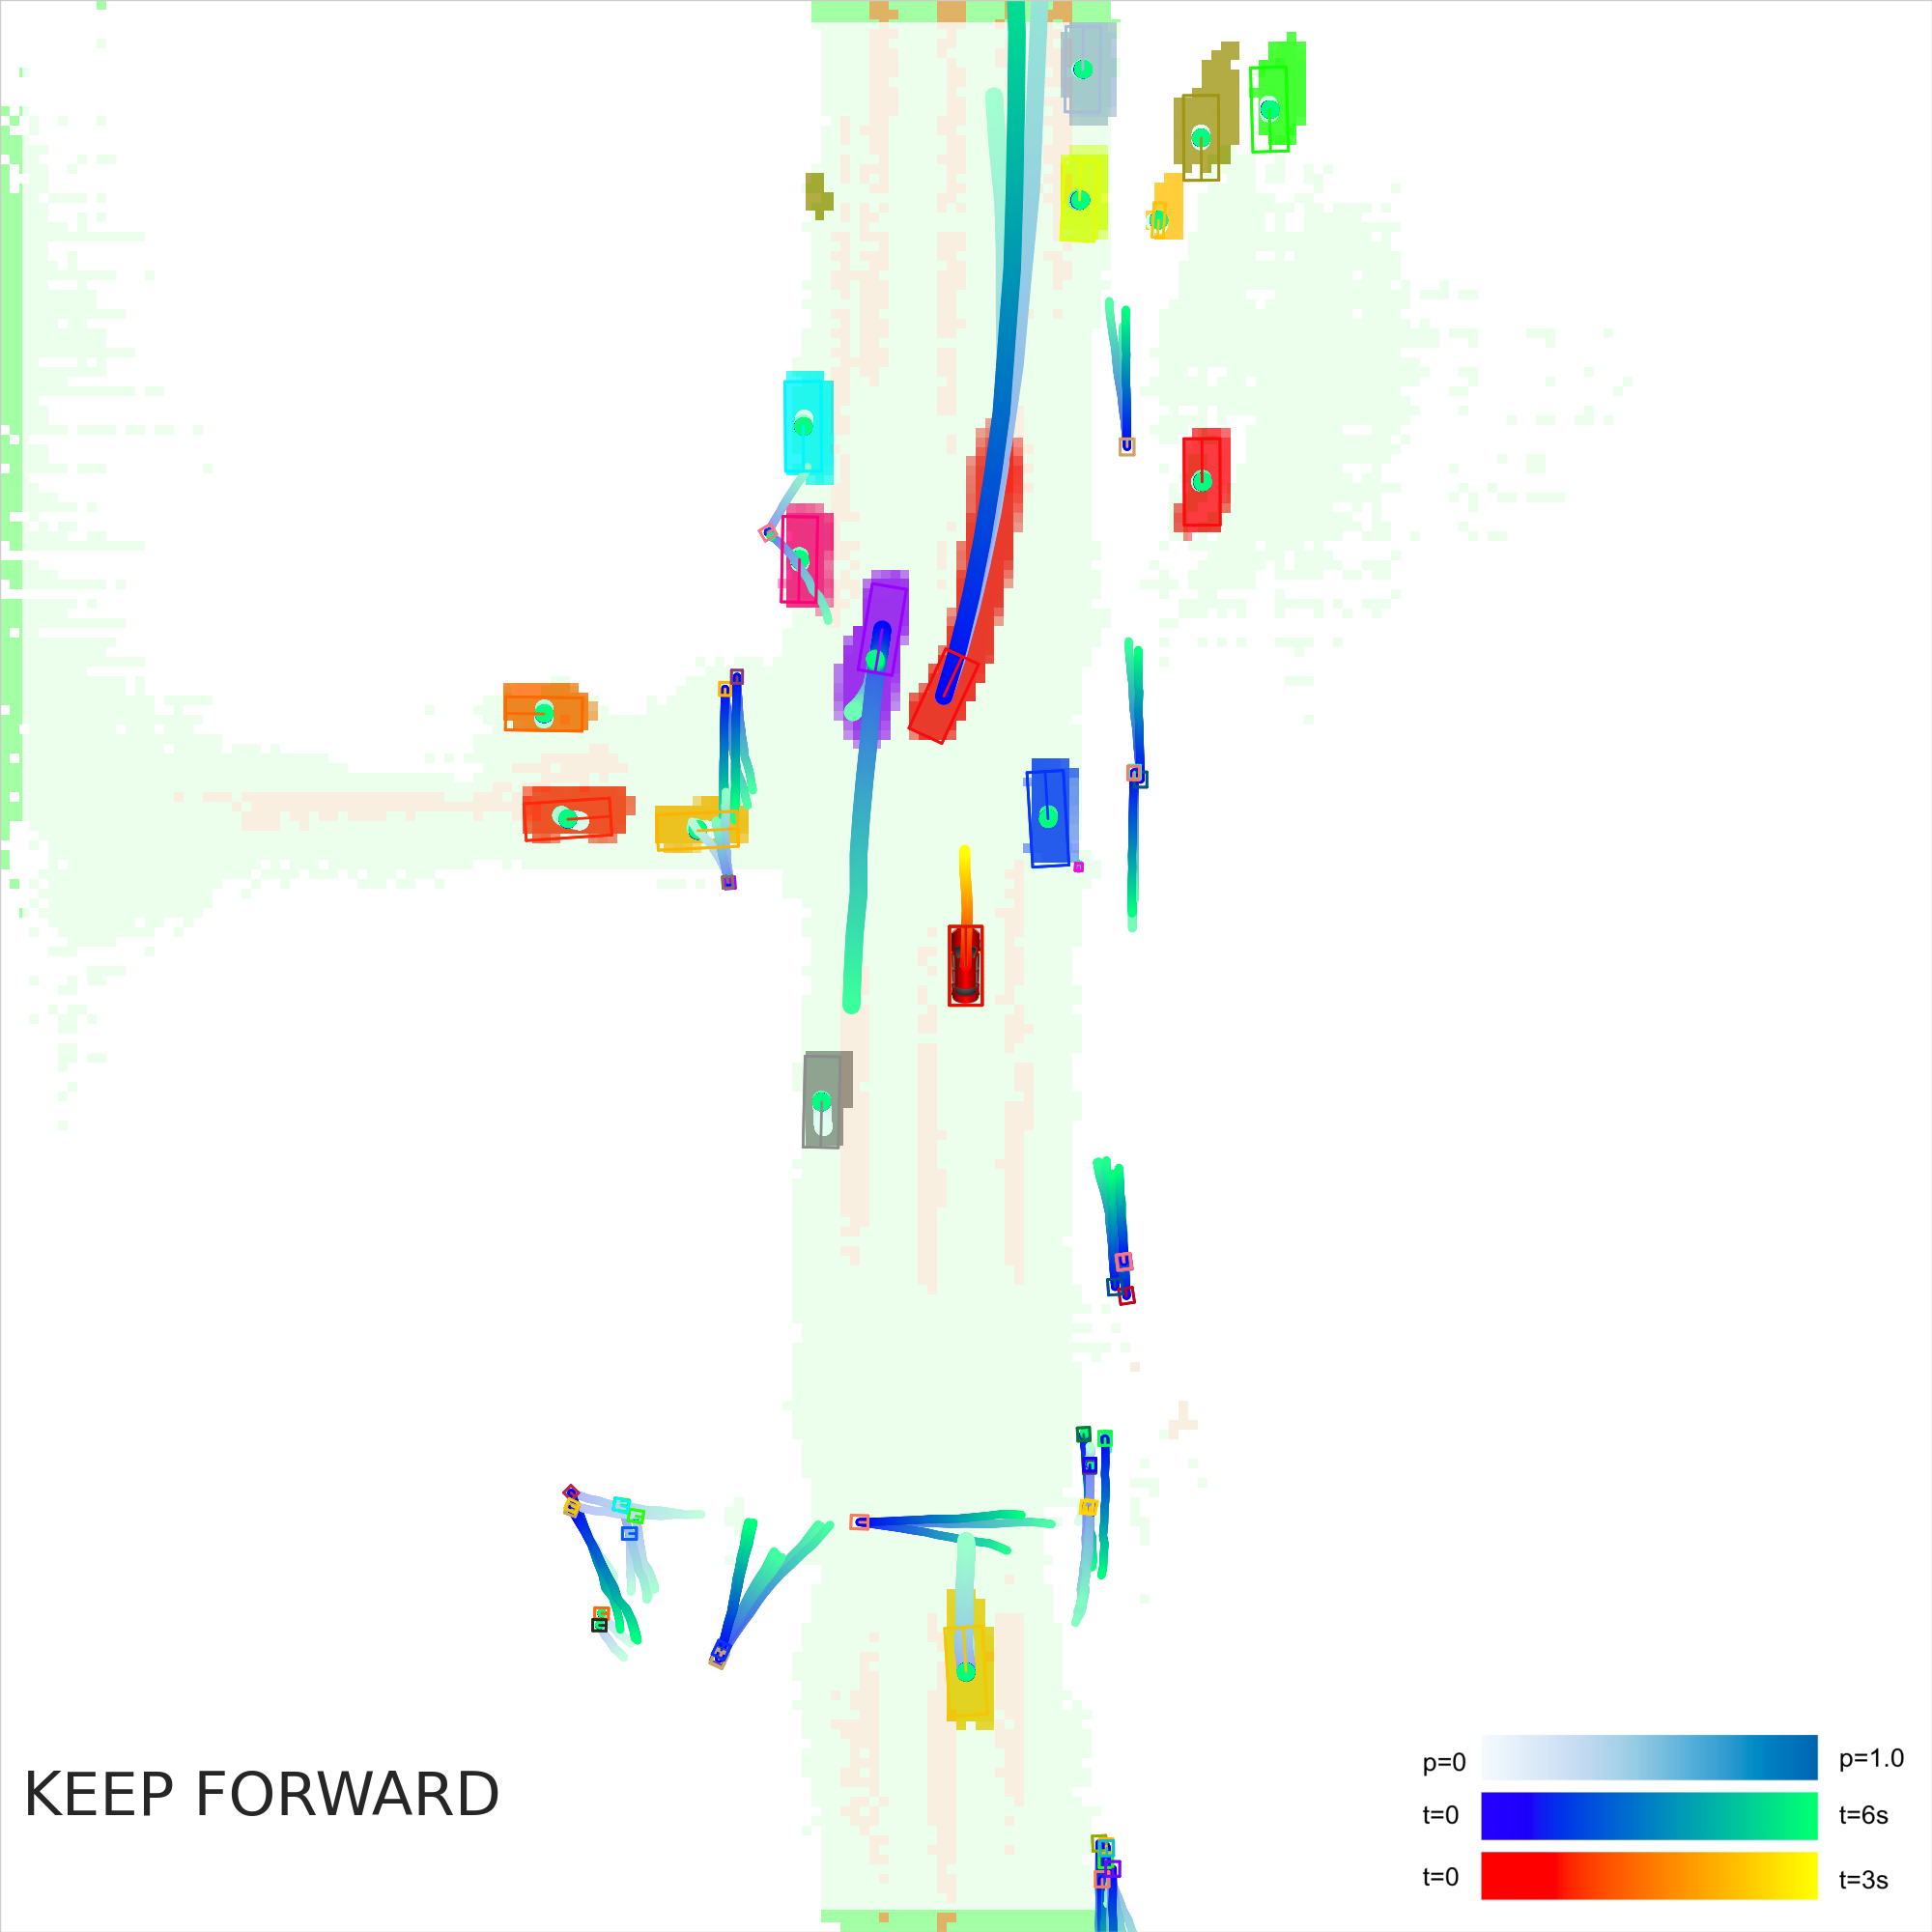
图 6:UniAD nuScenes 可视化结果。 上排:六环视相机图像,每张图上标注了检测框(3D框投影到图像)和轨迹预测;下排:BEV 视角,展示 Track(彩色框 + ID)、Map(蓝色车道线)、Motion(虚线轨迹)、Occ(黄色/绿色占用区域)、Plan(粗绿线为自车规划轨迹)。图中场景为自车在路口礼让对向黑车。
规划结果
Benefiting from rich spatial-temporal information in both the ego-vehicle query and occupancy, UniAD reduces planning L2 error and collision rate by 51.2% and 56.3% compared to ST-P3, in terms of the average value for the planning horizon.
| 方法 | L2 (1s) | L2 (2s) | L2 (3s) | Col (1s) | Col (2s) | Col (3s) |
|---|---|---|---|---|---|---|
| ST-P3 | 0.84 | 1.65 | 2.60 | 1.52 | 2.84 | 6.28 |
| UniAD | 0.44 | 0.99 | 1.71 | 0.56 | 0.88 | 1.64 |
跟踪(MOT)结果
| 方法 | AMOTA↑ | AMOTP↓ | Recall↑ | IDS↓ |
|---|---|---|---|---|
| MUTR3D | 0.294 | 1.498 | 0.427 | 3822 |
| UniAD | 0.359 | 1.320 | 0.467 | 906 |
UniAD 在所有指标上优于之前的端到端 MOT 方法。
运动预测结果
| 方法 | minADE↓ | minFDE↓ | MR↓ | EPA↑ |
|---|---|---|---|---|
| PnPNet-vision | 1.15 | 1.95 | 0.226 | 0.222 |
| ViP3D | 2.05 | 2.84 | 0.246 | 0.226 |
| UniAD | 0.71 | 1.02 | 0.151 | 0.456 |
UniAD 比 PnPNet-vision 降低 38.3% 预测误差,比 ViP3D 降低 65.4%。
占用预测
| 方法 | IoU-near↑ | IoU-future↑ | VPQ-near↑ | VPQ-future↑ |
|---|---|---|---|---|
| FIERY | 56.5 | 31.0 | 45.5 | 26.1 |
| BEVerse | 58.5 | 38.7 | 49.8 | 28.5 |
| UniAD | 62.5 | 39.8 | 53.2 | 32.6 |
在近处区域取得显著领先。
消融实验:每个模块为什么不可或缺
UniAD 的消融实验非常充分,有力证明了每个模块的价值。
主消融:逐步添加任务的影响
下图为消融实验的核心结果,展示从纯多任务学习(MTL)基线逐步添加各模块后各指标的变化:
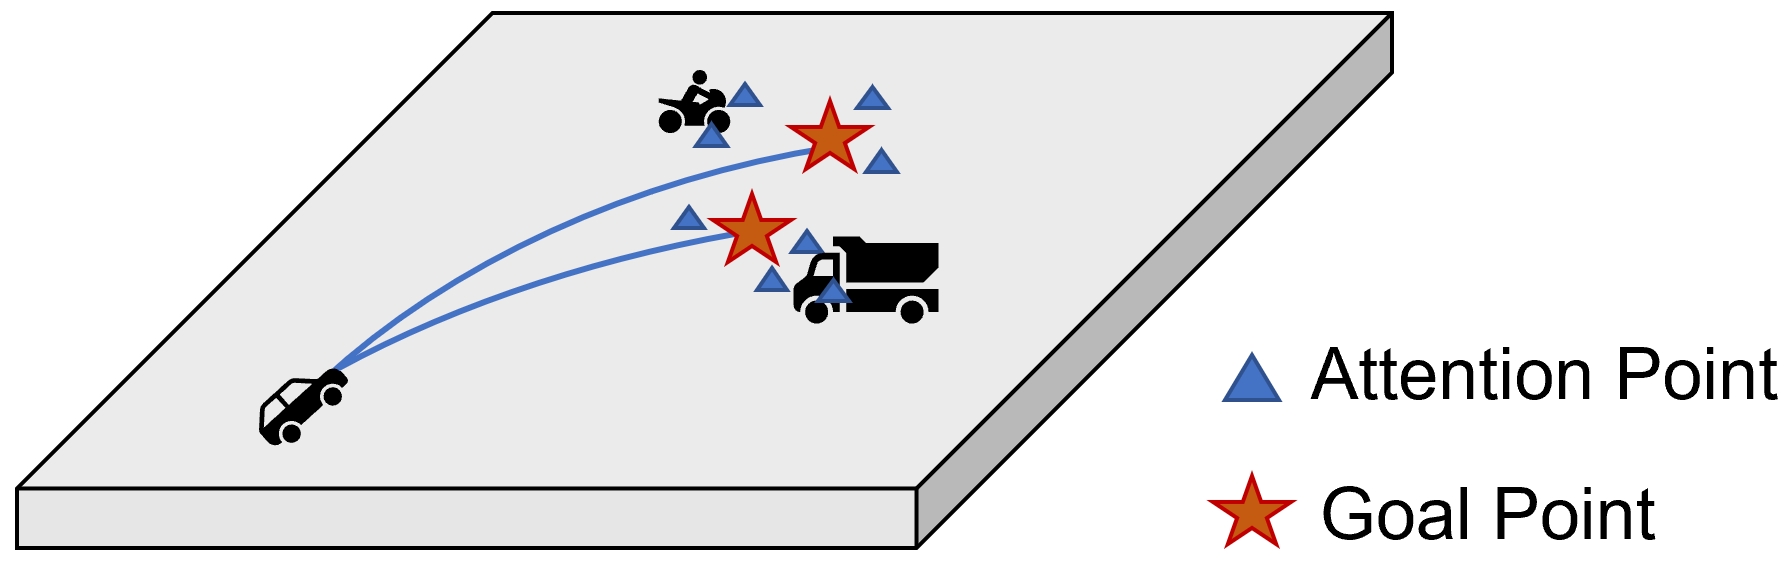
表 2 关键行分析:
| ID | 配置 | 规划 L2↓ | 碰撞率↓ | 关键结论 |
|---|---|---|---|---|
| 0* | MTL baseline | 1.154 | 0.941 | 各任务独立训练,无交互,规划最差 |
| 7 | +Motion | - | - | 加入运动预测后各项开始提升 |
| 9 | +Motion+Occ | - | - | 两预测模块协同效果更好 |
| 10 | Planner only | 1.131 | 0.773 | 纯规划(无感知融合)结果 |
| 11 | +Track+Map+Motion | 1.014 | 0.717 | 加入感知后提升明显 |
| 12 | 全量 | 1.004 | 0.430 | 完整 UniAD,碰撞率降幅最大 |
关键发现:
- Occupancy 对安全最关键:ID 11 → 12,加入 Occupancy 后碰撞率从 0.717 降到 0.430,降低 40%
- Motion + Occupancy 协同:单独 Motion(ID 7)或单独 Occ(ID 8)的占用预测都比两者都有的(ID 9)差——说明预测任务间有正向协同
- 感知提升预测:加入 Track 和 Map(ID 5 → ID 6)后,Motion 的 minADE 降低 9.7%、minFDE 降低 12.9%
占用预测模块消融
| ID | Cross Attn | Attn Mask | Mask Feat | IoU-near↑ |
|---|---|---|---|---|
| 1 | 61.2 | |||
| 2 | ✓ | 61.3 | ||
| 3 | ✓ | ✓ | 62.3 | |
| 4 | ✓ | ✓ | ✓ | 62.6 |
注意力 mask 和 mask feature 重用都贡献了可观的提升。
规划模块消融
| ID | BEV Att | Col Loss | Occ Optim | L2 (3s)↓ | Col (3s)↓ |
|---|---|---|---|---|---|
| 1 | 1.71 | 1.64 | |||
| 2 | ✓ | 1.81 | 1.58 | ||
| 3 | ✓ | ✓ | 1.76 | 1.39 | |
| 4 | ✓ | ✓ | ✓ | 1.81 | 1.05 |
碰撞损失(Col Loss)将 3 秒碰撞率从 1.58 降至 1.39,占用优化(Occ Optim)进一步降至 1.05——降幅达 36%。
可视化结果
UniAD 在多种城市驾驶场景中都能生成高质量的中间表示与规划轨迹:
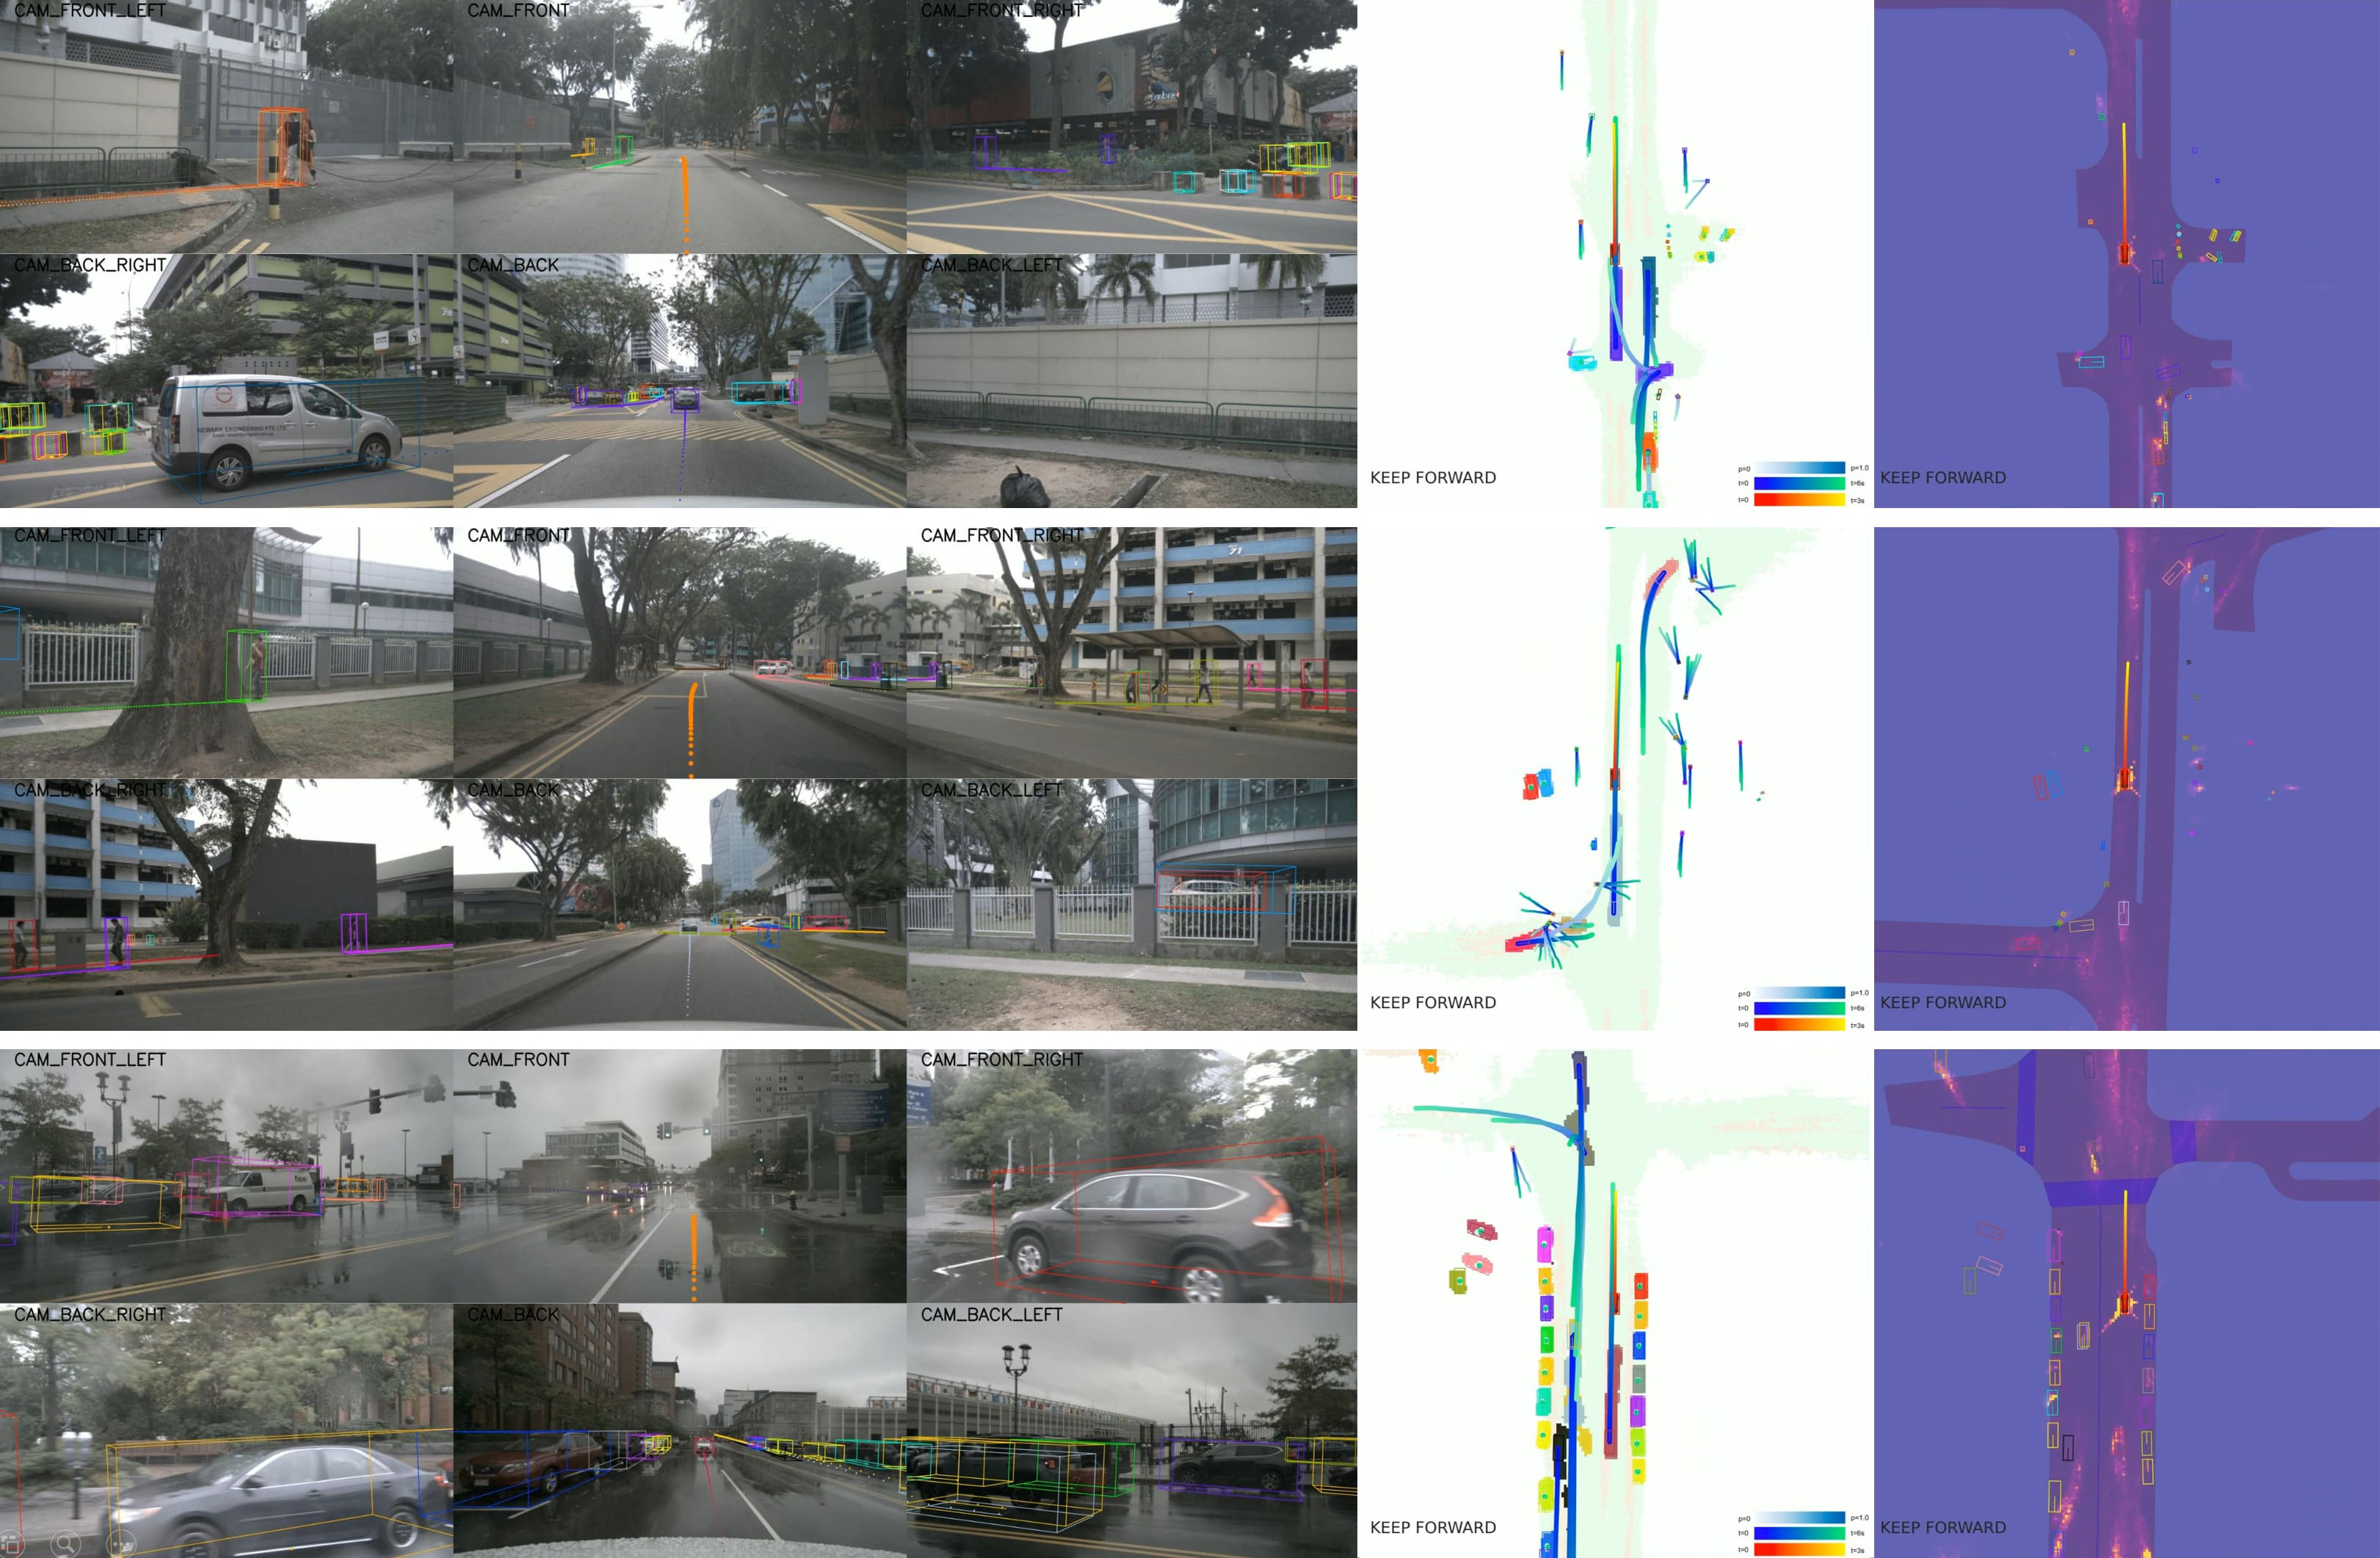
图 7:UniAD 城市巡航可视化。 图中展示了多个城市驾驶场景下的全任务输出。每个场景中,BEV 视角统一展示了检测跟踪框、矢量化地图元素、多模态运动预测轨迹与自车规划轨迹(粗绿线)。UniAD 在不同道路拓扑与交通环境下均能保持各模块输出的一致性——跟踪框准确、地图元素完整、运动预测合理、规划轨迹平滑安全。
历史地位:开创"显式端到端"范式
UniAD 的历史地位,远不止于"一个跑得好的系统",而在于它确立了一条新路线:
| 路线 | 代表 | 特点 | 局限 |
|---|---|---|---|
| 分模块拼接 | 工业界传统 | 成熟、可解释 | 误差累积、不可微 |
| 隐式端到端 | 行为克隆类 | 联合优化 | 黑盒、不可调试 |
| 显式端到端 | UniAD ⭐ | 可微 + 显式表示 | 训练复杂、算力高 |
显式端到端这个范式几乎成了 2023 年之后学术界的"默认选项",后续一大批工作都沿着 UniAD 铺好的路往前走。
与后续工作的关系
UniAD → VAD
VAD 直接继承了 UniAD 的"显式端到端 + 向量化表示"思想,但做了两件关键瘦身:
- 用矢量化场景表示替代 UniAD 中较重的密集 BEV 栅格,大幅降低算力、提升推理速度
- 进一步精简模块,强调效率与泛化,推理速度从 UniAD 的 ~10FPS 提升到 VAD 的 ~40FPS
UniAD → SparseDrive
SparseDrive 把"稀疏"做到极致——用稀疏 query 表示目标和地图,避免密集 BEV 计算,在保持甚至提升精度的同时把推理开销进一步压低。它延续了 UniAD “query 贯通 + 显式表示” 的内核,只是把表示做得更稀疏、更高效。
三者一脉相承
| 工作 | 核心传承 | 主要进化 |
|---|---|---|
| UniAD | 范式奠基者 | 首次显式端到端,规划导向 |
| VAD | 向量化 + 显式端到端 | 轻量化、提速 4 倍 |
| SparseDrive | query 通路 + 显式表示 | 全稀疏,进一步提效 |
个人思考
读 UniAD 最打动我的,是它对"目标"的清醒定位。在它之前,自动驾驶学术界和工业界都容易陷入一种"局部最优陷阱"——每个团队埋头把自己的模块(检测、预测、规划)刷到 SOTA,却很少反思这些模块拼起来是否真的让车开得更好。UniAD 用一句话点醒了这个迷思:所有任务的终极目标只有一个,就是规划。这种"以终为始"的系统观,比任何具体的网络结构都更值得铭记。
从架构看 UniAD 的三个关键设计选择
1. 为什么用 query 做统一接口?
因为 query 比任何结构化表示都更适合做梯度传导。一个检测框是离散的(位置 + 类别 + 置信度),而 query 是连续的 (256-dim 向量),可以携带丰富的上下文信息。MotionFormer 之所以能联合预测所有 agent,就是因为它直接以 agent query 作为输入,而不是框坐标。这是"表示连续化"的胜利。
2. 为什么需要 Motion + Occupancy 双预测?
这本质上是稀疏表示 + 稠密表示的互补。Motion 假设世界由有限的可跟踪目标构成,对已知目标做高精度预测。但真实世界总有未检测到的物体(异常障碍物、施工区域)。Occupancy 是对 Motion 的安全兜底——即使 Motion 漏了,Occupancy 也能知道"前方有东西"。这种"稀疏目标 + 稠密占用"的双重预测,在后来的世界模型和端到端工作中被广泛采纳。
3. 为什么两阶段训练是必须的?
端到端联合训练在理论上是美好的,但实践中各任务的梯度尺度差异巨大——规划的 L2 loss 在 1 量级,跟踪的分类 loss 在 0.01 量级。如果从头联合训练,感知模块的梯度会被规划的梯度淹没。UniAD 的"先分后合"策略是实用的折中:先用强监督让各模块到合理位置,再用规划梯度做精调。
三点启示
第一,占用预测是工程价值最高的创新之一。真实世界充满"不规则、未归类、未观测"的障碍物,传统的检测/预测范式天然漏掉它们。占用栅格是一种"不管是什么,先告诉我有没有"的兜底表示。这种"从语义回到几何"的设计思路,对今天的研究仍然有启示——越是高层语义容易出错的地方,越需要底层几何的安全网兜着。
第二,UniAD 的架构复杂度在实用中是一个问题。五个级联的 Transformer decoder + 密集 BEV 特征,推理速度约 7-10FPS,远不及实时要求。这直接催生了 VAD 和 SparseDrive 的轻量化改进。但这并不减损 UniAD 的学术价值——它先证明了"方向对了",后继工作再优化效率。
第三,“折中"的智慧。UniAD 没有走极端:既不全盘黑盒(保留了显式的轨迹/地图/占用表示),也不固守分模块(让梯度贯通到感知)。这种"鱼与熊掌兼得"的设计哲学,在工程实践中往往比纯学术的激进更值钱。真正能大规模落地的自动驾驶系统,一定是某种形式的"显式端到端”——因为它同时满足了"可优化"和"可解释、可兜底"这两个落地刚需。
UniAD 的价值,在于它不只是"一个跑得好的模型",而是给整个领域立了一根旗杆:从此大家讨论端到端自动驾驶,都会以它为坐标系的原点。