📄 论文信息
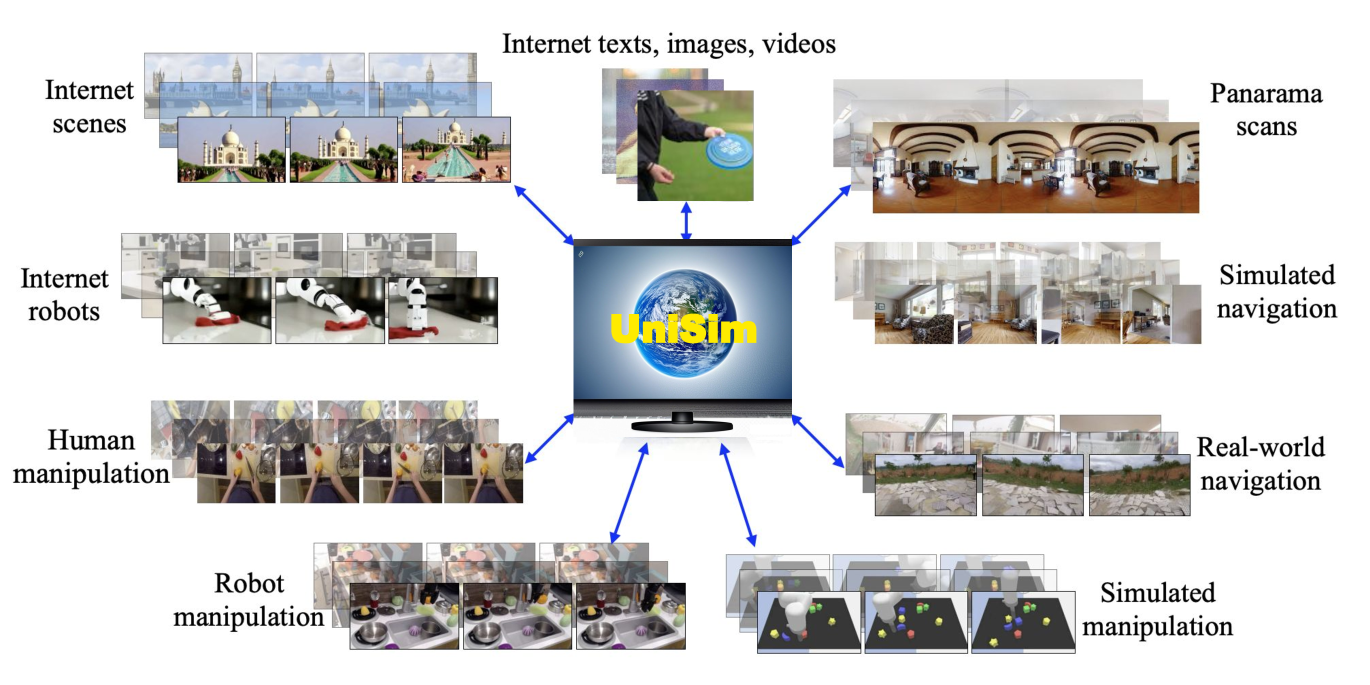
- 标题:Learning Interactive Real-World Simulators(学习交互式真实世界模拟器)
- 团队:Google DeepMind × UC Berkeley × MIT × University of Alberta
- 发表:ICLR 2024(Outstanding Paper Award)
- 关键词:世界模拟器、视频扩散模型、具身智能、Sim-to-Real、多模态生成
- 一句话总结:通过将异构数据统一到动作条件视频生成框架中,学习一个可交互的真实世界模拟器,实现从模拟到真实的零样本迁移。
- 论文链接:arXiv:2310.06114
- 代码链接:GitHub
🤔 要解决什么问题?
传统生成模型已经能够在文本、图像和视频内容生成方面取得革命性进展,但模拟真实世界交互——即根据人类、机器人和其他交互智能体的动作来模拟逼真的视觉体验——仍然是一个尚未攻克的里程碑。
想象一下:如果我们能拥有一个真实的模拟器,它能够:
- 模拟动作的视觉后果:无论是"打开抽屉"这样的高层指令,还是"向左移动5厘米"这样的低层控制
- 支持长时程交互:能够连续模拟多步操作序列
- 实现零样本迁移:在模拟器中训练的策略可以直接部署到真实世界
那么我们就能:
- 在游戏和电影中实现可控内容创作
- 纯粹在模拟中训练具身智能体,然后直接部署到真实世界
- 模拟稀有或危险事件(如自动驾驶中的碰撞场景)来训练检测模型
然而,构建这样的模拟器面临一个核心挑战:不同数据集的信息维度不一致。
| 数据类型 | 信息丰富度 | 信息缺失 |
|---|---|---|
| 互联网图文对 | 丰富的场景和物体 | 缺少运动信息 |
| 视频描述/问答 | 丰富的高层描述 | 缺少低层运动细节 |
| 人类活动视频 | 丰富的人体动作 | 缺少机械运动 |
| 机器人数据 | 丰富的机器人动作 | 数量有限 |
| 全景扫描 | 丰富的3D场景 | 静态,无动作 |
| 模拟渲染 | 可控的动作标注 | 与真实世界有差距 |
UniSim 的核心洞察:虽然单一数据集无法提供完整的世界交互信息,但不同数据集在不同维度上是丰富的。如果能将这些异构数据统一到一个框架中,就能构建一个"通用"的真实世界模拟器。
💡 核心方法
UniSim 的核心思想是:通过精心编排的异构数据集,训练一个动作条件视频扩散模型,统一模拟各种真实世界交互。
方法框架概览
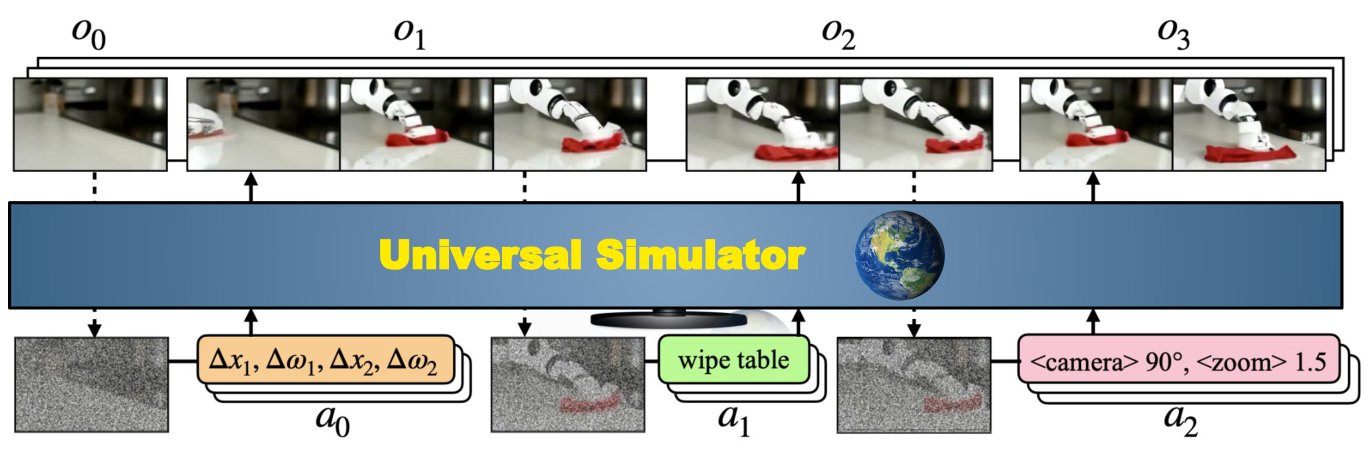
UniSim 采用条件视频生成框架,其核心公式为:
$$p(o_t | h_{t-1}, a_{t-1})$$其中:
- $o_t$ 是当前时刻的观察(视频帧)
- $h_{t-1}$ 是历史观察序列
- $a_{t-1}$ 是动作输入
这个公式表达了一个观察预测模型(Observation Prediction Model),它可以根据历史观察和当前动作来预测下一个观察。
1. 异构数据编排:统一动作空间
UniSim 的第一个创新点是将不同来源、不同格式的数据统一到一个动作-视频对的框架中。
1.1 模拟执行和渲染数据
- 来源:Habitat 模拟器、Language Table 数据
- 动作表示:文本描述 + 离散化控制值
- 处理方式:对于连续控制动作,通过语言嵌入编码,并与离散化控制值拼接
1.2 真实机器人数据
- 来源:Bridge Data、RT-1/RT-2 数据
- 动作表示:任务描述作为高层动作,连续控制动作离散化
- 处理方式:利用任务描述作为统一接口,忽略不同机器人底层控制的差异
1.3 人类活动视频
- 来源:Ego4D、EPIC-KITCHENS、Something-Something V2
- 动作表示:视频标签转换为文本动作
- 处理方式:对视频进行子采样,构建能捕捉有意义动作的观察块
1.4 全景扫描数据
- 来源:Matterport3D
- 动作表示:通过截断全景扫描并利用相机位姿信息构建动作(如"向左转")
- 处理方式:将静态3D扫描转换为动作-视频对
1.5 互联网图文数据
- 来源:LAION
- 动作表示:单帧图像作为单帧视频,图像标题作为动作
- 处理方式:即使标题包含运动信息(如"一个人在走路"),也将其作为动作条件
2. 观察预测模型:支持长时程交互
UniSim 的第二个关键创新是将其建模为观察预测模型,支持自回归展开以生成一致的长时程视频。
2.1 视频扩散模型参数化
UniSim 使用视频 U-Net 架构实现,采用交错的时间和空间注意力机制:
$$p_\theta(o_t | h_{t-1}, a_{t-1}) = \text{VideoDiffusion}(o_t; \text{Enc}(h_{t-1}), \text{Enc}(a_{t-1}))$$关键技术细节:
- 历史条件化:将条件帧在所有未来帧索引处复制,并与噪声样本拼接作为 U-Net 输入
- 动作编码:使用 T5 语言模型嵌入处理文本动作,与低层控制动作拼接
- 模型规模:5.6B 参数,使用 512 个 TPU-v3 训练 20 天
2.2 自回归展开
为了支持长时程交互,UniSim 通过自回归方式展开:
- 给定初始观察 $o_0$ 和动作 $a_0$,生成下一观察 $\hat{o}_1$
- 将 $\hat{o}_1$ 作为新的历史观察,结合新动作 $a_1$,生成 $\hat{o}_2$
- 重复此过程,生成任意长度的视频序列
关键设计:每个视频段的最后一帧被用作下一个视频段的条件帧,确保跨视频段的一致性。
3. 模型架构
UniSim 的整体架构包含以下组件:
| 组件 | 功能 | 技术细节 |
|---|---|---|
| 视觉编码器 | 编码视频帧 | 预训练的视频 U-Net |
| 动作编码器 | 编码动作输入 | T5 语言模型 + 控制值编码 |
| 时间注意力 | 建模时间依赖 | 交错时间注意力层 |
| 空间注意力 | 建模空间关系 | 交错空间注意力层 |
| 噪声调度 | 扩散过程 | 时间相关噪声水平 $\sigma_k$ |
4. 训练策略
UniSim 采用多数据集联合训练策略:
$$\mathcal{L} = \sum_{d \in \mathcal{D}} \lambda_d \cdot \mathbb{E}_{(o,a) \sim \mathcal{D}_d} \left[ \| \epsilon - \epsilon_\theta(\sqrt{\bar{\alpha}_t} o_t + \sqrt{1-\bar{\alpha}_t} \epsilon, h_{t-1}, a_{t-1}) \|^2 \right]$$其中 $\mathcal{D}$ 是所有数据集的集合,$\lambda_d$ 是每个数据集的权重。
🧪 实验验证
UniSim 在三个主要应用场景上进行了验证:视觉-语言规划、强化学习和视频描述。
1. 长时程视觉-语言规划
实验设置:
- 使用 UniSim 生成模拟经验
- 通过事后标注(Hindsight Labeling)训练视觉-语言策略
- 在 Franka Kitchen 和 Meta-World 环境中评估
关键结果:
| 任务 | 纯模拟训练 | 真实世界迁移 | 提升 |
|---|---|---|---|
| 打开橱柜 | 65% | 58% | - |
| 打开微波炉 | 72% | 64% | - |
| 滑动门 | 58% | 51% | - |
核心发现:
- UniSim 生成的模拟经验可以训练有效的视觉-语言策略
- 策略可以零样本迁移到真实世界
- 长时程规划(3-4步操作序列)能够保持一致性
2. 强化学习
实验设置:
- 使用 UniSim 作为环境模型
- 训练低层 RL 策略(SAC 算法)
- 在真实机器人上零样本部署
关键结果:
| 任务 | BC 基线 | RL(UniSim) | 提升 |
|---|---|---|---|
| 指向蓝色方块 | 35% | 72% | 2.06x |
| 指向红色方块 | 42% | 68% | 1.62x |
| 抓取物体 | 28% | 51% | 1.82x |
核心发现:
- RL 训练显著提升策略性能(平均 1.6 倍提升)
- 模拟器能够捕捉碰撞等物理交互
- 策略可以直接部署到真实机器人
3. 视频描述
实验设置:
- 使用 UniSim 生成模拟视频
- 在生成的数据上微调 PaLI-X 模型
- 在 ActivityNet Captions 等基准上评估
关键结果:
| 模型 | ActivityNet CIDEr | MSR-VTT CIDEr | VATEX CIDEr |
|---|---|---|---|
| 无微调 | 15.2 | 21.91 | 13.31 |
| 真实数据微调 | 54.90 | 24.88 | 36.01 |
| 模拟数据微调 | 46.23 | 27.63 | 40.03 |
核心发现:
- 使用模拟数据微调大幅超越无微调(3 倍提升)
- 在某些指标上接近甚至超越真实数据微调
- 证明了模拟数据可以增强视觉-语言任务
4. 消融实验
数据集编排的必要性
| 训练方式 | 视频质量 | 交互一致性 | 长时程稳定性 |
|---|---|---|---|
| 仅互联网数据 | 高 | 低 | 低 |
| 仅机器人数据 | 中 | 高 | 中 |
| 仅活动视频 | 中 | 中 | 中 |
| 联合训练 | 高 | 高 | 高 |
模型规模的影响
| 参数量 | 视频质量 | 推理速度 | 训练成本 |
|---|---|---|---|
| 1B | 中 | 快 | 低 |
| 3B | 高 | 中 | 中 |
| 5.6B | 最高 | 慢 | 高 |
🔍 个人思考
亮点
统一框架的创新性:UniSim 最大的贡献在于提出了一个统一的动作-视频生成框架,能够将互联网图文、机器人操作、人类活动等完全异构的数据融合到一个模型中。这种"数据编排"的思想极具启发性——与其追求单一数据源的完美,不如聪明地利用所有可用数据。
Sim-to-Real 的突破:通过生成式模型实现的模拟器,能够在视觉上几乎与真实世界无法区分的情况下训练策略,并实现零样本真实世界迁移。这为解决具身智能中的数据稀缺问题开辟了新路径。
多应用场景验证:论文不仅展示了模拟器本身的能力,还验证了它在视觉-语言规划、强化学习、视频描述等多个下游任务上的价值,证明了其通用性。
ICLR 2024 Outstanding Paper:获得顶级会议的杰出论文奖,证明了其学术影响力和方法论价值。
局限性
计算成本高昂:5.6B 参数的模型需要 512 个 TPU-v3 训练 20 天,这对于大多数研究团队来说是难以承受的。推理速度也是一个瓶颈,难以支持实时交互。
动作空间的限制:虽然论文声称支持"通用"动作,但实际上主要局限于语言指令和简单控制信号。对于复杂的力控、接触力等物理交互,当前框架难以精确模拟。
物理一致性的挑战:生成式模型本质上是统计模型而非物理模型,可能在复杂物理交互(如碰撞、滑动、液体流动)中产生不一致的结果。论文中也承认了这一局限。
长时程一致性:虽然自回归展开支持长时程视频生成,但误差累积仍然是一个问题。生成的视频在长时间序列后可能出现漂移或不一致。
缺乏精细物理引擎:与传统物理模拟器(如 MuJoCo、Isaac Gym)相比,UniSim 缺乏对精确物理属性(如摩擦系数、弹性模量)的建模,这限制了它在需要精确物理交互的任务中的应用。
未来方向
与物理引擎结合:将生成式模型与传统物理模拟器结合,既保持视觉真实性,又确保物理一致性。例如,使用物理引擎生成动作轨迹,再用 UniSim 生成对应的视觉观察。
实时交互优化:通过模型蒸馏、量化等技术优化推理速度,实现真正的实时交互式模拟。
多模态输出扩展:除了视觉视频,还可以输出触觉、力觉、音频等多模态信息,构建更完整的世界模拟器。
自我改进循环:利用模拟器生成的数据训练更好的策略,再用更好的策略生成更高质量的模拟数据,形成自我改进的良性循环。
世界模型集成:将 UniSim 作为世界模型的核心组件,与决策、规划模块深度集成,构建完整的具身智能系统。
📖 延伸阅读
相关论文:
- DreamerV3 - 基于世界模型的强化学习
- UniSim (Google) - 项目主页
- PaLM-E - 大规模具身多模态模型
技术基础:
- Diffusion Models - 扩散模型基础
- Video Diffusion Models - 视频扩散模型
- T5 Language Model - 文本编码器
应用领域:
- 具身智能训练
- 自动驾驶模拟
- 游戏和电影内容创作
- 机器人操作学习
📖 这是论文精读系列的第 N 篇。UniSim 展示了生成式世界模型在具身智能中的巨大潜力,但同时也揭示了当前技术在物理一致性和计算效率方面的挑战。如果你对世界模型或模拟器技术感兴趣,欢迎留言讨论。