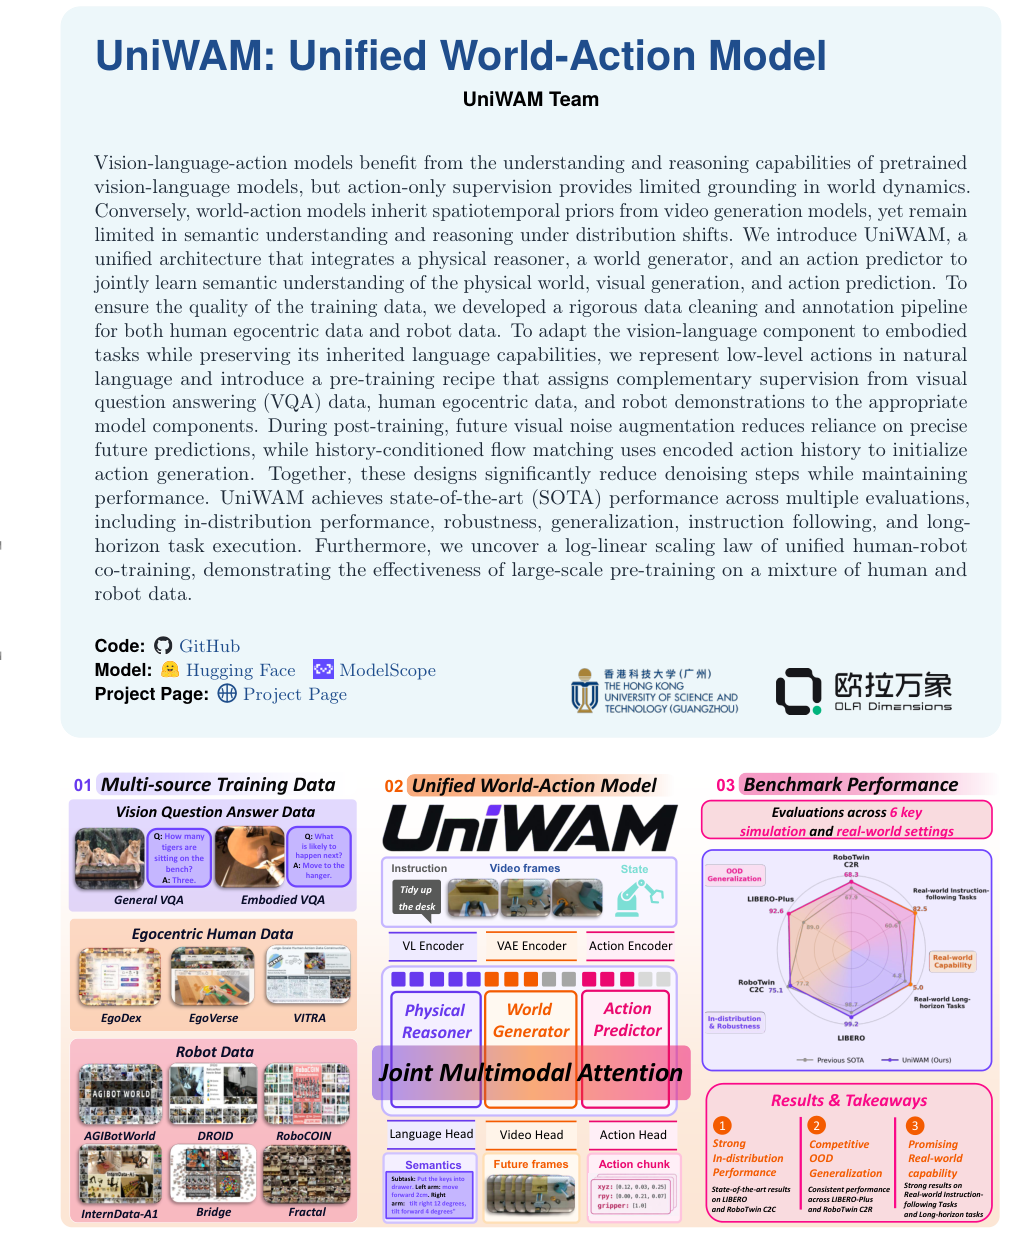
配图说明:本文收录论文全部 11 张插图(Figure 1 ~ Figure 11),放在站内 /images/uniwam/,逐张讲解,文末附图表总索引表。论文来自 HKUST(GZ)、OLA Dimensions、CMU、北大、上交、BAAI,arXiv 2610.02054(v4 2026-10-14),代码/模型/项目页全公开。这是一篇「把两条已有路线焊接」的论文:VLA 路线(π0.5、OpenVLA)赢在语义与推理,WAM 路线(DreamZero、Motus、OpenWAM)赢在物理先验,UniWAM 的主张是一个架构、三个专家、一份互补监督全都要。
📄 论文信息
- 标题:UniWAM: Unified World-Action Model
- 机构:HKUST-GZ、OLA Dimensions、CMU、北京大学、上海交大、BAAI
- 时间:2026-10(arXiv 2610.02054,v4 2026-10-14)— 内容上属于把 2026 上半年 WAM 技术栈(MoT 架构、物理语言、flow matching)整合成开源统一模型的收官式论文
- 关键词:世界行动模型(WAM)、Mixture-of-Transformers(MoT)、物理语言(physical language)、人机共训(human-robot co-training)、history-conditioned flow matching、EgoANT 人履数据标注
- 一句话总结:VLA 和 WAM 的能力是互补的,那就都别扔。三个专家通过联合注意力互读:动作 token 既能看到语义上下文、又能看到逐步演化的视觉预测。监督各配各的:VQA 给推理器保语言、人履数据同时喂推理器和生成器(但不喂低精度动作)、机器人数据三者全喂。结果是一台「会看图、会说话、会动」的统一体。
🎯 一句话版本:核心数字
| 基准 | UniWAM | 最强对手 | 备注 |
|---|---|---|---|
| LIBERO 四套件 | 99.2% | Xiaomi-Robotics-0 98.7% | +0.5,四套件几乎拉满 |
| RoboTwin C2C | 75.14% | OpenWAM-α 89.4% / 4D-WAM 81.5% | C2C 不是冠军(见下) |
| RoboTwin C2R | 68.32% | GigaBrain-0.7 67.90% | 最高 C2R;C2C→C2R 只掉 6.8 pp |
| RoboTwin 平均 | 71.73% | OpenWAM-α 69.0% | 平均第一 |
| LIBERO-Plus | 92.6% | Kairos 89.0% | 七维里 Robot 扰动 89.5% 最显眼 |
| 真机指令跟随 IFR | 82.5% | π0.5 60.6% | +21.9 pp |
| 真机长程任务进度 | 5.0 / 6 | π0.5 4.8 | Motus 3.2 |
| Scaling law | L≈0.03205−0.00302·ln(D) | R²≈0.983 | 人+机混合语料 |
值得注意的不对称:RoboTwin C2C 上 UniWAM(75.14%)低于 OpenWAM-α(89.4)与 4D-WAM(81.5)——它是换空间的「随机化数字冠军」而不是「clean 数字冠军」;真正的卖点是 C2C→C2R 只掉 6.82 pp(π0.5 掉 24.7、Spatial Forcing 掉 50.46)以及四舍五入后 71.73% 的平均分。
🧭 读前 5 分钟:六个概念
- VLA vs WAM 的各自短板:VLA(π0、OpenVLA、π0.5)靠预训练 VLM 获得语义/推理,但只拿动作监督,不理解「世界会怎么变」;WAM(DreamZero、Motus、Cosmos-Policy)继承视频生成模型的时空先验,但 OOD 时的语义理解和推理「不太行」。
- MoT(Mixture-of-Transformers):三种模态在一个 Transformer 里有各自独立的 QKV/投影/FFN 参数(不共享主参数),但每层做联合多模态注意力——所有模态的 token 拼在一起联合求解,输出解开后回到各专家的路线。本文的落点:动作 token 能同时「看」语义和「正在被生成的视觉预测」。
- 物理语言(physical language):把连续动作翻译成自然语言——「move forward 3 cm, move left 2 cm, tilt left 10 degrees, close gripper」(厘米/10度精度、模板确定式生成)。这让 VLM 的动作监督落在它预训练的输入-输出分布里,不破坏语言能力。这就是让 VLM 学具身知识而不忘掉语言的手段。
- 互补监督分配——数据三源,各管各的:VQA(8.29M 对)只喂推理器(保语言);人履数据喂推理器 + 生成器(不喂动作预测器——人手轨迹 Action tags 精度低);机器人数据三者全喂(它有最准的动作标注 + 最现场一致性)。
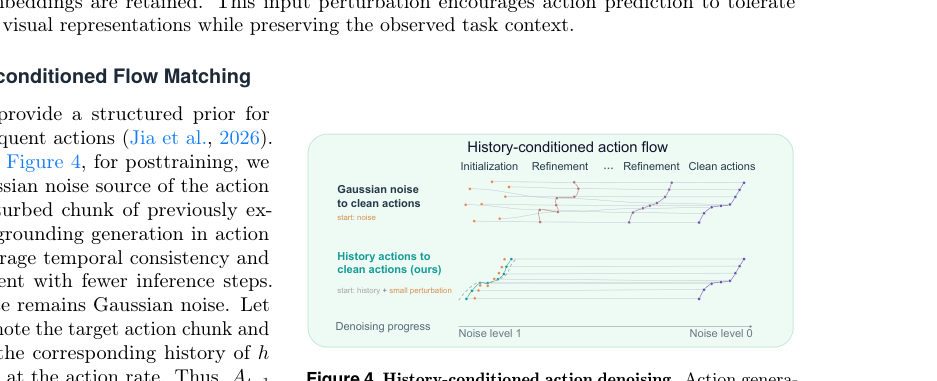
- A2A(action-to-action):flow matching 的起点不再是纯高斯噪声,而是「上一段历史动作 + 0.02 噪声」——时序连续性免费给了降低去噪步数的重要起点。
- EgoANT:把长人履视频切成原子操作段的 VLM 流水线(0.5s 采样时间表 → 全局粗分段 → 局部修正(no pad)→ 多路候选描述 → 纯文本选择器拍板)。
📦 数据:10,013 小时 + 8.3M VQA 对
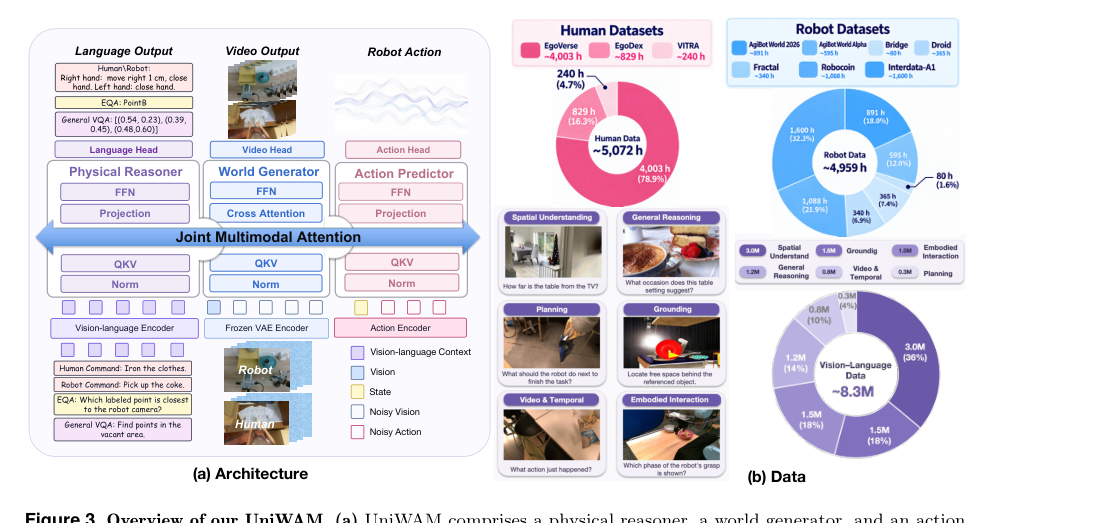
Figure 3 的右半横轴标出了数据配比:机器人 ≈4,958 h(AgiBot World 2026 ~891 h、AgiBot Alpha ~595 h、Bridge ~80 h、Droid ~365 h、Fractal ~340 h、RoboCOIN ~1,088 h、Interdata-A1 ~1,600 h);人履 ≈5,072 h(EgoVerse ~4,003 h、EgoDex ~829 h、VITRA ~240 h)。合计 ~10,013 h,另配 8.29M 对 VQA(SAT/RefSpatial/VST-P/SenseNova-SI/GRiD-3D/RoboPoint/CLEVR/VSI/SIMS-VSI/RoboVQA/Robo2VLM,含空间理解、指代、组合推理、时序、具身交互、规划六类)。
机器人数据的「三重体检」
- 时序/统计体检:级联中值滤波 + Savitzky–Golay 参考曲线识别非物理跳变;状态-动作经互相关对齐后检查一阶差分方向一致性;分位数(q01/q99)离群剔除(夹爪维度例外,因为分布不连续)。
- 几何体检:可靠关节读数 + 机器人模型时,用正运动学核对关节角 ↔ 末端位姿的一致性,暴露 TCP 定义/旋转表示/base 坐标系的坑;坐标轴语义不明的数据保持原样。
- 视觉体检:黑帧/损坏/过度模糊/长期静止帧剔除,但夹爪闭合的关键帧即使视觉变化小也保留。
EgoANT:人履数据怎么切成原子任务
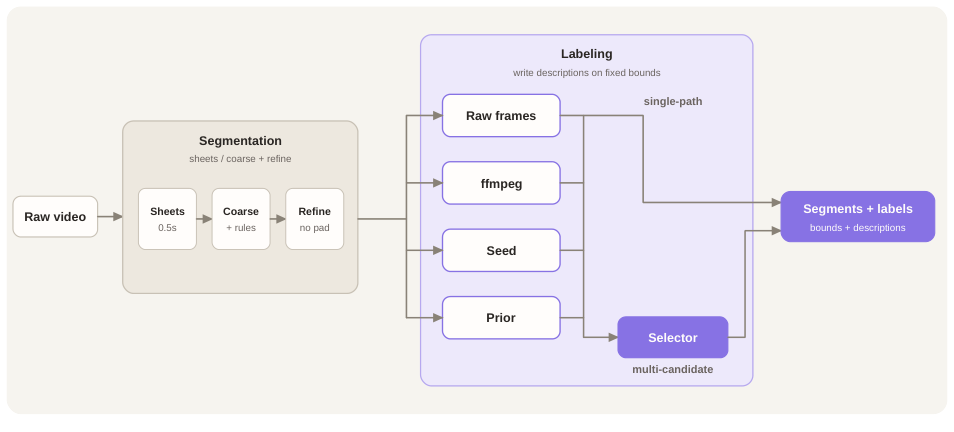
Figure 2 四步:(1) 粗分段:0.5s 采样的「接触池」(每表 ≤20 帧)作为整段一次性输入 VLM,配合 Macrodata Labs 的 completed-event 规则(识别会产生有效状态变化的操作段,不理睬接近/微调/缩手);(2) 局部修正:在粗边界周围有时间戳 contact sheet 复核(可把粗段拆分成多个原子任务);(3) 多路候选标注:固定边界上的原生帧标注、FFmpeg 替代解码路径标注、基于 seed/prior 条件的重标注并行;(4) 纯文本选择器只看候选描述文本定稿(选「动作-物体-落点」表述最具体的)——选段只用文本,视觉证据全在前一步。模型选择:分段用 Qwen3.6-27B,标注/选择用 Qwen3.5-397B。配完之后所有三个数据源都统一成「时序对齐的视觉 + 子任务描述 + 双腕 14 维运动(xyz+quaternion)」格式。
🛠️ 方法:三个专家 + 两种后训练技巧
MoT 架构
如图 3 左半所示:物理推理器吃当前观测 + 指令,产语义 token、保留自回归语言头,输出还包含物理语言描述;世界生成器基于 frozen 视频自编码器的 latent 未来视觉流(观测帧保持干净);动作预测器嵌动作块 + 当前状态 token、预测连续流场。三者每层通过 joint attention 互走信息(Q/K/V 各自的投影,拼 token 维联合求解输出)。整个模型学的是 p(语言, 未来观测, 动作 | 观测, 状态, 指令) 的联合分布——一个 forward 同时算视频和动作两个速度场。
预训练
损失 L = w_a·L_act + w_v·L_v + L_lang,权重用 1:1:0.1(视频:动作:语言)配比。flow matching 在独立采样 τ_a、τ_v 的噪声水平上插值;预训练时动作源和视觉源都是高斯噪声,生成从噪声端(t=1)流向干净目标端(t=0)。语言损失只对 answer token 回传。执行的是物理语言监督——人和机器人数据都按 LAP 的模板讲 EEF 位移变化。
后训练两项技巧
- 未来帧加噪增广(Future-frame Noise Augmentation):joint attention 会让动作预测太依赖「几乎干净」的未来视觉预测,但这种预测推理时不一定靠谱。以 p=0.5 的概率把插值后的未来 latent 保留率 saug~U(0.5,1) 充分扰动、观测 latent 保持干净、flow 目标和时间步 embedding 不变——逼动作专家从粗糙的视觉表征里也能提取控制相关信息。也就让「生成 + 动作」两路耦合更鲁棒。
- History-conditioned flow matching(图 4 上):动作流的源不再是高斯 N(0,I),而是「上一段历史动作 + N(0, η²I)」(η=0.02)。从扰动的历史(噪声水平 1)稳定流向干净的未来(噪声水平 0)。时序连续性成为了先验。图 4 下方两幅:start = noise(传统 N2A)vs start = 历史动作 + 小扰动(本文 A2A)都指向 clean actions。
两项技巧叠加的直接收益:推理去噪步数可以压到 2–4 步。Figure 11 显示 A2A 4 步(71.73%)超过 N2A 10 步(66.73%)——省 6 步推理且更准。
🧪 实验:六个赛道
1. LIBERO(分布内)
| 方法 | Spatial | Object | Goal | Long | 平均 |
|---|---|---|---|---|---|
| π0.5 | 98.8 | 98.2 | 98.0 | 92.4 | 96.9 |
| OpenVLA-OFT | 97.6 | 98.4 | 97.9 | 94.5 | 97.1 |
| Motus | 96.8 | 99.8 | 96.6 | 97.6 | 97.7 |
| X-VLA | 98.2 | 98.6 | 97.8 | 97.6 | 98.1 |
| VLA-Adapter / Cosmos-Policy / LingBot-VA / Spatial Forcing | – | – | – | – | 98.5 |
| Xiaomi-Robotics-0 | 98.8 | 100.0 | 98.8 | 97.2 | 98.7 |
| UniWAM | 99.6 | 99.6 | 99.2 | 98.4 | 99.2 |
2. RoboTwin 2.0(C2C 与 C2R)
50 任务、每任务 50 条 clean 演示、评估 100 episodes。分 VLA / WAM 两大家族:
| 家族 | 方法 | C2C | C2R | 平均 |
|---|---|---|---|---|
| VLA | GR00T-N1.7 | 43.6 | 20.7 | 32.2 |
| VLA | StarVLA | 58.1 | 10.6 | 34.4 |
| VLA | Xiaomi-Robotics-0 | 62.90 | 18.20 | 40.55 |
| VLA | ABot-M0 | 57.40 | 30.36 | 43.88 |
| VLA | X-VLA | 68.00 | 20.90 | 44.45 |
| VLA | Spatial Forcing | 77.20 | 26.74 | 51.97 |
| VLA | π0.5 | 70.70 | 46.00 | 58.35 |
| VLA | GigaBrain-0.7 | 66.80 | 67.90 | 67.35 |
| WAM | AHA-WAM | 64.3 | 3.2 | 33.8 |
| WAM | FastWAM | 70.20 | 1.20 | 37.70 |
| WAM | X-WAM | 70.00 | 25.80 | 47.90 |
| WAM | 4D-WAM | 81.5 | 41.8 | 61.7 |
| WAM | OpenWAM-α | 89.4 | 48.7 | 69.0 |
| WAM | UniWAM | 75.14 | 68.32 | 71.73 |
这张表是最值得慢慢看的一张:C2C 冠军 OpenWAM-α 一掉随机化就掉 40.7 pp(89.4→48.7);而 UniWAM 是全表掉分最少的一档(6.82 pp),C2R 又以 0.4 pp 险胜开了「随机化数据训练」外挂的 GigaBrain-0.7。fast WAM(AHA-WAM/FastWAM)的 C2R 崩到 1–3% 印证了那个前提:纯视频生成骨干、没有语义/推理配套时,随机化是死穴。
3. LIBERO-Plus(七维扰动)
| 方法 | Camera | Robot | Language | Light | Background | Noise | Layout | 总 |
|---|---|---|---|---|---|---|---|---|
| π0.5 | 87.6 | 78.4 | 80.0 | 92.6 | 91.6 | 91.4 | 81.8 | 86.2 |
| ACoT-VLA | 96.6 | 70.4 | 79.7 | 95.1 | 97.1 | 95.9 | 85.0 | 88.0 |
| Kairos | 95.5 | 72.6 | 86.8 | 97.7 | 95.8 | 96.8 | 81.5 | 89.0 |
| UniWAM | 92.0 | 89.5 | 92.2 | 97.9 | 97.6 | 94.3 | 84.6 | 92.6 |
四个单项第一(Robot/Language/Light/Background),Robot 扰动 +11.1 pp 领先 π0.5——这条就是「物理语言把语义和动作绑在同一空间上,视觉捷径被削了」的直接证据;Camera 和 Layout 两项则不是第一(ACoT-VLA 96.6 / 85.0)——视角和布局扰动依然靠推理链路最深的模型占先。
4. 真机:指令跟随
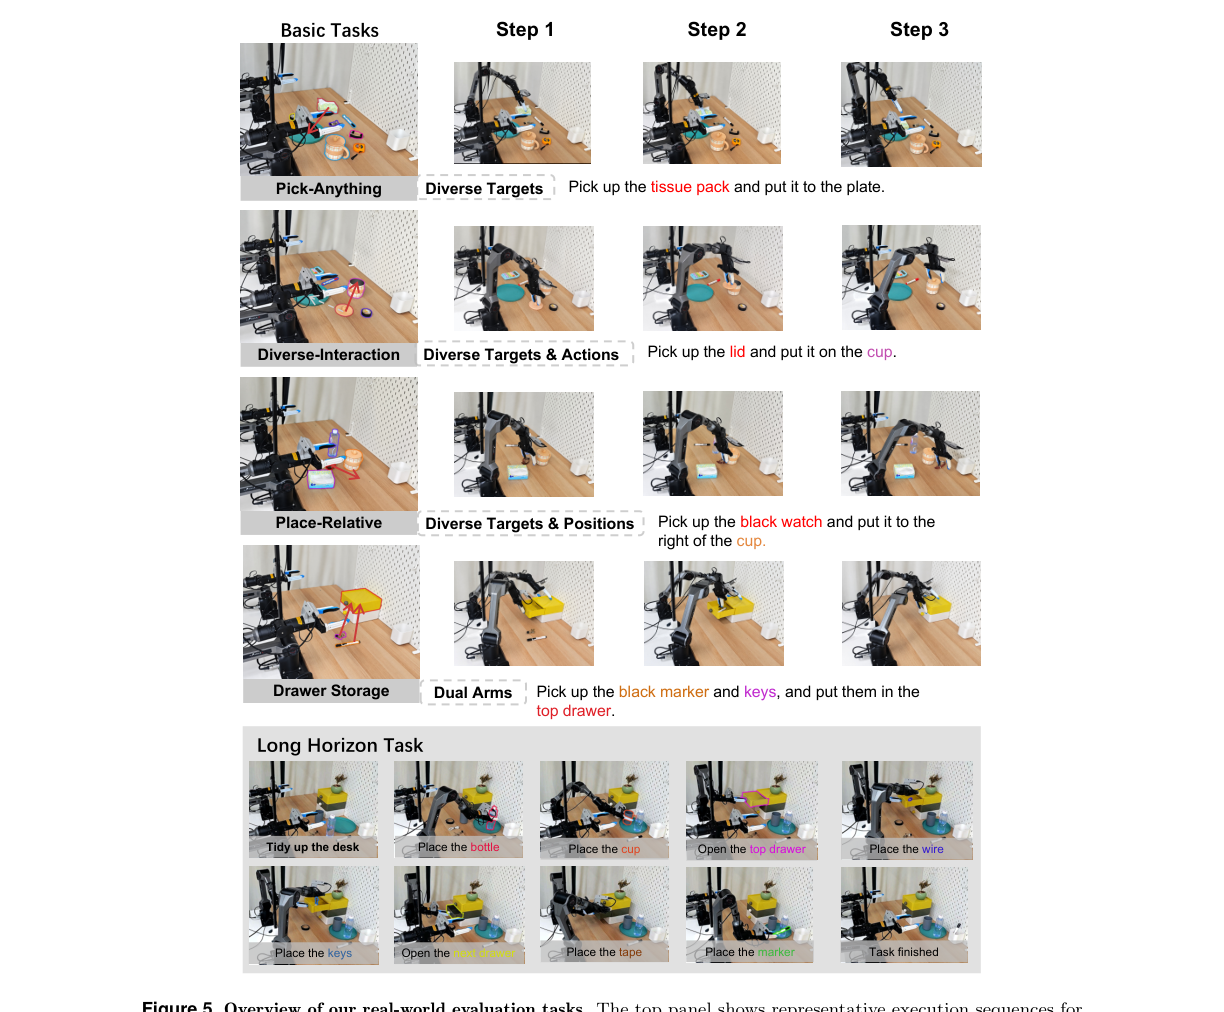
四个任务设计在同一 18 物体集合上考四种语言能力:Pick-Anything(名词 grounding;多干扰物场景找对目标)、Diverse-Interaction(同物体多动词——放盘上/盖盖子/按下计算器)、Place-Relative(介词 grounding:「粉杯放到计算器左边」)、Drawer-Storage(拉开抽屉放东西 + 双臂协作)。每个任务 40 次评估、每方法 200 演示/任务、同一 8×H100 训练协议 80K 步。
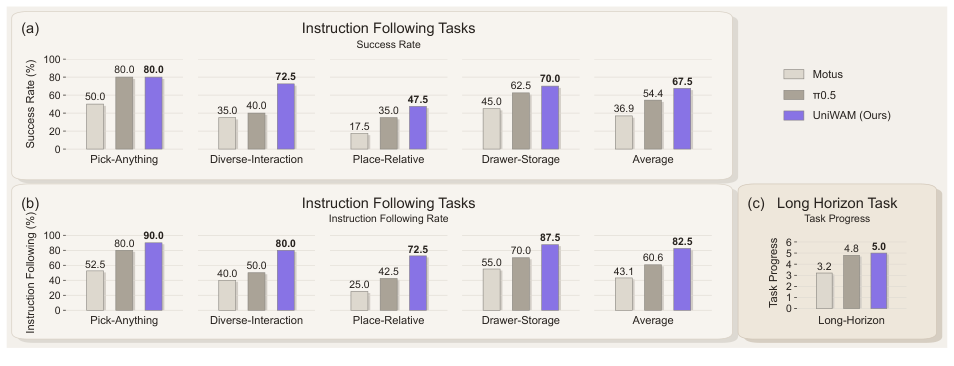
| 任务 | SR: Motus / π0.5 / UniWAM | IFR: Motus / π0.5 / UniWAM |
|---|---|---|
| Pick-Anything | 50.0 / 80.0 / 80.0 | 52.5 / 80.0 / 90.0 |
| Diverse-Interaction | 35.0 / 40.0 / 72.5 | 40.0 / 50.0 / 80.0 |
| Place-Relative | 17.5 / 35.0 / 47.5 | 25.0 / 42.5 / 72.5 |
| Drawer-Storage | 45.0 / 62.5 / 70.0 | 55.0 / 70.0 / 87.5 |
| 平均 | 36.9 / 54.4 / 67.5 | 43.1 / 60.6 / 82.5 |
IFR 指令跟随率衡量「有没有按指令对上物体和动作」——「把粉杯放到盘子上」时动橙杯即便是成功执行也算 IFR 失败。平均 IFR +21.9 pp、最大单项是 Diverse-Interaction(40.0→72.5,+32.5 pp)——物理语言监督确实在联合 grounding 上长出能力。
5. 真机:长程任务
Figure 5 下的「Tidy up the desk」任务推理时只给一句高层指令,模型自己推断 6 个顺序里程碑:放第一只杯 → 放第二只杯 → 开抽屉 → 放目标物 → 关抽屉 → 把记号笔放进笔架;UniWAM Task Progress 5.0/6,π0.5 4.8,Motus 3.2。训练秘技:训练时在物理语言前面加细粒度子任务描述、一起监督——「高层目标 ↔ 中间子目标 ↔ 动作」的链条就是这么练的。
6. Scaling law + t-SNE
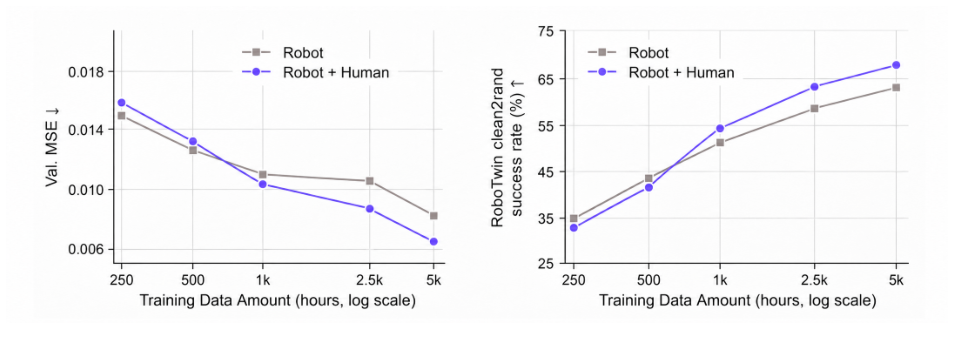
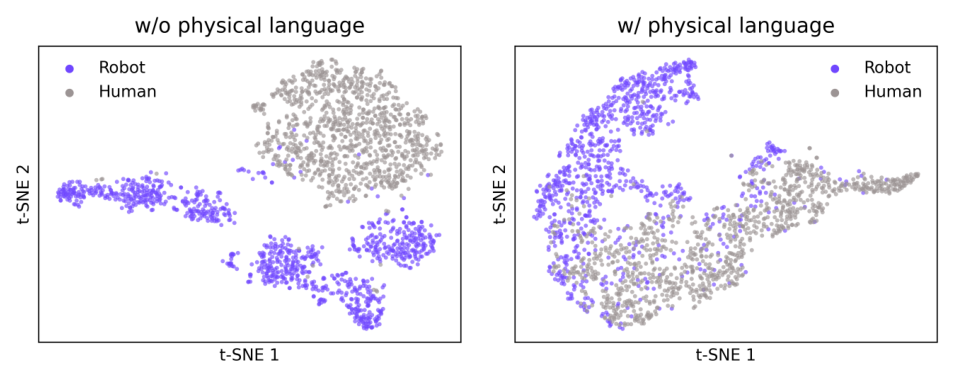
Figure 7 双图:左图是验证损失随机器人数据时长(log 尺刻)的收敛曲线——L(D) ≈ 0.03205 − 0.00302·ln D,R²≈0.983,而且这条离线曲线和下游任务成功率同步升降;右图是 RoboTwin C2R 成功率——纯机器人数据到 5k 小时时是 0.67,混入等量人履数据在 <1k 小时反而拖后腿、≥1k 之后开始反超。「人机共训大数据才有物理共性可迁移」。Figure 8 给的是机制证据:没有物理语言监督时物理推理器的表征里机器人(紫)和人(灰)在 t-SNE 里完全分开,加上物理语言监督后相互嵌入——共域映射就是靠这套语言桥。
Task-level 全表(附录 Table 7)
50 任务里最强项 grab_roller 100%、click_bell 99.5%、stack_bowls_two 92.5%;最弱项 hanging_mug 16%、handover_block 21%、put_object_cabinet 34% 拖低均值——挂物/交接类交互复杂任务仍是公难点。
🔬 消融
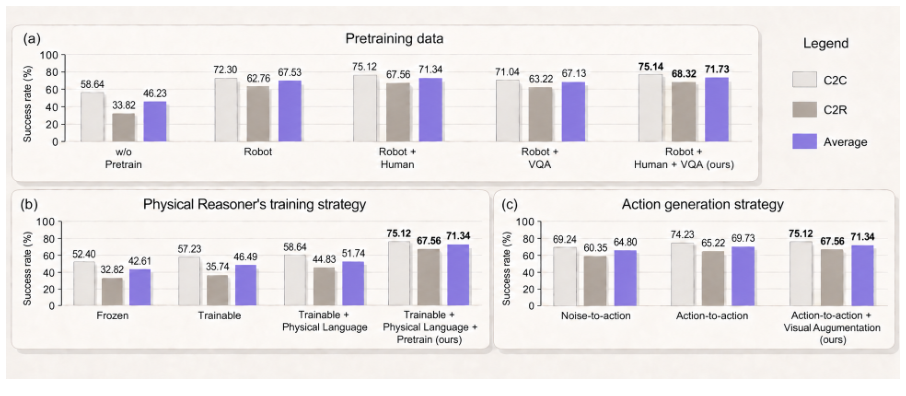
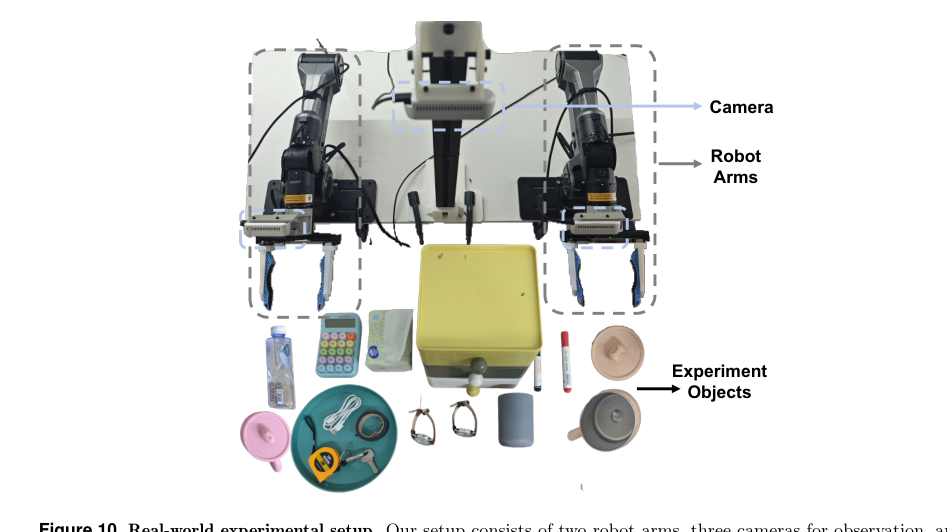
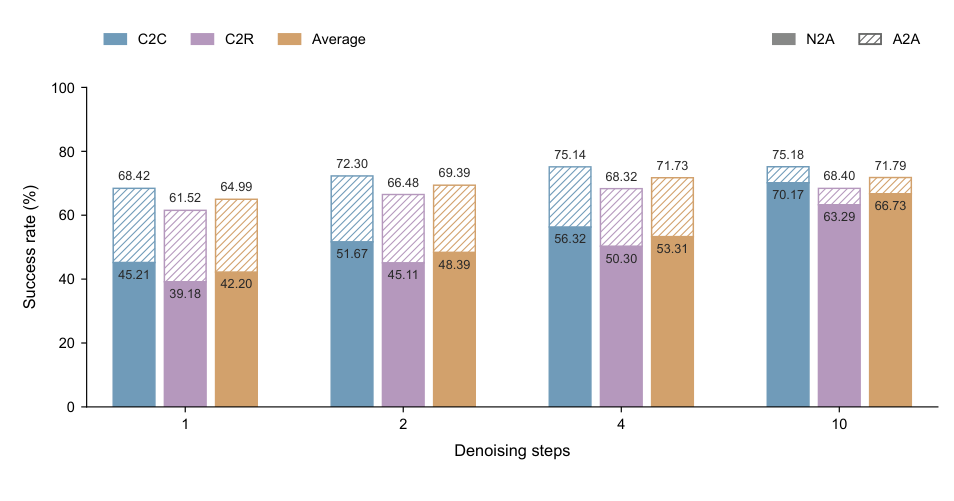
Figure 9 三组(RoboTwin 平均):
- 数据构成:baseline 46.23 → 机器人 only 预训练 67.53(C2C 72.30 / C2R 62.76)→ +人履数据 71.34(C2C 75.12 / C2R 67.56)→ +VQA 71.73(C2C 75.14 / C2R 68.32)。机器人+VQA(无 human)=67.13,不升反微降——VQA 只和「人+机」搭配才有增益,就是前文那条「大数据才够迁移」的消融面。
- VLM 训练策略:冻结推理器 42.61 → 解冻 46.49 → +物理语言监督 51.74 → +预训练 71.34。逐级有效。
- 动作生成策略:N2A 64.80 → A2A(历史初始化)69.73 → +未来帧加噪 71.34。
Figure 11 把推理效率讲透:1/2/4/10 步下,N2A 平均 42.20/48.39/53.31/66.73,A2A 64.99/69.39/71.73/71.79——A2A 只要 2 步就追平 N2A 的 10 步,4 步封顶。推理成本直接半价打三折。
💡 评析:一条焊缝,两个亮点,四条边界
最妙的地方
- 物理语言是「万能插座」:一个模板让 human 手腕运动和机器人 EEF 动作说同一种语言——它同时做了三件事:保语言(对 VLM 是熟悉的文本分布)、跨本体(14 维 vs 关节角差几度不同不要紧)、可对齐(EgoVerse/VITRA/EgoDex 的腕轨迹都能转写成动作语言)。t-SNE 重叠是人类-机器人 transfer 的最直观形态。
- 「监督按专家分配」原则写清楚了 VQA/人/机三者的角色——记录了这个时代最重要的 multi-source pretraining 的系统落位,可以视作 MoT 系工作(Motus、Cosmos 等)里监督设计写得最干净的一篇。
- A2A 是白嫖的时序先验:不改架构、不 cost 推理,把 past 动作当初始化拿一个清晰收益(64.8→69.7),而且让推理步数从 10 降到 2-4。「推理太慢」这个 WAM 系的老 bug 被打掉。
四条边界
- C2C 不是冠军:75.14 落后 4D-WAM(81.5)/ OpenWAM-α(89.4)达 6-14 pp。作者解释成「limited training data 下的双臂性能」,反过来读也是「本体/推理亮点用在随机化场景、而非把 clean 记忆化推到满」。
- Camera / Layout 扰动不是第一:视角换位和桌面布局更多考验纯空间推理,UniWAM 的多专家集成在这两个维度上仍不如 ACoT-VLA——「语言/物理维度拉满」是数据配比给的,不是架构跨维度无敌。
- 真机实验问题谱窄:18 个桌面物体、4+1 个任务、每任务 40 次评估——指令跟随强但总体仍是桌面双臂系统级验证(AgileX Piper 双臂 + 三相机)。
- Scaling law 是验证损失 not 成功率:R²≈0.983 的曲线拟合到 5k 小时数据;下游 0.35→0.67 的增益虽单调但样本点少,不宜断言已踩到平台——250h→5k 小时也就 4 个数据点。
🗺️ 在 WAM 谱系里的位置
| 路线 | 代表 | 思路 | 与本文关系 |
|---|---|---|---|
| 纯 VLA | π0/π0.5、OpenVLA、X-VLA | VLM + 动作头 | 家族对手(IFR 基线) |
| WAM(视觉动力学) | DreamZero、OpenWAM、4D-WAM | 视频骨干 + 未来预测监督 | 家族对手(C2C 强 / C2R 软的对照面) |
| latent action 桥 | Motus | 光流 latent action 共享 | 家族对手(无监督共训路线) |
| 统一三专家(本文) | UniWAM | VLM+VGM+动作、物理语言为桥 | 谱系收束点 |
| 人履增强训练 | GEN-0、Xiaomi、BeingH0.5 | 人履数据 + 共训姿态 | 同向(本文提供了它的 scaling law) |
延伸:《π0.5开放世界泛化精读》(VLA 操纵链)、《PrismWAM 精读》(MoT 解耦路线)、《Flash-WAM 精读》、《DROID机器人操作数据集精读》、《LIBERO 精读》(四套件基准)、《WAM 世界行动模型全景分析》。
📊 图表总索引
| 图号 | 内容 | 在本文中的位置 |
|---|---|---|
| Fig 1 | 数据/架构/成绩总览 | 开篇 |
| Fig 2 | EgoANT 人履标注流水线 | 数据 |
| Fig 3 | 三专家 MoT 架构 + 数据构成 | 数据/方法 |
| Fig 4 | History-conditioned 去噪示意 | 方法 |
| Fig 5 | 真机 4 个指令任务 + 6 层长程任务 | 真机 |
| Fig 6 | 指令跟随 SR / IFR / 长程进度 | 真机 |
| Fig 7 | 验证损失 scaling law + C2R 数据尺度曲线 | 分析 |
| Fig 8 | 物理语言上线前后的 t-SNE | 分析 |
| Fig 9 | 三组消融条形图 | 消融 |
| Fig 10 | 真机双臂 + 三相机 setup | 消融旁 |
| Fig 11 | N2A vs A2A 在 1/2/4/10 步的曲线 | 推理效率 |
表格:Table 1 机器人+人数据小时数;Table 2 VQA 8.29M 构成;Table 3 EgoANT 配置;Table 4 LIBERO;Table 5 RoboTwin 50 任务 C2C/C2R;Table 6 LIBERO-Plus 七维;Table 7 RoboTwin 全任务。
❓ 自测 Q&A
Q1:为什么动作要用自然语言描述?直接用回归动作头监督不行吗? A:动作头照记(机器人数据里都有),但不保 VLM 的语义能力。VLM 更新到具身 domain 时如果有动作「外语」监督冲击它 pretrained 输入输出分布,语义会伤掉;物理语言把动作翻译成 VLM 熟悉的自然语言文本,是「通讯约束内的具身改造」。
Q2:人履数据为什么只喂推理器和生成器、不喂动作预测器? A:人手轨迹的 Action tags 精度低于机器人拿的 joint/EEF 读数,何况每个人手的动作语义集不一样,用低精度动作当监督会污染 flow 中的连续性先验;但人履帧在「世界会怎么变」上信息丰富、且腕轨迹经 EgoANT+ wrist transform 可以讲物理语言,故喂推理器 + 生成器而不喂动作。
Q3:未来帧加噪增广是对「生成」还是对「动作」的加固? A:动作。joint attention 让动作 token 直读视觉预测 token;推理时视觉 token 由 VGM 生成、有噪声/有缺陷,如果训练时动作只见过「准干净视觉未来」它就脆弱。策略是在训练期以 p=0.5 强行加噪未来 latent(观测 latent 干净、flow 目标不变),让动作学会「从粗糙视觉也能过日子」。
Q4:A2A 会不会把「动弹不得」锁死? A:入口不是纯历史而是「历史 + N(0, η²I)」(η=0.02)。扰动幅度小到保留时序连贯(供网络走 2-4 步就到目标),又大到可以自由偏离历史(转新动作 chunk 时输出的位移场这个头负责)。
Q5:LIBERO-Plus 里 Robot 扰动(89.5%)的领先来自? A:作者的归因是:物理语言把语义-动作绑成共享映射、VQA 保语言理解、世界生成训练强调「光照/背景下的动力学不变量」——三个监督目标各占一个维度,正好打在 Robot/Language/Light+Background 三条扰动带上。
Q6:Scaling law 是在什么上面量的? A:log(D) 上的验证损失。公式 L≈0.03205−0.00302·ln D(D 单位小时,R²≈0.983),覆盖 250h → 5k 小时机器人+恒定比例人履;同时验证损失和 RoboTwin C2R 成功率同向走——离线 loss 可以作为具身能力估计。它的可用性在 <1k 时有「人履拖累」的插曲——小数据阶段还得纯机器人。
📚 资源与延伸
- 论文:arXiv 2610.02054
- 代码 / 模型 / 项目页:GitHub repo、Hugging Face / ModelScope 权重、EgoDex/EgoVerse/VITRA 数据全部公开(站内链接见项目页
unified-wam仓库组) - 关键前作:π0 / π0.5(arXiv 2504.16054)、OpenVLA、LAP(语言-动作预训练,RSS 2026)、Motus(CVPR 2026)、DreamZero(arXiv 2602.15922)、4D-WAM(arXiv 2608.08023)、Fast-WAM(arXiv 2603.16666)、RoboTwin 2.0(arXiv 2506.18088)、LIBERO-Plus(arXiv 2510.13626)、EgoDex、EgoVerse、VITRA、Mixture-of-Transformers(arXiv 2411.04996)
- 站内延伸:《π0.5开放世界泛化精读》、《PrismWAM 精读》、《Flash-WAM 精读》、《LoopWAM 精读》、《HexaShell 精读》、《WorldOracle 精读》、《LIBERO 精读》、《DROID机器人操作数据集精读》、《WAM 世界行动模型全景分析》、《什么是世界模型》