📄 论文信息
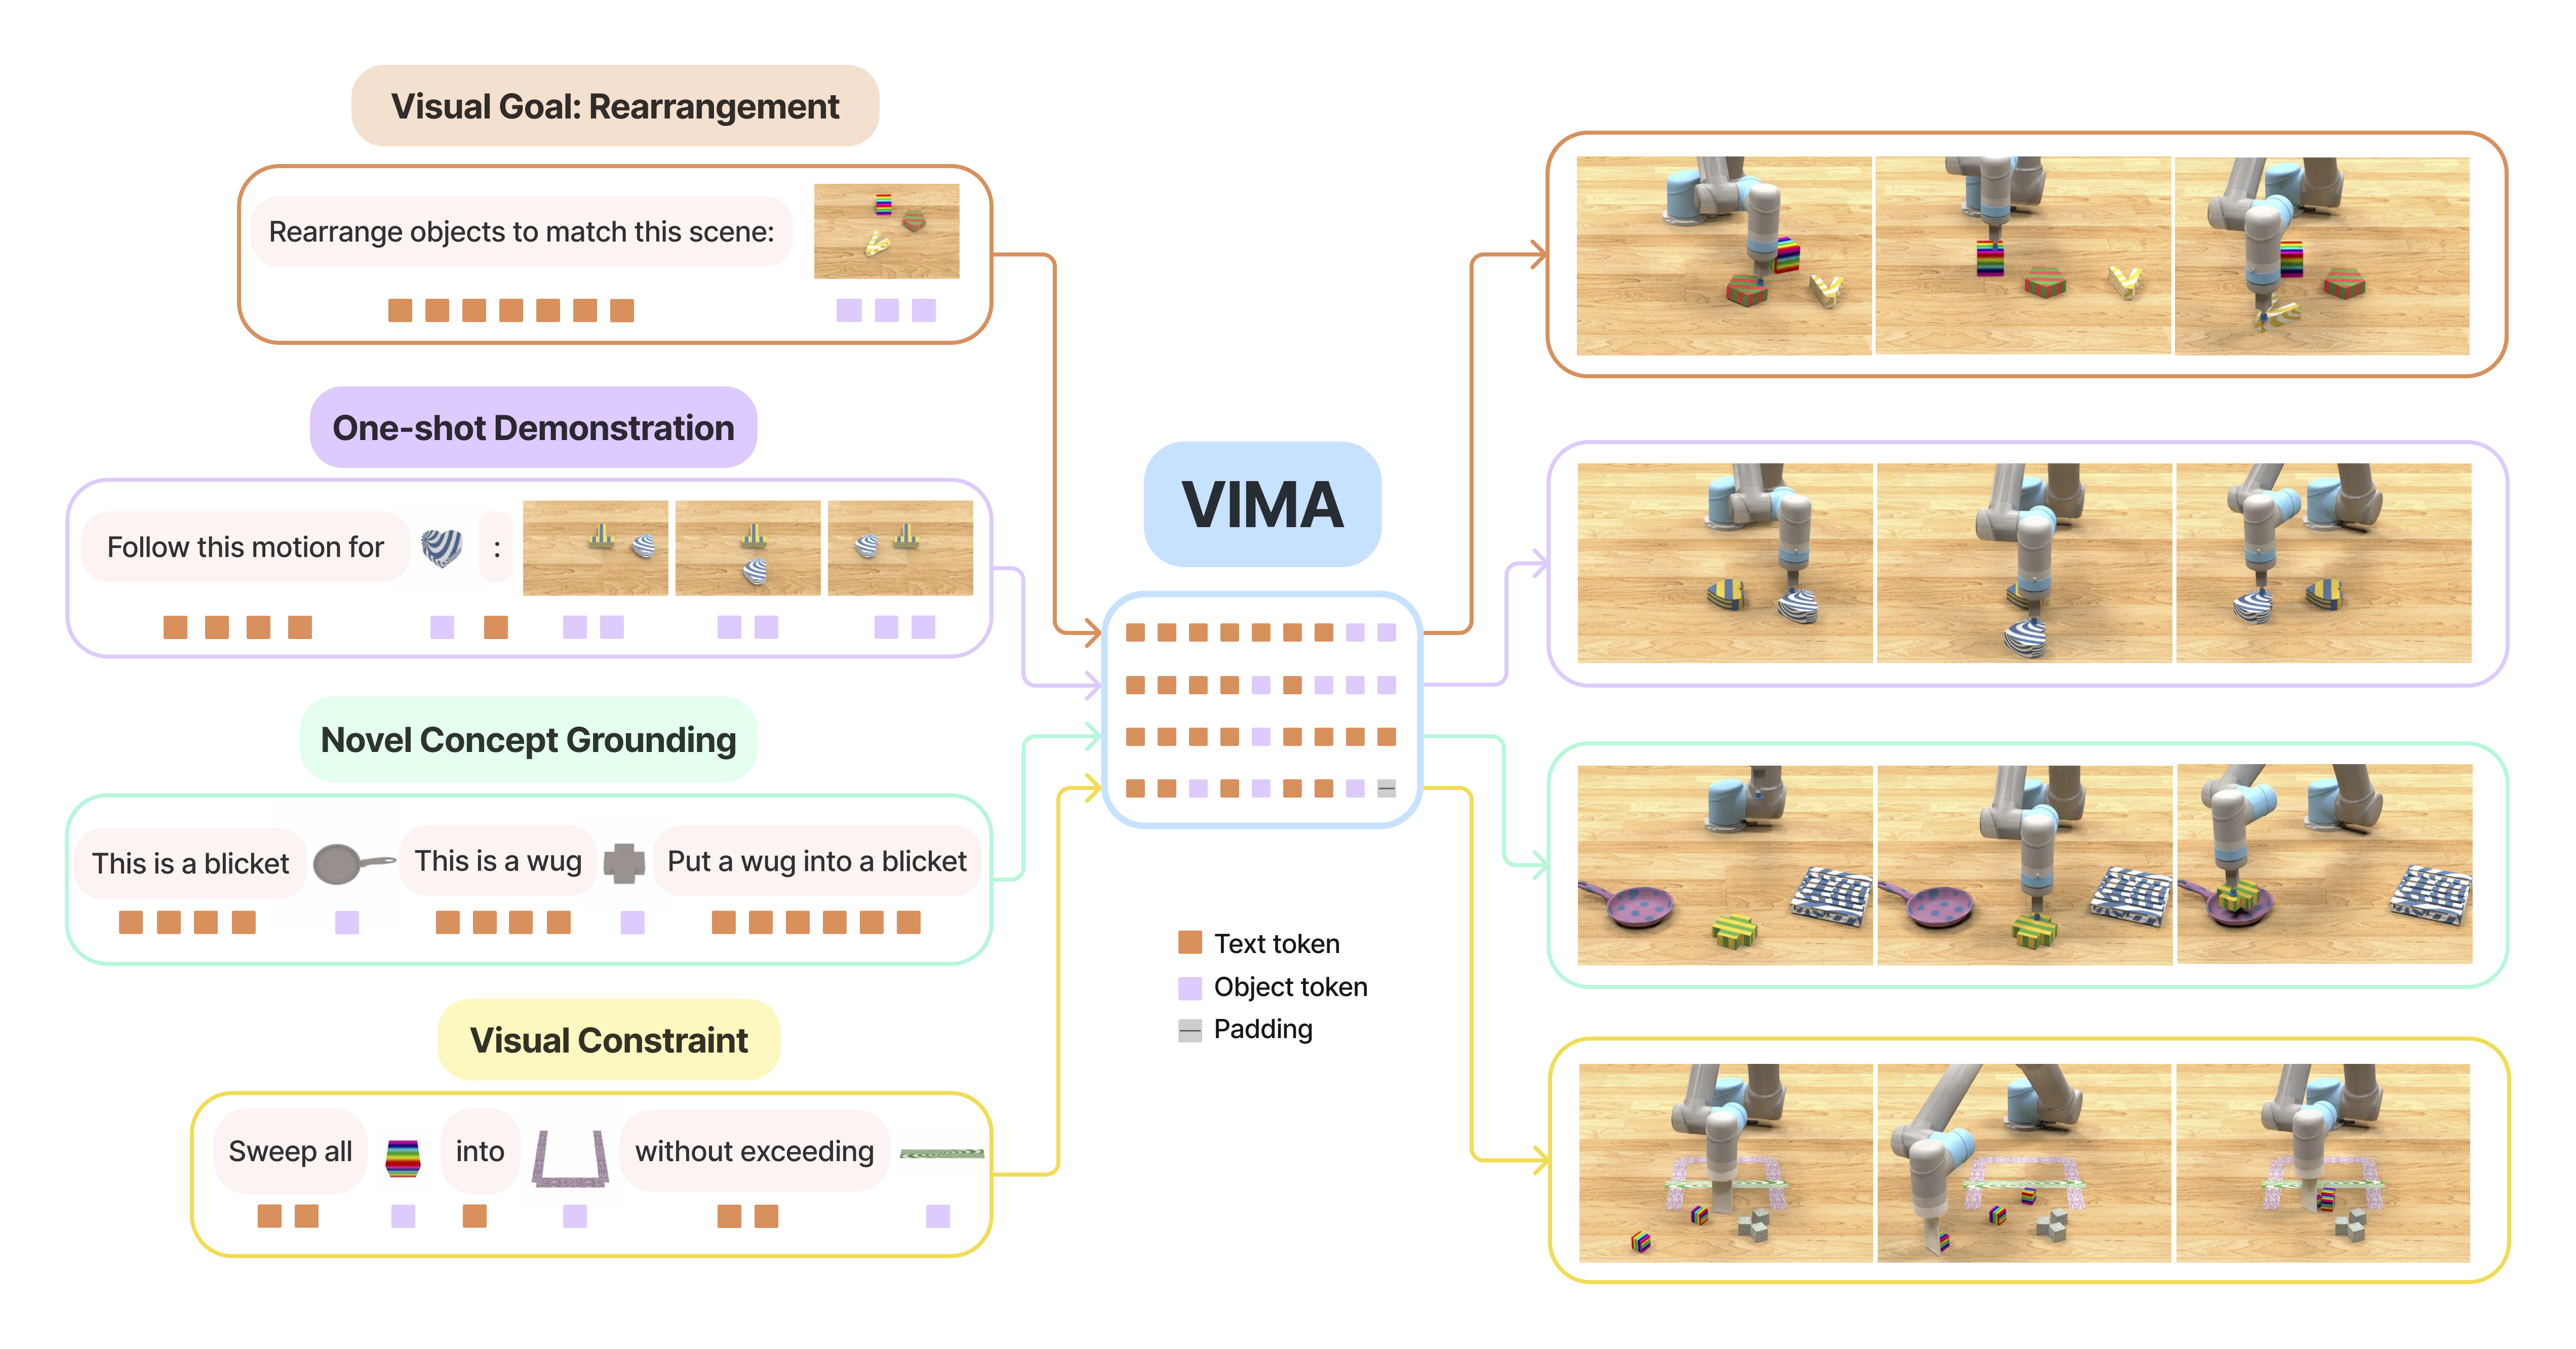
- 标题:VIMA: General Robot Manipulation with Multimodal Prompts(VIMA:基于多模态提示的通用机器人操作)
- 团队:Stanford University、NVIDIA、Caltech、Tsinghua University、UT Austin
- 发表:ICML 2023(International Conference on Machine Learning)
- 关键词:多模态提示、Transformer、机器人操作、模仿学习、零样本泛化
- 一句话总结:VIMA通过将文本和视觉token交织的多模态提示统一各种机器人操作任务,在单一模型中实现了强大的模型可扩展性和数据效率。
- 论文链接:arXiv:2210.03094
- 代码链接:GitHub - vimalabs/VIMA
🤔 要解决什么问题?
在自然语言处理领域,基于提示的学习(Prompt-based Learning)已经成为一种成功的范式:一个通用的大语言模型可以通过输入提示来执行各种任务。然而在机器人领域,任务规格的形式多种多样:
- 模仿一次性演示:给机器人展示一次如何完成任务
- 遵循语言指令:用自然语言告诉机器人该做什么
- 到达视觉目标:提供目标图像让机器人重现
传统方法通常将这些视为不同的任务,使用专门的模型来处理每一种。这种"孤岛式"的开发方式导致机器人系统无法灵活组合,难以适应多样化的应用场景。
核心问题:能否找到一种统一的接口,将所有这些不同的机器人操作任务表达为同一个序列建模问题?
VIMA的作者团队提出了一个大胆的假设:许多机器人操作任务可以统一表达为多模态提示(Multimodal Prompts),即交替包含文本和图像/视频帧的输入序列。
💡 核心方法
1. 多模态提示接口设计
VIMA的核心洞察是将各种机器人任务统一为多模态提示格式。一个典型的多模态提示包含:
- 文本token:语言指令(如"把红色方块放到蓝色圆圈旁边")
- 视觉token:图像帧(如目标状态图像、演示视频帧、物体特写图等)
例如:
- 简单操作:提示 = “把红色方块放到蓝色圆圈旁边” + 当前场景图像
- 视觉目标到达:提示 = “达到这个状态” + 目标图像
- 一次性视频模仿:提示 = “按照这个动作做” + 演示视频帧
- 新概念落地:提示 = “把所有"扭曲的"物体移到左边” + “扭曲的"物体示例图像
2. VIMA模型架构
VIMA采用编码器-解码器(Encoder-Decoder) Transformer架构:
编码器(Prompt Encoder):
- 使用预训练的冻结T5语言模型编码多模态提示
- 文本输入通过T5分词器和词嵌入获得词token
- 图像输入首先通过Mask R-CNN提取单个物体,然后将每个物体的边界框坐标和裁剪的RGB图块展平为物体token序列
- 所有token拼接形成提示序列 $P = [t_1, t_2, ..., v_1, v_2, ...]$
解码器(Robot Controller):
- 因果Transformer解码器,由交替的自注意力层和交叉注意力层组成
- 交叉注意力层将提示序列 $P$ 作为键(Key)和值(Value),将轨迹历史序列 $H$ 作为查询(Query)
数学表达为:
$$H' = \text{softmax}\left(\frac{Q_H K_P^\top}{\sqrt{d}}\right) V_P$$其中 $d$ 是嵌入维度。这种设计有三个优势:
- 加强与提示的连接:通过交叉注意力直接关注提示信息
- 保持提示token的完整流动:原始提示token可以深入传递
- 更好的计算效率:比全自注意力更高效
动作预测:
- 解码器输出的动作token通过离散化映射到机器人臂的位姿
- 每个交互步骤自回归地预测一个动作
3. 物体中心表示(Object-Centric Representation)
VIMA的关键创新之一是采用物体中心表示而非直接处理原始像素:
- 使用预训练的Mask R-CNN(在目标域微调)从图像中提取单个物体
- 每个物体由边界框坐标和裁剪的RGB图块组成
- 将物体信息展平为token序列
这种方法相比图像patch token有明显优势:
- 保留了物体级别的语义信息
- 避免了处理大量无关背景像素
- 更适合处理包含多个物体的复杂场景
4. VIMA-Bench基准测试
为了系统评估多模态提示代理,作者开发了VIMA-Bench:
- 17个代表性任务,涵盖6大类别:简单物体操作、视觉目标到达、新概念落地、一次性视频模仿、视觉约束满足、视觉推理
- 600K+专家轨迹用于模仿学习
- 四级评估协议评估渐进式泛化能力:
- Level 1:随机化物体放置
- Level 2:随机化物体外观
- Level 3:新物体组合
- Level 4:全新任务
每个任务可以通过程序化生成实例化为数千个不同的场景,通过各种纹理和桌面物体的组合实现多样化。
🧪 实验验证
主要实验结果
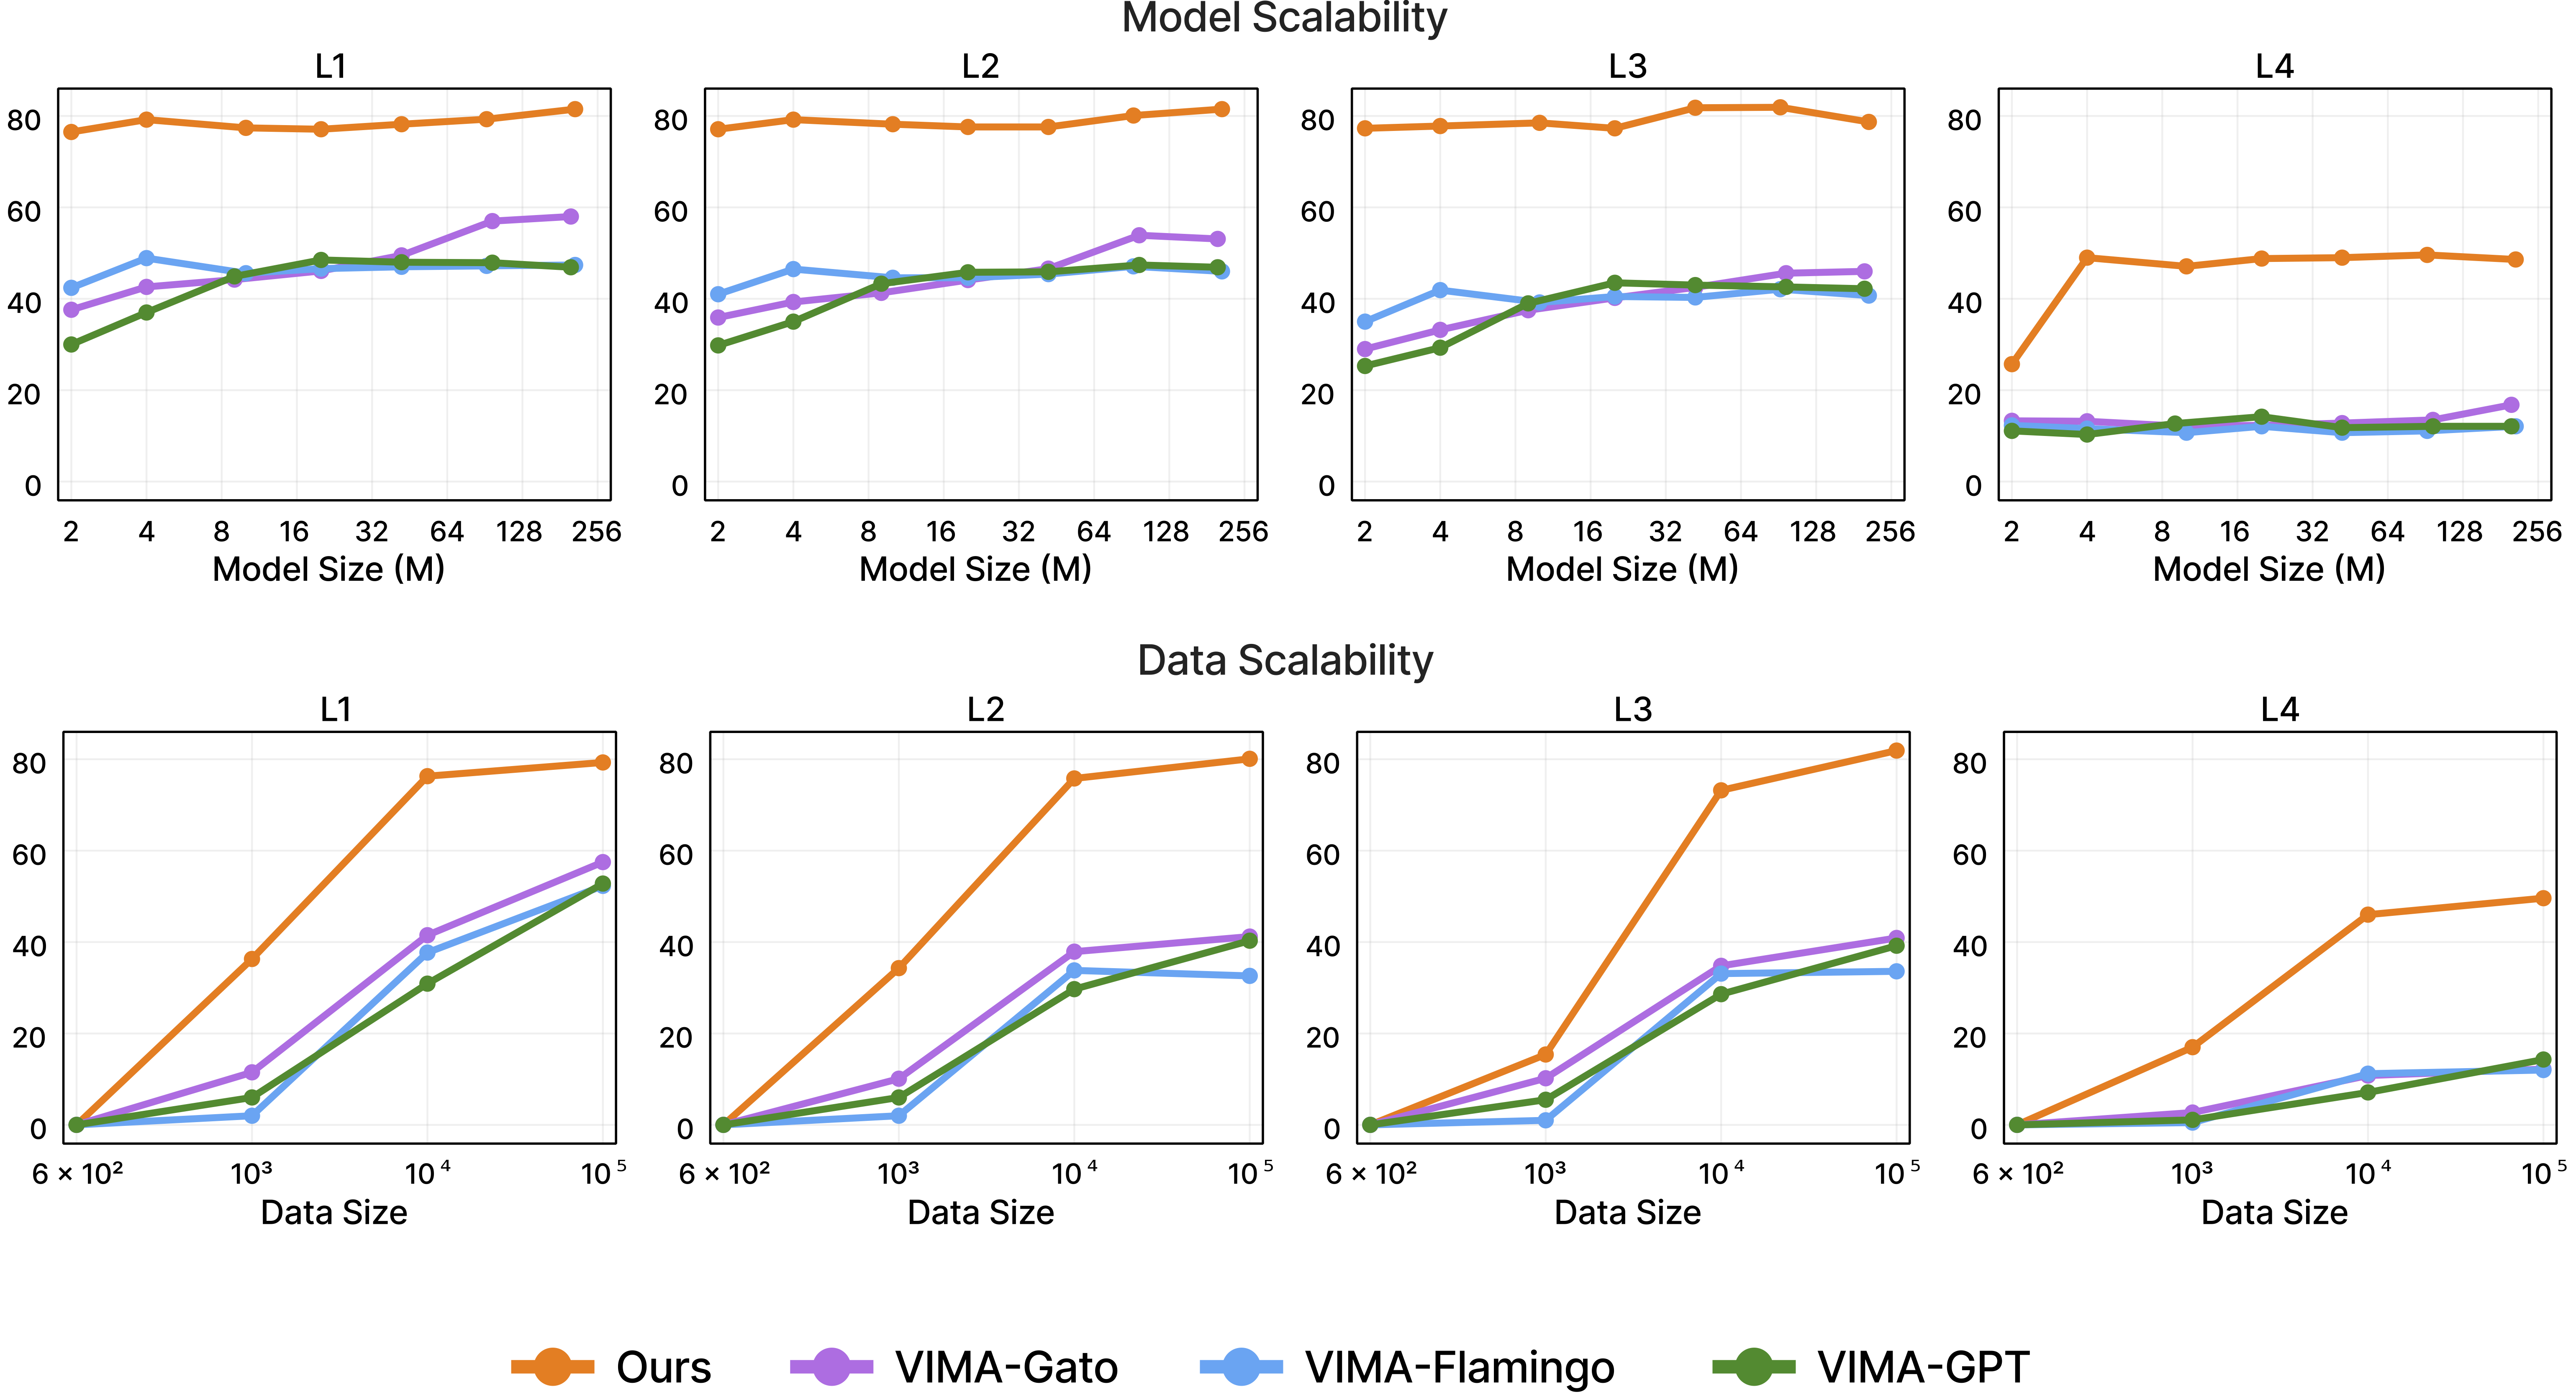
实验设置:训练7个不同规模的模型(2M到200M参数),在四级泛化设置下评估。
关键发现:
模型扩展性:在所有模型容量和泛化级别下,VIMA都优于基线变体。在最难的零样本泛化设置下:
- 相同训练数据:VIMA任务成功率最高提升 2.9倍
- 10倍更少训练数据:VIMA仍比最佳竞争变体好 2.7倍
数据效率:VIMA极其高效,仅使用10%的数据就能达到其他方法使用完整数据的性能水平
泛化能力:在四级泛化设置中,VIMA在所有级别上都表现出一致的性能优势
消融实验
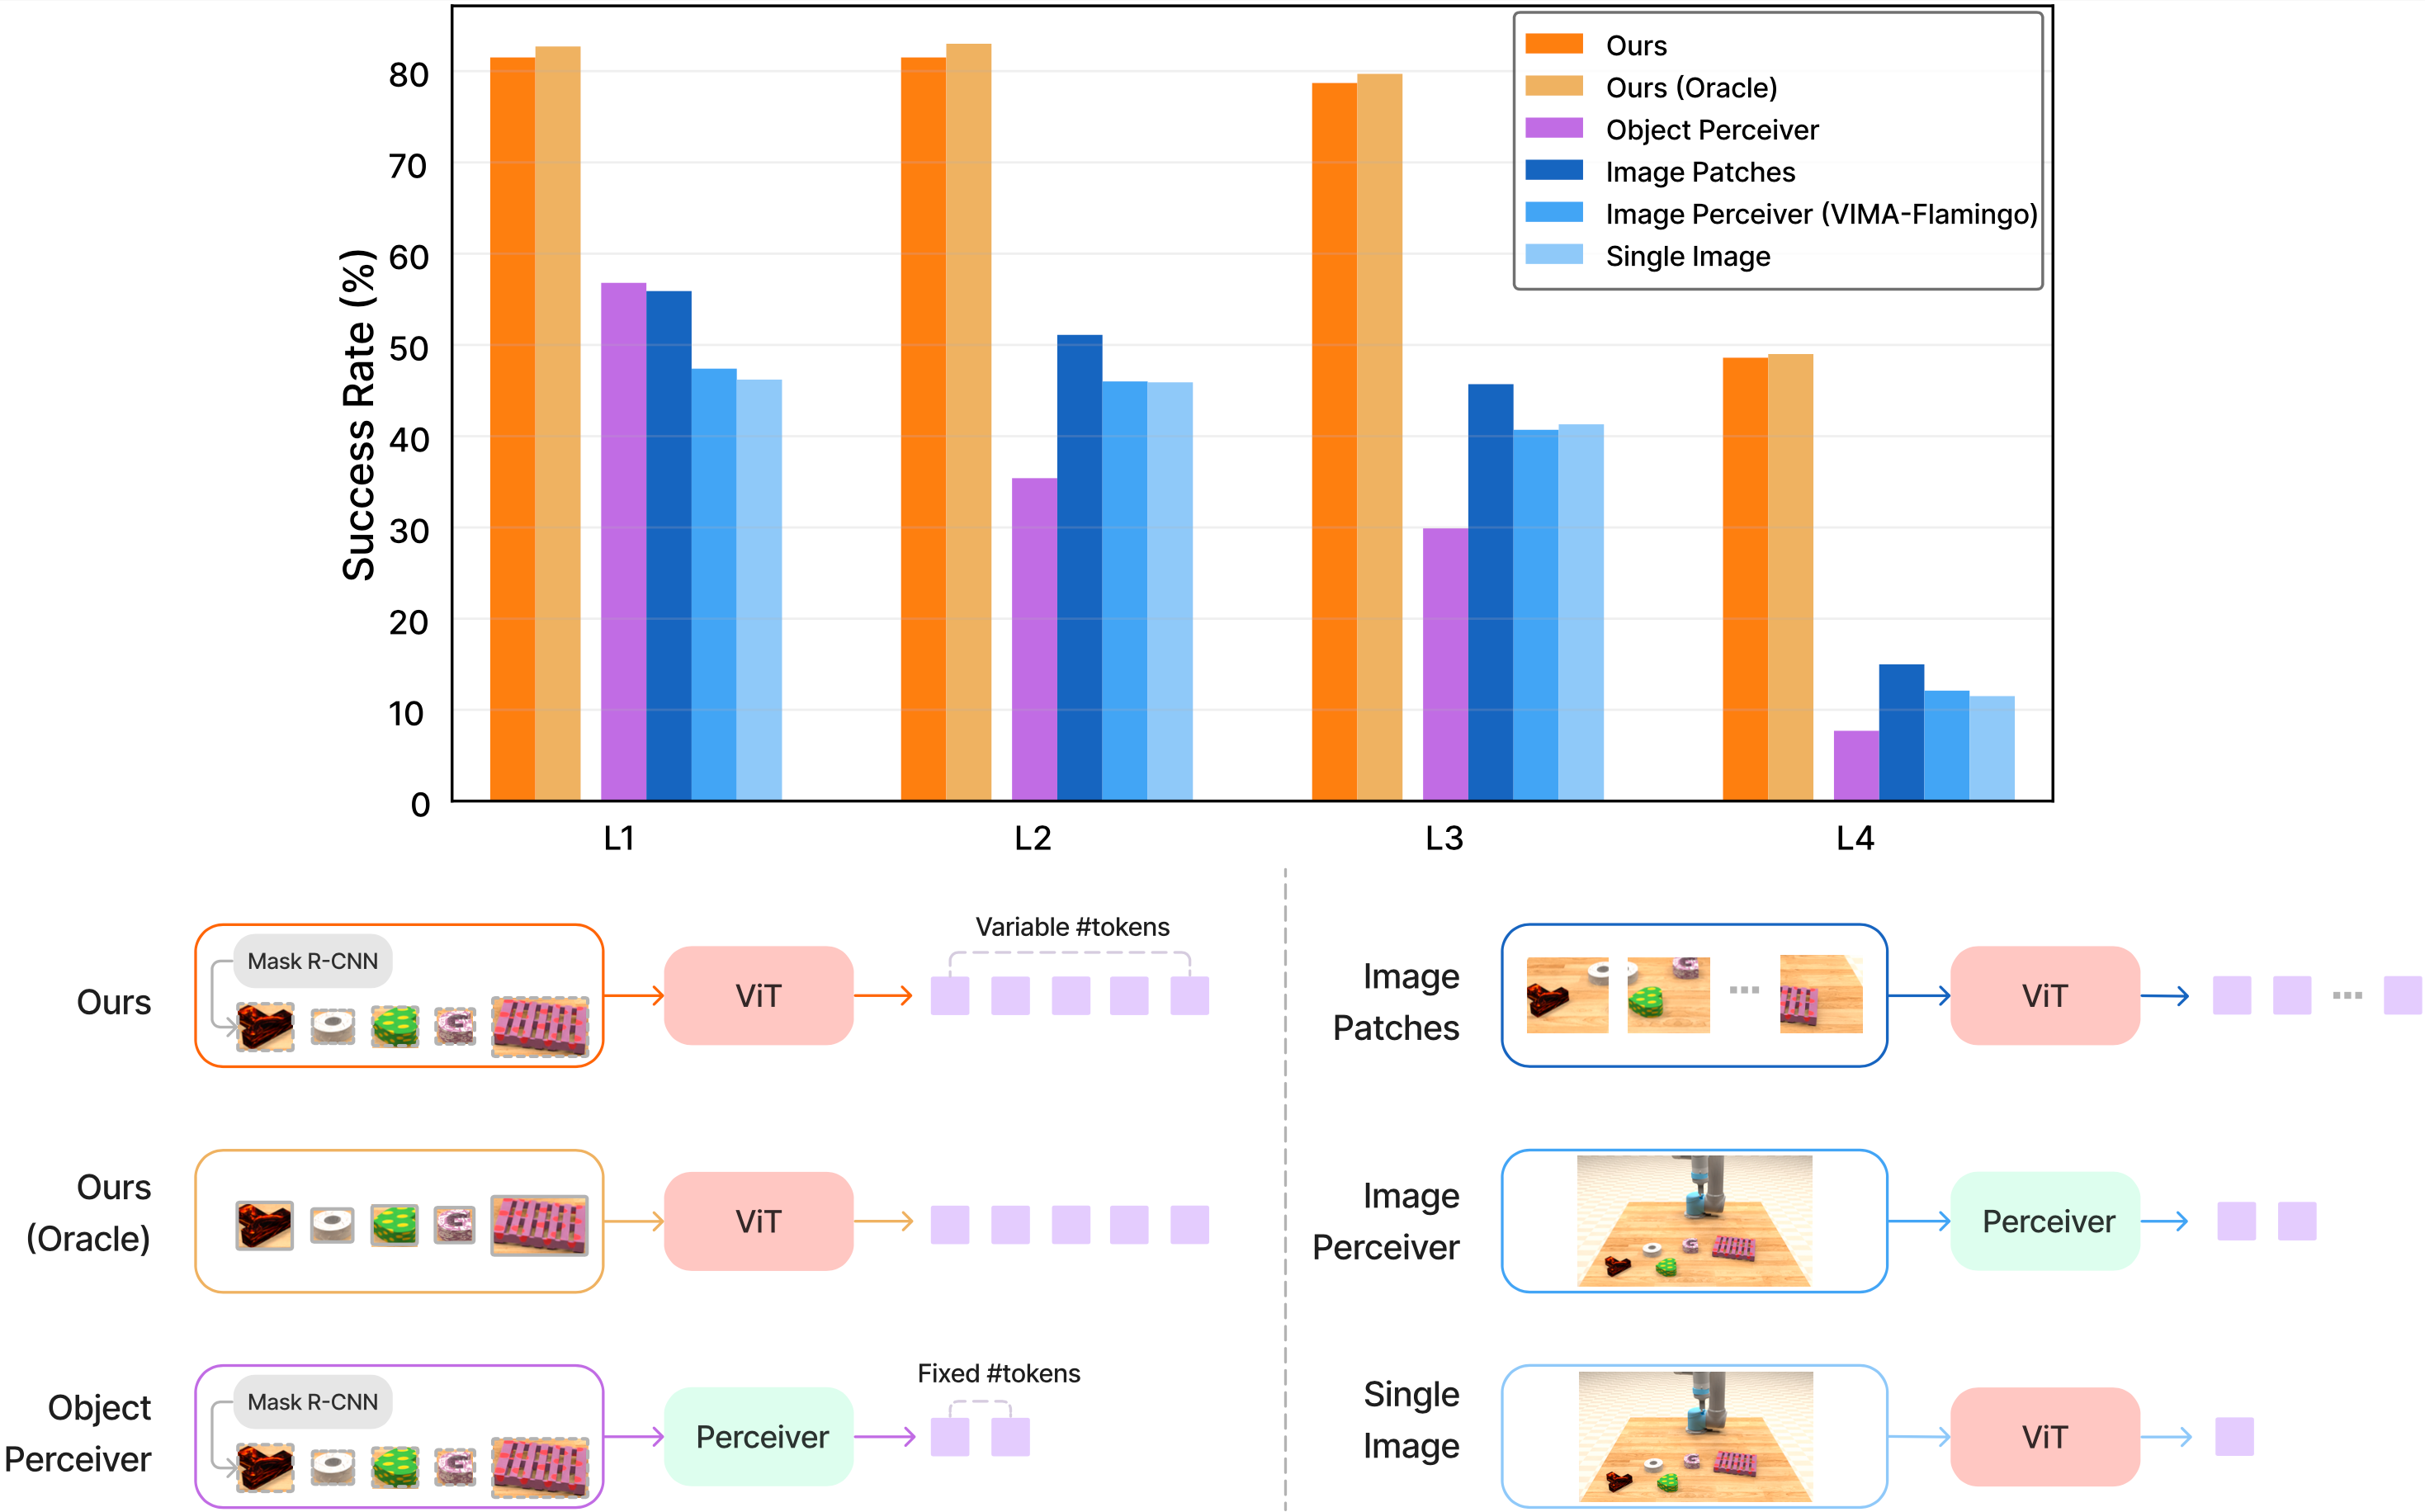
视觉分词器对比(VIMA-200M模型):
- 物体token(VIMA):表现最佳
- 图像patch token:直接从原始像素学习,性能较差
- 图像Perceiver:将物体序列下采样到固定数量token,性能下降
- 原始像素:性能最差
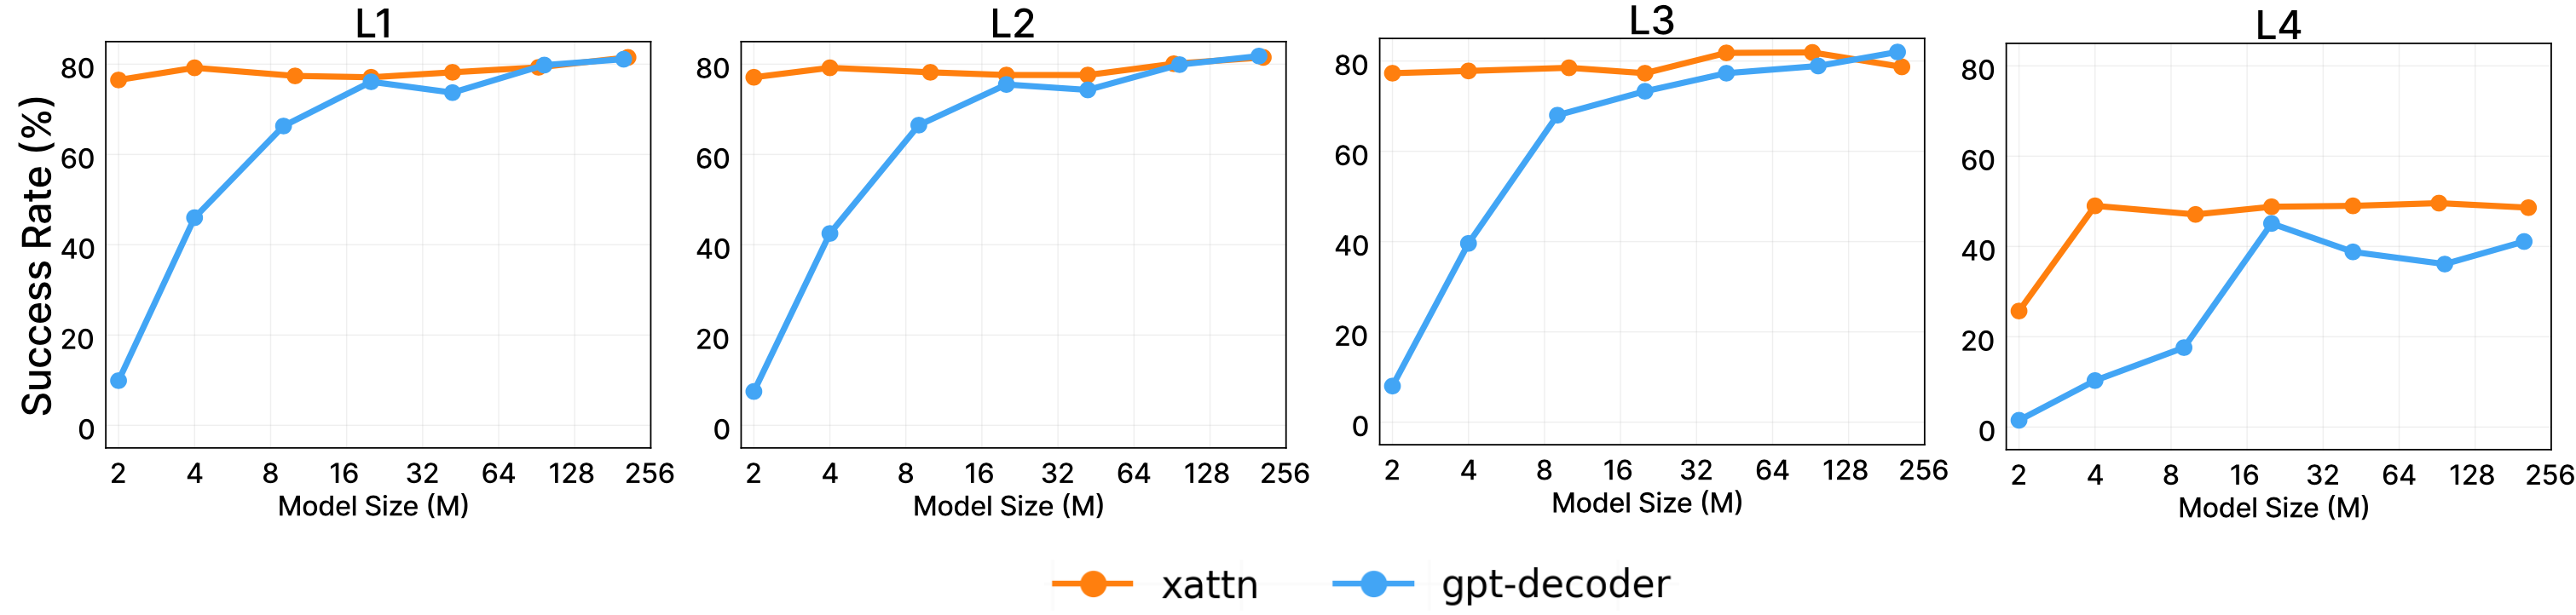
提示条件化机制对比:
- 交叉注意力(VIMA):在低参数设置和困难泛化任务中尤其有效
- GPT解码器(仅因果自注意力):性能较差,特别是在模型容量较小时
实验结论
实验证明VIMA的物体token + 交叉注意力条件化是最有效的设计方案。VIMA在各种设计选择中表现出:
- 更强的模型可扩展性
- 更高的数据效率
- 更鲁棒的零样本泛化能力
🔍 个人思考
亮点
统一接口设计的优雅性:将多样化的机器人任务统一为多模态提示格式是一个非常优雅的抽象。这种设计使得一个单一模型可以处理各种类型的任务,而不需要为每种任务设计专门的架构。这种"接口统一"的思想与NLP领域的提示学习范式高度一致。
物体中心表示的实用性:相比于直接处理原始像素,物体中心表示是一个非常实用的设计选择。它不仅保留了语义信息,还大大减少了计算量,使得模型能够更高效地处理复杂的多物体场景。
系统性的评估框架:VIMA-Bench的四级泛化协议是一个很好的评估设计,能够系统性地衡量模型在不同难度下的泛化能力。600K+的专家轨迹数据集也为后续研究提供了宝贵的资源。
局限性
仅限仿真环境:目前所有实验都在仿真环境中进行,尚未验证在真实机器人上的效果。仿真到真实的迁移(Sim-to-Real)仍然是一个开放问题。
依赖物体检测器:VIMA依赖Mask R-CNN来提取物体,如果检测器失败或不准确,整个系统的性能会受到影响。这种管道式的方法可能引入脆弱性。
固定的任务集合:虽然VIMA-Bench提供了17个任务,但这些任务仍然是预定义的。对于真正开放世界的应用,模型需要能够处理从未见过的全新任务类型。
未来方向
- 真实世界部署:将VIMA迁移到真实机器人上,验证其在实际操作中的有效性
- 与基础模型结合:探索将VIMA与更大的视觉-语言模型(如GPT-4V、Gemini)结合,利用其更强大的语义理解能力
- 在线学习:使VIMA能够在与环境交互的过程中持续学习和适应
- 多机器人协作:将多模态提示扩展到多机器人协作场景
📖 延伸阅读
- RT-1: Robotics Transformer for Real-World Control at Scale(arXiv:2212.06817)- Google的机器人Transformer,在大规模真实世界数据上训练,展示了Transformer架构在机器人控制中的潜力
- CLIPort: What and Where Pathways for Robotic Manipulation(arXiv:2109.12098)- 结合CLIP语义理解和空间推理的机器人操作方法,为多模态提示提供了重要参考
- Perceiver: General Perception with Iterative Attention(arXiv:2107.08090)- 通用感知架构,VIMA在消融实验中与其进行了对比