📄 论文信息
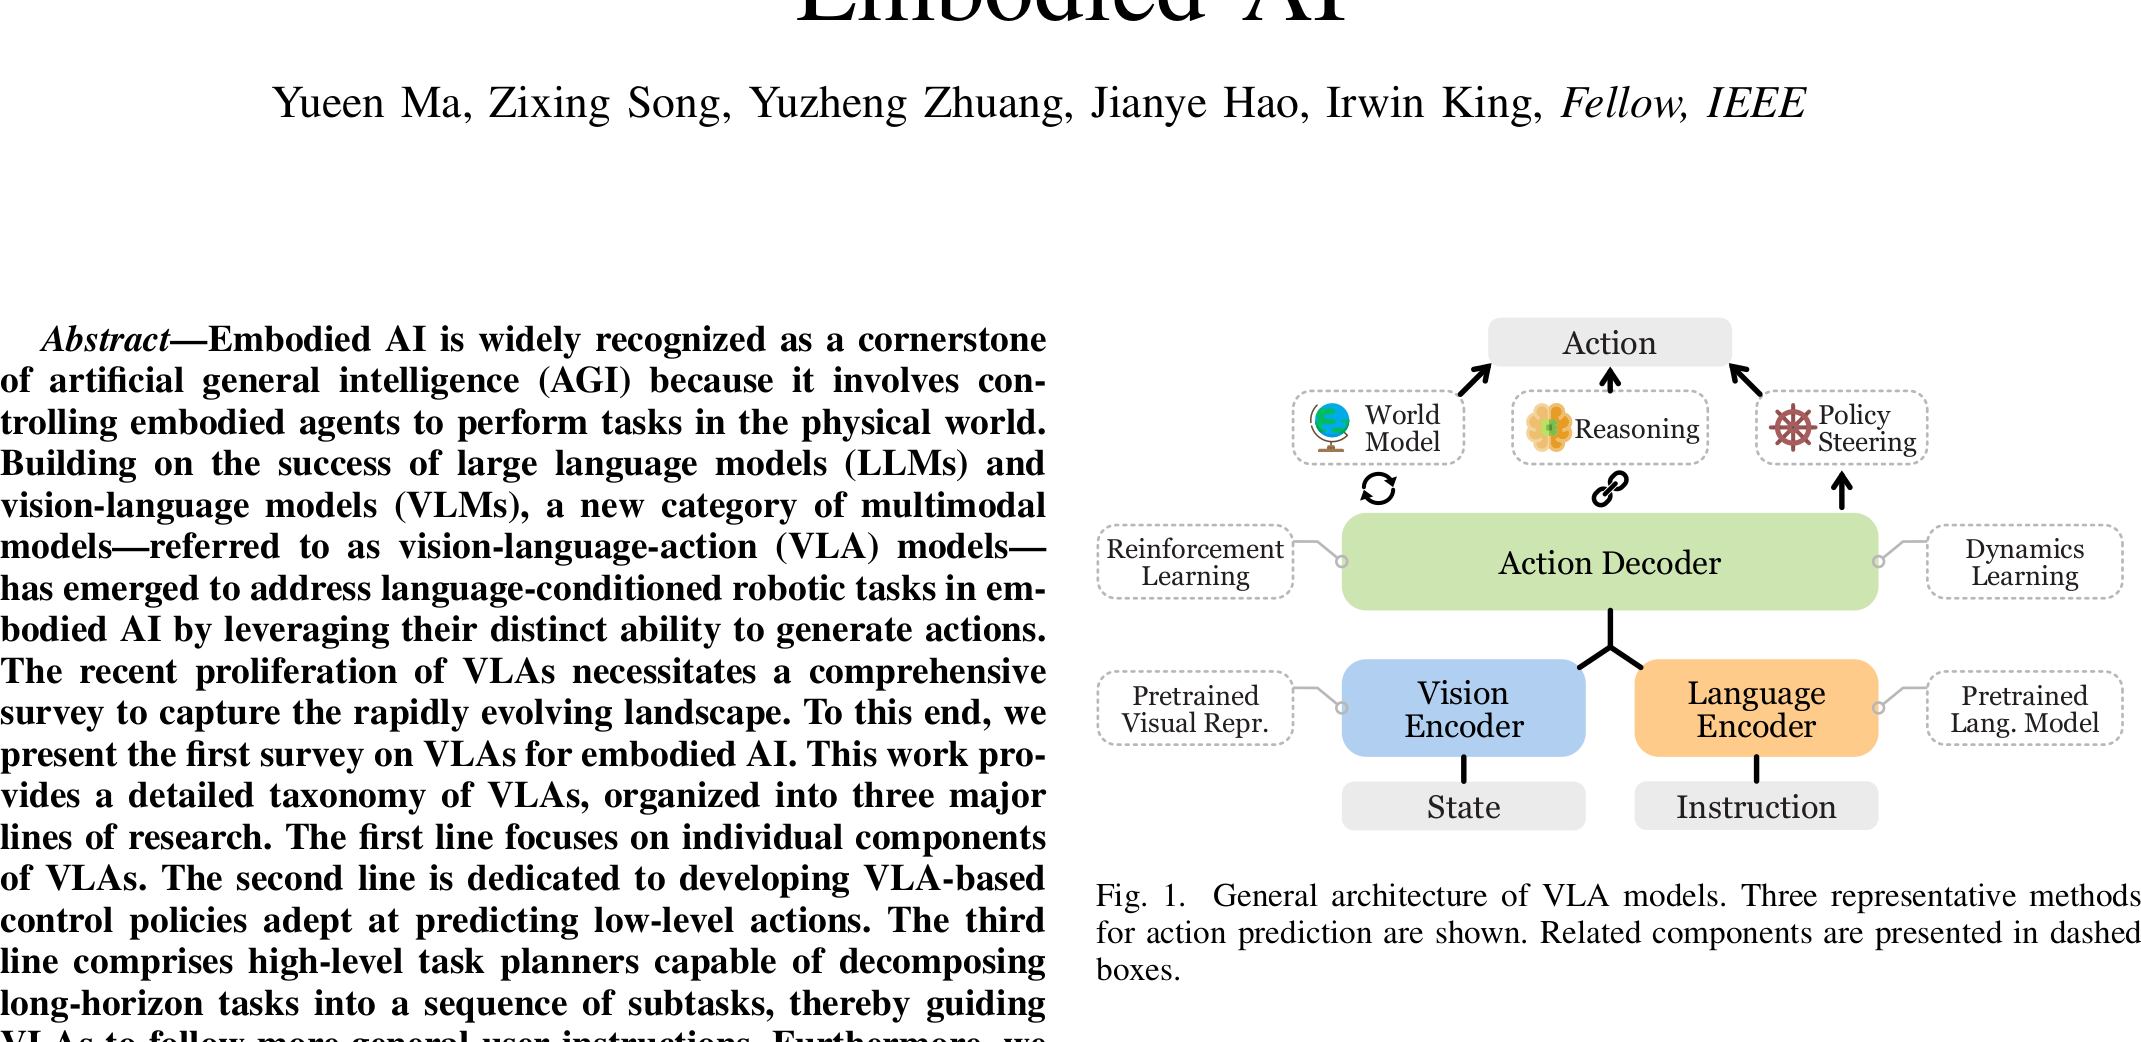 **图1: VLA模型通用架构**。视觉编码器提取预训练视觉表征(PVRs),LLM编码语言指令,通过Flamingo/BLIP-2/LLaVA三种策略对齐视觉-语言嵌入,最终由LLM作为解码器预测动作。虚线框内展示了三种代表性动作预测方法。
- 标题:A Survey on Vision-Language-Action Models for Embodied AI(具身智能视觉-语言-动作模型综述)
- 团队:香港中文大学(Yueen Ma, Irwin King)、布里斯托大学(Zixing Song)、华为诺亚方舟实验室(Yuzheng Zhuang, Jianye Hao)
- 发表:IEEE Transactions on Neural Networks and Learning Systems, 2025(arXiv:2405.14093v8)
- 关键词:视觉-语言-动作模型、具身智能、机器人学习、多模态模型、大语言模型
- 一句话总结:首篇全面综述VLA模型的文章,系统梳理了从组件到架构再到应用的技术全景,提出了三层分类体系(组件-控制策略-任务规划)。
- 论文链接:arXiv:2405.14093
- 代码仓库:Awesome-VLA
🤔 为什么需要这篇综述?
从对话式AI到行动式AI的跨越
具身智能(Embodied AI)被广泛认为是通向通用人工智能(AGI)的基石,因为它涉及控制具身智能体在物理世界中执行任务。与对话式AI不同,具身智能需要控制物理实体与环境交互,而机器人学是具身智能最突出的应用领域。
在语言条件化的机器人任务中,策略必须具备理解语言指令、视觉感知环境和生成适当动作的多模态能力。随着大语言模型(LLMs)和视觉-语言模型(VLMs)的成功,一种新的多模态模型类别——视觉-语言-动作(VLA)模型应运而生。VLA模型一词由RT-2首次提出,它利用VLMs的多模态能力来处理视觉、语言和动作三种模态的信息。
为什么需要这篇综述?
VLA模型近年来经历了爆发式增长,涉及的研究方向众多且相互交织:
组件研究多样化:从预训练视觉表征(PVRs)如CLIP、R3M、DINOv2,到世界模型(Dreamer系列、LLM诱导的世界模型),再到推理能力(CoT、ToT),每个方向都有大量工作。
控制策略创新频繁:从RT-1开创性地使用Transformer作为控制策略,到RT-2首次提出VLA概念,再到OpenVLA提供开源大规模VLA模型,以及Diffusion Policy引入扩散模型进行动作生成,技术路线快速演进。
任务规划方法多样:从SayCan的语言条件化规划,到Code as Policies的代码生成规划,再到ECoT的具身思维链推理,规划范式不断创新。
这种技术的多样性使得研究者难以全面把握VLA模型的发展脉络。本综述正是在这一背景下诞生的——作为首篇专门针对VLA模型的综述,它不仅填补了领域空白,更为研究者提供了理解VLA模型全貌的系统框架。
📚 综述覆盖范围
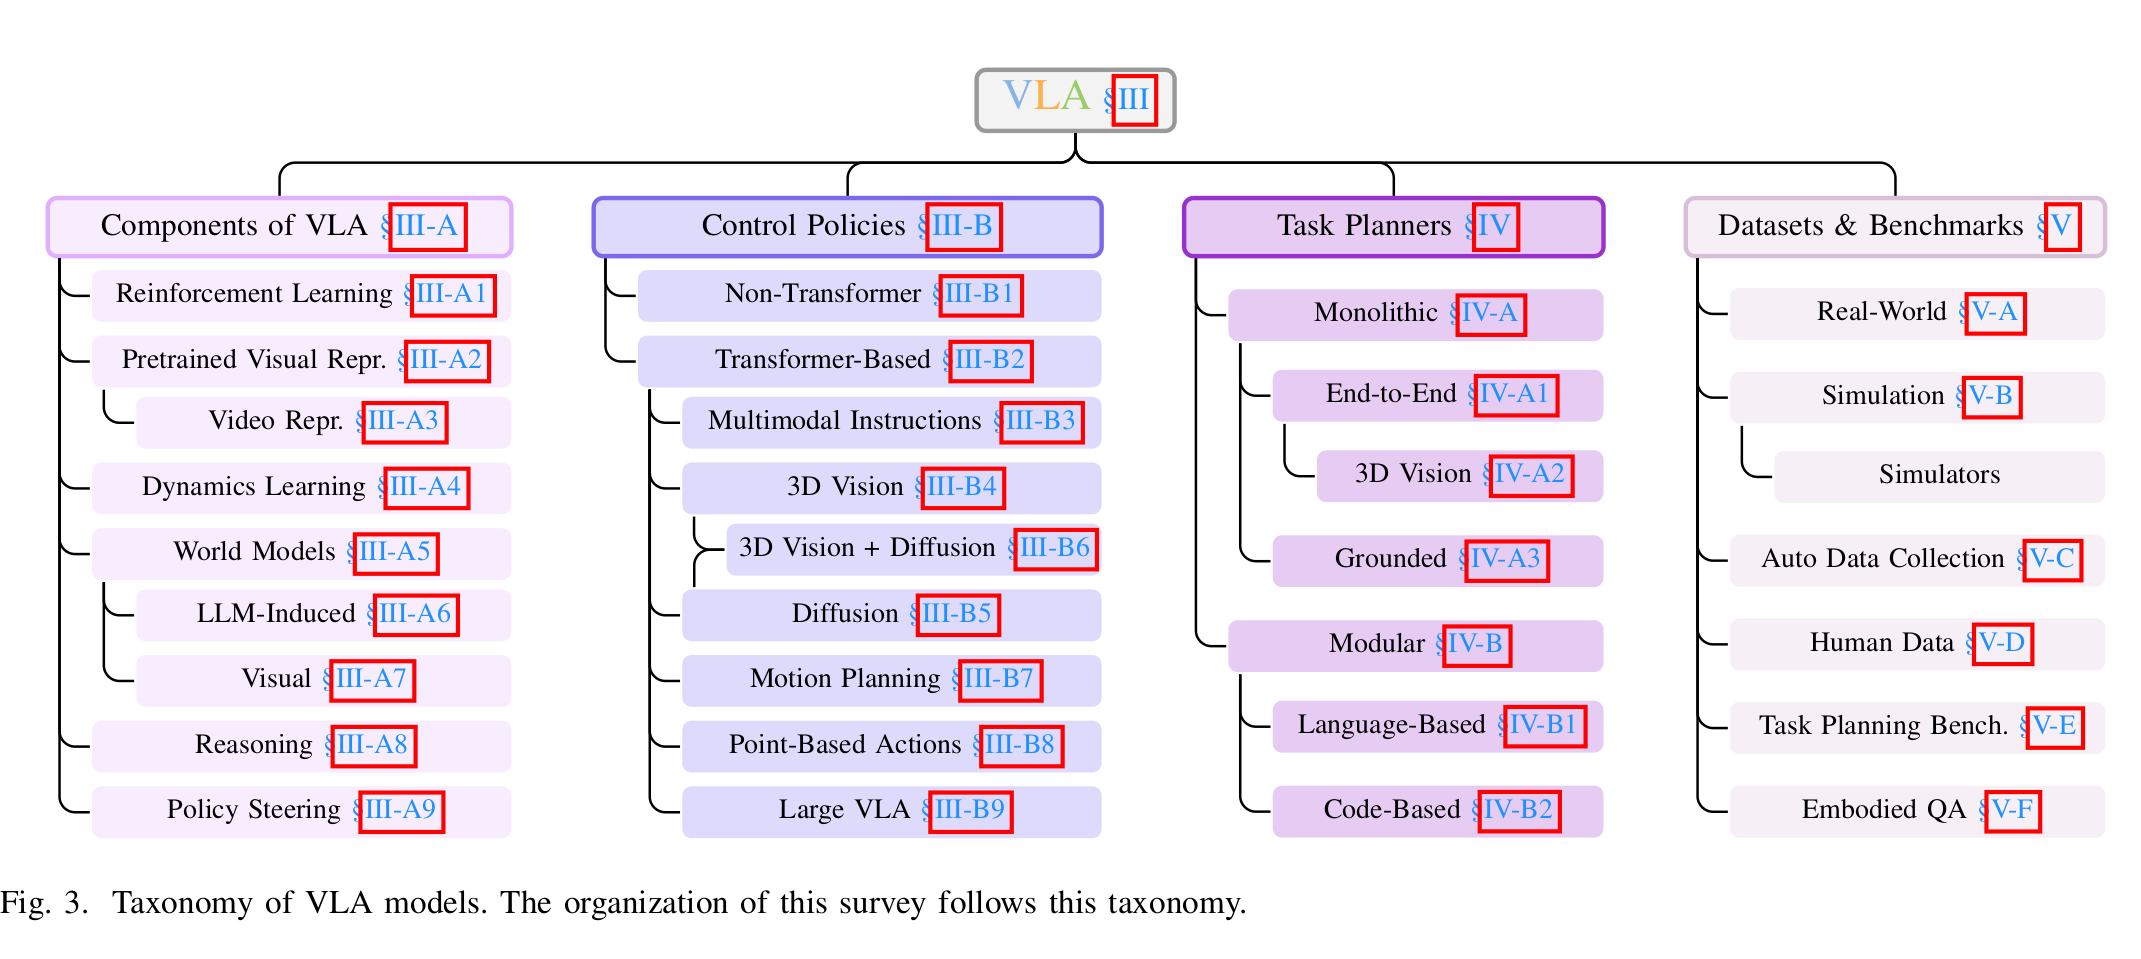 **图3: VLA模型分类体系**。综述提出的三层分类树:组件研究(RL/PVRs/世界模型/推理)→低级控制策略(Transformer/扩散/大型VLA)→高级任务规划(端到端/模块化)。整篇综述的章节组织即遵循此分类体系。
第一部分:VLA模型的核心组件
综述首先深入分析了VLA模型的各个核心组件,这些组件构成了VLA模型的技术基础:
1. 强化学习(RL)基础
RL为具身智能奠定了基础,并持续推动VLA模型的发展:
- DQN:首次展示了直接从高维像素输入学习策略的可能性,强调了端到端RL中模型容量的重要性
- Decision Transformer(DT):将RL轨迹建模为序列问题,自然适配Transformer架构
- Trajectory Transformer(TT):进一步探索了Transformer在轨迹建模中的潜力
- Gato:将这一范式扩展到多模态、多任务、多具身设置
- RL与LLM的协同:RLHF将LLMs与人类偏好对齐,也应用于机器人学习;SEED利用RLHF和基于技能的RL解决稀疏奖励问题;Reflexion提出语言RL框架,用语言反馈替代权重更新;Eureka展示LLMs可以设计出超越人类专家的奖励函数
2. 预训练视觉表征(PVRs)
视觉编码器的性能直接影响VLA模型的表现,因为它提供了关于当前状态的关键信息。综述详细比较了多种PVR方法:
| 模型 | 网络 | 类型 | 核心思想 | 适用任务 |
|---|---|---|---|---|
| CLIP | ViT-B | 视觉-语言对比学习 | 在4亿图像-文本对上预训练,识别正确的图文对 | 被CLIPort、EmbCLIP等广泛使用 |
| R3M | ResNet-50 | 时间对比学习 | 最小化时序相近帧的距离,增远时序远离帧的距离 | Meta-World、Franka Kitchen |
| MVP | ViT-B/L | MAE | 将掩码自编码器应用于机器人数据集 | xArm7抓取、推 cube |
| VIP | ResNet-50 | 时间对比学习 | 利用视频时序关系,引入折扣因子 | Franka抓放、折叠毛巾 |
| VC-1 | ViT-L | MAE+CL | 系统探索不同ViT配置在多种数据集上的最优组合 | Meta-World、Habitat |
| DINOv2 | ViT | 自蒸馏 | 教师-学生网络匹配不同视图的编码表示 | 被OpenVLA、ReKep使用 |
| I-JEPA | ViT | JEPA | 基于联合嵌入预测架构,构建"原始"内部世界模型 | - |
| Theia | ViT-T/S/B | 蒸馏 | 将多种视觉基础模型(ViT、CLIP、SAM、DINOv2、Depth-Anything)蒸馏到单一模型 | CortexBench |
3. 动力学学习
动力学学习包括前向动力学(预测下一状态)和逆向动力学(预测动作):
前向动力学:$\hat{s}_{t+1} \leftarrow f_{\text{fwd}}(s_t, a_t)$
逆向动力学:$\hat{a}_t \leftarrow f_{\text{inv}}(s_t, s_{t+1})$
代表性方法包括:
- Vi-PRoM:提出三种预训练目标——对比自监督、时序动力学、伪标签分类
- MIDAS:引入逆动力学预测任务作为预训练,训练模型从观测预测动作
- SMART:结合前向动力学、逆向动力学和随机掩码事后控制三个目标
- MaskDP:掩码决策预测,同时掩码状态和动作token进行重建
- PACT:建模状态-动作转移,自回归预测每个状态和动作token
- VPT:利用无标签互联网数据预训练Minecraft基础模型
- GR-1:为GPT式模型引入视频预测预训练
4. 世界模型
世界模型 $P(\cdot)$ 编码了关于世界的常识知识,能够预测给定动作的未来状态:
$$\hat{s}_{t+1} \sim P(s_{t+1} | s_t, a_t)$$Dreamer系列:
- Dreamer:使用表示模型、转移模型和奖励模型构建潜在动力学模型
- DreamerV2:引入离散潜在状态空间和改进目标
- DreamerV3:扩展到更广泛的领域,使用固定超参数
- DayDreamer:将方法应用于真实世界机器人任务
LLM诱导的世界模型:
- DECKARD:提示LLM生成抽象世界模型(有向无环图),用于Minecraft物品合成
- LLM-DM:使用LLM构建PDDL格式的世界模型,LLM还作为接口连接生成的PDDL模型和纠正反馈
- RAP:将LLM重新用作策略和世界模型,结合蒙特卡洛树搜索(MCTS)进行结构化规划
- LLM-MCTS:扩展到POMDP设置,LLM生成当前状态的初始信念并指导动作选择
视觉世界模型:
- IRIS:使用GPT式自回归Transformer作为世界模型基础,VQ-VAE作为视觉编码器
- TWM:探索Transformer在构建世界模型中的应用
5. 推理能力
VLA模型中的推理研究包括:
- 思维链(CoT):逐步推理,将复杂问题分解为子步骤
- 思维树(ToT):将推理过程组织为树结构,探索多条推理路径
- ECoT(Embodied Chain-of-Thought):将思维链推理引入具身场景
- 具身推理框架:专门针对机器人任务设计的推理方法
6. 策略引导
策略引导研究如何利用LLMs的常识知识来指导机器人策略:
- 语言条件化:将语言指令作为策略的条件输入
- 技能发现:利用LLMs自动发现和组合基本技能
- 任务分解:将复杂任务分解为可执行的子任务序列
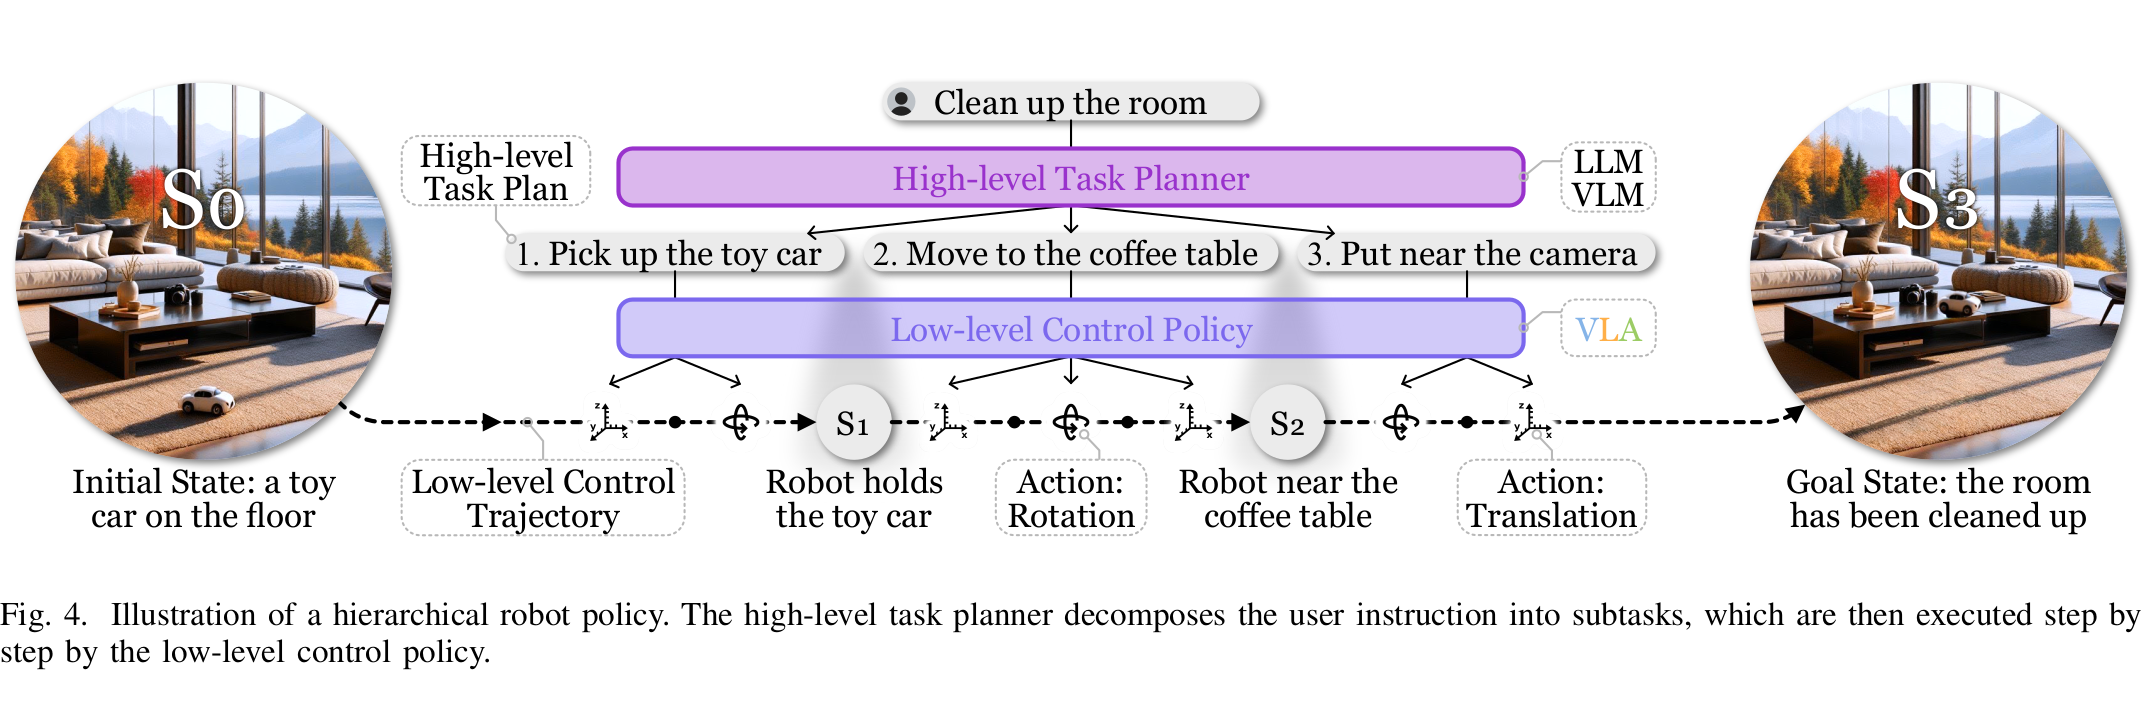 **图4: 分层机器人策略示意图**。高级任务规划器将用户指令分解为子任务序列,低级控制策略逐步执行每个子动作。当前机器人系统普遍采用这种分层框架——高层利用大容量模型进行推理规划,底层专注于速度和精度。
第二部分:低级控制策略
控制策略负责将语言指令和视觉观察转换为低级动作。综述将其分为多个子类别:
1. Transformer控制策略
- RT-1(Google, 2022):开创性地使用Transformer作为控制策略,在13万+真实机器人轨迹上训练,展示了scaling law
- RT-2(Google, 2023):首次提出VLA概念,将VLM适配到机器人任务,将网络知识迁移到机器人控制
- OpenVLA(Stanford, 2024):提供开源的大规模VLA模型,推动VLA技术的民主化
- Octo(UC Berkeley, 2024):开源通用机器人策略,支持多任务学习
2. 扩散策略
- Diffusion Policy(MIT, 2023):引入扩散模型进行动作生成,天然支持多模态动作分布
- 3D Diffusion Policy:利用3D视觉信息增强扩散策略
- Diffusion Policy with 3D Vision:结合3D点云和扩散模型
3. 大型VLA模型
- PaLM-E(Google, 2023):将PaLM与视觉嵌入结合,实现具身多模态理解
- CaP(Code as Policies):将代码生成作为动作预测的方式
- π₀(Physical Intelligence, 2024):基于Flow Matching的通用VLA模型
- SmolVLA(Hugging Face, 2025):轻量级VLA模型,支持语言条件控制
4. 动作类型与训练目标
综述详细比较了不同动作类型及其训练目标:
- 离散动作:将连续动作离散化为token(如RT系列)
- 连续动作:直接回归连续动作值
- 扩散动作:通过扩散过程生成动作序列
- 动作块(Action Chunk):预测未来多步动作的序列
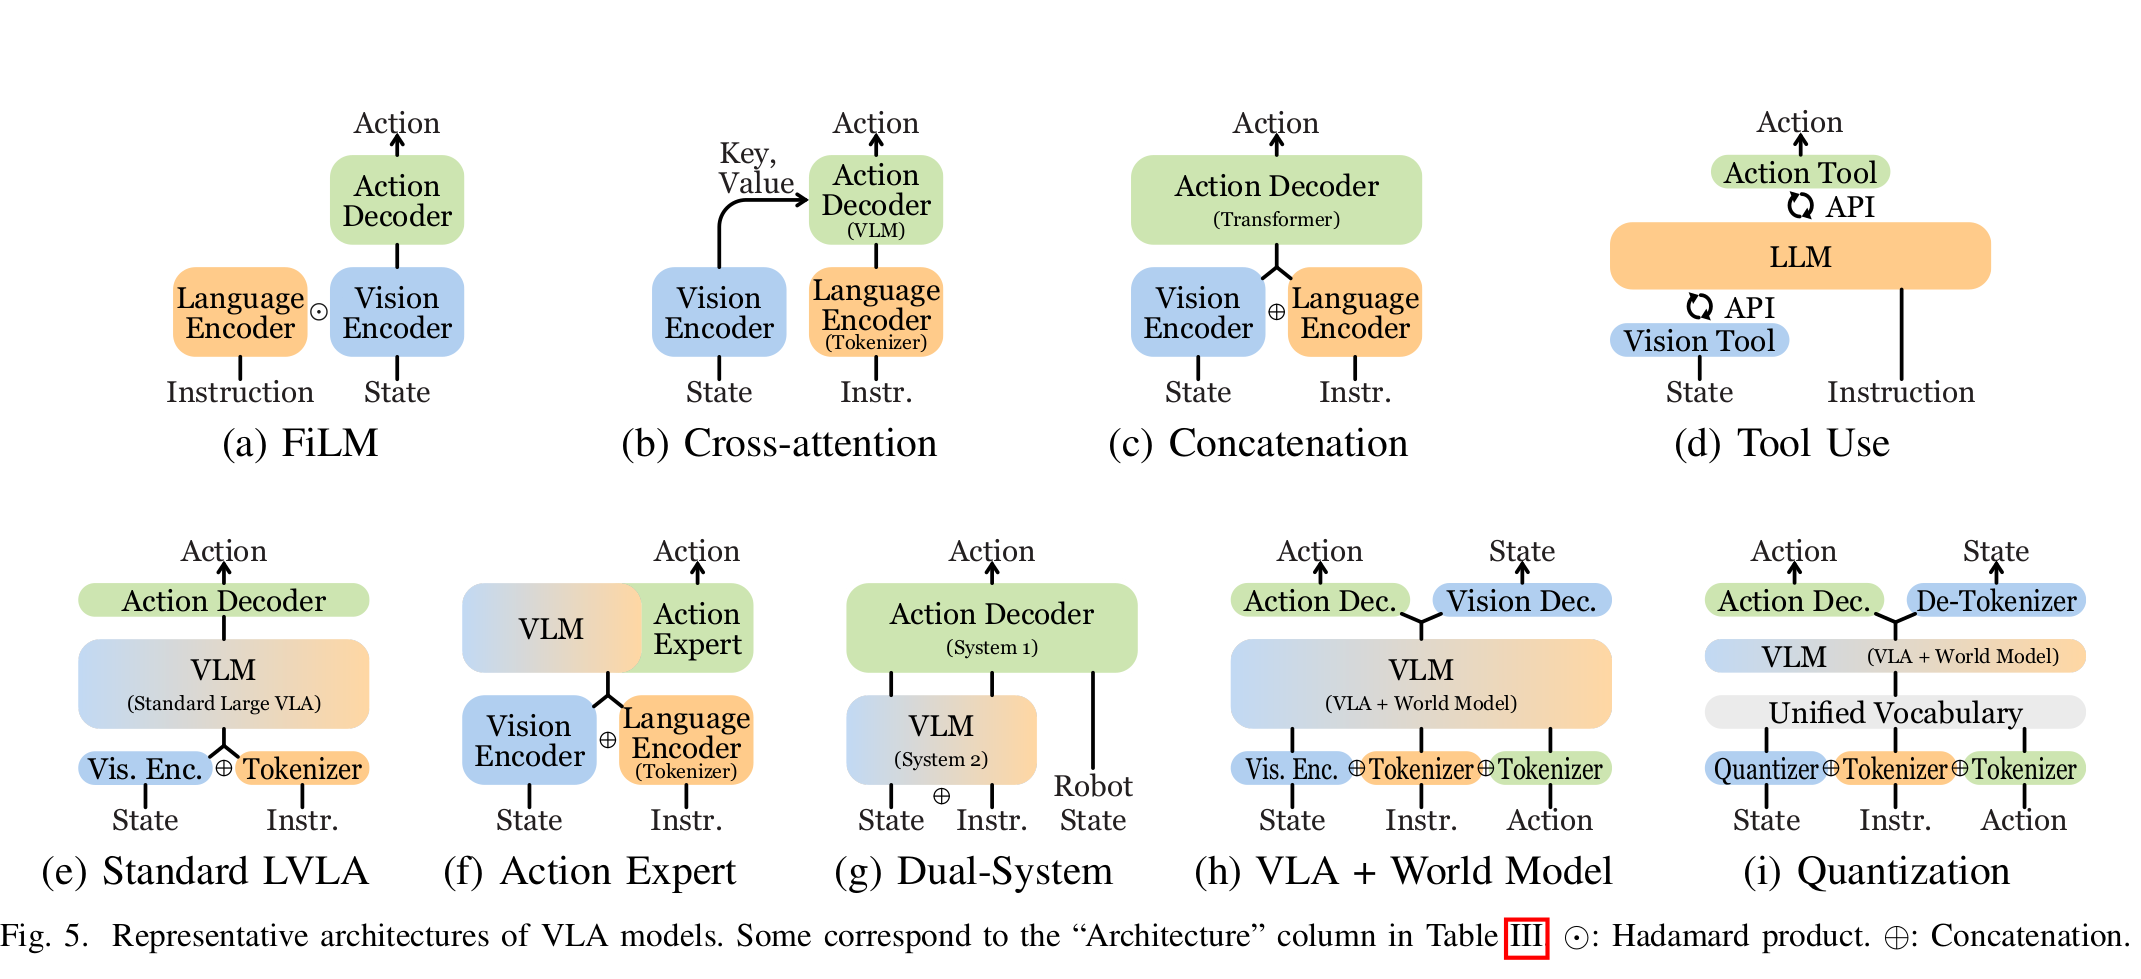 **图5: VLA模型9种代表性架构**。(a)FiLM(特征线性调制) (b)交叉注意力 (c)拼接融合 (d)工具使用 (e)标准大型VLA (f)动作专家 (g)双系统推理 (h)VLA+世界模型 (i)量化方法。每种架构对应不同的视觉-语言融合策略和动作输出方式。
第三部分:高级任务规划
任务规划器负责将长期任务分解为子任务序列,引导VLA模型完成更复杂的用户指令:
1. 端到端任务规划
直接从原始输入预测动作序列的方法,无需显式的任务分解步骤。
2. 模块化任务规划
基于语言的任务规划:
- SayCan(Google, 2022):利用LLMs的常识知识和机器人技能的可行性来规划任务
- Inner Monologue:通过内心独白进行任务规划
- DEPS:描述、解释、规划和选择的多步规划框架
基于代码的任务规划:
- ProgPrompt:将任务规划转化为代码生成问题
- Code as Policies:直接生成可执行的代码来控制机器人
- VoxPoser:利用LLMs和VLMs生成3D值函数来规划操作
3. 具身推理
- ECoT(Embodied Chain-of-Thought):将思维链推理引入具身场景
- AR2:自回归具身推理框架
- Reasoning with World Models:利用世界模型进行具身推理
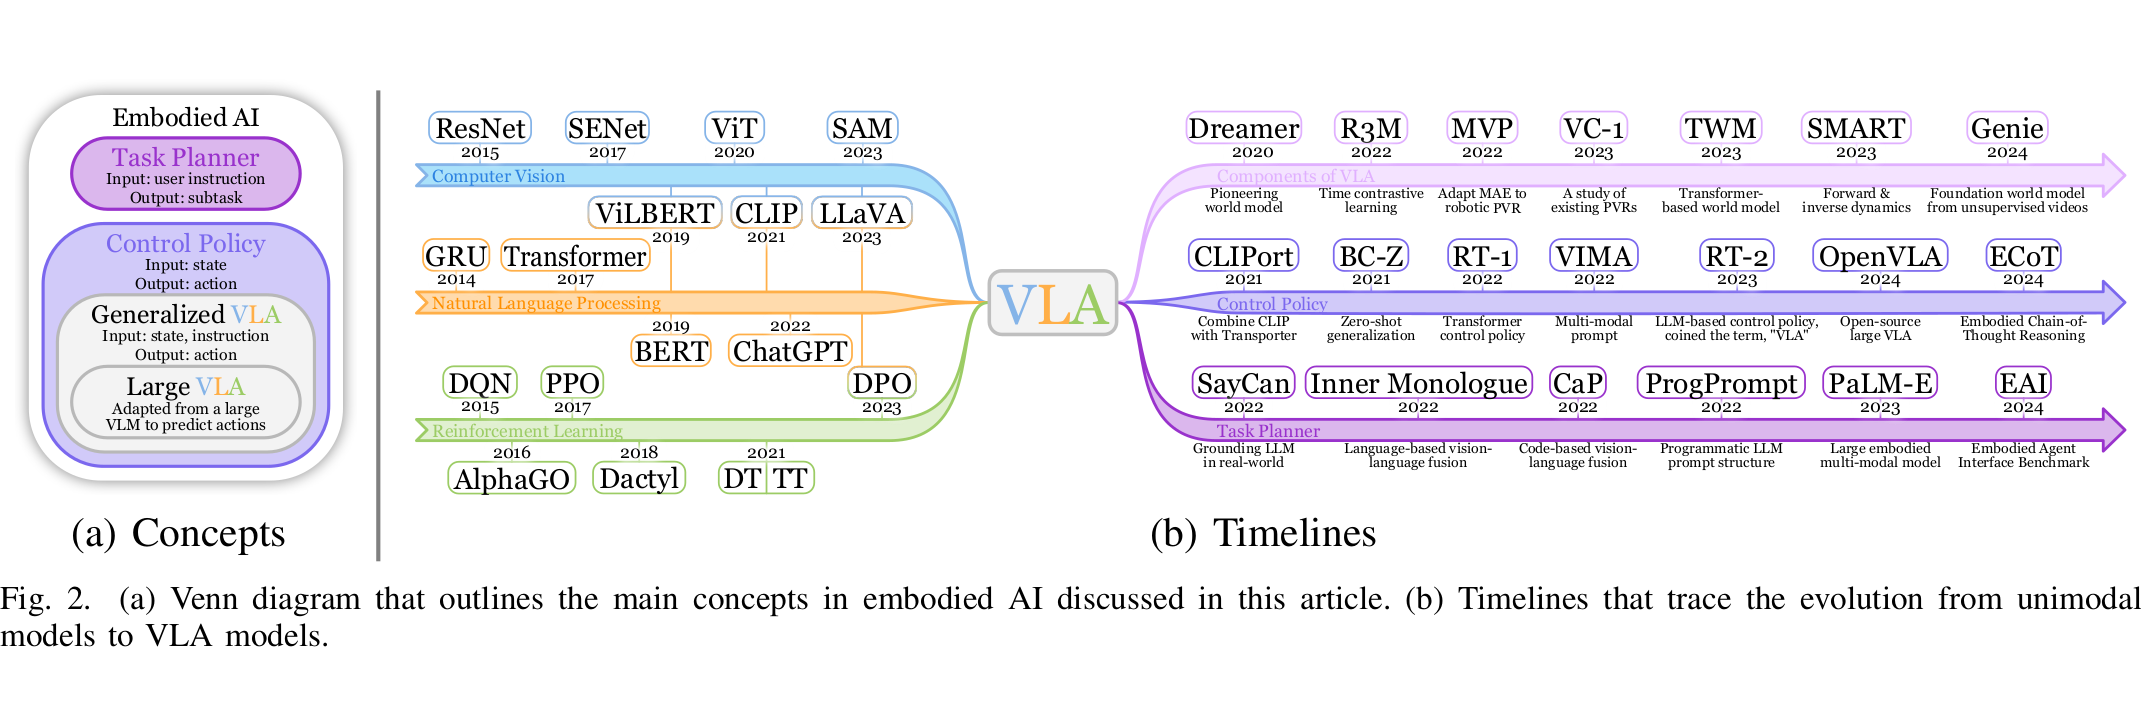 **图2: VLA模型概念图与时间线**。(a)文氏图展示了具身AI的核心概念:视觉(Vision)、语言(Language)和机器人(Robotics)的交集构成VLA研究的完整版图。(b)时间线梳理了从单模态模型→视觉-语言模型→VLA模型的演进脉络。
🗺️ 技术路线图
本综述提出了一个清晰的VLA模型分类体系,基于当前机器人系统的层级框架:
VLA模型分类体系:
组件研究
- 强化学习(DQN, DT, TT, Gato, RLHF)
- 预训练视觉表征(PVRs):CLIP(对比学习)、R3M(时间对比学习)、MVP(MAE)、VC-1(系统探索)、DINOv2(自蒸馏)、I-JEPA(联合嵌入预测)、Theia(多模型蒸馏)
- 视频表征(NeRF, 3D-GS)
- 动力学学习:前向动力学(预测下一状态)、逆向动力学(预测动作)
- 世界模型:Dreamer系列(潜在动力学)、LLM诱导的世界模型(DECKARD, LLM-DM, RAP)、视觉世界模型(IRIS, TWM)
- 推理能力(CoT, ToT, ECoT)
- 策略引导
低级控制策略
- 非Transformer控制策略(CNN, RNN)
- Transformer控制策略(RT-1, RT-2, OpenVLA, Octo)
- 多模态指令控制策略
- 3D视觉控制策略
- 扩散策略(Diffusion Policy, 3D Diffusion Policy)
- 大型VLA模型(PaLM-E, CaP, π₀, SmolVLA)
高级任务规划
- 单体任务规划:端到端任务规划、3D视觉端到端任务规划、具身任务规划(Grounded Task Planners)
- 模块化任务规划:基于语言的任务规划(SayCan, Inner Monologue, DEPS)、基于代码的任务规划(ProgPrompt, Code as Policies, VoxPoser)
这种分类体系体现了当前机器人系统的层级框架:高级任务规划器利用大容量模型进行任务分解,低级控制策略专注于速度和精度,形成类似于层级强化学习的架构。
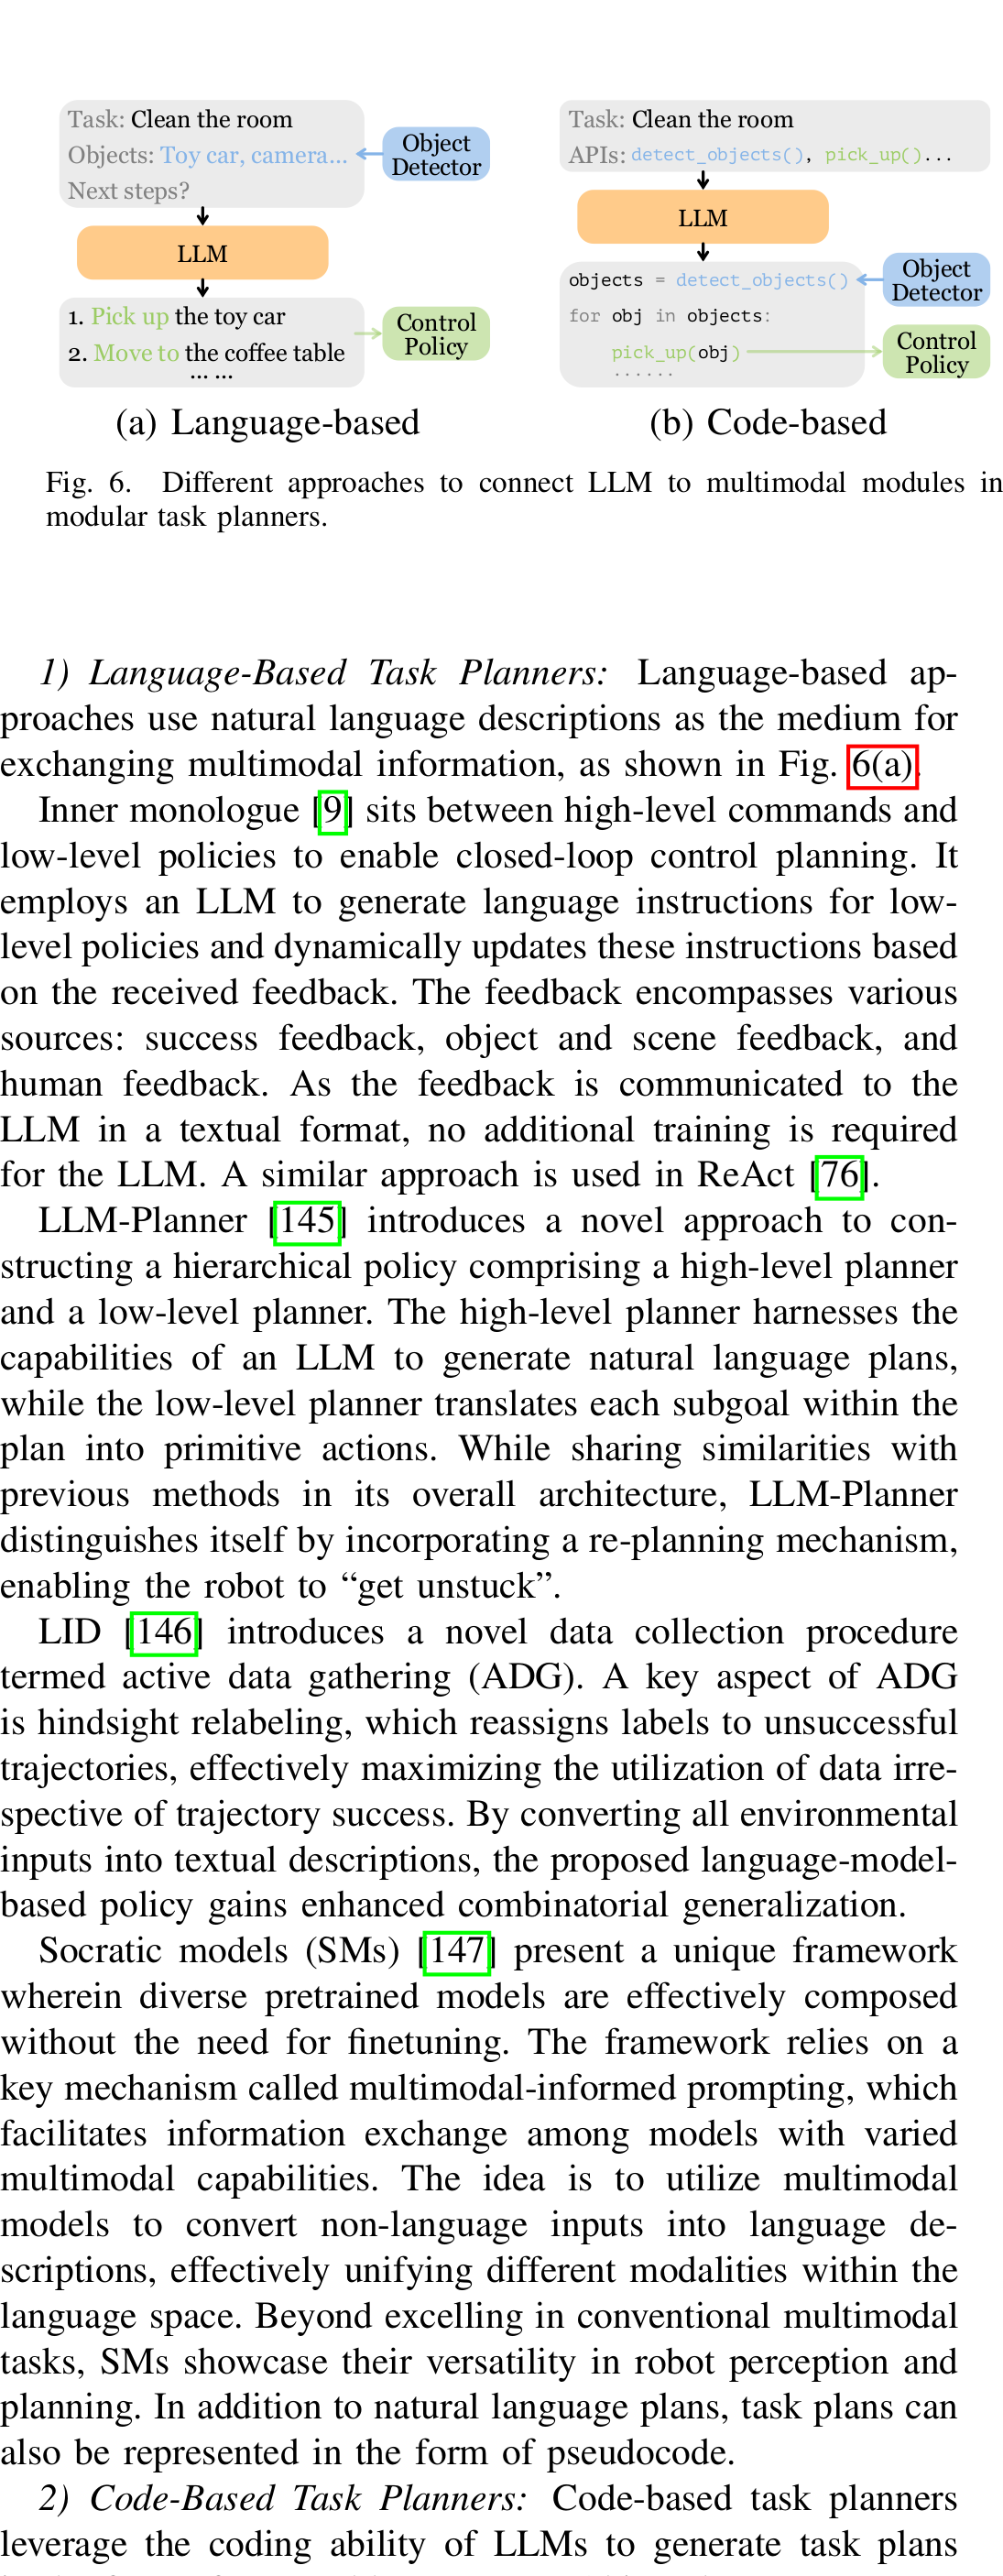 **图6: 任务规划方法对比**。(a)单体任务规划器:直接从原始输入端到端预测动作序列,无需显式任务分解。(b)模块化任务规划器:通过语言(如SayCan)或代码(如Code as Policies)将长期任务分解为子任务序列,再交由低级控制策略执行。
📊 关键论文对比表
| 模型 | 团队 | 年份 | 核心架构 | 动作类型 | 特点 |
|---|---|---|---|---|---|
| RT-1 | 2022 | EfficientNet+Transformer | 离散token | 首个大规模机器人Transformer | |
| RT-2 | 2023 | VLM→VLA | 离散token | 首次提出VLA概念 | |
| OpenVLA | Stanford | 2024 | Prismatic VLM | 离散token | 开源大规模VLA |
| Diffusion Policy | MIT | 2023 | CNN/Transformer+扩散 | 扩散采样 | 多模态动作分布 |
| PaLM-E | 2023 | PaLM+视觉嵌入 | 连续回归 | 具身多模态理解 | |
| π₀ | Physical Intelligence | 2024 | VLM+Flow Matching | Flow Matching | 通用VLA模型 |
| SmolVLA | Hugging Face | 2025 | 轻量级VLM | Flow Matching | 轻量高效 |
| SayCan | 2022 | LLM+可行性 | - | 语言条件化规划 | |
| Code as Policies | 2022 | LLM→代码 | - | 代码生成规划 | |
| ECoT | - | 2023 | LLM+思维链 | - | 具身推理 |
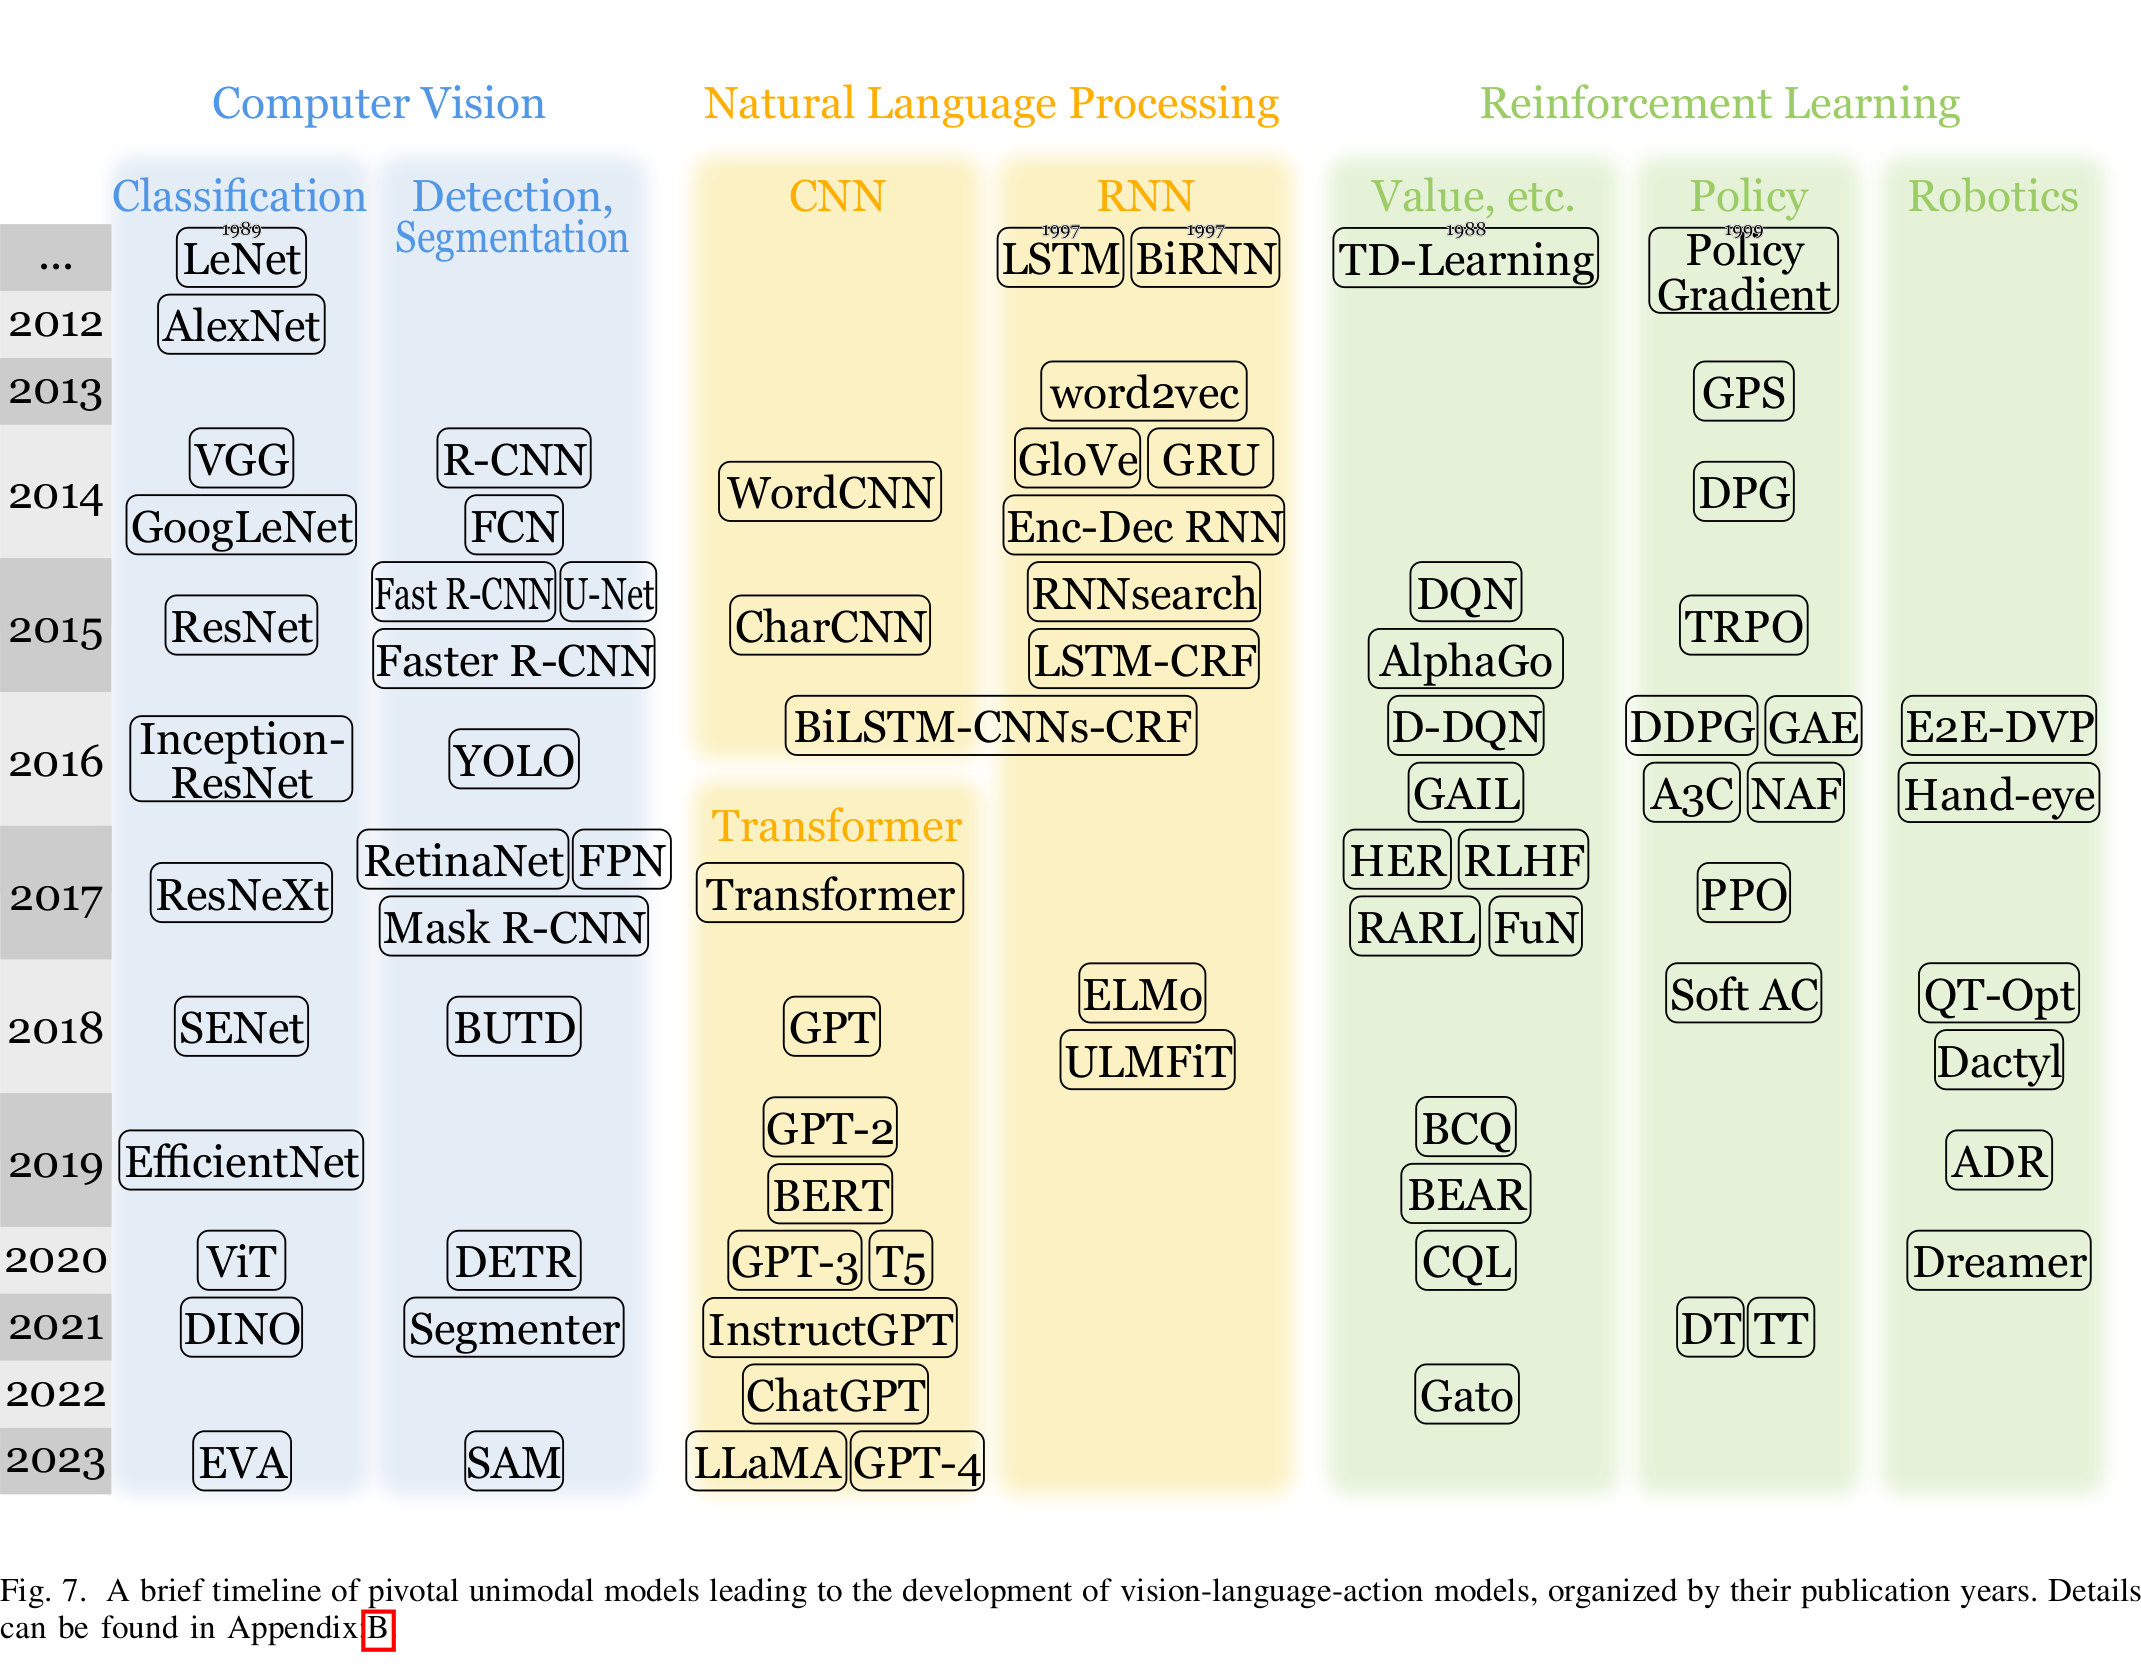 **图7: 关键单模态模型时间线**。从AlexNet、RNN、DQN到Transformer、GPT系列、CLIP,展示了推动VLA模型发展的基础技术演进。底部标注了各模型对VLA发展的贡献方向(NLP/CV/RL/Multimodal)。
🔍 个人思考
综述的亮点
1. 首创性与全面性:作为首篇VLA模型综述,本工作填补了领域空白。它不仅涵盖了组件研究(PVRs、动力学、世界模型、推理),还包括控制策略(Transformer、扩散、大型VLA)和任务规划(语言、代码、具身推理),形成了完整的技术图谱。
2. 清晰的三层分类体系:综述提出的分类体系(组件-控制策略-任务规划)逻辑清晰,与当前机器人系统的实际架构高度契合。高级规划器利用大容量模型进行任务分解,低级控制策略专注于速度和精度,这种层级结构为研究者提供了明确的导航框架。
3. 丰富的资源汇总:综述详细总结了训练和评估VLA模型所需的数据集、仿真器和基准测试,包括真实世界机器人数据集(Open X-Embodiment、DROID)、仿真环境(LIBERO、Meta-World、Habitat)和任务规划基准,为后续研究提供了宝贵的资源目录。
4. 深入的组件分析:综述对每个核心组件都进行了深入分析,包括PVRs的训练目标对比、动力学学习的前向/逆向对比、世界模型的LLM诱导vs视觉生成对比,帮助研究者理解各组件的技术细节和适用场景。
不足之处
1. 实验对比的缺失:作为综述文章,本文主要进行文献梳理和分类,缺乏对不同VLA模型在统一基准上的系统性实验对比,使得读者难以直观判断各方法的优劣。
2. 实际部署挑战的深度不足:虽然综述提到了安全性和实时响应等挑战,但对实际部署中面临的工程问题(如模型压缩、延迟优化、硬件适配)的讨论相对有限。
3. 跨领域应用的覆盖不均:综述主要聚焦于机器人操作和导航,对自动驾驶、医疗机器人等其他具身智能应用场景的覆盖相对较少。
对领域的启发
本综述揭示了VLA模型发展的几个关键趋势:
从专用到通用:VLA模型正从处理特定任务的专用模型(如RT-1)向能够执行多种任务的通用模型(如RT-2、OpenVLA)演进,这与LLM和VLM的发展路径一致。
端到端学习的兴起:越来越多的研究倾向于端到端学习,减少手工设计的模块,这可能简化系统架构并提高性能。
安全与对齐的重要性:随着VLA模型在物理世界中的应用,安全性和与人类意图的对齐变得至关重要,这需要新的技术方案(如RLHF、安全约束RL)。
数据稀缺的挑战:高质量机器人数据的获取仍然是主要瓶颈,自动数据收集和模拟数据的利用成为重要研究方向。
开源生态的形成:OpenVLA、Octo、LeRobot等开源项目的出现,正在推动VLA技术的民主化,降低研究门槛。
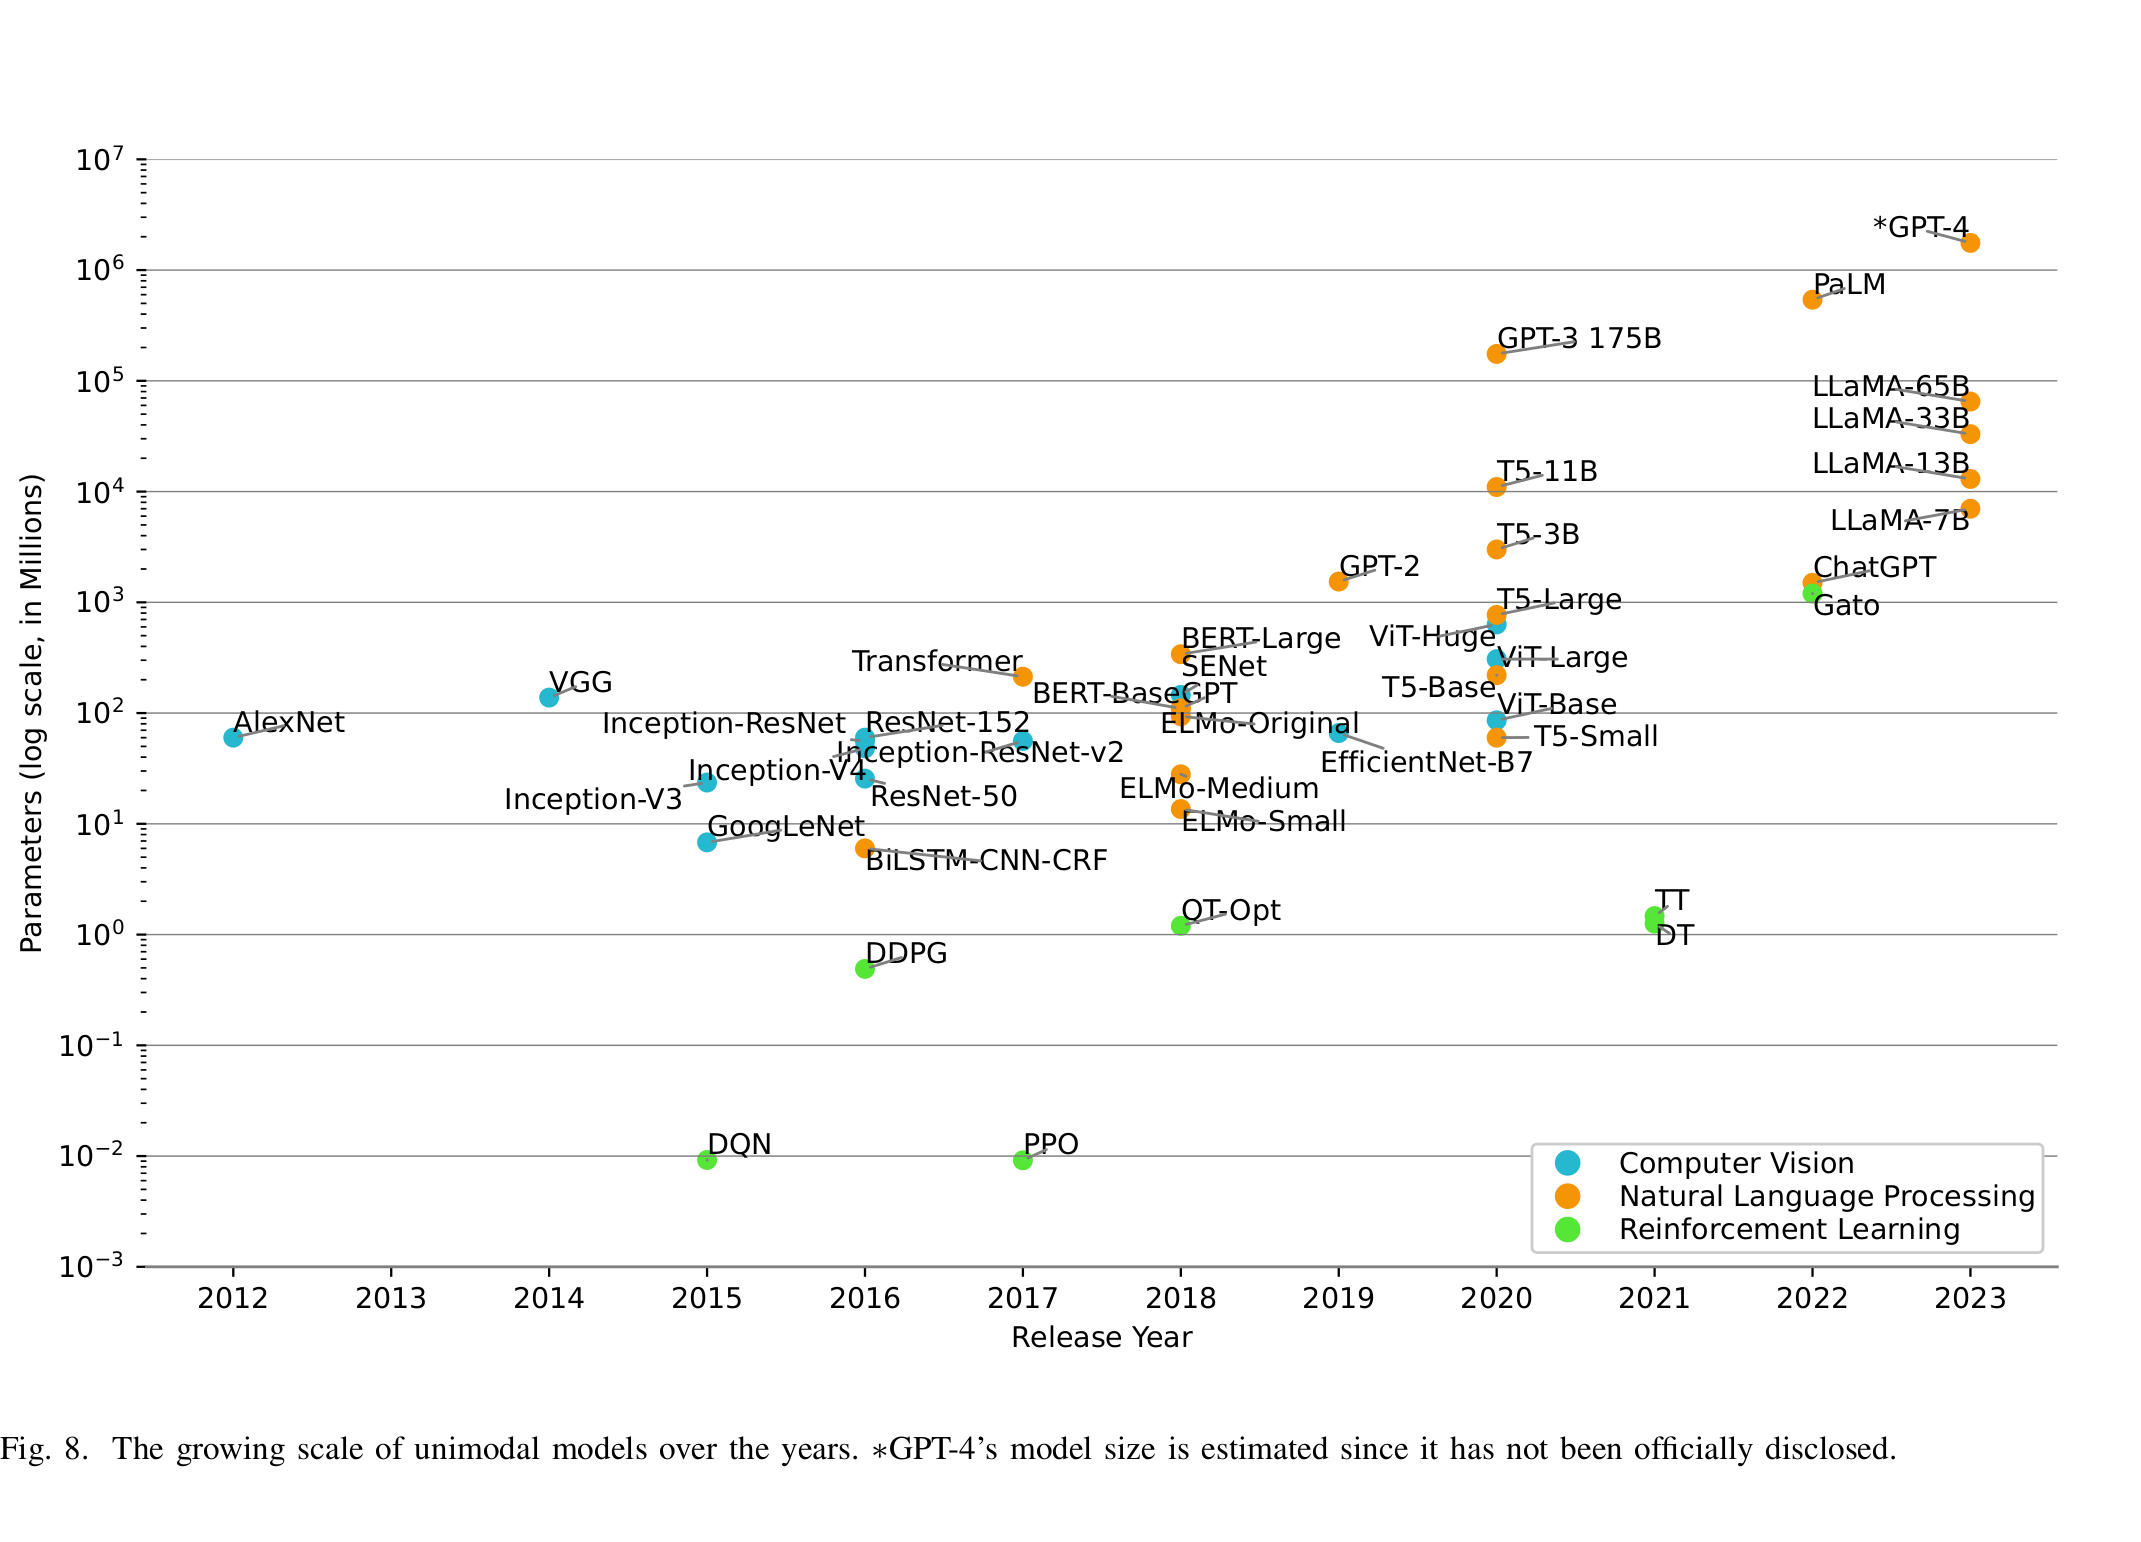 **图8: 单模态模型规模增长趋势**。展示了CV/NLP/RL三大领域模型参数量的增长曲线。GPT-4等大模型的出现为VLA提供了强大的基础能力,但同时也带来了计算开销和数据需求等挑战。
📖 延伸阅读
RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control(Brohan et al., 2023)- 首次提出VLA概念,将网络知识迁移到机器人控制,是VLA模型的奠基之作
OpenVLA: An Open-Source Vision-Language-Action Model(Kim et al., 2024)- 开源的大规模VLA模型,推动了VLA技术的民主化,基于Prismatic VLM架构
Diffusion Policy: Visuomotor Policy Learning via Action Diffusion(Chi et al., 2023)- 将扩散模型引入机器人控制,开创了扩散策略范式,在多模态动作分布建模方面表现出色
SayCan: Do As I Can, Not As I Say: Grounding Language in Robotic Affordances(Ahn et al., 2022)- 利用LLMs的常识知识和机器人技能可行性进行任务规划,是模块化任务规划的经典之作