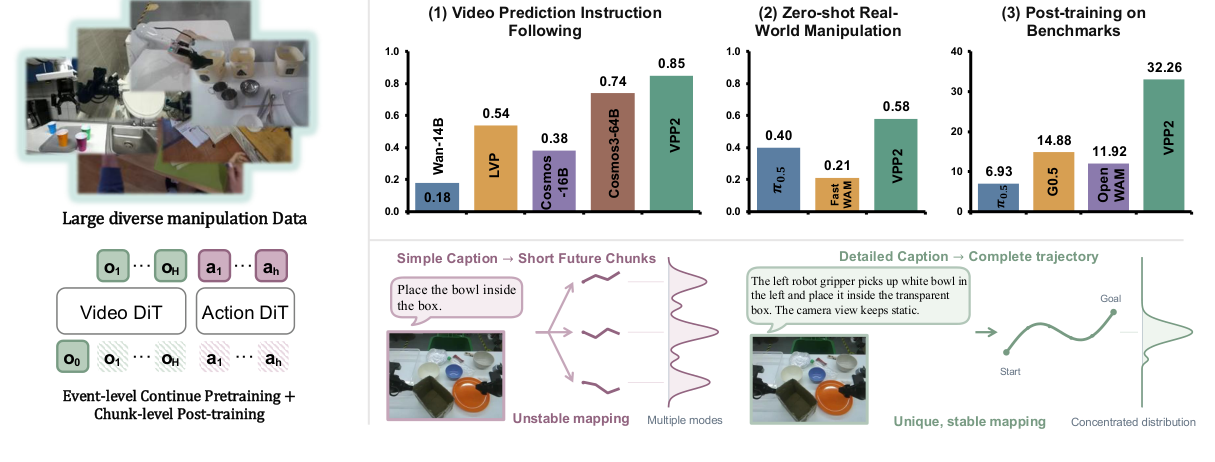
图 1 逐图讲解:这是全文的方法+成果总览,分左、右上、右下三块。左侧是动机与架构缩影:上方拼贴画代表「大规模、多样化的操作数据」(桌面、厨房、工位、人手、机器人混杂);下方是 VPP2 的两流结构——Video DiT 吃观测序列(o₀ 为条件帧,o₁…o_H 为待生成的未来块),Action DiT 吃动作块(a₁…a_h),下方标注「事件级继续预训练 + 块级后训练」。右上三张柱状图是三个层面的成绩单:(1) 视频预测指令跟随成功率——VPP2 的 0.85 超过 Cosmos3-64B 的 0.74 与 LVP 的 0.54;(2) 真机 ALOHA 零样本——VPP2 0.58 对 π0.5 的 0.40、FastWAM 的 0.21;(3) 基准后训练——RoboDojo 平均分 VPP2 32.26,远超 GO.5 的 14.88 与 OpenWAM-α 的 11.92。右下是全文论点的视觉化:左半「简单 caption → 短未来块」——一句 “Place the bowl inside the box.” 对应无数条可能轨迹(多峰、不稳定映射,右侧紫色密度曲线又宽又散);右半「详细 caption → 完整轨迹」——一句写明左夹爪、不锈钢杯、左边、最左黄色盒子的长 caption,把未来压成单条绿色平滑轨迹(唯一、稳定映射,密度曲线收敛成单峰)。这张图同时回答了「做了什么」和「为什么有效」。
配图说明:本文收录论文全部 10 张插图(Figure 1 ~ Figure 10),放在站内 /images/vpp2/,逐张讲解,文末附图表总索引表。论文来自 Robotera、清华大学、香港科技大学(广州)、UC Berkeley、上海交通大学,arXiv 2610.10270(v3,2026-10-13)。
📄 论文信息
- 标题:Video Prediction Policy 2: Predict Better, Act Better
- 机构:Robotera(一作单位)、清华大学、香港科技大学(广州)、UC Berkeley、上海交通大学
- 时间:2026-10(arXiv 2610.10270 v3)
- 关键词:世界行动模型(WAM)、事件级视频预训练、详细 caption、一致性蒸馏、单步视觉规划、MoT 动作专家、VLM 子任务规划
- 一句话总结:现有 WAM 的问题不是动作头不够强,而是视频预测本身不够准——基础视频模型不是为操作任务训练的,硬塞进动作模块又会破坏它的泛化。VPP2 的解法是「先把视频预测练到既听话又确定,再把它冻住/轻调,最后只学一个 0.9B 的逆动力学动作专家」。
🔗 开源情况(2026-10 更新)
代码与视频模型权重均已放出,是目前少数「视频底座 + 训练配方」全公开的 WAM:
| 资源 | 链接 | 说明 |
|---|---|---|
| 代码仓库 | github.com/roboterax/video-prediction-policy-2 | 含零样视频预测、LIBERO/RoboDojo 后训练与评测脚本 |
| 视频模型权重(Hugging Face) | huggingface.co/Haodong082399/VPP2 | Stage-1(49 帧)与 Stage-2(17 帧)检查点 |
| 视频模型权重(ModelScope) | modelscope.cn/models/haodong123/VPP2 | 同上,国内镜像 |
| 项目页 | robert-gyj.github.io/video-prediction-policy-2 | 演示视频与说明 |
| RoboDojo 榜单 | robodojo-benchmark.com/leaderboard | 2026-10-08 起总分第一(39.26 / 32.26%) |
README 里的 News 时间线:10-08 RoboDojo-Sim 官方榜单登顶;10-10 视频模型权重(Stage-1 49 帧 / Stage-2 17 帧)在 HF 与 ModelScope 放出,附零样视频预测使用指南;10-12 RoboDojo 历史帧条件化的视频训练代码(Video-10k 配方,从 Stage-2 蒸馏前检查点出发)开源。动作专家与完整策略权重截至论文版本尚未单独放出,复现策略需要按仓库脚本自己跑 Stage-3。
🎯 一句话版本:核心数字
| 场景 | 环境 | VPP2 | 最强基线 | 差距 |
|---|---|---|---|---|
| 视频预测指令跟随(开放任务,GPT 评审) | 真实图像条件 | 机器人 0.90 / 人手 0.80 | Cosmos3-64B 0.78 / 0.70 | +11.0 pt(综合口径) |
| 真机 ALOHA 零样本(10 类任务) | 真机 | 58.5% | π0.5 40.0%,Fast-WAM 20.5% | +18.5 pt |
| LIBERO-Pro(位置+任务扰动) | 仿真 | 45.0% | π0.5 11.0% | +34.0 pt |
| LIBERO-OOD(组合泛化) | 仿真 | 63.9% | Temporal Ratio 59.4% | +4.5 pt |
| RoboDojo(42 双任务) | 仿真 | 32.26% / 39.26 分 | GPT-6-Astra 22.48% / 28.97 | +9.8 pt |
论文的标题就是论点:Predict Better, Act Better——预测得更好,动作才会更好。它不靠更大的模型,而靠把「预测」这件事本身做对。
🧭 读前 5 分钟:四个概念
- WAM 的两种耦合方式:①「先生成未来视频,再用逆动力学(IDM)反推动作」(两段式,慢);②「动作直接条件在视频模型的特征/KV cache 上」(VPP2、Fast-WAM 走这条)。VPP2 属于后者,但视频模型是认真为操作任务预训练过的,这是它和「拿一个通用视频模型直接改」的最大区别。
- 事件级(event-level)vs 块级(chunk-level)预测:事件级 = 从子任务起点一直预测到子任务完成(时长不定,1–12 秒);块级 = 固定时长(人手 2 秒、机器人 8 秒)。事件级的语义与语言描述天然对齐;块级的时间尺度固定,才好接动作。
- 一致性蒸馏(consistency distillation):训练一个学生网络,让它在任意噪声点上一步映射到干净终点,而不是像教师那样走完整条 ODE。VPP2 用它把 8 秒视频块的生成压到单次前向(约 0.1 秒)。
- MoT(Mixture-of-Transformers):视频 DiT 和动作 DiT 是两个独立参数块,通过注意力共享信息。VPP2 的动作专家只有 0.9B,且训练早期冻结视频骨干、只挂 LoRA,目的就是「学动作但别把视频先验带坏」。
🗺️ 先分清:哪些是仿真,哪些是真机
这篇论文的实验横跨四类环境,读表前先对号入座:
| 实验 | 环境 | 说明 |
|---|---|---|
| 视频预测指令跟随 / 胜率(表 2、图 6/7) | 真实图像条件、视频生成评测 | 测试图像来自办公室/机器人工作台现场拍摄,指令自由编写;用 GPT 评审与人工两两比较,不涉及控制闭环 |
| 真机 ALOHA 零样本(图 8) | 真机 | 双臂 ALOHA 平台(训练数据中见过的本体),10 类任务不做任务微调直接部署 |
| LIBERO-ID / Pro / OOD(表 3) | 仿真 | LIBERO 四套件上后训练;Pro 加位置/任务扰动,OOD 重组物体/布局/目标 |
| RoboDojo(表 4、图 9) | 仿真 | 官方 simulation leaderboard,42 个双臂任务、五维能力;记忆任务需要历史帧输入 |
| 图 5 / 图 10 的视频预测示例 | 真实视频预测(开环) | 给初始帧+指令生成未来视频,人手与机器人操作都有,含未见本体 |
一句话:闭环控制的硬数字来自 1 个真机平台(ALOHA)+ 2 个仿真基准(LIBERO、RoboDojo);视频预测能力则在真实拍摄的图像上测。
🧱 数据:这篇论文一半的功夫在数据上
训练数据总表(论文 Table 1)
| 类型 | 本体 | 来源 |
|---|---|---|
| 机器人 | 单臂 | OXE、RoboMIND、DROID、RH20T、MolmoAct |
| 机器人 | 双臂 | AgiBot World-Beta、RoboCOIN、RDT、GM-100、ABC-130K、自采 ALOHA |
| 机器人 | 移动/人形 | InternData-A1、Galaxea Open-World、自采灵巧手 |
| 人类 | 人手 | EgoDex、Ego4D、EPIC-KITCHENS、Something-Something V2、VITRA-1M、自采第一视角 |
| 通用视频 | 人手 | OpenVid、Panda-70M(经 LVP 式过滤,只留操作相关) |
覆盖 20+ 种机器人本体。注意它同时吃了人类手和机器人数据——这解释了后面 Figure 5 里人手预测与机器人预测能共用一个模型。第一视角双臂数据(ALOHA 型、人形、人类第一视角)占总量 80% 以上,这也是统一动作空间只对这部分做的原因。
1. 详细 caption:把「一对多」的映射压成「一对一」
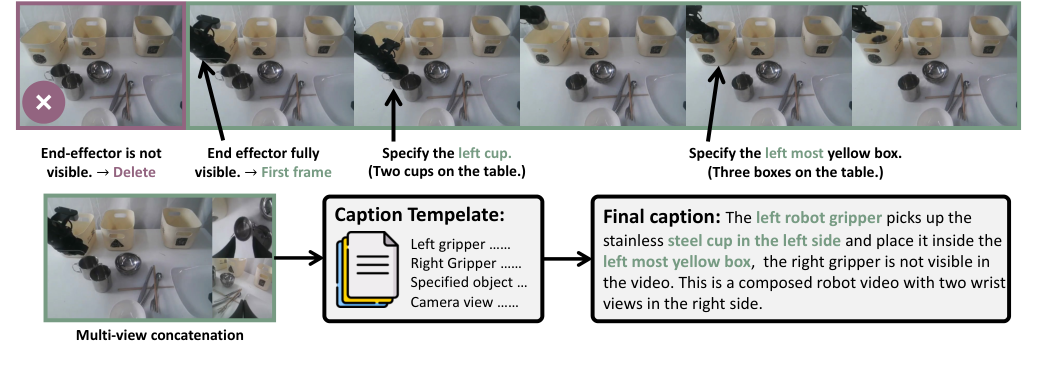
图 2 逐图讲解:这是单条演示如何被清洗、裁剪、标注成训练样本的完整流水线,分上下两行。上行是「帧级筛选」:第一张图被打红叉,标注「End-effector is not visible. → Delete」——末端执行器在画面里不可见的片段直接删掉;第二张图箭头指向夹爪清晰出现的第一帧,标注「End effector fully visible. → First frame」——以夹爪首次完全可见的帧作为片段起点;第三、四张是「目标消歧」:桌上有两个杯子时 caption 必须写 “Specify the left cup. (Two cups on the table.)",有三个盒子时必须写 “Specify the left most yellow box. (Three boxes on the table.)"——属性或空间关系必须唯一锁定目标。下行左侧是多视角拼接:主视角在左、两路腕部相机竖排在右拼成 T 形(不足两路用黑图占位);中间是 Caption Template 图标,列出模板四要素——Left gripper……、Right Gripper……、Specified object……、Camera view……;右侧是套模板生成的最终 caption 全文:"The left robot gripper picks up the stainless steel cup in the left side and place it inside the left most yellow box, the right gripper is not visible in the video. This is a composed robot video with two wrist views in the right side."——哪个夹爪、什么物体、在哪个位置、视角怎么拼,全部写死。
VPP2 的应对是用 caption 把不确定性消掉。一条 caption 必须包含四件事(Appendix A.1):
- 详细任务描述:末端执行器怎么完成任务,动作顺序与方式;
- 明确的末端执行器:必须第一帧可见,不可见就裁剪到可见处;双臂则分别描述;
- 无歧义的目标物体:多个相似物体时用属性或空间关系定位("left most yellow box"),且第一帧必须可见;末端不可见或目标不可见的片段直接删掉;
- 相机视角描述:光流过滤视角剧变的第一视角片段,中等运动则让 VLM 描述视角变化。
2. 统一动作空间:不统一坐标系,动作维度就没有语义
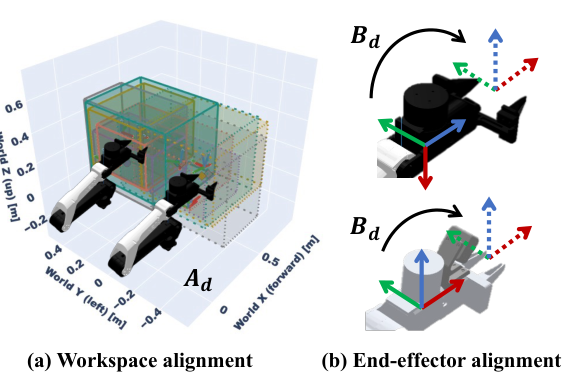
图 3 逐图讲解:跨数据集训练最常见的隐形杀手是坐标系不一致,这张图给出两层对齐的几何含义。(a) 工作空间对齐:3D 画布里堆叠着多个数据集各自的末端工作空间——彩色实线框(如青色)与各色虚线框交错,代表不同机器人的可达范围原本互不相同;对齐变换 A_d 把它们映到同一参考盒内,使「向左 20 厘米」在所有数据里指向可比的物理区域。(b) 末端坐标系对齐:上下两组夹爪各带一个坐标系——上方是变换前(绿色 B_d 箭头标出旋转关系),下方是对齐后:原点统一到夹爪中心、红/绿/蓝三轴分别对齐到统一的 x/y/z 方向。变换写成 eT_d = A_d · T_d · B_d:先右乘 B_d 拧局部坐标系,再左乘 A_d 摆进公共工作空间。看着简单,但这是「20 多个本体的数据能放进同一个损失函数」的前提。
不同数据集里「向左移动」可能是 +x,也可能是 −y,模型无法学到每个动作维度的含义。VPP2 只处理第一视角双臂数据做对齐:
- 工作空间对齐 A_d = W̄ᵀW_d:把不同机器人的末端工作空间变换到可比范围;
- 末端坐标系对齐 B_d = E_dᵀĒ:统一末端原点与轴向。
3. 预处理与后训练的数据流
- 视频过滤与切分:先剔除相机故障、轨迹突变的坏段;剩余轨迹按语义切成 1–12 秒的连贯片段,边界由人手/末端速度局部极小值、开合夹爪时刻等启发式线索初选,再由 VLM 精修合并。
- 事件级样本:每条演示在整个事件上均匀采 N 帧,条件 = 子任务指令 + 初始帧。
- 块级样本:固定时长——人手 2 秒、机器人 8 秒,帧率重采样到统一间隔。
- 动作后训练:只用处理好的双臂数据(统一工作空间+末端坐标系之后),动作 = 末端位姿增量 + 夹爪开合。
- RoboDojo 特供:为支持记忆任务,输入额外拼「初始帧 + 按 1 秒间隔采的 8 个历史帧」;因为输入结构变了,从蒸馏前的 Stage-2 检查点重新后训练(先单独训视频 10,000 步,再联合训动作专家),训练中视频噪声固定在最大值、推理时单次前向,动作流的时间步在 [0,1] 均匀采样。
🏗️ 方法:三阶段训练流水线
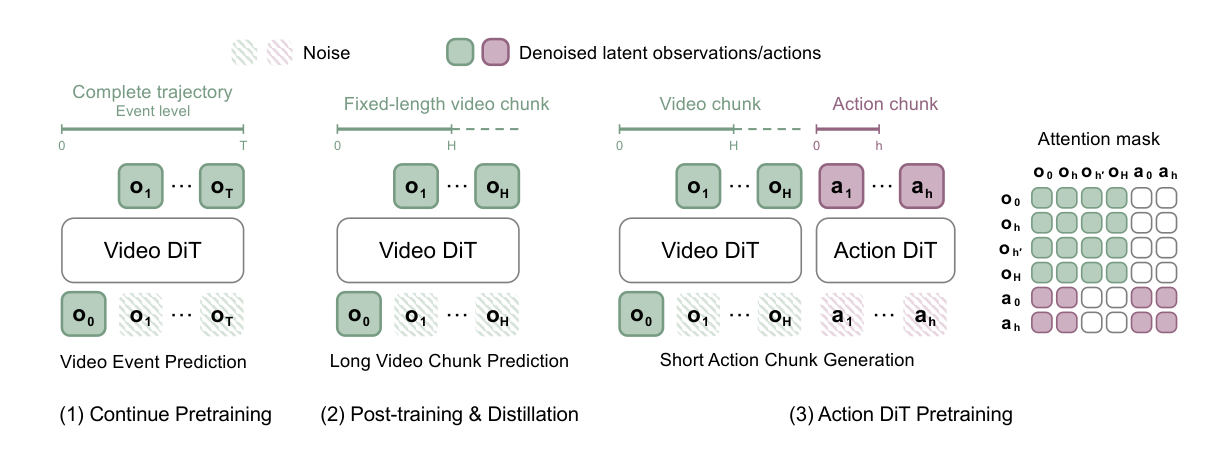
图 4 逐图讲解:三个阶段从左到右排开,上方是输入/输出时间线,下方是模型块,右侧是注意力掩码。图例:斜纹块 = 噪声,绿/粉色实心块 = 去噪后的潜变量观测/动作。(1) Continue Pretraining(事件级续预训练):时间线是「Complete trajectory, Event level」——从 0 到 T 覆盖完整事件;下方 Video DiT 的输出行是 o₁…o_T(全部要去噪的未来帧),输入行是 o₀(干净条件帧)+ o₁…o_T(噪声版)。(2) Post-training & Distillation(块级后训练与蒸馏):时间线变成「Fixed-length video chunk」,0 到 H 固定长度(机器人 8 秒);结构同左,但 H 固定,为单步蒸馏做准备。(3) Action DiT Pretraining(动作专家预训练):在视频块右侧多出紫色的 Action chunk(0 到 h,对应 2 秒动作);Video DiT 与 Action DiT 并列,底部输入是视频噪声 + 动作噪声。右侧注意力掩码矩阵定义了两流如何互通:行 = 查询来源(o₀、o_h、o_h’、o_H、a₀、a_h),列 = 可见内容——视频 token 全程可以看视频历史;动作 token 可以看全部视频列 + 自己的动作历史,但动作之间的时间可见性受限(下半紫色区域的白色空格)。这就是「动作条件在视频 latent 上、视频不偷看未来动作」的结构化表达。
Stage 1:事件级视频续预训练(Continue Pretraining)
- 目标:把通用视频模型改造成「懂操作、听指令」的视频模型;
- 基座:Wan2.1-I2V-14B;
- 对一条演示 τ = (o₀, …, o_T),在整个事件上均匀采 N 帧:y_event = (o₀, o_⌊T/N⌋, …, o_T);
- 用 flow matching:x_s = (1−s)ε + s·x₁,损失 ‖v_θ(x_s, s, c) − (x₁ − ε)‖²,条件 c 包含子任务指令与初始帧 o₀;
- 配置:预测 49 帧、416×240,续训 30,000 步、batch 1,024、lr 1e-5。
关键点:预测的是「完整事件」而不是固定窗口,所以语言描述与视觉演变严格对应,这正是 Figure 1 里「唯一、稳定映射」的来源。
Stage 2:块级后训练 + 一致性蒸馏
事件级模型有个副作用:不同时长的事件采固定帧数,预测帧之间的时间间隔是变的,没法直接接动作。于是第二阶段改成固定时长块:人手 2 秒、机器人 8 秒(输入压到 17×416×240),采样间隔 δ = fH/N,用同样的 flow matching 目标训练。
随后做一致性蒸馏(Eq. 5):让学生在相邻 flow 时间上预测同一个终点,并且以 0.5 的概率直接令 s′ = 1,专门强化单步生成。教师目标用 EMA 学生参数计算。推理时 F_θ(ε, 0, c) 一次前向出整块视频 latent,配 bfloat16 + torch.compile 约 0.1–0.12 秒。
Stage 3:动作专家(0.9B MoT)
- 结构:0.9B 扩散 Transformer(DiT),标准 MoT,条件在视频模型的 KV cache 上;
- 数据:处理好的双臂数据(统一工作空间与末端坐标系之后);
- 策略:动作专家是全新初始化的,早期冻结视频 DiT 基座,只用 LoRA 适配,避免动作梯度破坏视频表征;
- 输出:2 秒动作块(h 步),5 步去噪,约 0.1 秒;
- 端到端延迟:0.12 + 0.1 ≈ 0.22 秒/块。
加分项:VLM 做高层规划
长程任务和含糊的人类指令交给 VLM:它把「收拾桌子」拆成「先把碗放进盒子,再擦桌子……」,同时把子任务描述改写成训练时的 caption 模板格式(prompt enhancement)。VLM 可以本地部署,也可以调 API。这个模块不是必需,但对开放指令很关键(见 Figure 9)。
🧪 实验一:视频预测本身有多好
4. 定性:跨人手、跨本体、跨视角(真实视频,开环生成)
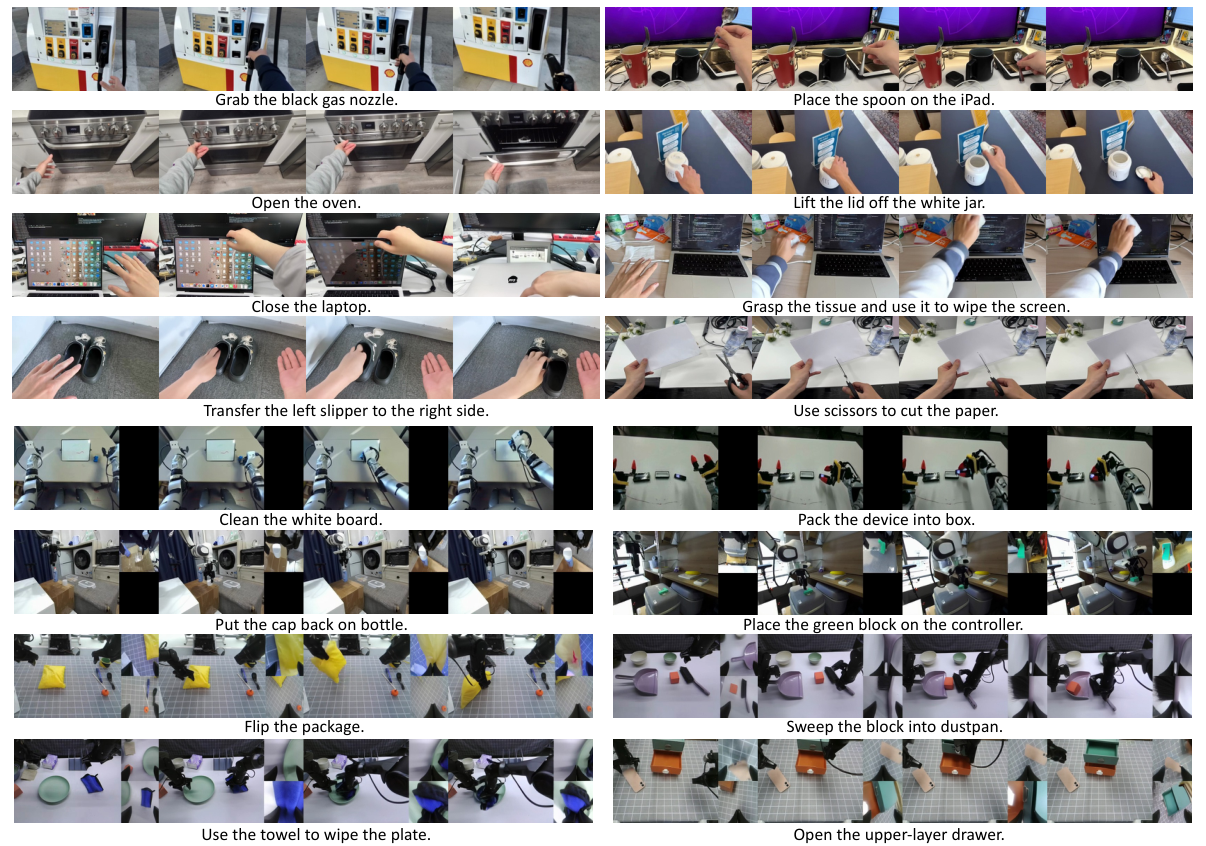
图 5 逐图讲解:16 个开环预测案例排成 8 行 × 2 列,每格是「初始帧 → 预测帧序列」的时间抽样。上四行是人手操作(第一视角):抓黑色燃气嘴、把勺子放到 iPad 上、打开烤箱、揭开白色罐子的盖子、合上笔记本、抓纸巾擦屏幕、把左脚拖鞋移到右侧、用剪刀剪纸。下四行是机器人操作:擦白板、把设备装进盒子、把盖子拧回瓶子、把绿块放到控制器上、翻转包装袋、把方块扫进簸箕、用毛巾擦盘子、打开上层抽屉。机器人行里有几例能看到 T 形多视角拼接——左侧大图是主视角,右侧竖条是两路腕部相机的同步预测,这正是 Figure 2 数据管线在推理端的兑现。论文强调这些测试样本是从办公室/机器人工作台现场拍照 + 自由编写指令得到的,不是从训练集里挑的。
两个观察:
- 模型在未见过的本体上也能生成合理的运动轨迹,说明它学到的是「任务 → 视觉未来」的映射,而不是记住某个机器人的外观;
- 机器人场景支持1–3 路相机联合预测(T 形拼接),这对双臂/多视角策略很实用。
5. 定量:指令跟随成功率与两两胜率(真实图像条件)
指令跟随评测:人手、机器人各 50 对「图像 + 指令」,用 GPT 评审判断生成视频是否完成任务。
| 方法 | 人手 | 机器人 |
|---|---|---|
| Wan2.1-14B(基座) | 0.32 | 0.04 |
| LVP(同基座改操作) | 0.62 | 0.46 |
| Cosmos3-Nano-16B | 0.44 | 0.32 |
| Cosmos3-Super-64B | 0.70 | 0.78 |
| VPP2-Fixed-Step(消融) | 0.48 | 0.42 |
| VPP2 | 0.80 | 0.90 |
两个结论:
- 14B 打赢 64B(0.90 vs 0.78),说明「为操作任务续预训练 + 详细 caption」比单纯堆参数有效;
- 事件级 > 块级(0.90 vs 0.42)——固定窗口模型看到的未来与完整指令对不上,指令跟随直接腰斩。这是本文最重要的消融。
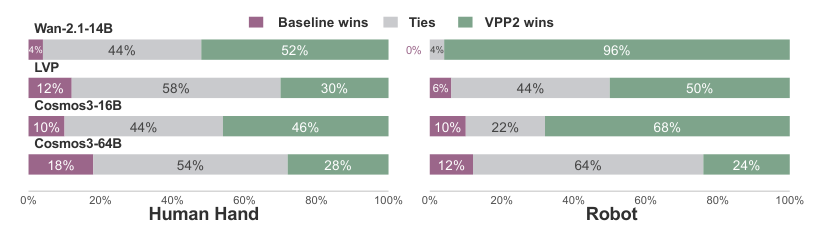
图 6 逐图讲解:左右两组水平堆叠条形图,分别对应 Human Hand 与 Robot 域的两两人工比较。每组四行,从上到下对手依次是 Wan-2.1-14B、LVP、Cosmos3-16B、Cosmos3-64B;图例紫色 = Baseline wins、灰色 = Ties、绿色 = VPP2 wins,横轴 0%–100%。读法:对 Wan-14B 机器人域几乎碾压(0% 输 / 4% 平 / 96% 胜);对 LVP 胜 50%、平 44%、负 6%;对 Cosmos3-16B 胜 68%;对最强的 Cosmos3-64B 胜 24%、平 64%、负 12%——多数样本难分高下,但 VPP2 很少输。人手域格局类似,只是对 Cosmos3-64B 的胜率略高(28%)。注意这张图测的是视频预测质量(谁生成的未来更合理、更贴指令),与控制成功率独立。
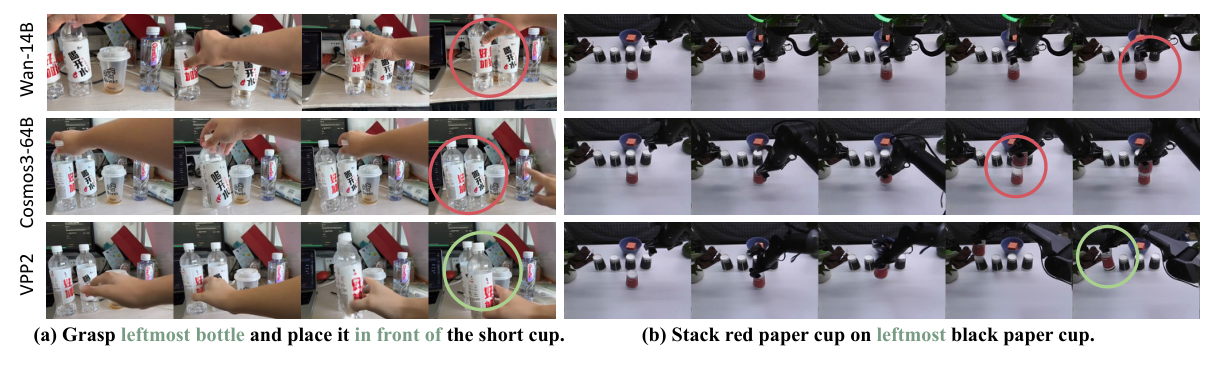
图 7 逐图讲解:三行 × 两列的失败/成功对照。行标签从上到下是 Wan-14B、Cosmos3-64B、VPP2;左列 (a) 是人手场景「Grasp leftmost bottle and place it in front of the short cup.」(抓最左边的瓶子放到矮杯子前面),右列 (b) 是机器人场景「Stack red paper cup on leftmost black paper cup.」(把红色纸杯叠到最左边的黑色纸杯上)。红色圆圈 = 错误行为,绿色圆圈 = 正确行为。Wan-14B 在 (a) 里抓错瓶子/放错位置(红圈),Cosmos3-64B 同样「抓了不是最左的那个」;VPP2 绿圈里正确锁定最左目标并放到指定关系位。右列机器人任务同理:两个基线都叠错杯子,VPP2 正确叠上最左黑杯。这张图是「详细 caption 训练让空间词与像素绑定」的直接证据——caption 模板本来就强制写清 left/left most/in front of,模型于是学会把这些词落到正确位置。
🧪 实验二:动作到底行不行
6. 真机 ALOHA 零样本:58.5%,9/10 类第一
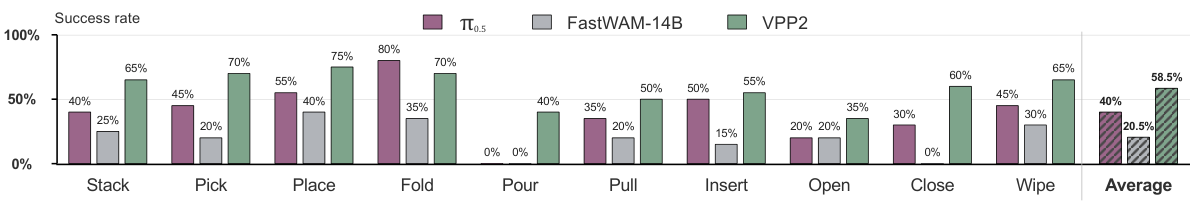
图 8 逐图讲解:分组柱状图,横轴 11 组——Stack / Pick / Place / Fold / Pour / Pull / Insert / Open / Close / Wipe / Average;纵轴成功率 0%–100%;图例紫色 π₀.₅、灰色 FastWAM-14B、绿色 VPP2。读关键数字:Stack 65 vs 40/25、Pick 70 vs 45/20、Place 75 vs 55/40、Fold 70 vs 80/35(唯一一项 π₀.₅ 反超)、Pour 40 vs 0/0(两个基线全零)、Pull 50 vs 35/20、Insert 55 vs 50/15、Open 35 vs 20/20、Close 60 vs 30/0、Wipe 65 vs 45/30;平均 58.5% vs 40.0% / 20.5%(Average 组用斜纹柱区分)。这是全文唯一的真机闭环控制数字,也是「零样本 VPP2 对比微调过的基线」仍然领先 18.5 个点的证据。
在训练中见过的本体(ALOHA)上不做任何任务微调,直接部署,测 10 类任务:
| 任务 | π0.5 | Fast-WAM-14B | VPP2 |
|---|---|---|---|
| Stack | 40% | 25% | 65% |
| Pick | 45% | 20% | 70% |
| Place | 55% | 40% | 75% |
| Fold | 80% | 35% | 70% |
| Pour | 0% | 0% | 40% |
| Pull | 35% | 20% | 50% |
| Insert | 50% | 15% | 55% |
| Open | 20% | 20% | 35% |
| Close | 30% | 0% | 60% |
| Wipe | 45% | 30% | 65% |
| 平均 | 40.0% | 20.5% | 58.5% |
公平性说明:π0.5 和 Fast-WAM 都在 VPP2 训练数据里暴露过的全部 ALOHA 数据上微调过,Fast-WAM 用的是 14B 版本。也就是说这不是「零样本 vs 零样本」,而是「零样本 VPP2 vs 微调过的基线」,VPP2 仍然领先 18.5 个点。
值得注意的是 Fold 这一类 π0.5 更强(80% vs 70%)——单一类别上的优势并非全面碾压。
7. LIBERO 三个基准(仿真):分布内差不多,分布外差一个量级
| 方法 | LIBERO-ID | Pro(位置) | Pro(任务) | Pro 总 | OOD 总 |
|---|---|---|---|---|---|
| π0 | 94.2 | 0.5 | 0.0 | 0.3 | 1.7 |
| π0.5 | 96.9 | 20.8 | 1.3 | 11.0 | 26.8 |
| MolmoAct | 86.6 | 1.5 | 1.5 | 1.5 | – |
| X-VLA | 98.1 | 0.8 | 6.8 | 3.8 | – |
| AtomVLA | 97.0 | 7.3 | 5.3 | 6.3 | – |
| Cosmos-Policy | 98.5 | – | – | – | 10.5 |
| Fast-WAM | 97.6 | – | – | 9.4 | 12.7 |
| DiT4DiT | 98.6 | – | – | 10.3 | 6.4 |
| Temporal Ratio | 94.0 | – | – | 59.4 | – |
| VPP2 | 98.8 | 42.3 | 47.8 | 45.0 | 63.9 |
(Pro/OOD 的 Position、Task、Spatial、Object、Goal 细项见论文 Table 3 与附录 Table 7/8。)
仿真协议:所有模型只在标准 LIBERO 四套件上后训练;Pro 与 OOD 不额外训练,直接评测。Pro 的 Position/Task 扰动按 HarnessVLA 协议,OOD 按 Mishra et al. 的组合泛化协议。
三个要点:
- 分布内(ID)大家都 94–99%,这个数字已经不能区分方法;
- Pro 的 Task 扰动最致命:π0.5 只有 1.3%,VPP2 47.8%。任务说明变了,靠「背轨迹」的模型立刻失效,靠指令-未来映射的模型还能做;
- OOD 上视频类策略(Cosmos-Policy/Fast-WAM/DiT4DiT)都 ≤12.7%,VPP2 63.9%。作者认为这正是「详细 caption + 事件级预测」带来的指令-轨迹一致性。
8. RoboDojo(仿真):和 GPT-6-Astra 同台
| 方法 | 平均分 | 成功率 |
|---|---|---|
| π0 | 3.48 | 1.53% |
| π0.5 | 11.44 | 6.93% |
| X-VLA | 10.13 | 6.52% |
| Fast-WAM | 3.48 | 2.03% |
| OpenWAM-α | 17.18 | 11.92% |
| Xiaomi-Robotics-1 | 20.07 | 13.93% |
| GPT-6-Astra | 28.97 | 22.48% |
| VPP2 | 39.26 | 32.26% |
RoboDojo 的仿真基准是 42 个双臂任务,覆盖泛化、记忆、精度、长程、开放词表五个维度;基线分数取自 2026 年 9 月官方 simulation leaderboard。VPP2 领先前沿基础模型 GPT-6-Astra 约 10 分。为了支持记忆任务,作者把初始帧 + 8 帧按 1 秒间隔采样的历史帧加进输入,并从 Stage 2(蒸馏前)checkpoint 重新后训练(先训视频 10,000 步再联合训练),视频噪声固定为最大、单次前向。
9. VLM 子任务规划:长程任务的分水岭(仿真)
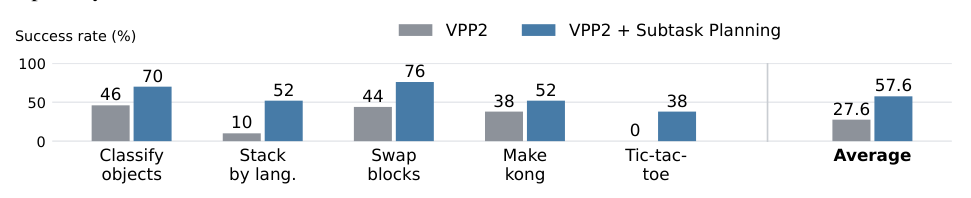
图 9 逐图讲解:分组柱状图,横轴是 RoboDojo 的五个任务组——Classify objects(物体分类)、Stack by lang.(按语言叠积木)、Swap blocks(交换积木)、Make kong(麻将)、Tic-tac-toe(井字棋);纵轴成功率;灰色 = 纯 VPP2,蓝色 = VPP2 + Subtask Planning。每组柱顶标着成功率:分类 46→70、按语言叠 10→52、交换 44→76、麻将 38→52、井字棋 0→38;最右 Average 27.6→57.6——平均翻倍。每任务 50 次试验,基线检查点与表 4 一致。最极端的是「按语言叠积木」和井字棋:这两类都需要多步决策与状态记忆,单靠一个「指令→动作块」的映射做不了,必须由 VLM 把任务拆成有序子目标。
10. 单步蒸馏不掉质
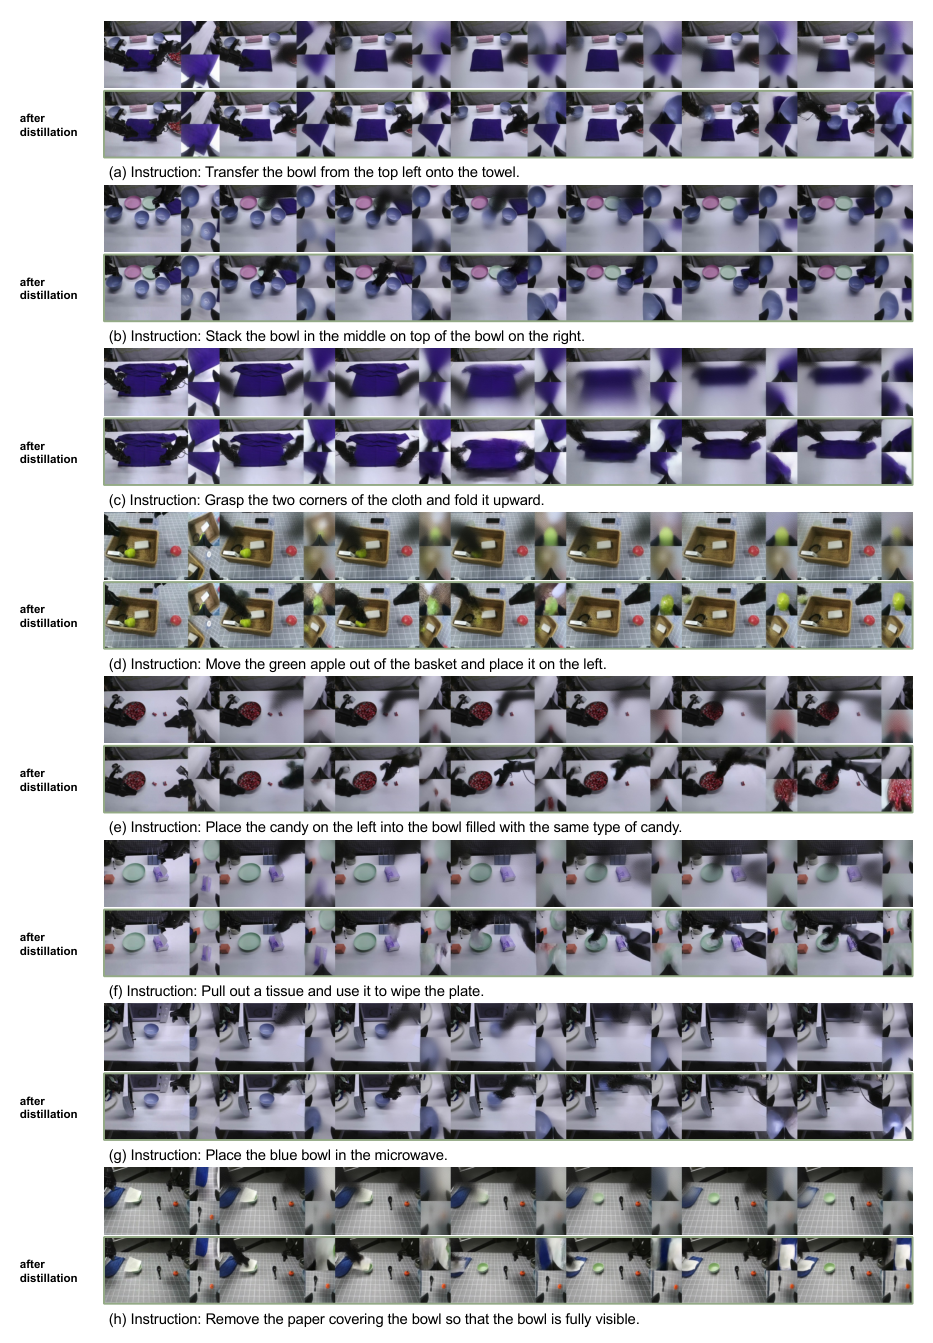
图 10 逐图讲解:附录图,8 个开放任务 (a)–(h) 纵向排列,每个任务占两行视频条带——上行 = 蒸馏前多步采样,下行 = 蒸馏后单步生成(左侧统一标注 “after distillation”)。指令依次是:(a) 把碗从左上移到毛巾上;(b) 把中间的碗叠到右边的碗上;(c) 抓住布的两角向上折;(d) 把绿苹果从篮子里移到左边;(e) 把左边的糖果放进同类型糖果碗里;(f) 抽纸巾擦盘子;(g) 把蓝碗放进微波炉;(h) 揭掉盖在碗上的纸让碗可见。逐帧对比上下两行:物体身份、运动轨迹、场景结构几乎一致,肉眼难以区分——说明一致性蒸馏确实把长视频块压到一次前向而没有牺牲可用性。注意 (e)(f) 这类多物体/接触任务在单步下依然稳定,这正是后面动作专家敢于「条件在单步视频 latent 上」的信心来源。
💡 评析:三个最妙的设计,三条边界
三个最妙的设计
- 把「数据标注」当模型能力的一部分。多数 WAM 论文把 caption 当预处理细节,VPP2 把它当成降低多峰性的核心手段:详细 caption 让「指令→未来」接近一对一,模型不必再去猜「用户到底指哪个杯子」。Figure 7 的空间理解提升和 LIBERO-Pro 的 Task 扰动提升,都是这条线的直接结果。
- 事件级预训练、块级后训练的分工。事件级保证语义对齐,块级保证时间尺度可接动作——两个目标本来冲突,论文用两阶段把它们拆开,还顺手用「VPP2-Fixed-Step」消融证明了事件级不可省(0.42 vs 0.90)。
- 冻结视频、只训 0.9B 动作专家。这是对「加动作模块会破坏视频泛化」这一已知问题的正面回应:动作专家独立参数 + LoRA 轻调,视频表征基本不动。0.9B 也解释了它为什么能 0.22 秒出一块。
三条边界
- 零样本的本体仍然「见过」。ALOHA 零样本是在训练分布内的本体上、未见任务上评测;真正换一个完全没见过的机器人,论文没有给零样本数字(RoboDojo 也做了后训练)。「跨本体」在这里主要指数据混合,不是任意本体即插即用。
- 依赖 VLM 与 GPT 评审。指令跟随用 GPT 当裁判,存在评审偏差;长程能力靠外挂 VLM 规划,Figure 9 的提升有很大一部分应记在规划器而不是策略本身。
- 8 秒视频块 + 2 秒动作块的错位。视频一次预测 8 秒,动作只执行 2 秒,中间如何复用/重规划、闭环频率多少,正文着墨不多;这会影响真实动态场景下的反应性。另外动作专家权重尚未开源,视频权重可下但完整策略复现仍需自己训练。
🗺️ 在 WAM 谱系里的位置
| VPP2 | DreamZero | Flash-WAM | Fast-WAM | |
|---|---|---|---|---|
| 视频预训练 | 事件级续预训练 + 详细 caption | 直接用 Wan2.1 I2V | 沿用教师 | 不显式生成 |
| 动作耦合 | MoT 动作专家(0.9B) | 同一 DiT 联合去噪 | 沿用教师 | 视频特征单次前向 |
| 推理 | 视频 1 步 + 动作 5 步,0.22 s | 1 步 + 系统优化,7Hz | 1v/1a,347 ms | 快 |
| 强项 | 指令跟随、OOD 泛化 | 零样本新技能、跨本体 | 把任意 WAM 蒸馏到实时 | 推理效率 |
| 弱项 | 依赖本体覆盖与 VLM 规划 | 精度任务、长程记忆 | 依赖教师质量 | 视频预测能力被绕开 |
站内延伸:《WAM 世界行动模型全景分析》、《DreamZero 精读》、《Flash-WAM 精读》、《OpenWAM 精读》、《π0.5 开放世界泛化精读》
📊 图表总索引
| 图号 | 内容 | 在本文中的位置 |
|---|---|---|
| Fig 1 | 核心思想:数据+架构、三柱成绩、简单 vs 详细 caption | 开篇 |
| Fig 2 | 数据处理流水线与 caption 模板 | 数据 1 |
| Fig 3 | 工作空间/末端坐标系对齐 | 数据 2 |
| Fig 4 | 三阶段训练流水线 + 注意力掩码 | 方法 |
| Fig 5 | 人手与机器人视频预测(16 例) | 实验 4 |
| Fig 6 | 两两胜率(人手/机器人 × 4 基线) | 实验 5 |
| Fig 7 | 指令跟随定性对比(空间理解) | 实验 5 |
| Fig 8 | 真机 ALOHA 零样本柱状图 | 实验 6 |
| Fig 9 | VLM 子任务规划前后 | 实验 9 |
| Fig 10 | 蒸馏前后单步预测(8 任务) | 实验 10 |
表格:Table 1 数据来源(数据 3)、Table 2 指令跟随(实验 5)、Table 3 LIBERO 三基准(实验 7)、Table 4 RoboDojo(实验 8);附录 Table 5–8 为数据引用与 LIBERO/Pro/OOD 细项。
❓ 自测 Q&A
Q1:为什么「详细 caption」能提升动作成功率,而不是只提升视频好看程度? A:因为动作专家条件在视频 latent 上。如果 caption 含糊,视频模型会生成多峰的「平均未来」,动作专家从模糊未来里反推的动作也不确定;caption 把未来压成单峰,视频 latent 更锐利,逆动力学更容易。LIBERO-Pro 的 Task 扰动提升(1.3%→47.8%)说明它确实在「听指令」,而不是背轨迹。
Q2:事件级预训练和块级后训练各自解决什么?为什么不能只留一个? A:事件级让「指令 ↔ 完整视觉演变」对齐,保证语义;但事件时长不一,采固定帧数会导致帧间隔变化,无法与固定频率动作对齐。块级把时长固定(人手 2 秒/机器人 8 秒),时间尺度稳定后才好接动作。消融 VPP2-Fixed-Step 只有 0.42,证明只做块级会丢掉指令跟随。
Q3:为什么动作专家要冻结视频骨干、只挂 LoRA? A:论文引用已有发现:把动作目标硬塞进视频模型会显著破坏其泛化。冻结 + LoRA 让动作梯度只做小幅适配,保住视频先验;同时 0.9B 的独立专家让推理便宜。
Q4:LIBERO-ID 98.8% 和 LIBERO-Pro 45.0% 差距这么大,说明什么? A:说明「分布内高分」主要靠记忆/插值,任务描述或物体位置一变就失效。Pro 的 Task 扰动(π0.5 1.3%)尤其能暴露这一点。VPP2 47.8% 仍不高,但已是数量级差异,方向是「跟随指令而非复现轨迹」。
Q5:RoboDojo 上为什么要从 Stage 2 checkpoint 重新后训练? A:因为记忆任务需要额外输入「初始帧 + 8 个历史帧」,改变了输入结构;从蒸馏前的 Stage 2 开始,能让视频模型重新适配这个输入,再做单步蒸馏,避免蒸馏后的单步模型无法吸收新结构。这也是开源仓库 docs/robodojo.md 里 Video-10k 配方的起点。
Q6:VPP2 与 Fast-WAM 的关键差别? A:Fast-WAM 走「不显式生成视频、把视频 DiT 当单次编码器」的路线,快但放弃了视频预测这一监督信号;VPP2 坚持显式预测,并用事件级预训练 + 单步蒸馏把成本压下来。Figure 8 的零样本对比(58.5% vs 20.5%)是这条路线差异的直接体现。
Q7:权重放出来了,能直接跑真机吗? A:视频模型(Stage-1/Stage-2)可以下载后直接做零样视频预测(仓库有指南);但动作专家尚未发布,跑真机策略需要自己按 Stage-3 配方在目标本体数据上训练动作头,或等后续放出。
📚 资源与延伸
- 论文:arXiv 2610.10270
- 代码:github.com/roboterax/video-prediction-policy-2
- 视频模型权重:Hugging Face(Haodong082399/VPP2)、ModelScope(haodong123/VPP2)
- 项目页:robert-gyj.github.io/video-prediction-policy-2
- RoboDojo 官方榜:robodojo-benchmark.com/leaderboard
- 站内延伸:《WAM 世界行动模型全景分析》、《什么是世界模型》、《Flow Matching 入门详解》、《LIBERO 精读》、《Cosmos 3 世界基础模型精读》、《Flash-WAM 精读》、《OpenWAM 精读》