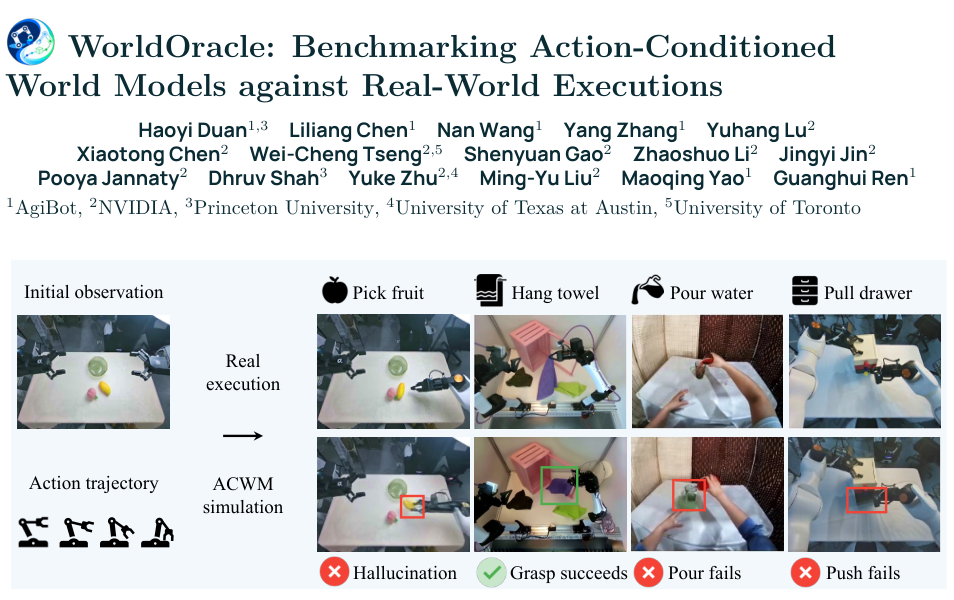
配图说明:本文收录论文全部 21 张插图(Figure 1 ~ Figure 21),放在站内 /images/worldoracle/,逐张讲解,文末附图表总索引表。论文来自 AgiBot、NVIDIA、Princeton、UT Austin、Toronto,arXiv 2610.18826(v2 2026-10-16),数据/代码/排行榜/网站全部公开。它自己不做世界模型,而是当考官——给现有的「动作条件世界模型」(ACWM)出题,图中那个幻觉抓水果的场景就是最典型的考题:真机器人没抓住水果,模型却画出一次成功的抓取。
📄 论文信息
- 标题:WorldOracle: Benchmarking Action-Conditioned World Models against Real-World Executions
- 机构:AgiBot、NVIDIA、Princeton、UT Austin、Toronto
- 时间:2026-10(arXiv 2610.18826 v2,v1 10-13)
- 关键词:动作条件世界模型(ACWM)、执行一致性(execution coherence)、AgiBot G2 / YAM / 人手、VLM 评测(GPT-5.5)、SAM3 掩码、DINOv3 / V-JEPA 特征
- 一句话总结:给 ACWM 出一道「对答案」的题。每个评测样本是「初始观测 + 真实世界里的低层动作序列 + 真实执行的结果」,让模型开环重放同一串动作,然后从四个维度打分。核心设计是成对真实执行(paired real-world executions):既然答案就摆在那里,就不需要人主观判断「像不像」,只需要比较「预测的未来」和「实际发生的未来」。
🎯 一句话版本:核心数字
| 模型(AgiBot G2 真人遥操作) | 30s 综合 | 长episode综合 | 掉分幅度 |
|---|---|---|---|
| IRASim(0.7B) | 49.20 | 35.04 | −14.2 |
| Ctrl-World(1.5B, 多视角) | 49.59 / MV 53.58 | 30.40 / MV 32.62 | −19.2 |
| DreamDojo(2B) | 50.56 | 27.08 | −23.5 |
| Cosmos 3 Nano(16B) | 53.99 | 26.60 | −27.4 |
| GE-Sim 2.0(2B, 多视角) | 73.86 / MV 79.77 | 63.33 / MV 71.74 | −10.5 |
三个注脚:其一,冠军的优点和分数一样集中——GE-Sim 2.0 的空间对齐 81.40 比最强对手(Cosmos 3 的 67.41)高 14 个点;其二,policy rollout 分布(π0.5 闭环跑出来的动作,带犹豫/抖动/自我纠正)是单独一份考卷,GE-Sim 2.0 综合 64.69 依然第一,但 IRASim 的物理正确性反而爬到 62.18 的第一;其三,整个人手 track 是零样本的(论文不提供人手训练数据),最强的人手 track 模型(JointControlVideo 的 44.40)也远低于机器人卷。
🧭 读前 5 分钟:五个概念
- ACWM(动作条件世界模型):输入初始观测 + 低层动作序列,输出「未来会怎么发展」的视频。可以直接供数据生成、策略评测(imagined rollout)、闭环策略学习使用。
- 执行一致性(execution coherence):本文的核心概念——预测的未来和同条件下的真实执行有多一致。注意不是「像不像机器人操作视频」,而是「那串动作下来物件真的会那样」。
- 三个压力测试:Causal obedience(动作里的失败执行——空抓、掉落、洒水——你会跟着照错演化吗?)、Distribution transport(换本体、换动作源——从遥操作到策略 rollout 到人手,一致性还在吗?)、Temporal endurance(几分钟长轨迹持续生成,误差累积会滚雪球吗?)。
- 四个评测维度:物理状态正确性(phys)、交互空间对齐(spa)、交互关键区域保真(key)、多视角动作一致性(mv)。前三个都在主视野(top_head 头部相机)上算,组合为 WorldOracle-SV;mv 对所有三个相机镜头同步评测,组合为 WorldOracle-MV。
- 交互段(interaction segment):每条 episode 被切成 N 段,每段一次操作尝试,段尾一帧「关键帧」记录该次尝试的物理结果(成功举起 / 空手闭合 / 水洒了……)。评测因此既能看帧间轨迹、又能看端到端 outcome。
🔍 问题:画得像 ≠ 发生了
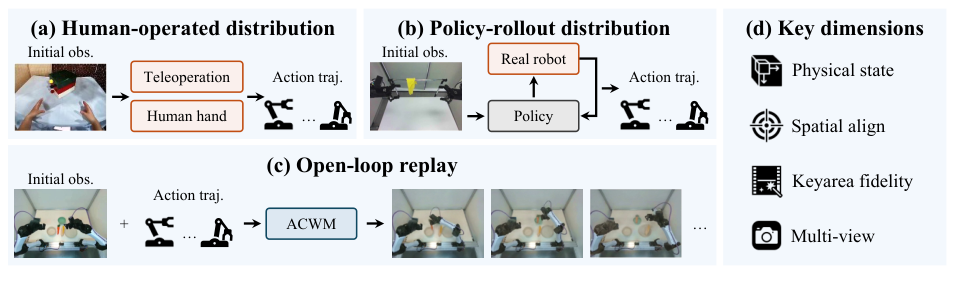
Figure 2 把整个框架一层层画出来——(a) 真人操作轨迹(遥操作 or 人手直接执行),(b) 策略 rollout 轨迹(π0.5 闭环跑真机),(c) ACWM 开环重放动作序列生成预测 rollout,(d) 四个维度打分。注意三点设计:任何动作源都能进考题(遥操作/策略/人手三种分布就是三份考卷);开环(不给模型实时反馈,误差累积全靠自己扛);答案在真实现场(paired real execution)。
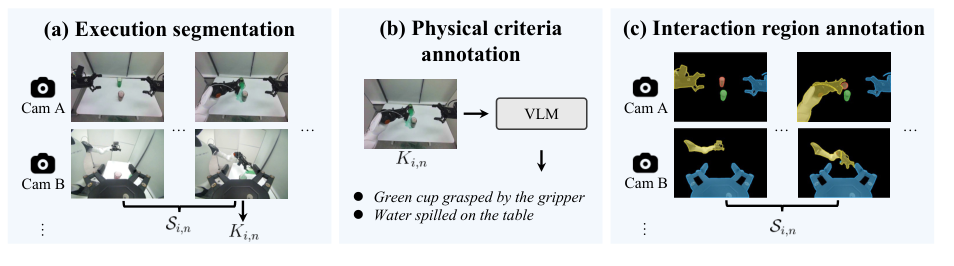
Figure 3 是完整的标注流水线。Segmentation 把 episode 切成交互段 + outcome keyframe;Criteria 用 GPT-5.5(VLM)根据「初始观测 + 关键帧」生成可视觉判定的物理状态判据(如「绿色杯子被夹爪抓紧」「水洒在桌面上」);Region 用 SAM3 逐帧标出被操作物体 + 机械臂/人手的掩码,供空间对齐和关键区域保真两项使用。有意思的是判据生成与评判决分互为镜像:作者把真实关键帧交给 VLM 判分,GPT-5.5 对 100% 的判据给了通过——这排除了「考官自己都看不懂考卷」的风险。
4 个任务 → 4 种物理动力学
摘水果(刚体)、挂毛巾(可变形物体)、倒水(流体,加了有颜色的水让溢出可见)、拉抽屉(铰接物体)。每个任务里既有成功也有失败段,每个 outcome keyframe 都能被 VLM 直接看图判断(水果在不在筐里、水移没移、抽屉开没开),不需要状态符号化或额外传感器。
三种本体、三种动作分布
- AgiBot G2:遥操作 100 条 + policy rollout 60 条(π0.5 从 DROID 检查点微调而来、部署在真机);
- YAM:75 条(模型靠公开 ABC-130K 数据集适配,测试时面对 train-test 域差);
- Human hand:100 条人手直接执行(15 FPS),零样本——论文不给适应训练数据,看模型的 egocentric 世界建模能力。
- 所有评测 episode 约 2 分钟长,约 40% 的交互段是失败执行(训练集里这个比例只有约 20%)——这是故意的:只见过成功的世界模型会默认「动作对了 → 画出成功」,而 WorldOracle 问的是「动作是错的,你能画出错的后果吗?」
🛠️ 四个指标——四个问题,四个答案
四个维度各设一摊判分标准:
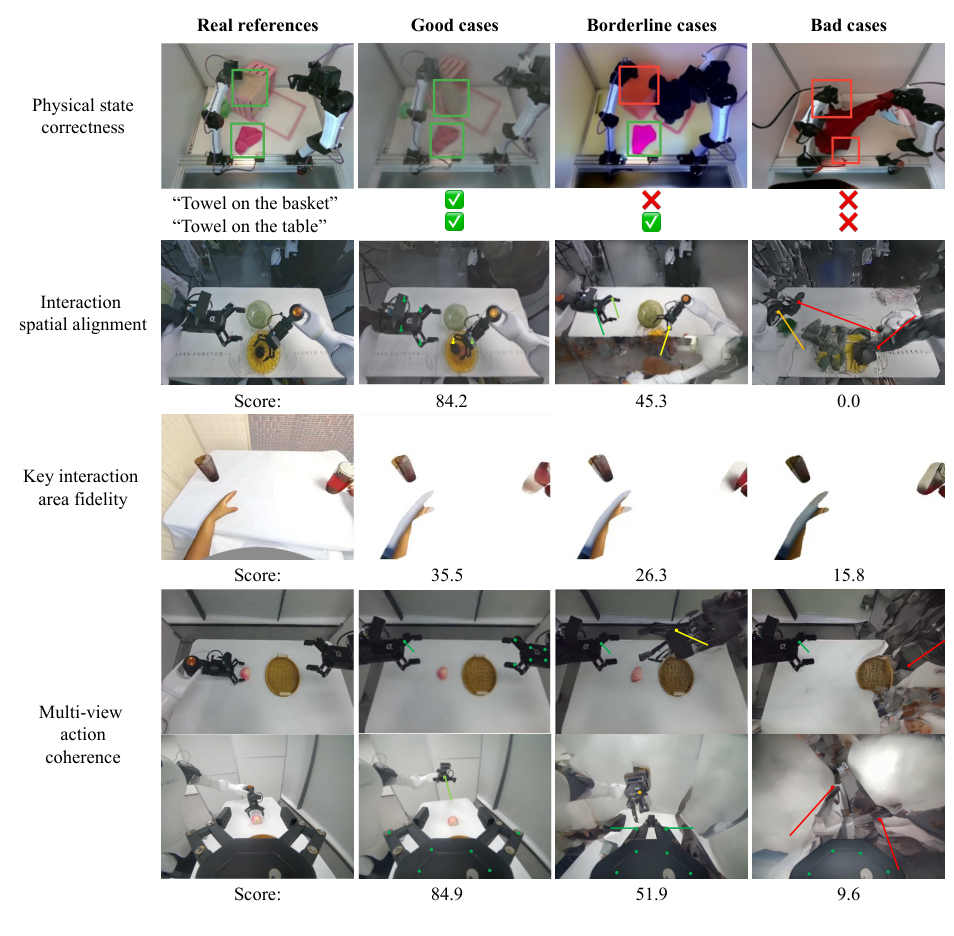
Figure 4 每一行是一个任务场景,列出高/中/低分的三个预测与真实参考对照:(i) 物理状态正确性检查是否满足判据(「毛巾在篮子上」满足、「毛巾在桌上」不满足,低分例预测的两条毛巾状态全错);(ii) 交互空间对齐用点标出匹配的视觉特征、点色从绿(高置信)到红(低置信)、连线越短对齐越好(低分例对齐点整体漂移);(iii) 交互关键区域保真只看交互区域内的外观与结构(低分例物体出现形变和结构畸变);(iv) 多视角动作一致性在低分例的多路同步镜头里出现机器人错位。
1. Physical State Correctness(有没有对答案)
把每个 outcome keyframe 交给 VLM:给出那一段的判据列表(「黄色水果被抓着」「蓝毛巾挂在杆上」),VLM 对每个判据打个 0/1。段分数 = 判据通过率,episode 分数 = 各段平均,再平均到整个 benchmark。测试的是端到端物理 outcome——永远不会只因为「画面清楚」就给高分。
2. Interaction Spatial Alignment(沿着真实轨迹走了吗)
对每个采样帧(步长 10):从真实观测中被 SAM3 标记的区域抽 DINOv3 特征当模板 → 到预测观测里找最近邻 → 计算每个匹配点的空间位移。位移越小说明「机械臂/物体在预测里出现在真实轨迹要求它出现的地方」。匹配的置信度(互匹配率、匹配 margin、余弦相似度、几何 inlier 比率四信号合成 sigmoid)会乘进分数——公式 100·q_d·q_c^3(γ=3)意味着:位移再小,置信度不够就拿不到分。
3. Key Interaction Area Fidelity(交互区域糊不糊)
整帧的 PSNR/LPIPS 会被背景主导——桌子占一大半像素,全对了也无意义。想法是把评测范围限制在被操作物体 + 机械臂/手的那一块掩码区域:对物体掩码和机械臂掩码各自在预测/真实图里裁出局部区域,算 masked PSNR(像素级)、masked LPIPS(感知级)、V-JEPA 2 余弦(表征级)三个指标,各自经验归一化后几何平均合成——几何平均意味着任何一项挂了都会拖垮整个分数。想要高分就必须「物体出现在该出现的位置,而且长得对」。
4. Multi-View Action Coherence(多镜头一致吗)
对多视角同步输出的模型(GE-Sim 2.0 / Ctrl-World),在三个镜头(top_head + 左右手腕镜头)各自独立算机械臂空间对齐,然后等权平均——某一路镜头里机器人出现在了正确的位置而另一路没出现,分数照样扣。这测试的是「viewpoint 错乱」这类单帧指标看不到的问题。
SV = (phys + spa + key)/3,MV = (phys + spa + key + mv)/4。每个维度必须单独做好,才拿得到一个够看的综合分。
🧪 实验:七模型 × 四张考卷
七个被考选手:IRASim(0.7B, 视频)、Ctrl-World(1.5B, 多视角)、DreamDojo(2B)、Cosmos 3 Nano(16B)、GE-Sim 2.0(2B, 多视角 + 联合预测本体感受状态)、JointControlVideo(14B)、OSCAR(2B)——后两个是给「人手」track 的 egocentric 模型。所有模型都从官方 checkpoint 出发、用原论文的训练配方做或轻或重的适配。
1. AgiBot G2(主考卷)
30s vs Long 两种计时口径(短/长),所有指标 [0,100],±95% bootstrap CI(5,000 episode 重采样):
| 模型 | 物理正确性 (30s/Long) | 空间对齐 | 关键区域保真 | 多视角 | 综合 SV | 综合 MV |
|---|---|---|---|---|---|---|
| IRASim | 55.64 / 42.06 | 53.96 / 37.60 | 38.00 / 25.47 | – | 49.20 / 35.04 | – |
| Ctrl-World | 51.15 / 38.31 | 57.08 / 29.44 | 40.53 / 23.45 | 65.57 / 39.31 | 49.59 / 30.40 | 53.58 / 32.62 |
| DreamDojo | 53.32 / 37.97 | 53.96 / 18.10 | 44.39 / 25.18 | – | 50.56 / 27.08 | – |
| Cosmos 3 | 53.12 / 33.43 | 67.41 / 25.26 | 41.44 / 21.10 | – | 53.99 / 26.60 | – |
| GE-Sim 2.0 | 72.54 / 60.26 | 81.40 / 73.49 | 67.62 / 56.24 | 97.53 / 96.96 | 73.86 / 63.33 | 79.77 / 71.74 |
要点三行:
- 像素对齐条件化(GE-Sim 2.0)跟空间对齐分数绑在一起——它对末端执行器位姿出像素对齐轨迹图(把动作直接画在图片坐标系里),这个设计让它在空间对齐上全项领先。论文诚实地说:这只是 observational 关联,不是控制变量的因果结论(各模型架构、预训练、记忆长度都不一样)。
- 空间跟着动作走 ≠ outcome 对——GE-Sim 2.0 长轨迹下空间对齐 73.49、多视角 96.96,但物理正确性 60.26、关键区域保真 56.24。可以完美跟随机械臂轨迹,却抓错了水果。
- 长轨迹全面下跌——全部模型在 Long 上都比 30s 掉(-10 到 -27 分不等),短窗口高分 ≠ 长时程稳定。
2. Policy-Track 卷(动作从 π0.5 来)
60 条,动作是被学习出来的策略闭环跑出来的,分布里带着犹豫、抖动、反复纠正:
| 模型 | 物理 | 对齐 | 关键区域 | 多视角 | SV | MV |
|---|---|---|---|---|---|---|
| IRASim | 62.18 | 51.62 | 32.30 | – | 48.70 | – |
| Ctrl-World | 27.22 | 42.95 | 33.16 | 62.91 | 34.44 | 41.56 |
| DreamDojo | 44.44 | 52.88 | 36.57 | – | 44.63 | – |
| Cosmos 3 | 34.29 | 59.81 | 34.31 | – | 42.80 | – |
| GE-Sim 2.0 | 57.03 | 78.70 | 58.33 | 96.64 | 64.69 | 72.67 |
这张考卷非常有意思——谁对谁错大洗牌:IRASim 的物理正确性跃居第一(62.18),而 Cosmos 3 的物理正确性从 G2 真人卷的 53 跌到 34;空间对齐上 GE-Sim 2.0 仍大幅领先(78.70)。策略 rollout 的动作分布和真人遥操作不一样——分布迁移本身就是需要单独考察的变量,这也是把它单独作为一份考卷的原因。
3. YAM 卷(换本体 + 远域差)
| 模型 | 物理正确性 30s/Long | 空间对齐 | 关键区域 | 多视角 | SV | MV |
|---|---|---|---|---|---|---|
| IRASim | 65.23 / 53.39 | 51.52 / 38.71 | 39.67 / 30.35 | – | 52.14 / 40.82 | – |
| Ctrl-World | 56.39 / 39.03 | 53.43 / 20.71 | 35.93 / 18.97 | 41.87 / 15.52 | 48.59 / 26.24 | 46.91 / 23.56 |
| DreamDojo | 59.14 / 48.15 | 56.35 / 19.70 | 45.84 / 28.11 | – | 53.78 / 31.99 | – |
| Cosmos 3 | 67.84 / 62.85 | 68.93 / 34.61 | 40.71 / 16.04 | – | 59.16 / 37.83 | – |
| GE-Sim 2.0 | 67.78 / 49.37 | 74.97 / 59.78 | 54.64 / 44.41 | 64.10 / 48.54 | 65.80 / 51.19 | 65.37 / 50.53 |
GE-Sim 2.0 仍稳坐第一(65.80),但它的 领先幅度从 G2 卷的 19.9 分跌到 YAM 卷的 6.8 分。它是在 AgiBot G1 上预训练的——G1 骨架、外形都更接近 G2,换 YAM 本体后域差扩大。这提示「像素对齐动作条件化」不是万能钥匙,本体迁移照样要付学费。
4. Human Hand 卷(零样本考卷)
| 模型 | 物理 30s/Long | 对齐 | 关键区域 | SV |
|---|---|---|---|---|
| JointControlVideo | 55.47 / 56.33 | 57.24 / 23.79 | 20.50 / 8.10 | 44.40 / 29.41 |
| Cosmos 3 | 47.46 / 30.23 | 33.70 / 9.43 | 22.21 / 11.44 | 34.46 / 17.03 |
| OSCAR | 53.18 / 48.88 | 47.48 / 16.07 | 27.46 / 17.82 | 42.71 / 27.59 |
没有训练数据、只有模型自带的「看见手 → 推断未来」能力,整个人手 track 的分数系统性低于机器人 track。关键区域保真(key)垫底——最强模型只有 27.46(30s),手和物体接触区域小又复杂,渲染保真就成了第一短板。
5. 每任务拆解(四张热图)
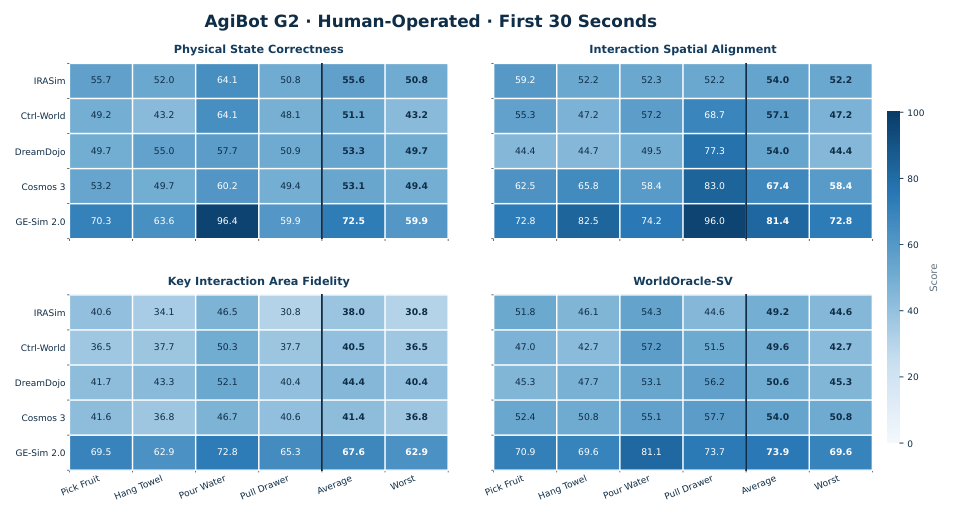
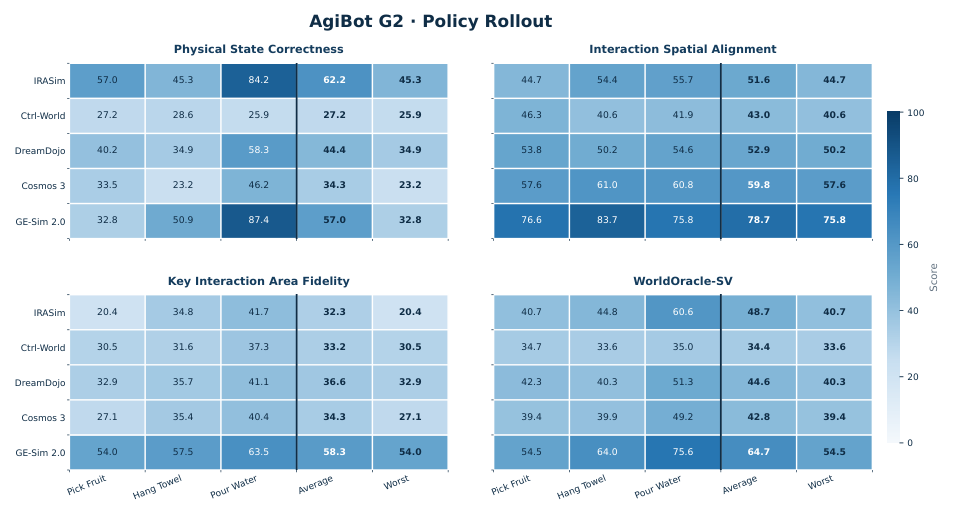
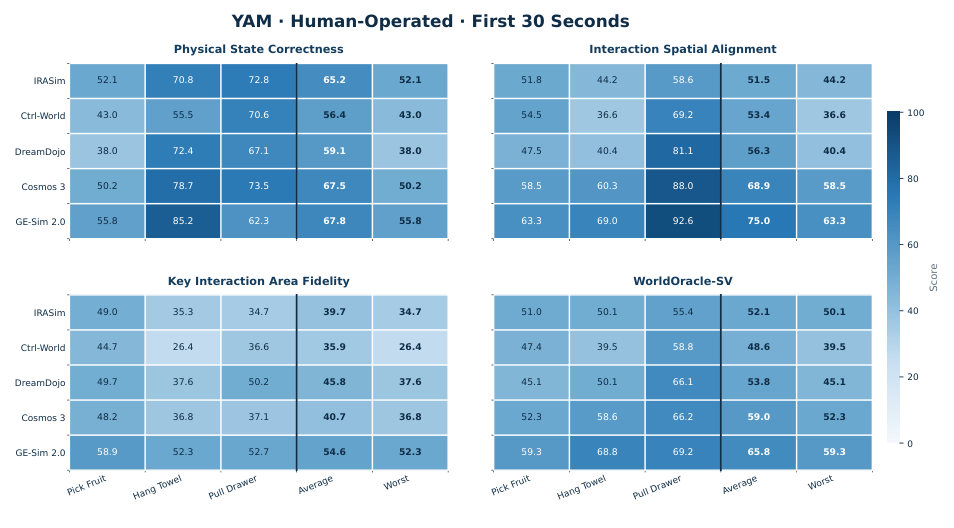
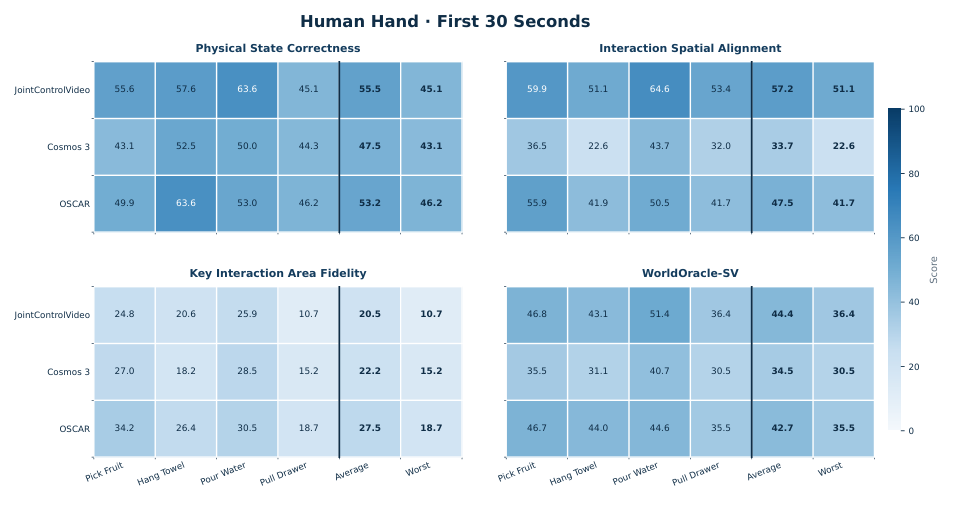
- 按任务看:倒水 是最「好考」的任务——杯子大、接触区域好定位,物理正确性、关键保真与综合分普遍最高;拉抽屉虽然铰接动力学复杂,但抽屉视觉显眼、运动受约束,空间对齐分更高——物理难 ≠ 视觉难,这是任务设计里有意的双重考察。小目标则是公认的软肋:policy 卷里「摘水果」对 GE-Sim 2.0 和多数模型都是最弱的一格(Figure 6),即使在像素对齐条件下精确抓小物体仍然困难。
- 每个指标块的最后一列都是 Worst(最差任务)。均值之外再摆一个下限,防止「平均好看、单项烂」的假象——这也是后续所有热图的固定格式。
- 人手卷里三种失败模式分工明确:JointControlVideo 对齐最高(57.2)但关键保真最低(20.5);Cosmos 3 保真略高(22.2)却对齐明显低(33.7);OSCAR 是唯一两头都中游的(47.5 / 27.5)——跟手跟不上的 和 画不清的 是两种病。
6. 多视角在域际部署时缩水(Figure 9)
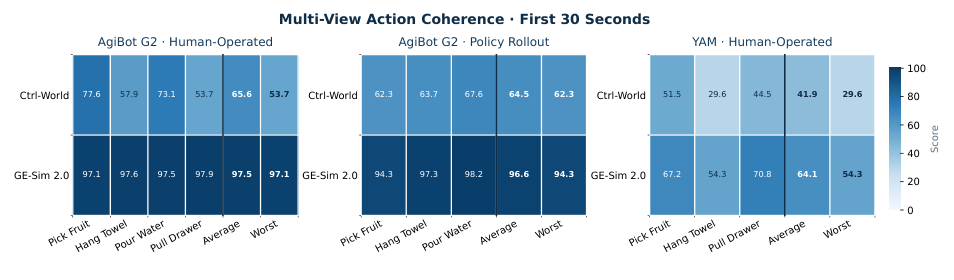
GE-Sim 2.0 在 G2 真人卷上多视角一致性 97.5,换到 YAM 掉到 64.1;Ctrl-World 从 65.6 → 41.9。多视角同步输出最难的地方在于多路镜头要画出同一个物理未来且风格一致——这解释了为什么多视角优势换个域就大幅缩水。
7. 物体 vs 机械臂:误差拆解(Figure 10)
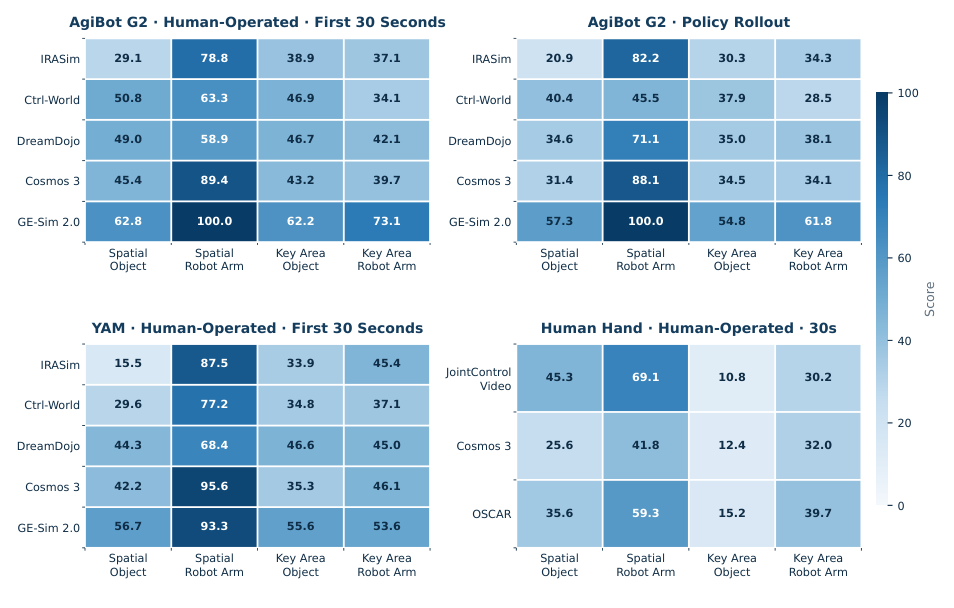
把空间对齐和关键保真分别按「物体掩码」「机械臂掩码」重算,三个分布里机械臂分都显著高于物体分:IRASim 在 AgiBot 30s 上臂 78.8 / 物体 29.1,Cosmos 3 是 89.4 / 45.4。这条「分体差」在所有模型上都稳定成立——世界模型可以完美「使唤机械臂」但不会让它手里的物体运动,因为接触动力学、材料与摩擦才是困难部分。
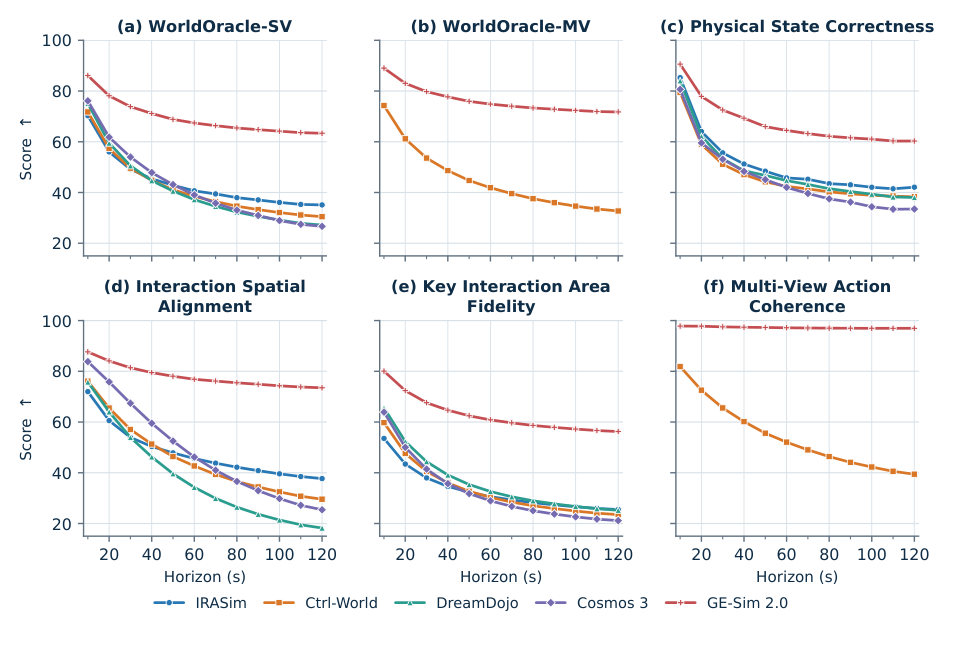
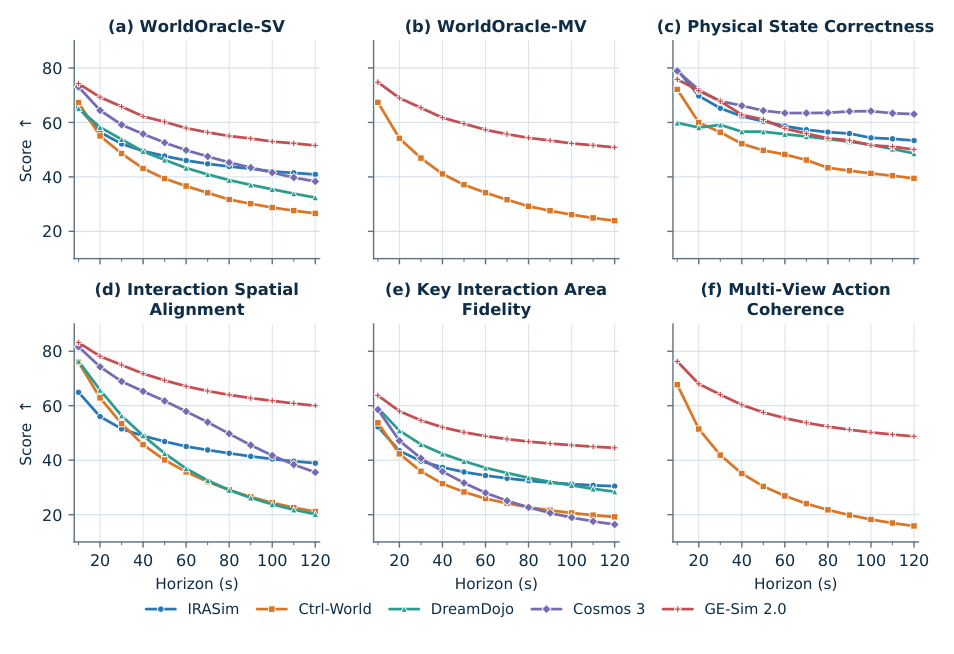
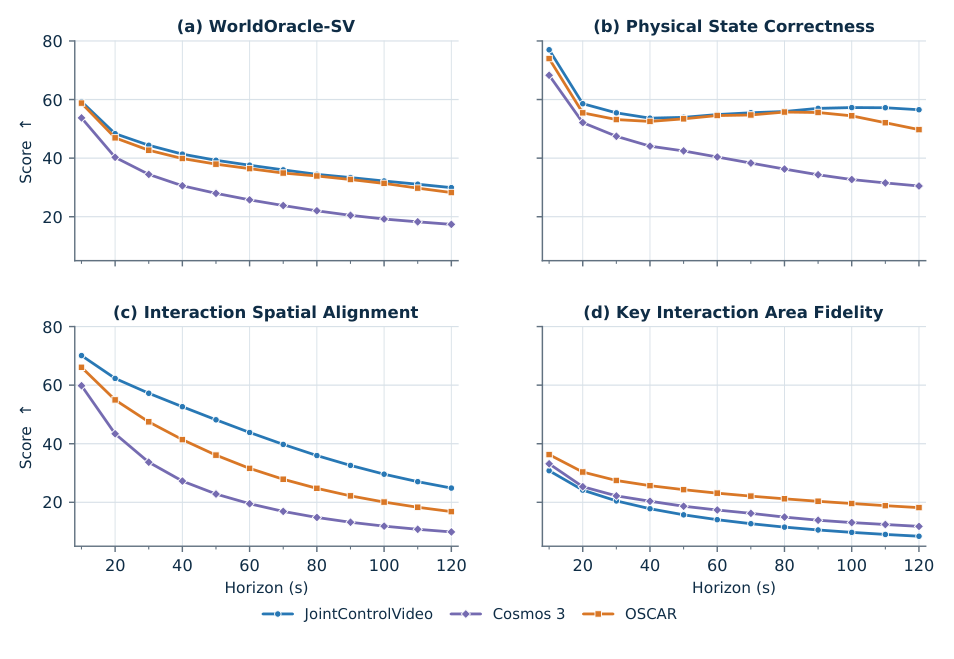
累积时间窗(从 10 秒到 120 秒)的曲线图(Figure 11/12/13)给出时间维度的细节:AgiBot G2 上 GE-Sim 2.0 综合从 86.1(10s)一路跌到 63.4(120s),其他模型最终落在 26.7–35.1 区间;Cosmos 3 在 60s 内还保持第二,之后跳水、被 IRASim 在 70 秒反超——短窗口优势撑不长时间。人手卷里物理正确性是最能「撑」的维度(JointControlVideo 120s 还有 56.5,而它的对齐/保真跌至 24.9/8.4):粗糙的「有没有碰到物体」比细粒度的接触渲染更能在长轨迹上存活。
🔬 校准:指标本身可信吗?
这部分是本文的方法论重点——毕竟「考官也要被考」。校准共分四摊,外加两页鲁棒性试验。
8. 人类调查:指标答案和人类一样吗
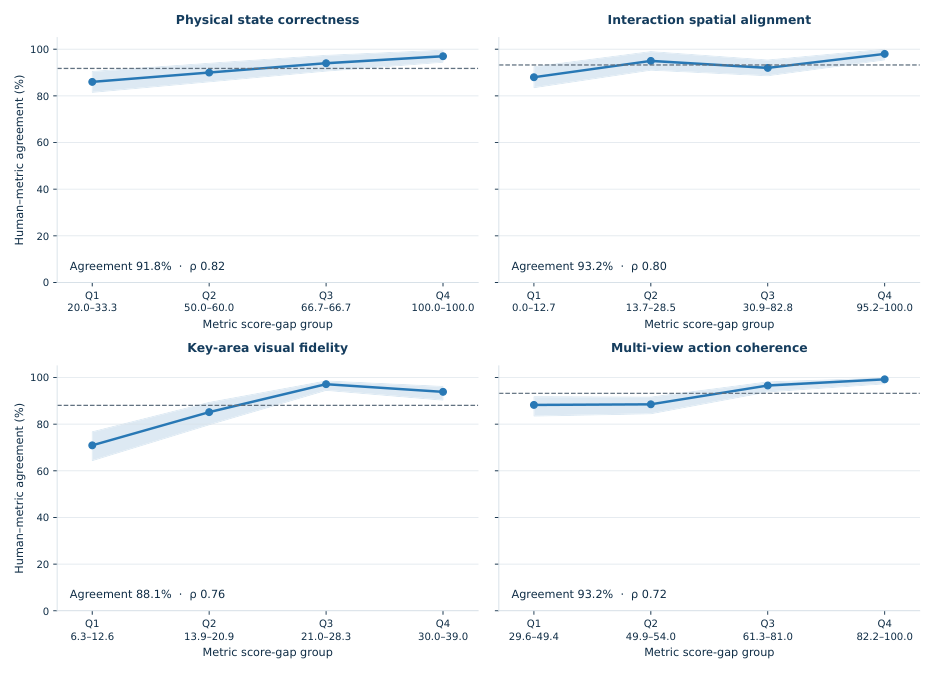
128 对 prediction pairs、119 名评分员、真人分布 + 策略 + YAM + 人手四摊都覆盖。人类偏好和指标偏好的总体一致率 88.1%–93.2%(各维度:物理 91.8%/ρ0.82、空间 93.2%/ρ0.80、保真 88.1%/ρ0.76、多视角 93.2%/ρ0.72),而且在分数差距小的 Q1 组(最难分辨的对子)里,一致率也大幅高于随机的 50%——这说明分数不是只在小误差被「好 easy」的样例拉起来。Spearman ρ 也是正相关的——分数差越大,人的倾向越坚定。
9. 指标互补性(那为什么不能合并成一个数)
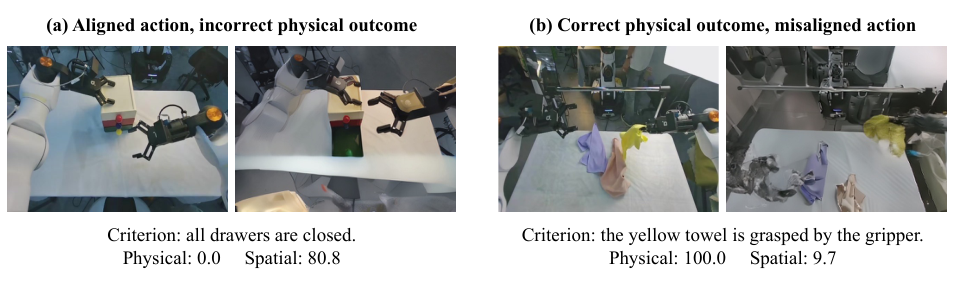
Figure 15 两个对子:(a) 拉抽屉——预测动作跟得漂亮(空间 80.8),但真实里三个抽屉全关上了预测却开着(物理 0.0);(b) 挂毛巾——「黄毛巾被抓着」的判据通过(物理 100.0),但整条手臂和毛巾的轨迹与真实差得远(空间 9.7)。没有哪个指标可以从另一个导出——outcome 对了但动作错了,或动作对了但 outcome 错了,明明白白是两种失败模式。
10. 保真指标的物理位置校准(Figure 16)
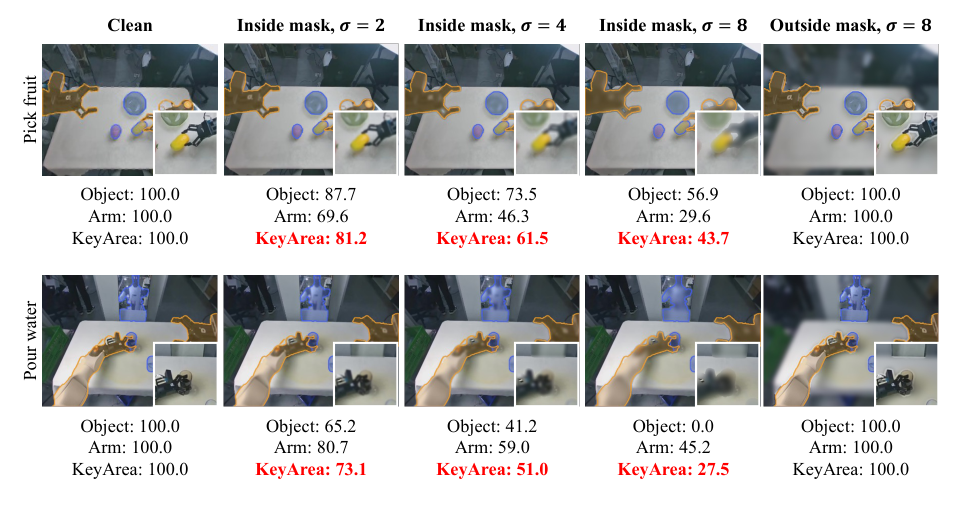
给一张干净的真实交互帧,只在掩码局部做高斯模糊(σ=2/4/8),保真分数跟着一路下跌:摘水果 100→81.2→61.5→43.7、倒水 100→73.1→51.0→27.5;而把同样强度的模糊只糊在背景时,两例分数纹丝不动(100.0)。这就证明它确实把「交互局部」看得比「背景整体」重——背景污染不会被误记成模型失真。
11. Outcome-swap:物理维度能否立刻感知错答
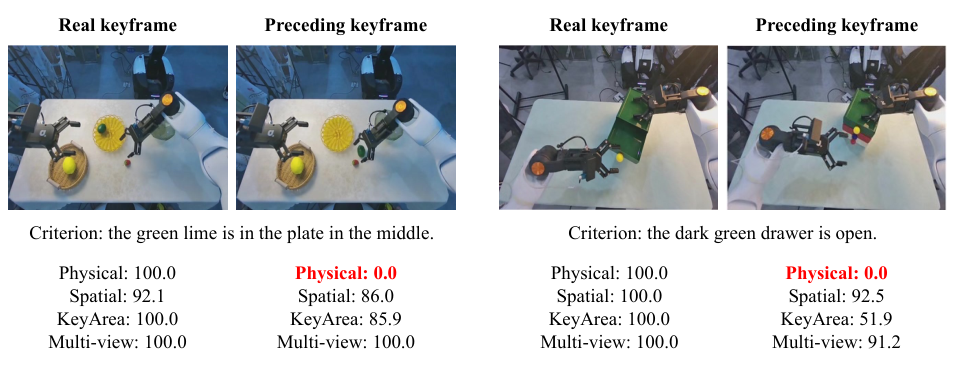
把一个 outcome keyframe 替换成同一 episode 里前一个 keyframe——画面布局相似、动作轨迹相似,但物理状态变了(青柠从中间的盘子里换到了别处)。40 个事件里,物理正确性平均相对降幅 67.9%,远大于保真 34.3%、空间对齐 20.0%、多视角 12.3%——每个指标被扰动的幅度正好对上它管的那摊事。
12. 多镜头不同步:灵敏度隔离
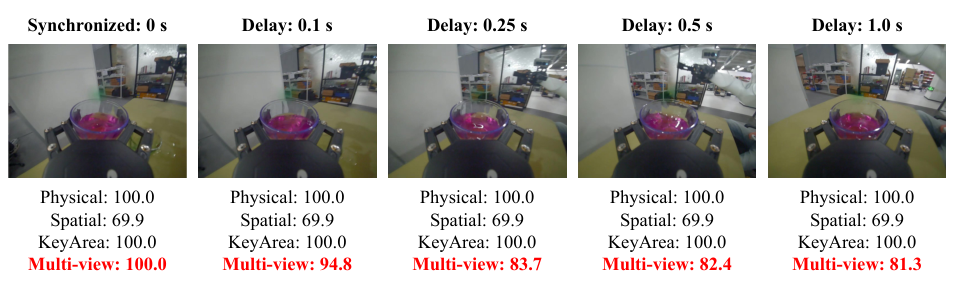
把左侧镜头单独推后 0.1 / 0.25 / 0.5 / 1.0 秒,四项里只有 multi-view 有反应(100.0→94.8→83.7→82.4→81.3,均值相对降幅 0.7%→1.7%→2.9%→4.4% 单调增长),三个 top_head 维度分数完全零变化(它们的评测只看头镜头)。选择性感应它该感应的东西。
13. 鲁棒性 + 超参敏感性
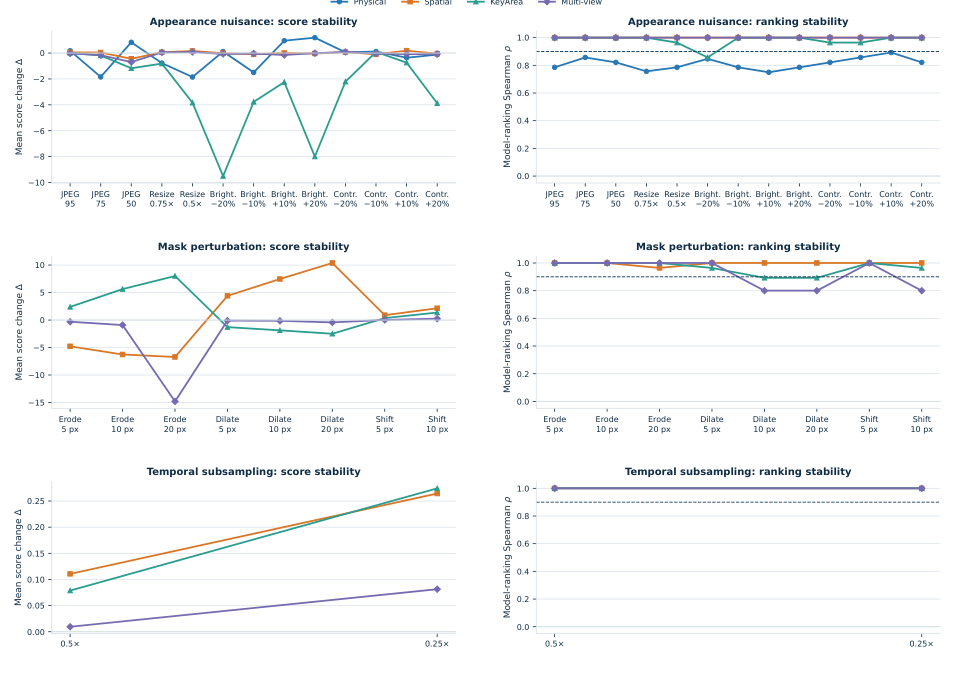
280 个 model–event 对、七模型——所有外观扰动下:空间对齐和多视角的分数几乎不动(均值变化分别在 ≤0.45 / 0.70 之内),模型排名不变(ρ=1.00);关键保真该跌就跌(0.5×下采样 −3.8、±20% 亮度 −8.0–9.5)——它本来就该对可见退化敏感,与「几何」指标有分工。掩码形变(腐蚀/膨胀/平移)会让绝对分动一下,但模型排名基本保稳(空间 ≥0.96、保真 ≥0.89、多视角最低 0.80);时序下采样到 0.25× 几乎等价(Δ≤0.27,ρ=1.00),就是说结论不依赖帧率。
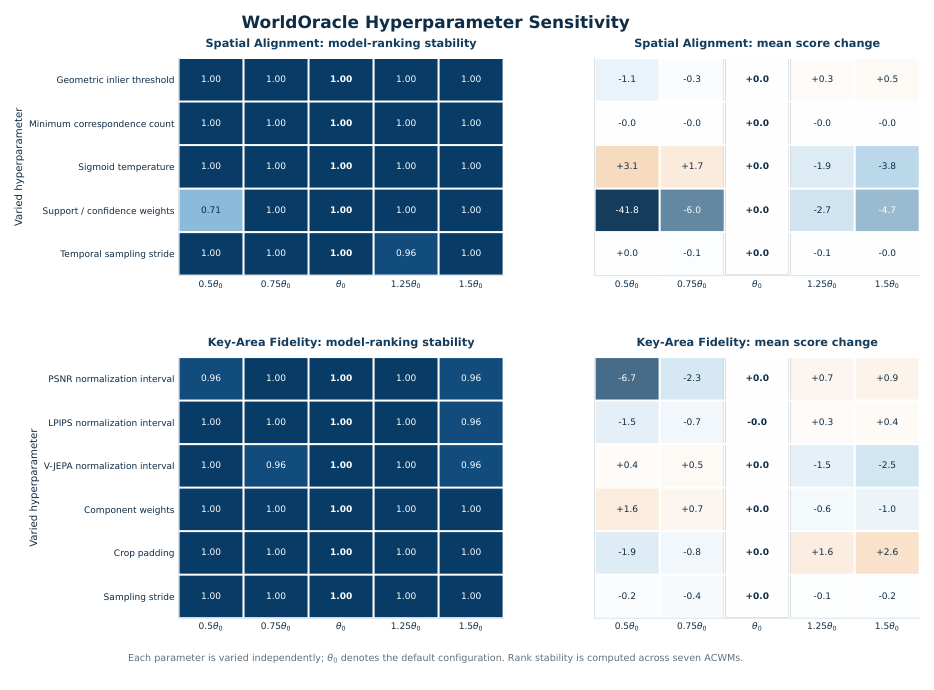
超参从 0.5θ₀ 到 1.5θ₀ 逐个单独扫:空间对齐的均值和排名基本稳(多数变化 ≤1.1 分),唯一明显的例外是「把特征置信度权重砍半」那一档——均值掉 41.8 分、排名 ρ 只有 0.71,而 0.75θ₀ 起排名完整恢复;关键保真超参全场 ρ≥0.96,最大偏移是 PSNR 归一化区间减半时的 −6.7 分。指标没有躲在调参的魔法里。
14. 为什么是 30 秒
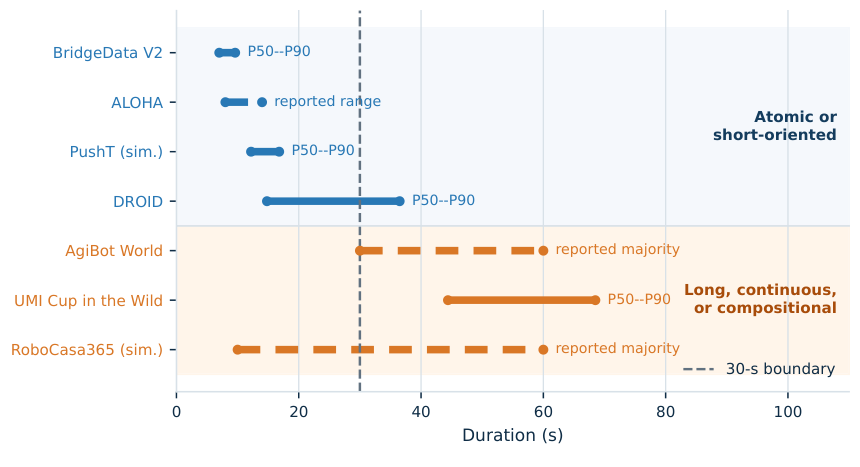
「短时程」这条界不是拍脑袋:BridgeData V2 的 P50–P90 是 7.0–9.6 秒、ALOHA 集中在 8–14 秒、PushT 12.2–16.8 秒、DROID 中位数 14.8 秒且 84.9% ≤ 30 秒——这些都是「原子动作」数据集;AgiBot World(多数 30–60s)、UMI Cup(P50–P90 44.4–68.5s)、RoboCasa365(多数 10–60s)这类长/复合行为数据集则整体跨过 30 秒。30 秒 ≈ 原子行为和复合行为的分界线,WorldOracle 因此把「首个 30 秒」当短时参考赛道,把 full-episode 当长时赛道。
💡 评析:一个 benchmark 的自省,两把手术刀,四条边界
三把最妙的地方
- 把「paired real execution」变成考题。对世界模型这种「 predicting 未来」的东西,考官不需要懂物理——同一串动作在真实世界跑过一遍,答案就是「那串动作下来物件真的会那样」。这也是它和 WorldArena(在 sim 里考功能)、RBench(图像/语义打分)最不同的地方。
- 失败的解剖学,不是排行榜。长轨迹衰减(Figure 11–13)、跟手跟得好但 outcome 错(GE-Sim 与 IRASim 的差分)、多视角跨域缩水(Figure 9)、物体动力学跟不上(Figure 10)——四个维度不做减法(不合并成一个黑箱数),所以每种失败都记录在案,且每一种都用受控实验校准过(Figure 16/17/18)。
- 校准比榜单还长。人类对照(128 对 / 119 人 / 88.1–93.2%)、判据自洽(真实关键帧 100% 通过)、干预实验(swap / 模糊 / 时延 / 扰动 / 超参)样样俱全——这在 embodied benchmark 论文里是少见的。
四条边界(论文 Limitations 与评析)
- 一个 episode 只有一份真实执行——对随机性强的接触、流体、可变形物场景,「真实」只取了一支。要更公平,需要多次重跑同一初始条件来估计 real-real 波动;一次执行既无法区分「模型错」和「环境随机」,也会把微小的时钟差异计入分数。
- 本体间适应预算不对等:AgiBot G2 有专门训练集、YAM 用公开数据(域差更大)、人手零样本——因此不能拿三卷总分排「本体难度」,跨卷看模型时尤其小心;作者也明确说了这组对比只是观察性(observational)的。
- 观察性因果关系:「像素对齐条件化」跟好成绩绑在一起(GE-Sim 2.0),但各模型的预训练、架构、记忆长度都不一样——它的领先不能被解读为「把动作画成图」这个设计本身的因果证明,还得靠控制变量的消融来证实。
- 范围窄:3 种本体、4 个任务、policy 只有 G2 一份考卷——离「操作世界模型通考」还差多样性(YAM/人手还没有 policy 卷,透明物、柔性长时变形等物理过程也未覆盖)。
🗺️ 在 WAM 评测谱系里的位置
| 路线 | 代表 | 评测什么 | 对照 |
|---|---|---|---|
| 生成质量型 | EWMBench、RBench、WMBench | 视频质量 / 语义 / 物理合理性 | instruction-level,不设动作条件 |
| 真实世界物理型 | PAI-Bench、WoW-World-Eval、RoboWM-Bench | 条件能力 / 物理理解 | 多为图文条件,动作条件弱或需 real2sim |
| 仿真功能型 | WorldArena / WorldArena 2.0 | 作为数据引擎 / 策略评测器 / planner | 在仿真里测功能,不对照真实执行 |
| 对照真实执行型(本文) | WorldOracle | 同观测同动作下预测 vs 真实的一致性 | 标准答案来自真实物理 |
| 仿真-真机一致性 | X2Real | 策略在仿真分数与真机分数的相关性 | 考是「策略成不成立」,不评生成画面质量 |
站内延伸:《X2Real 精读》(另一把「仿真-真机」标尺)、《Cosmos3-世界基础模型精读》(被考的 Cosmos 3)、《π0.5开放世界泛化精读》(policy-track 的动作来源)、《DROID机器人操作数据集精读》(π0.5 的起点 checkpoint)、《Flash-WAM 精读》、《PrismWAM 精读》(同期 WAM 方法精读)、《WAM 世界行动模型全景分析》、《什么是世界模型》。
📊 图表总索引
| 图号 | 内容 | 在本文中的位置 |
|---|---|---|
| Fig 1 | 核心问题:ACWM 幻觉抓取 vs 真实失败 | 开篇 |
| Fig 2 | Benchmark 总览(三种动作源 + 四个维度) | 问题 |
| Fig 3 | 标注流水线(分段 / 判据 / 掩码) | 方法 |
| Fig 4 | 四维度高/中/低分示例 | 指标 |
| Fig 5 | AgiBot G2 真人卷每任务热图 | 实验 5 |
| Fig 6 | AgiBot G2 policy 卷每任务热图 | 实验 5 |
| Fig 7 | YAM 真人卷每任务热图 | 实验 5 |
| Fig 8 | Human hand 每任务热图 | 实验 5 |
| Fig 9 | 多视角动作一致性热图 | 实验 6 |
| Fig 10 | 物体 vs 机械臂误差拆解 | 实验 7 |
| Fig 11–13 | 累积时间窗曲线(G2 / YAM / 人手) | 实验 7 |
| Fig 14 | 人类对照调查(一致率/ρ) | 校准 8 |
| Fig 15 | 互补失败两例(物理 vs 空间) | 校准 9 |
| Fig 16 | 掩码局部模糊对照 | 校准 10 |
| Fig 17 | Outcome-swap 干预 | 校准 11 |
| Fig 18 | 交叉视角时延对照 | 校准 12 |
| Fig 19 | 外观/掩码/时序扰动鲁棒性 | 校准 13 |
| Fig 20 | 超参敏感性 | 校准 13 |
| Fig 21 | 公开数据集时长分布与 30s 边界 | 校准 14 |
表格:Table 1 与其他 embodied benchmark 的功能矩阵;Table 2 AgiBot G2 真人卷(30s/Long);Table 3 AgiBot G2 policy 卷;Table 4 YAM 卷;Table 5 Human Hand 卷;附录 Table S1 训练统计(1,779 条 30h)、S2 评测统计(335 条 9.72h)、S3 训练配置、S4 架构/接口配置。
❓ 自测 Q&A
Q1:WorldOracle 为什么坚持「paired real-world execution」这种苛刻的对答案集? A:没有真实执行当锚点,评测只能对「看起来像不像机器人操作」打分——这很容易被「画面真实感」误导而漏掉「物理没发生」的幻觉。有了同观测 + 同动作 + 真实结果,物理正确性就不用人主观判断,VLM 只需要对照一份可判定的判据清单看图。
Q2:直接比较「预测 vs 真实」的逐帧像素,不就变成 PSNR 大赛了?为什么还要造四个指标? A:因为整帧像素由背景主导、往往漏掉局部错误。所以在整帧之外才有了局部(关键区域保真)、outcome 级(判据)、轨迹级(空间对齐)、多镜头一致性(多视角)四个互补维度。而且每个指标都用受控实验确认过「该对什么敏感」(Figure 16–18)。
Q3:三种动作分布(真人 / policy / 人手)各自考察什么? A:policy 卷(带犹豫/抖动/纠正)专考「跟得上一股分布外的动作」——它明显和遥操作分布不同;人手卷零样本考验的是不靠训练直接建模人手这种高自由度、可变形、细粒度接触的实体;真人卷作为参照系,量模型在标准遥操作分布上的底线。
Q4:GE-Sim 2.0 独一档的原因是什么?证据链有哪些东西? A:证据分三层:(i) 它在所有机器人卷的空间对齐上明显领先(AgiBot 81.4 / YAM 74.97 / policy 78.7);(ii) 它把末端执行器位姿渲染成像素对齐轨迹图再叠加 Plücker 射线图做条件——动作和它在画面里的位置直接挂上钩;(iii) 它还联合预测本体感受状态(多感觉输出)。但作者明说:模型间预训练、记忆长度、机器形态都不同——领先只能说「关联」不能说「因果」。
Q5:什么时候会看到「跟手跟得好,但物理结局错了」?怎么分辨这两种失败? A:GE-Sim 2.0 在 G2 Long 组的空间对齐 73.49、多视角 96.96,但物理正确性只有 60.26;Figure 15(a) 的抽屉也是同一型(空间 80.8 / 物理 0.0)。分辨方式就是看两个不同 axis 的分数——机械臂的轨迹 vs 物体的最终状态。两者的修法也不一样(动作轨迹的条件化 vs 生成的接触动力学)。
Q6:既然有三个维度的分,「WorldOracle-SV」这个综合分还有什么用? A:SV 只是为了排序方便——四个维度等权平均。但本文的立场是不要只看综合分:它还在每个区块里列出 Worst,帮你看到「平均好看、单项烂」的盲区,因为不同模型的失败方式不会同时体现在一个数里。这就是为什么热图和拆解占这么大篇幅。
📚 资源与延伸
- 论文:arXiv 2610.18826
- 数据:huggingface.co/WorldOracle
- 代码:github.com/AgibotTech/WorldOracle
- 排行榜:worldoracle-benchmark.github.io/leaderboard.html
- 网站:worldoracle-benchmark.github.io
- 被考的模型:π0.5、GE-Sim 2.0、Ctrl-World、DreamDojo、Cosmos 3、IRASim、JointControlVideo、OSCAR
- 关键前作/评测先例:WorldArena(arXiv 2602.08971)、WorldArena 2.0(arXiv 2605.17912)、EWMBench(arXiv 2505.09694)、PAI-Bench、RBench、RoboWM-Bench、SC3-Eval(arXiv 2606.18610)
- 站内延伸:《X2Real 精读》、《Cosmos3-世界基础模型精读》、《π0.5开放世界泛化精读》、《PrismWAM 精读》、《UniWAM 精读》、《LoopWAM 精读》、《HexaShell 精读》、《WAM 世界行动模型全景分析》、《什么是世界模型》