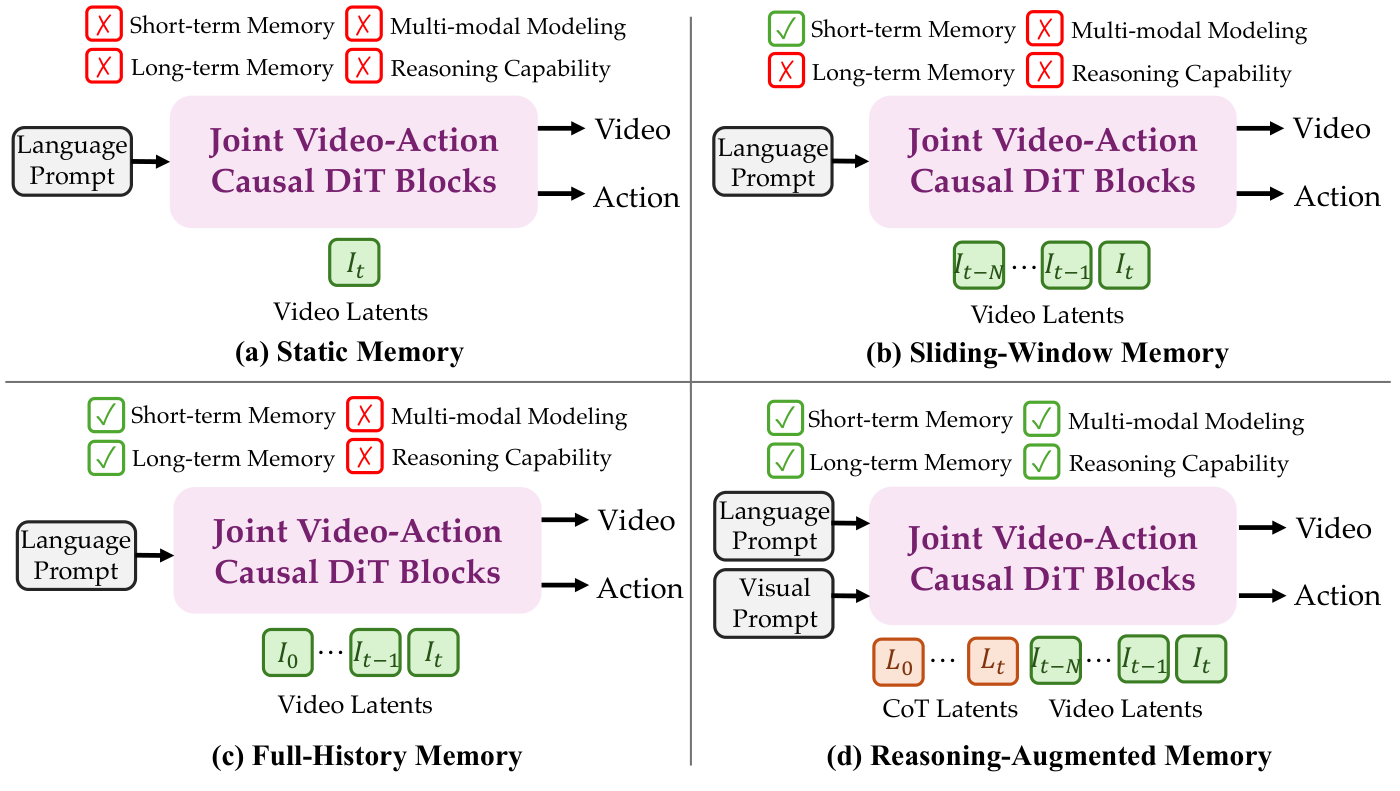
配图说明:本文收录论文全部 11 张插图(Figure 1 ~ Figure 11),放在站内 /images/worldscape/,逐张讲解,文末附图表总索引表。论文 WorldScape Policy 2.0: Empowering Steerable World Action Modeling with Reasoning-Augmented Memory and In-Context Learning(Manifold AI、清华、上交,2026-07;v2 2026-09-20),项目页 manifoldai-research.github.io/WorldScape-Policy。注意:榜单上的 WorldScape-R2SI 就是该系列在 RoboDojo 上的条目,不是另一篇论文。
📄 论文信息
- 标题:WorldScape Policy 2.0: Empowering Steerable World Action Modeling with Reasoning-Augmented Memory and In-Context Learning
- 机构:Manifold AI(WorldScape 团队)、清华大学、上海交通大学
- 时间:2026-07-20(arXiv 2607.18840;v2 2026-09-20)
- 关键词:WAM、因果短期视觉记忆、事件记忆(global / local-active / event-boundary)、DiT prefill、semantic forcing、ManipEvent-5M、多模态提示(text / goal-image / video)、三阶段训练
- 一句话总结:把「最近几帧视觉」和「整段历史事件」分开管理,再用语义强制把子任务语义灌进规划——既保局部接触动力学,又保长程进度;同一模型既能自主规划,又能被细粒度文本 / 目标图 / 视频演示直接操控。
🎯 一句话版本:核心数字
| 指标 | 数值 | 说明 |
|---|---|---|
| RoboTwin 2.0(clean+random 细调 50K) | 平均 94.3% SR | clean 94.3 / random 94.2;比 π0.5 平均高 14.5 pp |
| C2R(只训 clean) | 60.1% 平均 SR | 比 π0 高 28.7 pp、比 Fast-WAM 高 20.2 pp |
| ManipEvent-5M | ≈500 万事件段 | 动作轨迹 + 指令 + 子任务字幕 + 目标图 + 视频 |
| 真机 PiPER 折叠 / 桌面清理 | 75% / 80% | 长程自主规划 + 顺序细粒度控制 |
| Shell game / 示范积木 | 75% / 60–70% | 记忆依赖 + 视频跨本体 ICL |
| 细粒度指令 in-domain / OOD | 86.7% / 60.0% | π0.5:63.3 / 43.3;DreamZero:51.7 / 30.0 |
| 消融:加 STM→LTM→LSR | 平均 +4.67 → +更多 → 最优 | 记忆组件逐项有效 |
| RoboDojo(WorldScape-R2SI) | 39.35% SR / 46.6 progress | Memory 63.7%、Open 47.5%(学习型最强档) |
🗺️ 仿真 vs 真机:一眼分清
| 基准 / 场景 | 类型 | 说明 |
|---|---|---|
| RoboTwin 2.0(50 任务 × 100 次) | 仿真 | 主对比:clean+random 细调 50K 步 |
| RoboTwin C2R | 仿真 | 只用 clean 演示训练,测 OOD 随机化 |
| RoboDojo(R2SI 条目) | 仿真 | 榜单数字;与 HexaShell/VPP2 等同场 |
| 双臂 PiPER(折叠 / 清理 / shell / 积木) | 真机 | 每任务 20 trials,报平均 SR |
| LIBERO 等 | — | 摘要/消融中提及设置,正文以 RoboTwin + 真机为主 |
🧭 读前 5 分钟:四个概念
- WAM(World Action Model):联合建模视觉状态转移和机器人动作,而不是 VLA 只吐动作。可控性来自「可以问它世界会怎么变、动作怎么给」。
- 因果短期视觉记忆(STM):最近观测序列作为 DiT 的 prefill(前缀条件),保住局部接触与动力学,避免只看单帧丢短期上下文。
- 长短期事件记忆(LTM):历史 VLM 输出不是全堆上下文,而是拆成
- global-history:整段任务级摘要/历史;
- local-active:当前活跃子任务窗口;
- event-boundary:事件边界(子任务切换点)。
按进度感知检索,再门控进当前推理 token。
- Semantic forcing(语义强制):把事件级子任务指令的语义,压进隐式规划(latent planning)路径——即使最终不直接吐文本,规划也要「按事件推进」。
多模态可控提示:同一模型接受 (a) 高层语言自主规划,(b) 细粒度文本指令,(c) 目标图像,(d) 视频演示(跨本体 ICL)。
🛠️ 方法:记忆三分 + 三阶段训练 + 操控接口
框架总览
观测与可互换的文本 / 目标图 / 视频演示一起编码;VLM 侧维护推理增强记忆;规划 token 进入扩散 / DiT 头生成动作,STM 同时作为视觉 prefill。数据底座是 ManipEvent-5M。
三阶段学习(论文策略)
- Stage-1 事件接地预训练:在 ManipEvent-5M 上建立事件级语义 ↔ 动作 ↔ 多模态提示的对齐;
- Stage-2 记忆感知中训:加入 STM / LTM / 检索门控,让模型学会「进度感知」地用历史;
- Stage-3 语义强制 + 下游后训:semantic forcing 把事件语义灌进规划;再在下游基准(RoboTwin 等)后训。
消融显示:去掉 SF、去掉 Stage-2 等都会掉点(见正文 Table 消融);记忆消融里 STM 单独就带来 clean/random/average +3.42 / +5.92 / +4.67 pp,再加 LTM 与 LSR 到最优。
ManipEvent-5M 数据构造
聚合来源包括:人臂 ego 视频、无机器人 UMI、仿真轨迹、真机演示——统一转成事件段:对齐动作轨迹、整段任务指令、段级子任务字幕、目标图像、视频演示。标注流水线两阶段时序-语义打标 + 层级 episode/event 采样 + 多视角冲突消解(左夹爪 → 右夹爪 → 头)。细节见 Figure 5–9。
📸 逐图讲解(Figure 1 ~ 11)
Figure 1:四种 WAM 范式对比
(即文首头图。)- (a) 静态观测:单帧,无历史(典型 VLA);
- (b) 短期视觉历史:滑窗几帧,无进度推理;
- (c) 全历史视觉记忆:堆所有帧,但无进度感知检索、多为纯文本条件;
- (d) WorldScape 2.0:因果 STM(DiT prefill)+ 进度感知事件记忆 + 多模态条件(text / goal-image / video)。
这张图定义了全文要打的靶子:记忆要「分层 + 可检索 + 可操控」。
Figure 2:框架总览——事件数据 + 可互换提示 + 记忆
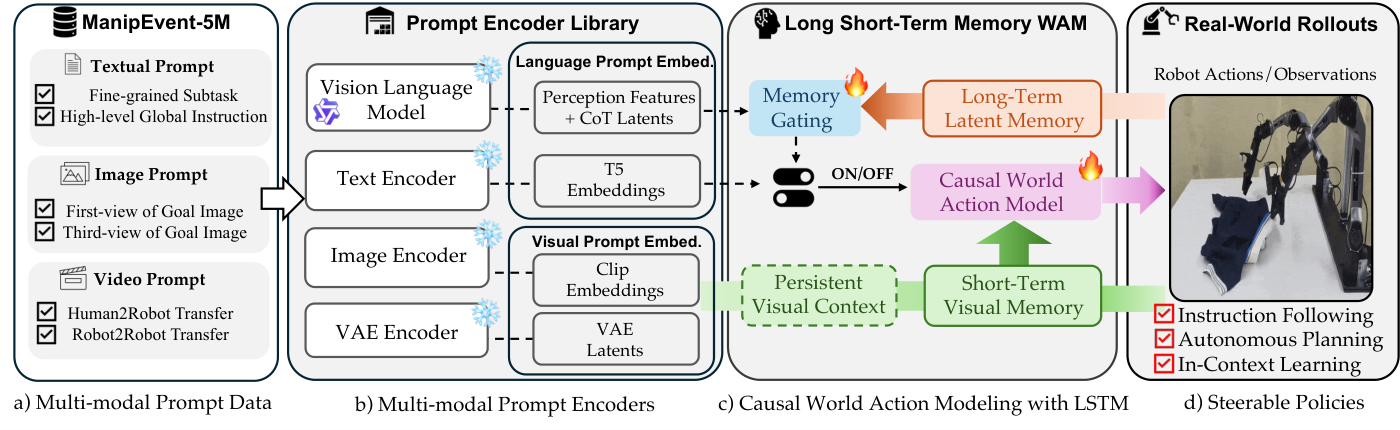
左侧:基于事件的 ManipEvent-5M 预训练。中部:观测与可互换的文本、目标图像、视频演示提示一起进入编码。右侧:推理增强记忆与规划头,输出动作。读图顺序:数据 → 提示接口 → 记忆 → 策略。
Figure 3:推理增强长短期记忆
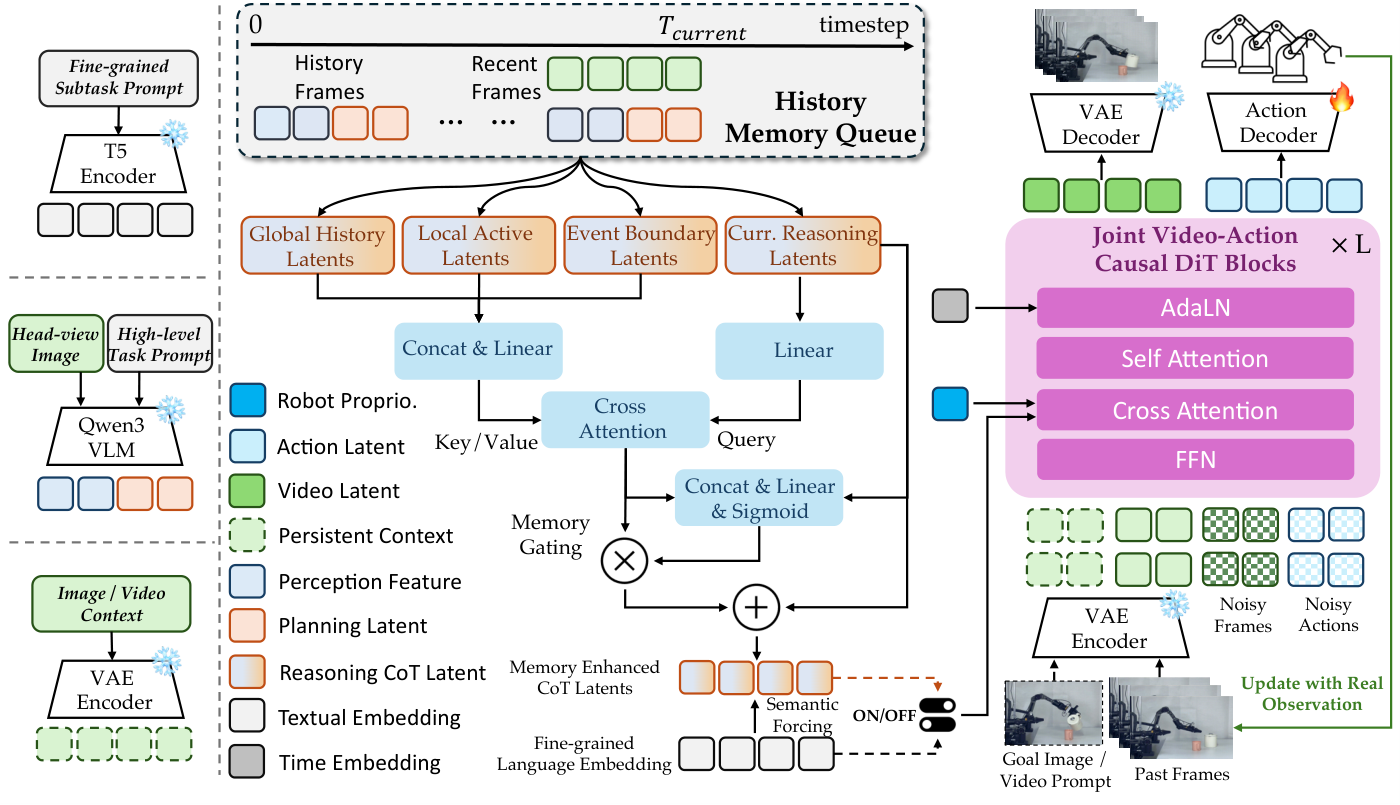
历史 VLM 输出被组织成三类记忆(global-history / local-active / event-boundary);检索器按当前进度取相关事件,门控后并入当前推理 token;同时 STM 作为 DiT prefill 保住最近视觉上下文。检索结果既增强感知,也增强自回归规划 token,形成隐式子目标条件——这就是「reasoning-augmented」的含义。
Figure 4:注意力掩码
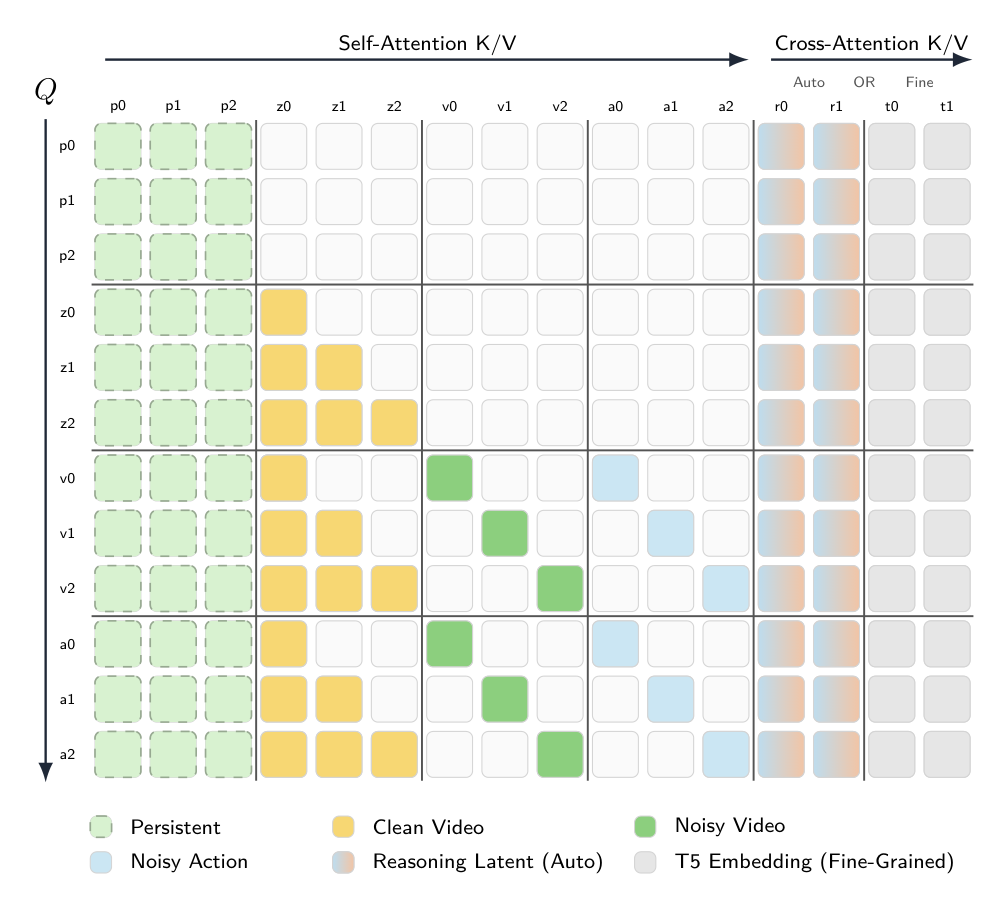
展示哪些 token 可以看见哪些历史(事件记忆窗口、当前观测、提示条件的可见性约束)。工程含义:记忆不是无限全连接,而是按角色切窗口,控制算力并强制进度结构。
Figure 5:ManipEvent-5M 构造流水线
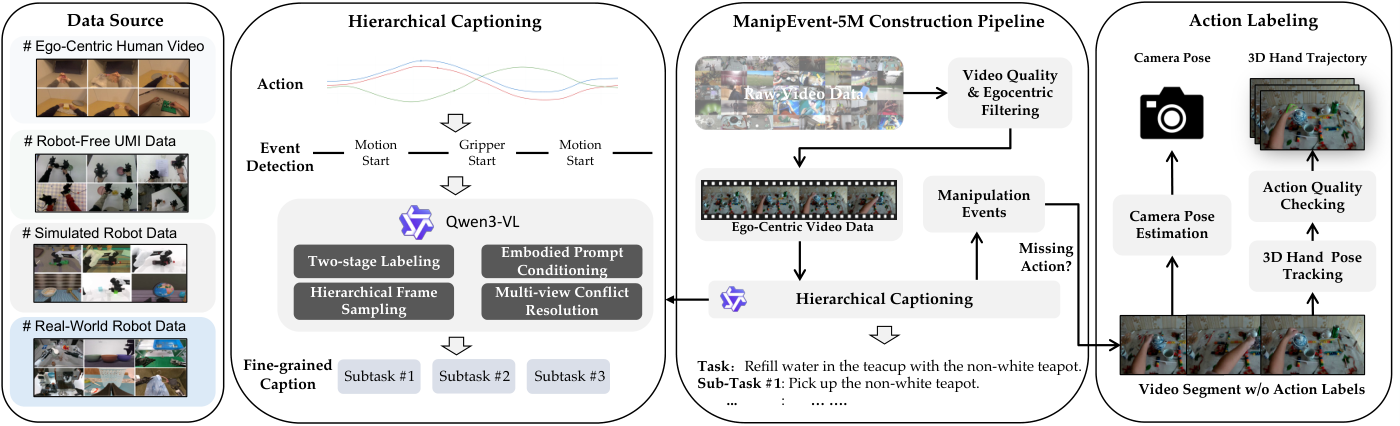
聚合异构来源 → 统一成事件段 → 对齐动作 / 指令 / 子任务字幕 / 目标图 / 视频。关键设计是事件级对齐,而不是只留整段 episode 标签。
Figure 6:层级字幕示例
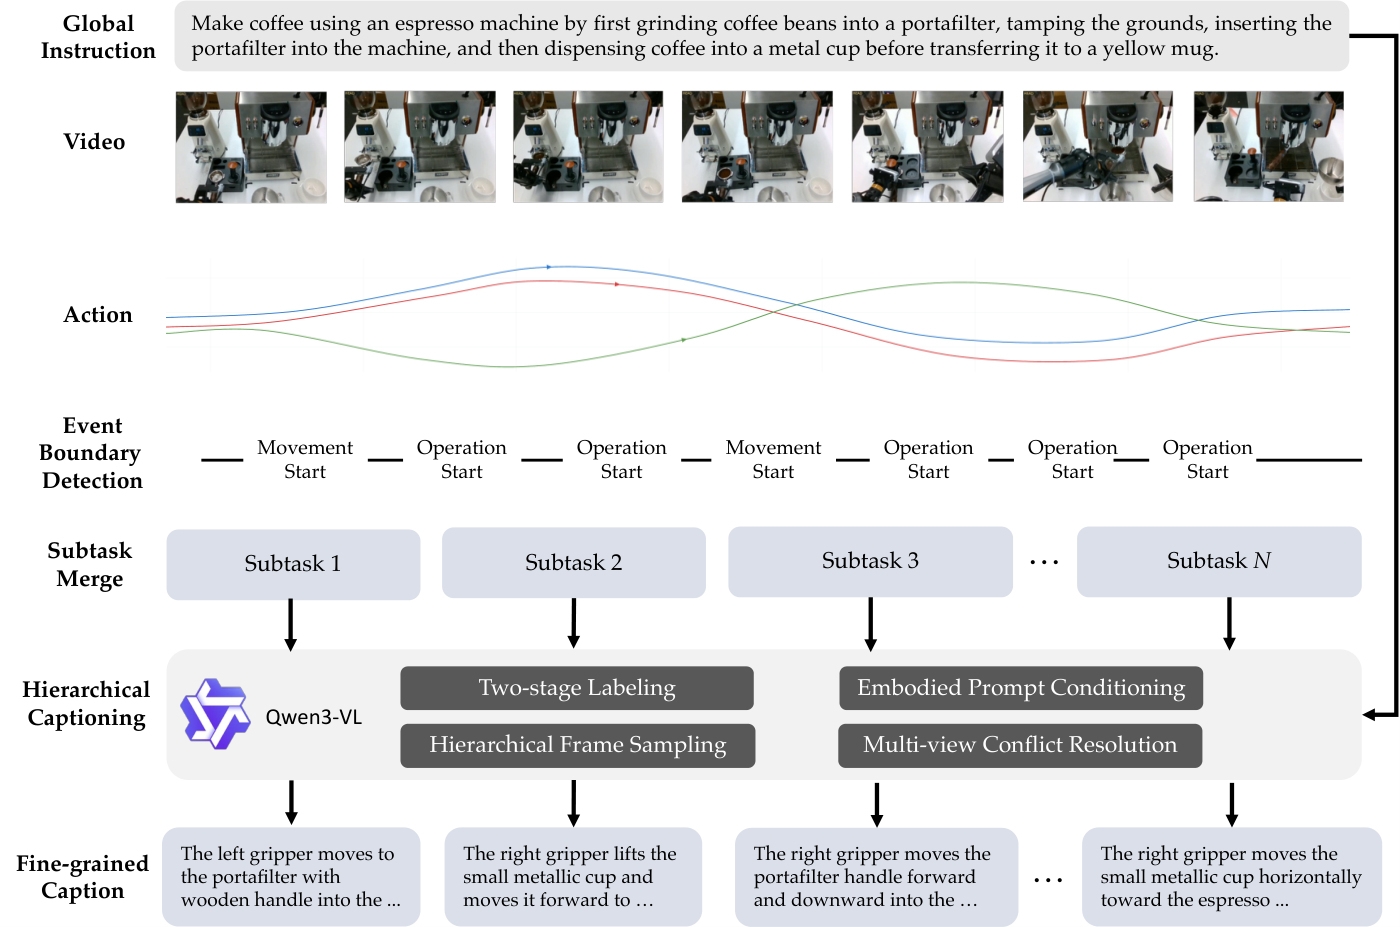
两阶段时序-语义打标 + episode / event 双层帧采样 + 具身提示条件 + 多视角冲突消解。左侧展示原始多视角,右侧是整理后的事件字幕结构——解释了为什么模型能做「按子任务细粒度控制」。
Figure 7:数据分布统计
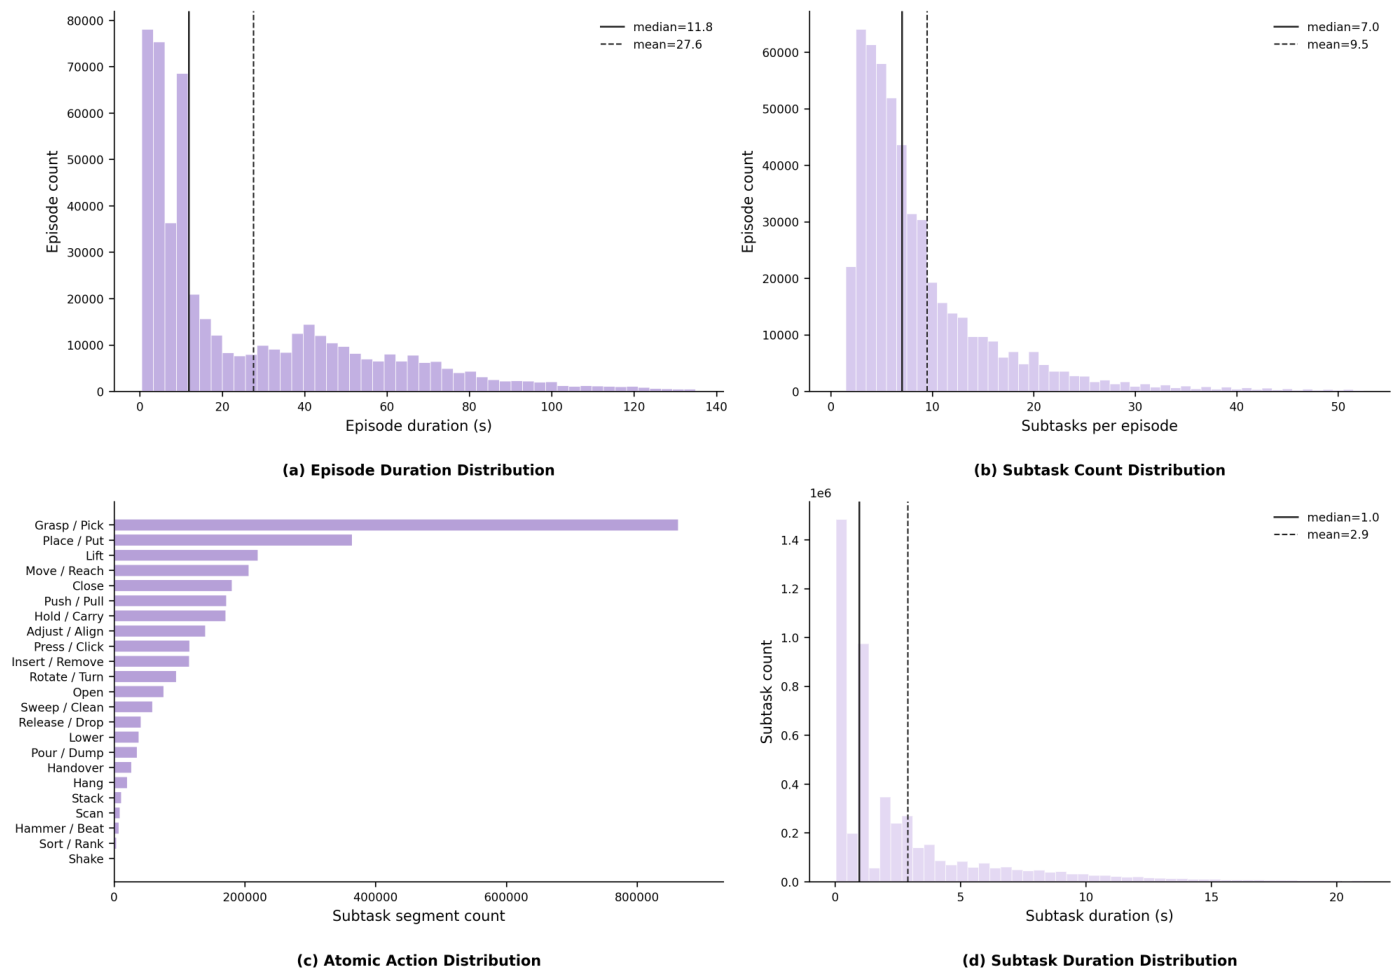
事件时长、子任务数、原子动作、子任务时长的分布,按真实 / 仿真 / 不同机器人来源拆分。用途:说明数据长尾被覆盖,不是只堆某一类短任务。
Figure 8:多模态提示示例——桌面清理
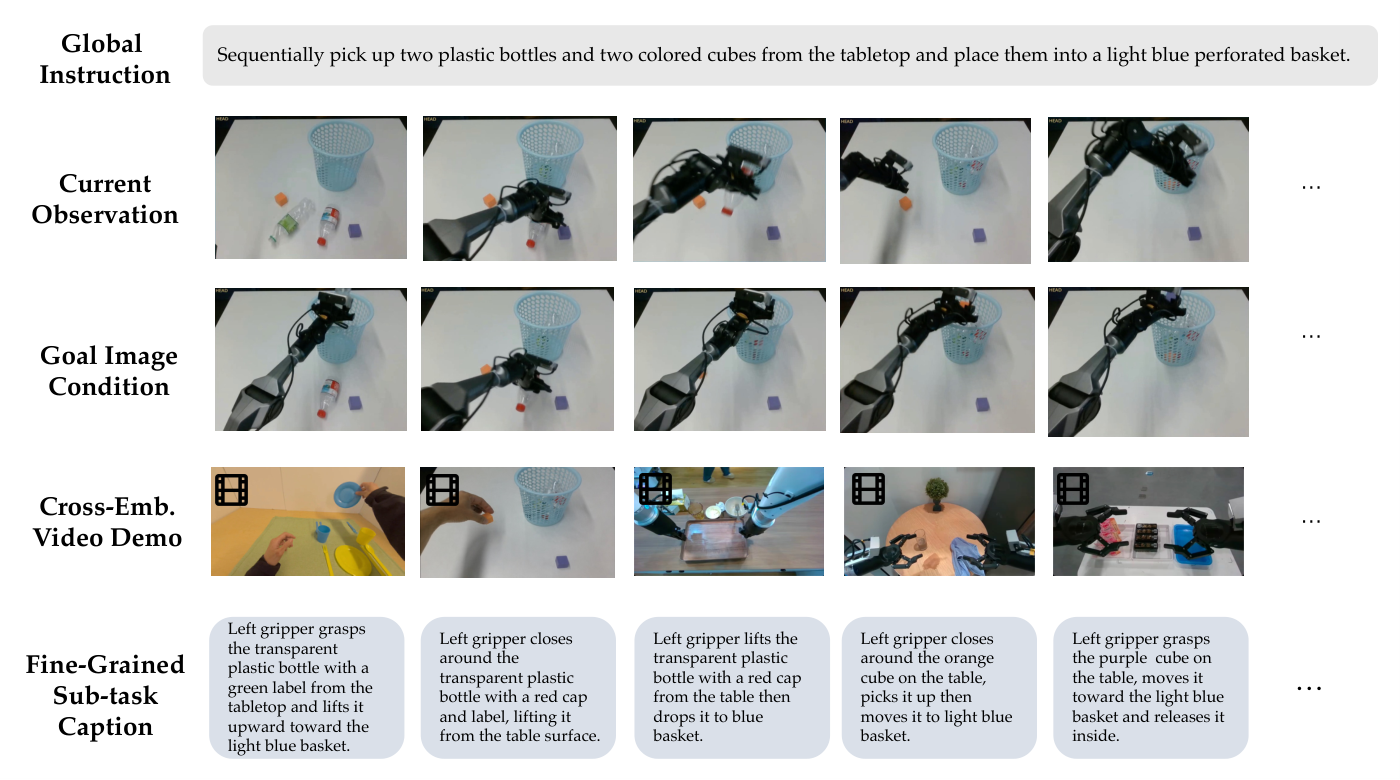
把「全局指令 + 当前观测 + 目标图像条件 + 事件级细粒度子任务字幕 + 跨视角」拼成一条可控样本。读者可对照:同一策略既能吃高层指令,也能吃子任务字幕。
Figure 9:多模态提示示例——咖啡制作
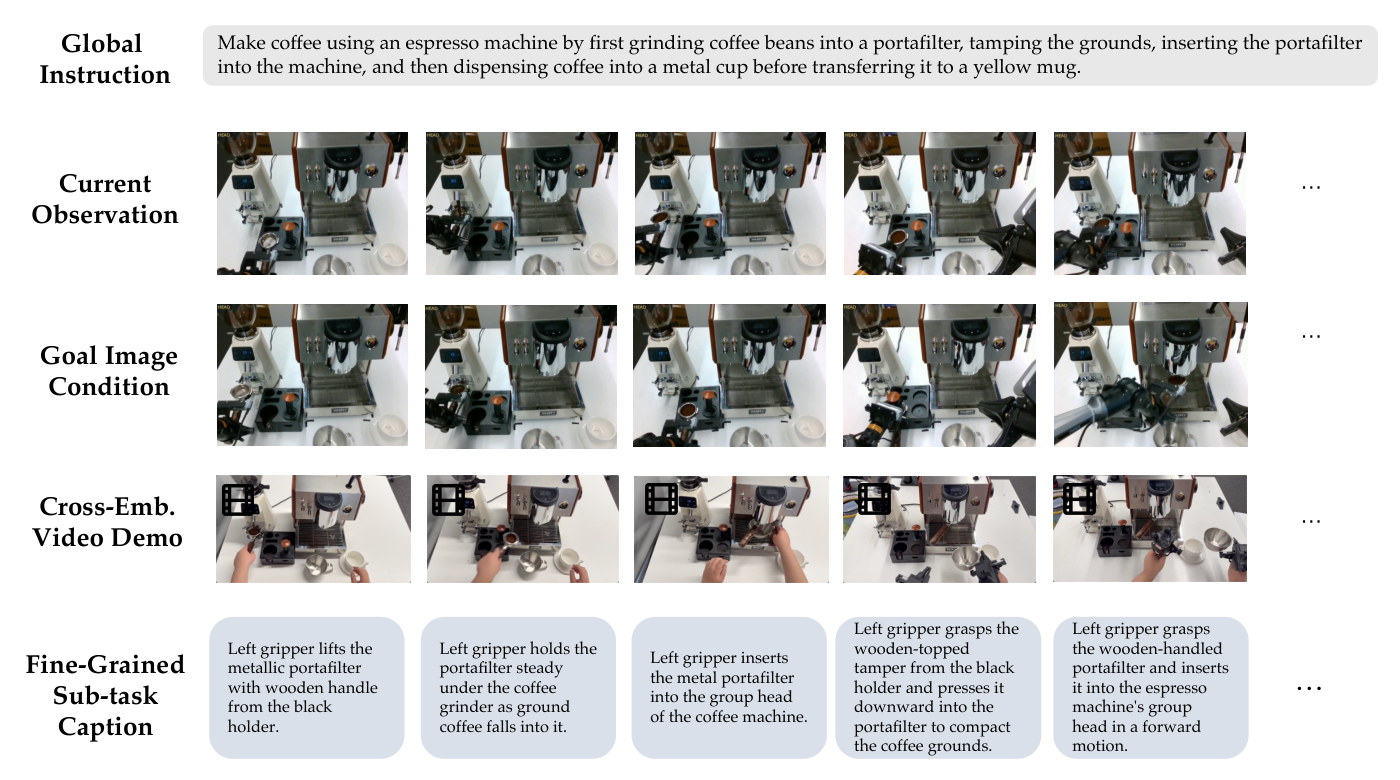
与 Figure 8 同构,换成长程多阶段任务;强调事件边界处字幕切换,支撑进度感知记忆的必要性。
Figure 10:RoboTwin 2.0 标准与 C2R 对比
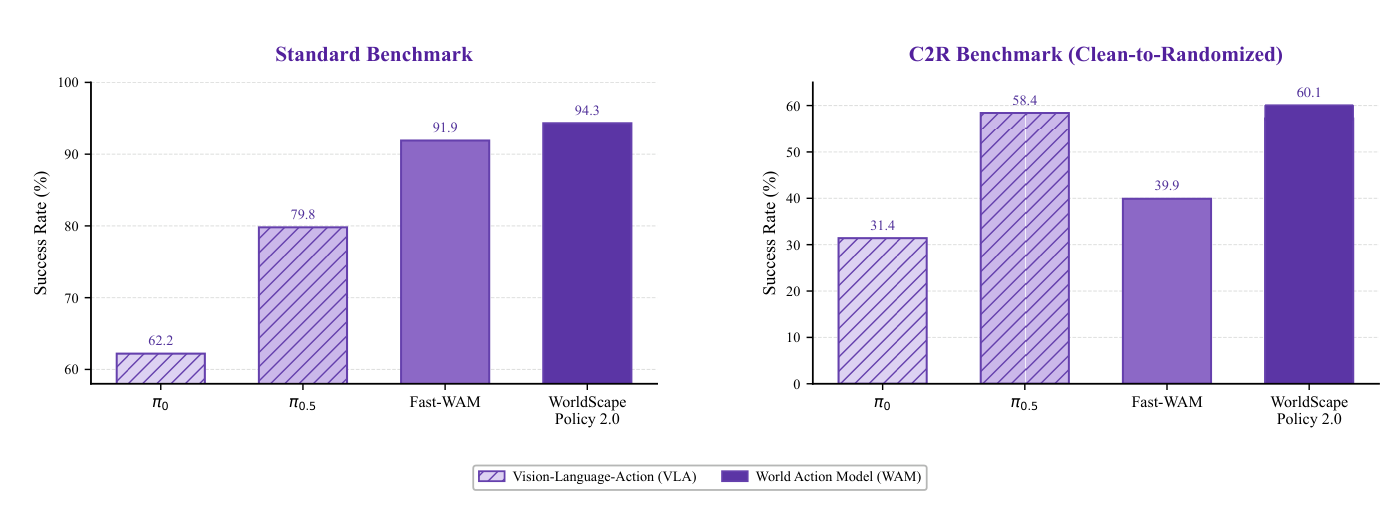
- 标准协议:clean+random 训练 → WorldScape 平均 94.3%,显著高于 π0.5、Fast-WAM、LingBot-VA 2.0 等;
- C2R:只训 clean → 平均 60.1%,比 π0 高 28.7 pp。
图中斜纹柱为 VLA、实心柱为 WAM——直观显示「事件预训练 + 记忆」在 OOD 上的优势。
Figure 11:真机双臂 PiPER 任务
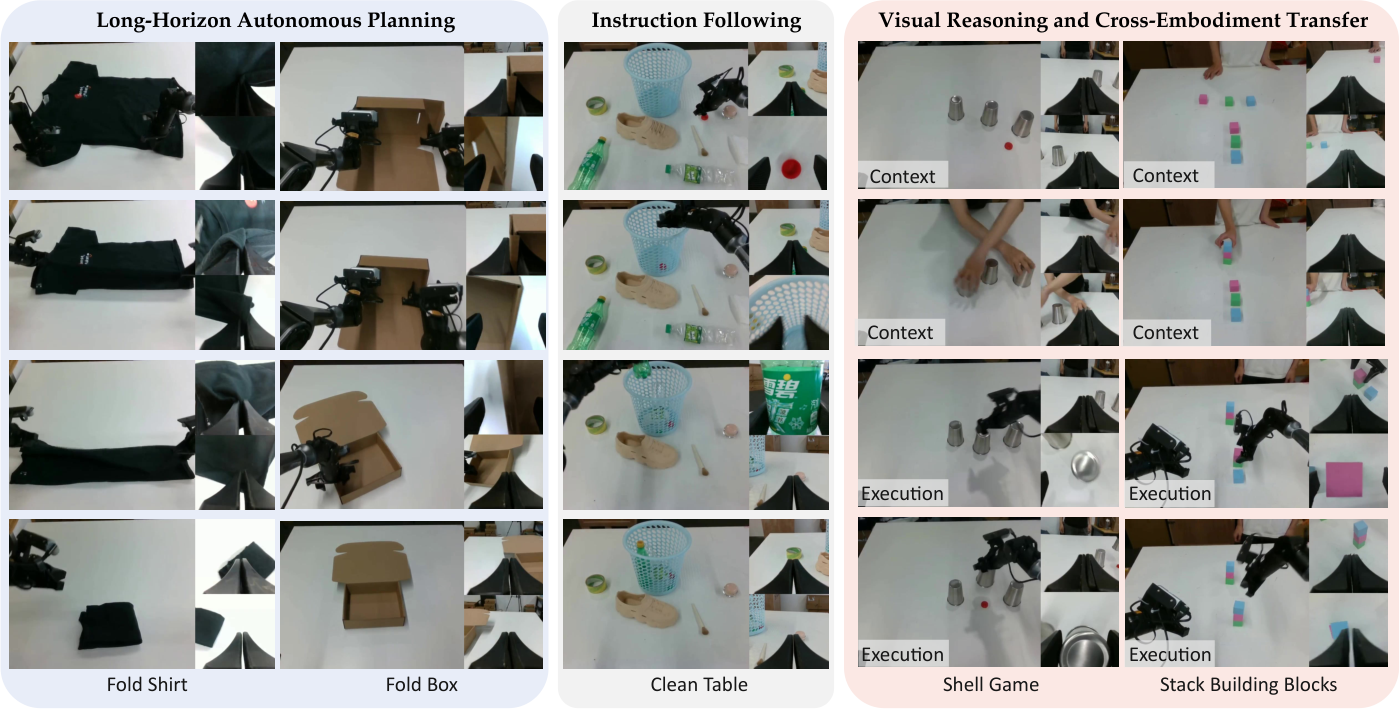
- 长程自主规划:叠衬衫 + 装箱(75%);
- 细粒度顺序控制:桌面清理全序列(80%);
- 记忆依赖:shell game(75%,需追踪隐藏球);
- 跨本体 ICL:目标图 / 示范视频条件下的积木堆叠(60–70%)。
标准 π0.5 用单帧难以直接做后两类,论文对其做了时序扩展以公平对比。
🧪 实验摘要
仿真
| 设置 | WorldScape 2.0 | 对照 |
|---|---|---|
| RoboTwin 标准平均 | 94.3% | π0.5 平均低 14.5 pp;Fast-WAM 平均低 2.4 pp |
| C2R 平均 | 60.1% | π0 +28.7 / π0.5 +1.7 / Fast-WAM +20.2 pp |
| 记忆消融(clean-only 设定) | STM→LTM→LSR 逐项升 | 无记忆基线最低;完整模型 clean/random/avg 全面最好 |
真机(PiPER,20 trials/task)
| 能力 | 任务 | 成功率 |
|---|---|---|
| 长程规划 | 折叠衬衫 / 装箱 | 75% |
| 顺序细粒度 | 桌面清理全序列 | 80% |
| 记忆推理 | shell game | 75% |
| 视频 ICL | 积木堆叠(示范) | 60–70% |
| 原子指令 in-domain / OOD | 桌面清理 6 条 | 86.7% / 60.0%(π0.5 63.3 / 43.3) |
榜单位置(RoboDojo)
WorldScape-R2SI:39.35% SR / 46.6 progress;Memory 63.7%、Open 47.5%——学习型模型里最高一档(HexaShell 论文亦引用该数字作对照)。
💡 评析:三个亮点,三条边界
三个亮点
- 记忆拆成「视觉 prefill + 事件检索」两条通路:接触动力学靠 STM,任务进度靠 LTM——比「堆更长上下文」更省、更可解释。
- 可控性统一:自主规划与细粒度 text / goal-image / video 操控同一权重完成,直接服务「训练一次、多种用法」的工程需求。
- 数据与方法对齐:ManipEvent-5M 的事件字幕 / 目标图 / 视频字段,正好喂给记忆与提示接口——不是先有模型再硬凑数据。
三条边界
- RoboTwin 上接近饱和(94%+),区分度更多来自 C2R、真机与 RoboDojo 记忆类任务。
- 真机规模仍小(每任务 20 trials、PiPER 双臂),长尾失败模式(液体、强接触)报告有限。
- 记忆检索与门控的超参敏感性在消融中有体现;事件边界检测错误会传播到进度检索——数据标注质量是隐性成本。
🗺️ 在「WAM / 记忆谱系」里的位置
- 对比 Flash-WAM:强调速度与蒸馏部署;WorldScape 2.0 强调记忆与可控提示。
- 对比 UniWAM / LoopWAM / PrismWAM:同属 WAM 大家族;2.0 的差异点是 reasoning-augmented memory + ManipEvent-5M + semantic forcing。
- 对比 EmbodiedEvo:一个用代码 harness 长经验(agent 路线),一个用学习型记忆长上下文(WAM 路线);两者在 RoboDojo 上分别代表「Agent+Harness」与「学习型记忆」两极。
- 榜单条目名:WorldScape-R2SI(读作 R2-SI,勿与论文标题混淆)。
📊 图表总索引
| 图 | 内容 | 本站文件 |
|---|---|---|
| Figure 1 | 四种 WAM 范式对比 | 本文插图 |
| Figure 2 | 框架总览 | 本文插图 |
| Figure 3 | 推理增强长短期记忆 | 本文插图 |
| Figure 4 | 注意力掩码 | 本文插图 |
| Figure 5 | ManipEvent-5M 构造 | 本文插图 |
| Figure 6 | 层级字幕示例 | 本文插图 |
| Figure 7 | 数据分布统计 | 本文插图 |
| Figure 8 | 提示示例:桌面清理 | 本文插图 |
| Figure 9 | 提示示例:咖啡制作 | 本文插图 |
| Figure 10 | RoboTwin 标准 / C2R | 本文插图 |
| Figure 11 | 真机 PiPER 任务 | 本文插图 |
(另有数据统计表、消融表、真机细粒度表等,正文以文字表格复现。)
❓ 自测 Q&A
Q1:STM 和 LTM 各解决什么问题?
STM(DiT prefill)解决「最近几帧怎么抓、怎么碰」的局部动力学;LTM(事件检索)解决「任务做到哪一步、下一步该干什么」的进度问题。
Q2:为什么叫「reasoning-augmented」?
因为历史不是原始像素硬堆,而是 VLM 输出的结构化事件,经过检索与门控后进入当前推理 token,显式增强规划。
Q3:semantic forcing 在训练里做什么?
把事件级指令语义写进 latent planning 路径,使隐式子目标也按事件推进——支持「不吐字也能按细粒度阶段执行」。
Q4:榜单上的 R2SI 是什么?
WorldScape Policy 2.0 在 RoboDojo 上的系统条目名(约 39.4% SR / 46.6 progress),与本文同一工作线。
Q5:和 HexaShell 谁高?
HexaShell v2 约 46.9% 高于 R2SI 39.4%——HexaShell 是 coding-agent + 工具演化路线;WorldScape 是学习型 WAM + 记忆路线,路线不同,不宜只看一个数。
📚 资源与延伸
- 论文:arXiv 2607.18840
- 项目页:WorldScape-Policy
- 同榜对照:HexaShell 精读、EmbodiedEvo 精读、VPP2 精读
- WAM 全景:WAM 世界行动模型全景分析、Flash-WAM 精读