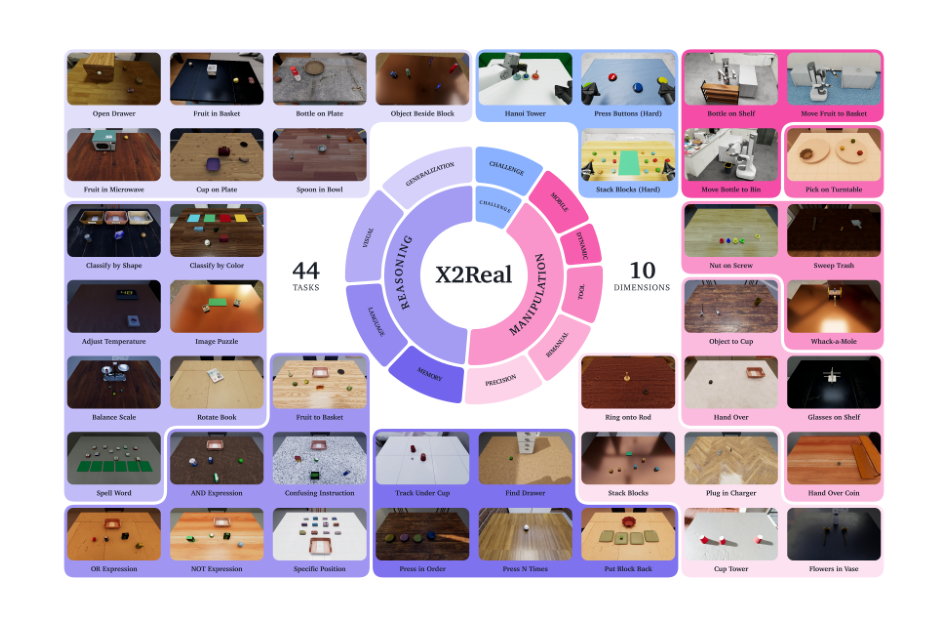
配图说明:本文收录论文全部 24 张插图(Figure 1 ~ Figure 24),放在站内 /images/x2real/,逐张讲解,文末附图表总索引表。论文来自 X Square Robot(Wall-OSS 系列模型的开发团队),arXiv 2609.27449(v2 2026-10-13),代码 github.com/X-Square-Robot/x2real。一句话定位:这不是又一个「任务列表」式 benchmark,而是一条想把「仿真分数 = 真机分数」做成可验证命题的评测基础设施——用相关性证明仿真考场可信,用 DAG 把「考了多少分」拆到每一阶段,用训练/评测隔离和随机化堵住刷榜的路。
📄 论文信息
- 标题:X2Real Technical Report: An eXtensive simulation benchmark for real-world generalist policies
- 机构:X Square Robot(X2Real 与 Wall-OSS-0.5、Wall-WM 出自同一团队;contributors 一节列出的核心成员包括项目负责人 Lian Ruan(†),通讯作者 Hao Wang(‡))
- 时间:2026-09 首发,v2 2026-10-13(arXiv 2609.27449);基于 NVIDIA Isaac Lab-Arena 搭建
- 关键词:sim2real 线性相关性、faithfulness/diversity/fairness、Task DAG、域随机化(三轴正交)、Mana 仿真生态、Physical DSL、Policy Space、帧级子任务标注、benchmark exploitation
- 一句话总结:先证明考场可信,再发成绩单。校准仿真 → 用「真机数据训练的模型」在两边同时考试 → 报告相关系数(0.84)→ 这时候仿真里的大规模评测(44 任务 × 随机化 × DAG 细粒度打分)才有资格替代一部分昂贵、缓慢、难复现的真机评测。
🎯 一句话版本:核心数字
| 指标 | 数值 | 说明 |
|---|---|---|
| 仿真-真机相关性 | 0.84(progress 分)/ 0.74(成功率) | 只用真机数据训练的 wall-oss-0.5;只看通用任务则 0.96 / 0.99 |
| 任务规模 | 10 维能力 × 44 任务 | 38 桌面 + 3 移动 + 3 挑战;全任务分层子任务 DAG |
| 随机化 | 三轴正交 | 外观(背景/光照/桌面材质)/ 任务设置(资产/布局/指令/谜面)/ 本体(夹爪/相机/桌高) |
| 数据集 | 约 300 小时,帧级子任务标注 | 桌面 300 条/任务、移动 1000 条/任务、挑战类 >20000 条 |
| 最强 policy 退化 | ID 53.9% → OOD 34.3% | wall-oss-preview;progress 分 67.3 → 56.6 |
| coding agent 当 policy | GPT-6-Astra OOD 36.15% | 比 wall-oss-preview 高 1.89 pp,但 progress 分 53.74 < 56.63 |
| 移动操作 OOD | wall-oss-preview 6/120,π0.5 只有 1/120 | 三个导航+操作任务,ID 成功率不低、OOD 几乎归零 |
| 自动合成 vs 遥操作 | 12 层堆塔平均 3.75 vs 1.90 层 | 同样 1398 条轨迹;换分段指令后 4.40 vs 2.05 |
| Mana 提速 | 46.79 → 22.43 ms/步(−52.06%) | async/async 调度;相机管线另省 28.41% |
🧭 读前 5 分钟:六个概念
- sim2real 线性相关性:本文的核心指标。同一个模型分别在仿真和真机上考同一套任务,把两边的分数画成散点——如果仿真分数不能线性预测真机分数,仿真评测就只是在考「会不会钻仿真器的空子」。理想相关系数是 1.0,X2Real 拿到 0.84(progress 分口径)。
- ID / OOD:in-distribution = 训练时见过的配置分布(同样的物体池、布局分布);OOD = 换掉物体实例、加干扰物、改外观/本体后的评测。三轴随机化就是 OOD 的生成器。
- benchmark exploitation(刷榜):仿真环境是确定性的、可复现的——策略完全可以对着固定评测配置过拟合(固定随机种子、背场景)。X2Real 的对策:训练数据全部在「绿幕棚」标准环境里采,评测配置严格分离,且评测分布本身可持续演化。
- Task DAG:每个任务 = 一张有向无环图。节点是「可验证的原子任务」(带基于仿真器状态的成功谓词),边是依赖关系。节点只有在全部前驱完成后才激活,完成后锁存——于是同一个 DAG 能同时干四件事:判定最终成功、在线生成帧级子任务标注、给 10 分制 progress 打分、失败时定位卡在哪一步。
- Mana 与 Physical DSL:底层仿真生态。把场景、任务图、本体、策略、采集配置都写成 YAML 片段(fragment),agent 通过增删片段和「订单(order)」来搭建环境,编译器先做编译检查再起仿真器——agent 全程不碰底层仿真 API。
- Policy Space:统一评测运行时。仿真客户端与每个 policy 服务分进程、走远程接口;观察映射、动作适配、episode 生命周期四步(initialize / ingest / infer / finalize)标准化,各 policy 保留自己的预处理和动作表示。
🗺️ 基准总览:Reasoning 管「做什么」,Manipulation 管「怎么做」
任务分两大类能力(见开篇 Figure 1):Reasoning(任务决策)拆成 4 个子能力——Generalization(抗扰动的通用操作)、Visual Understanding(按形状/颜色/数量分辨物体)、Language Understanding(解析 AND/OR/NOT 逻辑表达式、行列位置等结构化指令)、Memory(跨阶段记住并利用历史信息);Manipulation(物理执行)拆成 5 个子能力——Precision Operation(毫米级精细操作)、Bimanual Coordination(双臂协同)、Tool Usage(锤子/扫帚/螺丝刀等工具)、Dynamic Operation(与运动物体交互)、Mobile Operation(移动底盘 + 操作)。
44 个任务 = 38 桌面任务(分属 Reasoning 四维与 Manipulation 的四个桌面维度)+ 3 个移动操作任务 + 3 个挑战任务:Stack Blocks (Hard)(15 块积木搭 12 层塔,考精度上限)、Press Buttons (Hard)(按 4/8/12/16/20 长度的颜色序列按键,考记忆上限)、Hanoi Tower(2~5 层汉诺塔,考规划上限)。所有任务都分解成 DAG 子任务,规则评测器逐节点判分。附录 A.1 给了每个任务的 ID/OOD 配置,举几个例子感受一下 OOD 的设计:
- AND/OR/NOT 表达式:训练时指令只见过单一属性(「把红色的放进去」),评测考的是没见过的合取/析取/否定表达式——考的是语言组合泛化,不是背指令。
- Track Under Cup:骰子被杯子盖住、两个杯子交换一次、掀开——经典 shell game,考的是视觉记忆而非当前观察。
- Find Drawer:把积木放进指定层抽屉、关上、等一等、再打开同一层取出来——「同一层」三个字就是记忆考点。
🎲 公平性:三轴随机化 + 绿幕棚采数据 + 训练评测分离
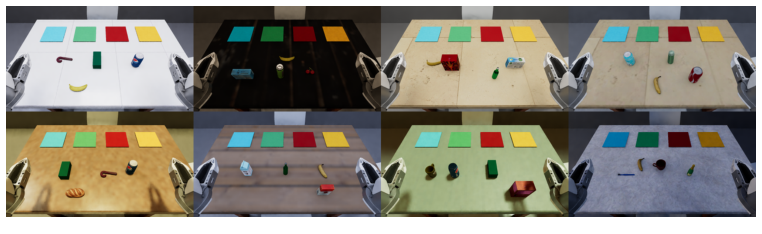
随机化分三个正交轴:①外观——背景场景、光照、桌面纹理;②任务设置——任务资产、物体摆放、干扰物布局、语言指令、谜面配置;③本体——夹爪类型、相机内外参、桌面高度。并且分层启用:Generalization 类任务三轴全开;其余 Reasoning 任务开外观 + 任务设置;Manipulation 类任务只开外观——既保证多样性,又不让随机化淹没任务本身要考的能力(比如精密插入任务就该考插入,不该同时考大换装)。
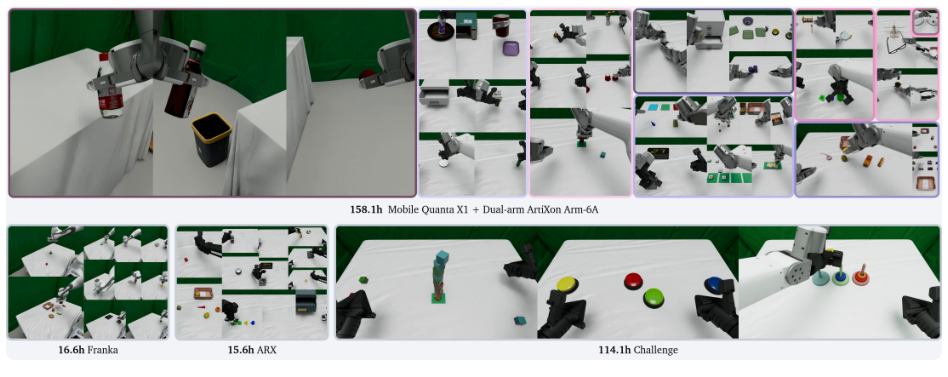
数据侧的公平性设计是「训练数据只从绿幕棚采」:搭建一个与 ManipArena 绿幕棚对齐的数字孪生环境,所有演示都在这个受限随机化的标准配置里采集,与评测配置严格分开。规模:桌面任务每任务 300 条、移动任务每任务 1000 条、三个挑战任务合计超过 20000 条。来源分布:ArtiXon Arm 数据约 80% 来自人工遥操作、20% 自动合成;而 Quanta X1 移动平台、Franka、ARX R5 和全部挑战任务的数据全部自动合成。时长拆账:Quanta X1 + ArtiXon Arm 共 158.1 小时(主力后训练集),Franka 16.6 小时,ARX R5 15.6 小时,挑战任务 114.1 小时——合计约 300 小时。
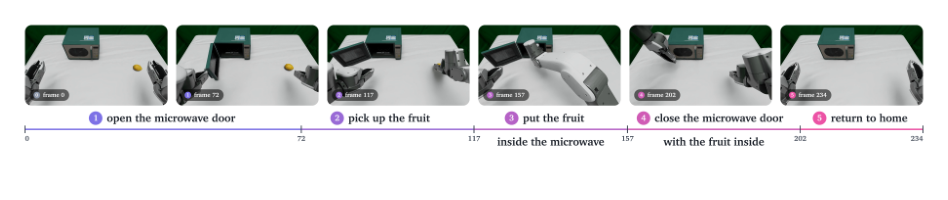
更关键的是每条轨迹自带帧级子任务标注(Figure 6):遥操作时 DAG 运行时用特权仿真器状态在线评估当前活跃节点的成功谓词,节点第一次完成的帧号被自动记录——不需要人工逐帧标边界,也不需要事后用一个辅助模型去猜。每条轨迹 = 相机原始数据 + 动作序列 + 语言指令 + 帧级子任务标签。这不只是省标注钱:它让「分段指令训练」「阶段级评测」「失败归因」有了同一份真值来源(后面 12 层堆塔实验会直接兑现这个好处)。
🤖 本体:多套平台、可换夹爪
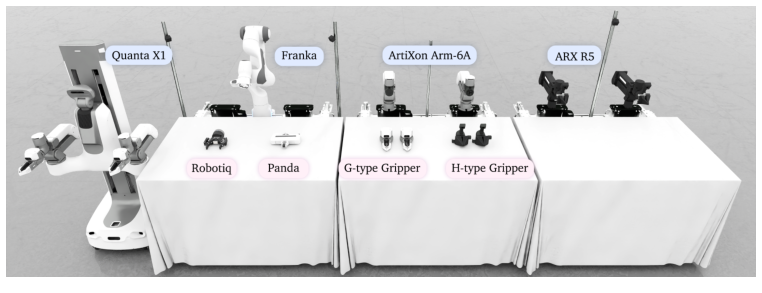
支持单臂 Franka(Robotiq 夹爪 / Panda Hand)、自研双臂 ArtiXon Arm-6A(G 型 / H 型夹爪)、双臂 ARX R5、自研移动操作平台 Quanta X1(Figure 4)。每个仿真本体都按真机逐项校准外观与物理参数;主力数据采集与实验验证在 ArtiXon Arm-6A 和 Quanta X1 上完成。底层控制参数做了毫米级对齐——同样的控制动作输入,仿真臂和真机臂的末端位置偏差在毫米量级(做法见下文系统辨识一节)。
🔌 Policy Space:让不同架构的 policy 坐同一张考卷
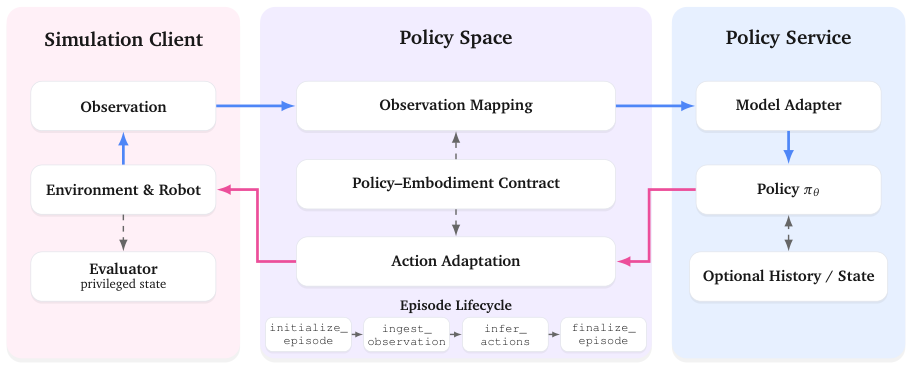
通用策略在运行时依赖、观察格式、历史状态、动作表示、推理节奏上千差万别。Policy Space 的解法是依赖隔离架构:仿真客户端与各 policy 服务分进程,通过轻量远程接口通信;运行时契约标准化四件事——观察映射(按本体配置映射成通用格式)、动作适配(policy 原生输出 → 机器人可执行指令)、episode 生命周期(initialize_episode / ingest_observation / infer_actions / finalize_episode 四个操作)、可选模块(坐标变换、单位换算、RTC 实时分块、历史更新)。关键红线是策略推理与任务评测分离:policy 只能看到 Policy Space 递给它的观察,评测器独占特权仿真器状态。
⚙️ Mana:让 agent 用 DSL 驱动的仿真生态
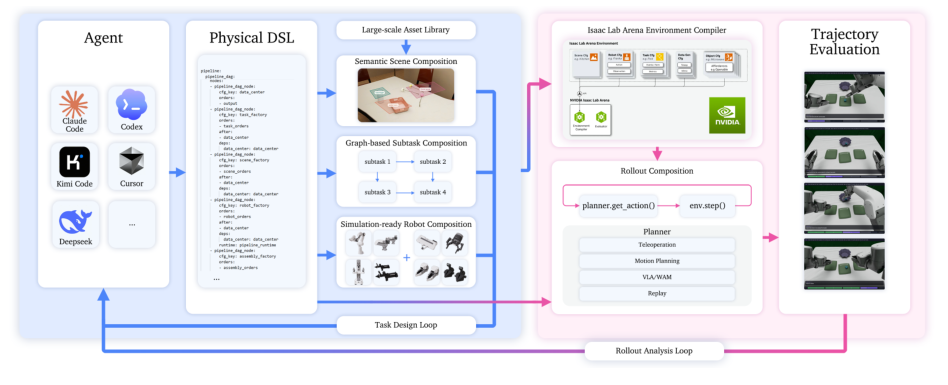
Mana 是整个基准的发动机,建立在 NVIDIA Isaac Lab-Arena 上。Arena 把环境拆成 scene / task / embodiment 三个可组合积木,但缺资产管理、数据管线和 agent 接口——Mana 补上这三块,核心是一个 YAML 物理领域专用语言:
- 编写层:一个 pipeline 文件声明哪些工厂启用、编译顺序、消费哪些订单流;环境实体写在独立片段(fragment)里——场景、任务、本体、策略、采集配置各管各的,
include引用 + 字段覆盖让「写一个变体」变成写一小段 overlay 而不是复制整个文件。 - 编译层:Translator 展开 include、把程序降级成「工厂配置 + 订单」两个产物。工厂是生命周期(setup / receive / fulfill / cleanup),订单是「给我生成某个场景/机器人/任务/装配/rollout」的具名请求。agent 的扩展方式是写新订单,而不是改工厂代码——这是编辑安全性的来源。
- 装配层:装配订单是一个三元组(场景、机器人、任务的生成器名字),按名字从共享数据中心取件、把任务角色绑定到带对应语义标签的场景资产(
@pickable自动解析到打了 pickable 标签的物体),交给 Arena 编译器实例化。绑定按名字进行,所以一个场景订单可以进很多装配、一个任务图可以配多种夹爪——小零件集合撑起大环境矩阵。 - 统一 rollout:rollout 订单复用已建环境,指定「老师」——遥操作、运动/技能规划器、policy 推理或轨迹回放。同一装配既能发数据生成订单也能发评测订单,两种轨迹都带逐节点 DAG 分数和指令日志。
Agent 驱动两个闭环:任务设计闭环(写/改片段 → 追加订单 → 校验 → dry-run 编译图,违规程序在仿真器启动前就被拒绝)和轨迹分析闭环(跑数据生成或评测 → 读节点级元数据与失败轨迹 → 反馈成 DSL 修改或切片增广数据)。人只在高层次给意图,迭代在语言内部完成。
📦 仿真就绪资产:从 96,480 条原始记录到 12,485 个可用包
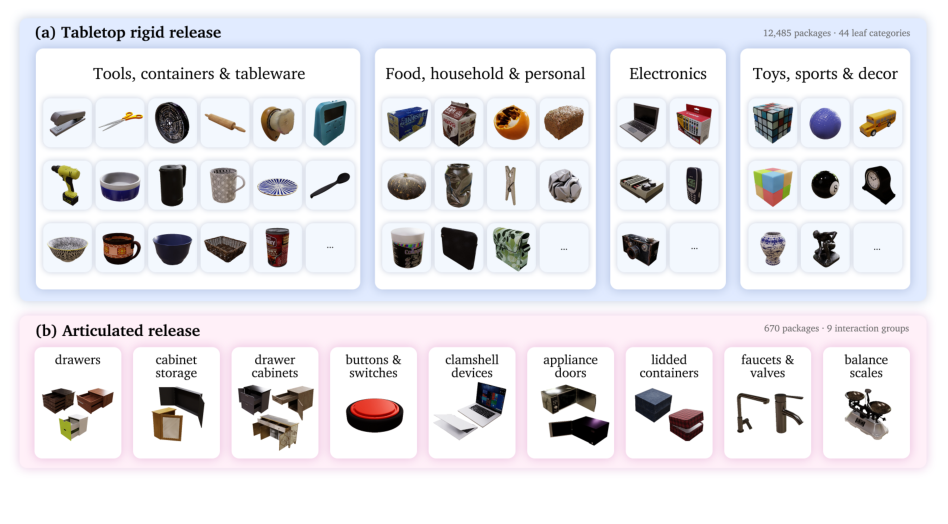
X2Real 把「仿真就绪资产」定义为一个包:视觉、米制尺度、语义、碰撞、惯性、运动学、物理材质七类记录捆绑在一起,并且通过了其声明角色所需的仿真器检查。来源池包括 Objaverse/CanoVerse、Omni6DPose、BlenderKit、GSO、ManiTwin-100K、HSSD、ProcTHOR、ABO、Poly Haven、ReplicaCAD 等十来个库加自产补充:索引到的刚性目录有 96,480 条源记录;桌面发布版包含 12,485 个刚性包(44 个叶类目、10 个语义族);铰接资产 670 个包(9 个交互组)。
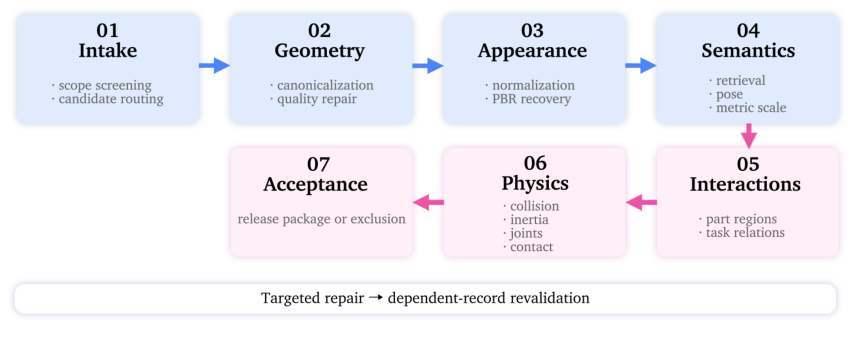
从原始内容到发布包要过七道依赖有序的工序(Figure 9):①源接入与范围筛查(统一到 OpenUSD,剔除畸形/超范围内容);②几何规范化与质量修复(归一化轴与单位、检查拓扑/朝向/复杂度);③外观规范化与 PBR 恢复(缺失材质先从类目候选补、不够再生成式合成——渲染材质记录与物理材质记录分开维护);④物体级语义与米制 grounding(多视角描述、开放词表检索、方向语义;尺度不可靠时用 GSO/ABO/YCB 锚点估计相对尺度);⑤部件语义与任务条件交互 grounding(PartSAM 提候选 3D 区域,affordance = 部件 × 任务 × 可交互动作的三元关系,同一个物体可以分别标出抓握区、开盖区、倾倒区);⑥物理/运动学/接触材质 authoring(解析体 → 凸包 → V-HACD/CoACD 凹分解;质量惯性按置信度分级估计);⑦角色专属的仿真器验收(可抓物体真被抓取搬运释放一遍,铰接物体真被开合一遍),失败包修复重测或剔除。
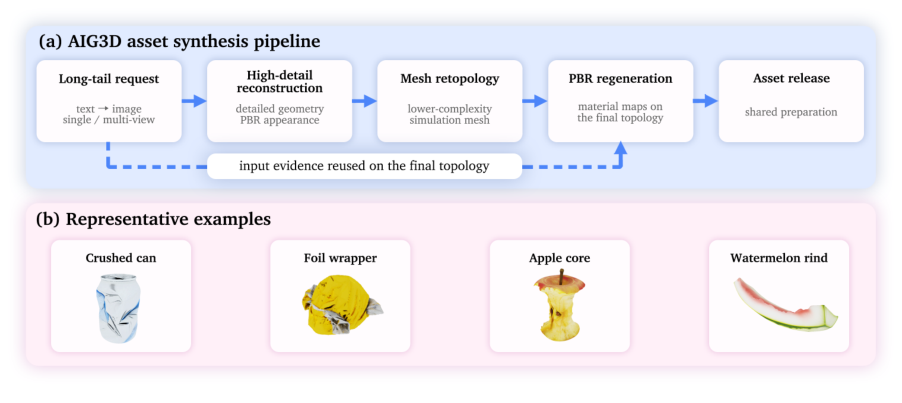
长尾缺口由 AIG3D 合成补齐(Figure 10):文本请求先转参考图像,单/多视角观察直接条件化重建;先做高细节几何与 PBR 外观,再做仿真导向的 remesh/retopology,最后在最终网格上重新生成 PBR——顺序保证轮廓和局部结构在网格预算约束下不被牺牲。生成物走与采集内容完全相同的准备与验收流程。
🏞️ 语义场景编译与运行时变化
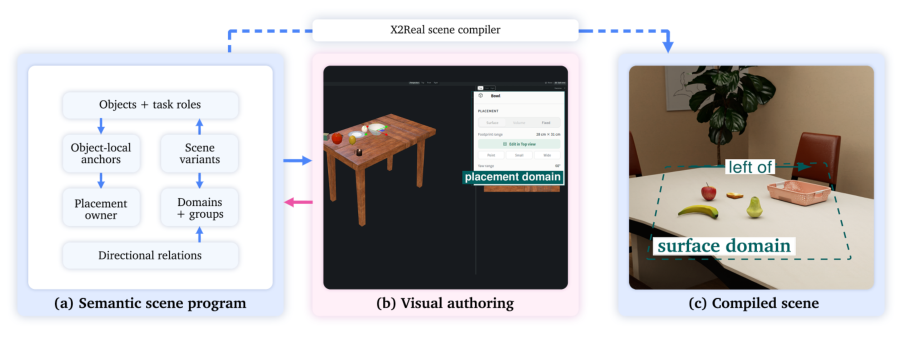
场景定义的老大难:一个对「这张桌子」有效的世界坐标位姿,换了桌子尺寸或物体实例就失效。X2Real 的解法是语义场景程序(Figure 11)——不写死位姿,写意图:物体与物体局部锚点(桌面、抽屉、收纳盒内部等可用几何暴露在支撑物的当前局部坐标系里)、放置所有权(每个放置节点有唯一 owner,防止冲突)、成组构图(region/scatter/volume/slot 四种成组放置)、空间关系(left_of / front_of 等在支撑面变大变小后依然成立的方向约束)、场景变体(资产/背景/槽位的备选)。编译器做两件事:依赖分析(足迹膨胀的重叠边 → 联合求解分量;支撑/容纳引用 → 父先子后的调度)和事务化求解(临时赋值 + 前向检查 + 有界回溯,要么整单提交要么整体回滚,搜完无解则返回绑定到具体约束的不可行诊断)。可视化编辑器和语言引导 authoring 改的是同一个程序、走的是同一个编译器。
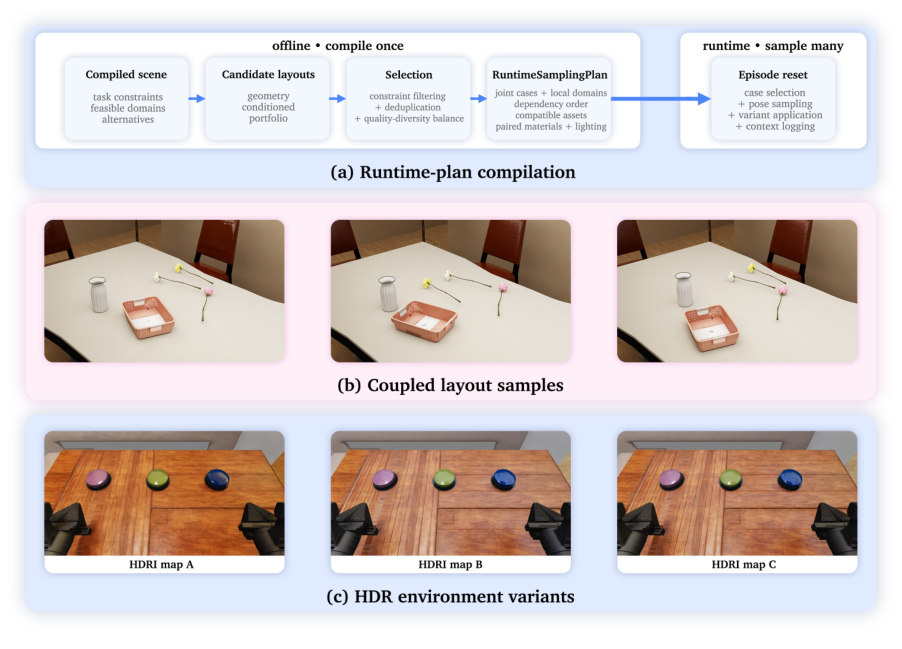
重置时的变化遵循「编译一次、采样多次」(Figure 12):编译器离线发出 RuntimeSamplingPlan——耦合的离散布局、连续的局部表面/体积域、允许朝向、依赖顺序、兼容的资产/成对材质/光照变体;每次 episode 重置从计划里采样,几何改动在计划构建期就解决,外观调整只动渲染通道、不碰物理记录。
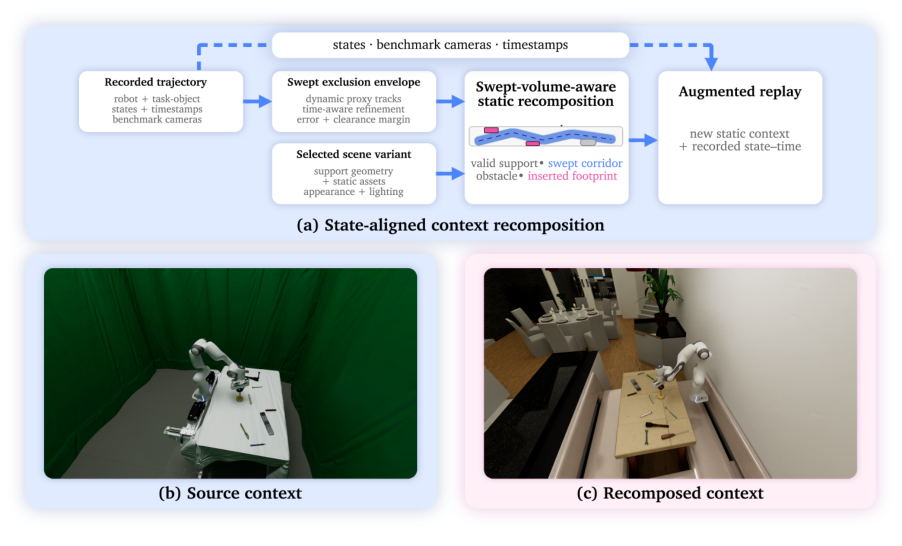
第二套变化机制是回放增广(Figure 13):一条已录 episode 提供机器人/物体状态、相机变换和时间戳,套上一个新的静态场景变体后重合成观察。插入的新物体必须落在有效支撑上、在记录运动「扫出来的排斥包络」之外——包络由几何代理、自适应时间采样、误差受限的路径压缩算出,再按空间尺度 + 近似误差 + 间隙余量膨胀。状态-时间对齐被完整保留,等于免费多了一批不同背景的训练观察。
🪜 Task DAG:同一张图,管标注、打分、归因
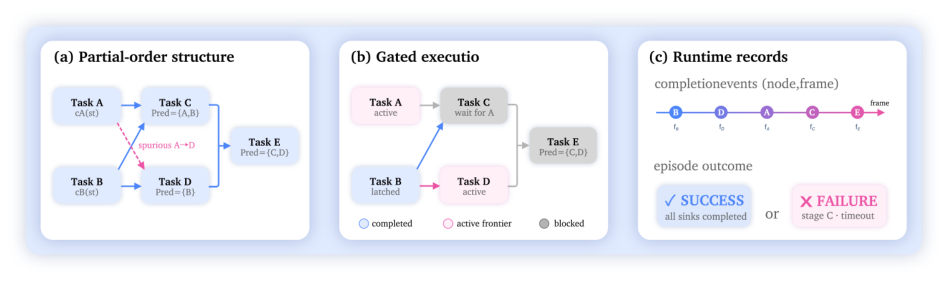
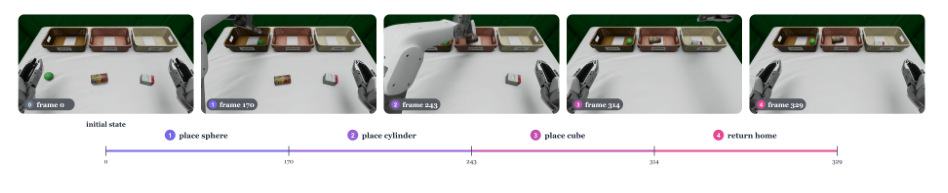
形式化很干净:每个节点 v 带一个基于仿真器状态的成功谓词 c_v(s_t);节点只有门控打开(全部前驱完成)才被激活评估,完成即锁存(d_t = d_{t-1} ∨ g ∧ c)——门控防止「初始状态恰好满足条件」被白判成功,锁存把瞬时物理状态变成持久阶段里程碑。所有汇点完成且无失败条件触发,任务才算成功。完成的瞬间发出节点完成事件(节点 ID + 首次完成帧),遥操作演示据此自动切段打子任务标签(Figure 15 的 Classify by Shape:三个放置节点互相独立、可任意顺序完成,return-home 节点等全部三个)。
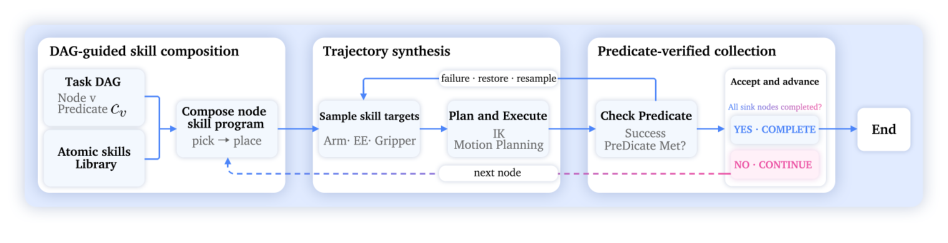
自动数据合成(Figure 16)是闭环的:给每个节点绑定一串参数化原子技能(pick = 接近→下降→闭合→抬起;place = 预放置→放置→松开→回撤),技能读当前机器人状态和特权仿真器状态、吐稀疏目标序列,cuRobo 做逆解与轨迹优化,执行后由节点自己的成功谓词独立验收——「生成」和「验收」分离,合成演示的通过标准和后续 policy 评测用的是同一套几何/接触/关节条件,不是生成器自己说了算。失败就恢复最近的成功检查点、只重采当前失败节点,不用从头重放;成功段保留谱系信息(节点 ID、父样本、完成进度),最后去缝拼接。同一张 DAG 还天然支持行为级增广:重采布局、抓取候选、放置位姿、分配手臂、技能参数,甚至并行活跃节点间的不同合法顺序。
评测指标也全部从 DAG 导出:①最终成功率(所有汇点完成且无失败);②逐子任务完成率 C_v(哪个阶段可靠、哪个阶段是瓶颈,一目了然);③10 分制任务进度分——每个节点按语义重要性分配权重、每张图权重和为 10,锁存保证进度分单调不减,失败 episode 也能拿到部分完成分;④失败归因——首个失败节点、失败帧、原因(节点失败谓词/阶段超时/任务级失败),加上首次完成帧,能区分「从没到过这一步」「到了但没完成」「完成后死在下游」三种完全不同的故事。
⚡ 效率:物理-渲染双异步调度
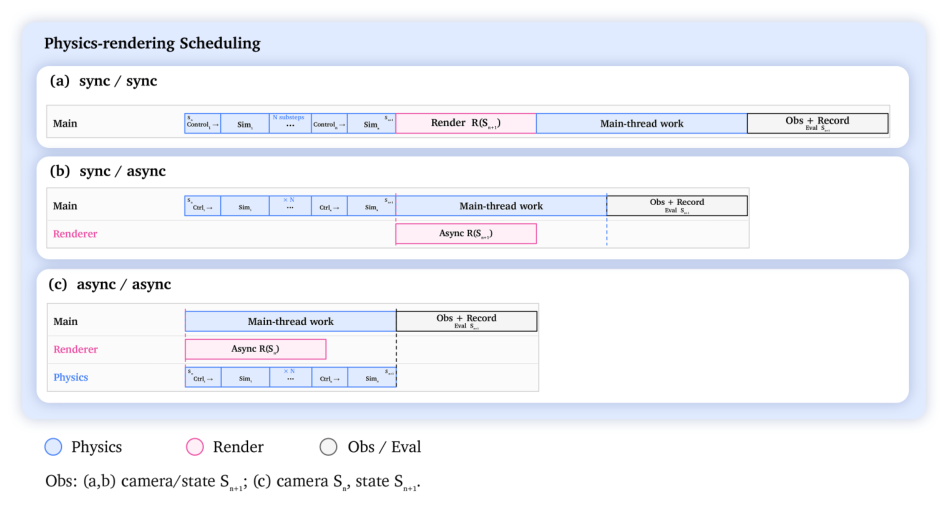
Mana 把每个环境步当成异构 CPU-GPU 管线(Figure 17):物理与执行器计算放 CPU(刚体场景可开连续碰撞检测 CCD,防高速穿透;GPU 让给多相机渲染),渲染独立控制。三种调度模式在同一个工作站(Ryzen 9 9950X + RTX 5090、双 640×480 腕相机 + 一个 1280×720 头相机)上测同一个 EX001-G episode:sync/sync 串行 46.79 ms/步;sync/async 渲染与主线程重叠 24.68 ms(−47.24%);默认的 async/async 22.43 ms(−52.06%)——渲染线程消费冻结的 S_n 快照,物理 CPU worker 推进到 S_{n+1},同步点统一汇合,相机观察带一步刻意延迟,状态观察与评测用当前态。相机管线本身也优化过(CUDA 双缓冲 + 独立 GPU 流后处理),对照实验中平均延迟降 28.41%。一句话:不改物理步长与控制频率,纯调度白拿约一半的每步延迟。
🎯 关键实验一:仿真到底像不像真机?(0.84 的来历)
系统辨识:把控制增益标到毫米级
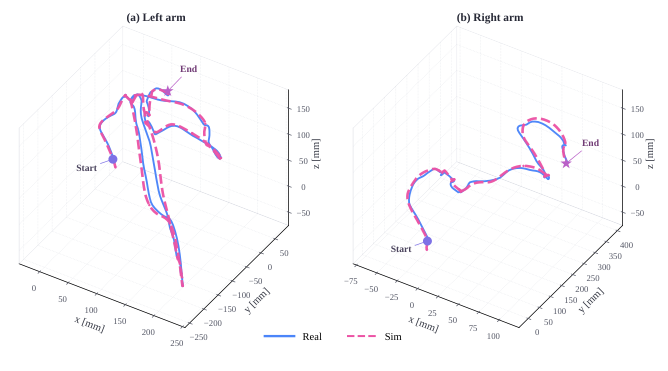
做法是增益级 real-to-sim 系统辨识(Figure 18):真机上遥操作采一批末端轨迹,把对应的末端位姿指令时间同步地重放到仿真里(IK 转关节目标,StablePD 控制器执行),12 个双臂关节共享 K_p、K_d 两组增益,用 CMA-ES 搜索。损失函数同时罚 RMSE 和 95 分位误差(位置 + 姿态,权重 1/5/0.1/0.5,毫米与度为单位)——分位项专门抓 RMSE 抓不住的间歇性大偏差。标定/验证/测试集三分,held-out 轨迹上的对齐如图:毫米级。作者同时诚实地写了边界:只调增益对「下游操作任务」未必最优,接触富集任务里执行器动力学与物体属性、柔性、冲击耦合在一起——任务相关的激励与力传感是后续方向。
相关性实验:真机数据训练的模型,两边同时考
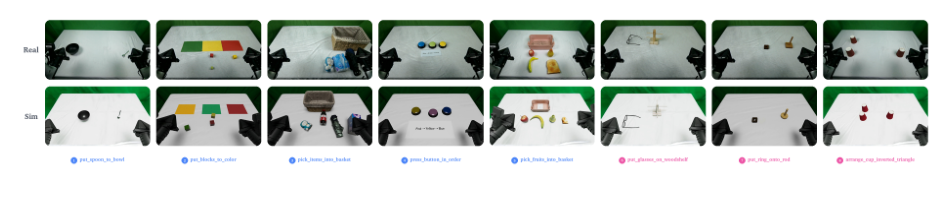
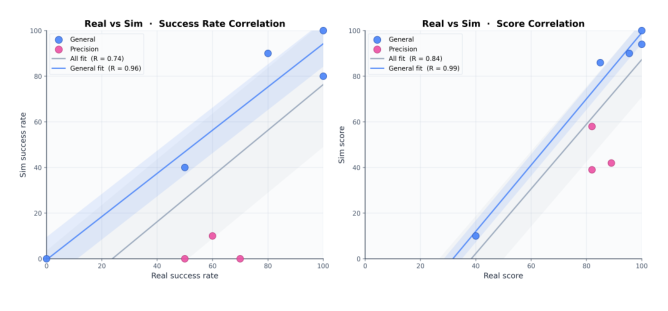
实验设计很讲究(Figure 19/20):把 ManipArena 的绿幕棚场景在仿真里手动对齐光源、资产与本体,复刻 8 个任务(5 个通用:勺子入碗、三块对色、物件入篮、按序按键、水果入篮;3 个高精度:双臂给木架挂眼镜、圆环套杆、三杯叠塔)。选 ManipArena 上表现最好的 wall-oss-0.5,只用真机演示数据微调(预训练 + 微调零仿真数据),然后直接在仿真环境里评测,与真机评测对比。结果:只看 5 个通用任务,成功率相关 0.96、进度分相关 0.99——仿真考场在通用操作上几乎完美预测真机;算上 3 个精密任务,总体相关降到 0.74(成功率)/ 0.84(进度分)。
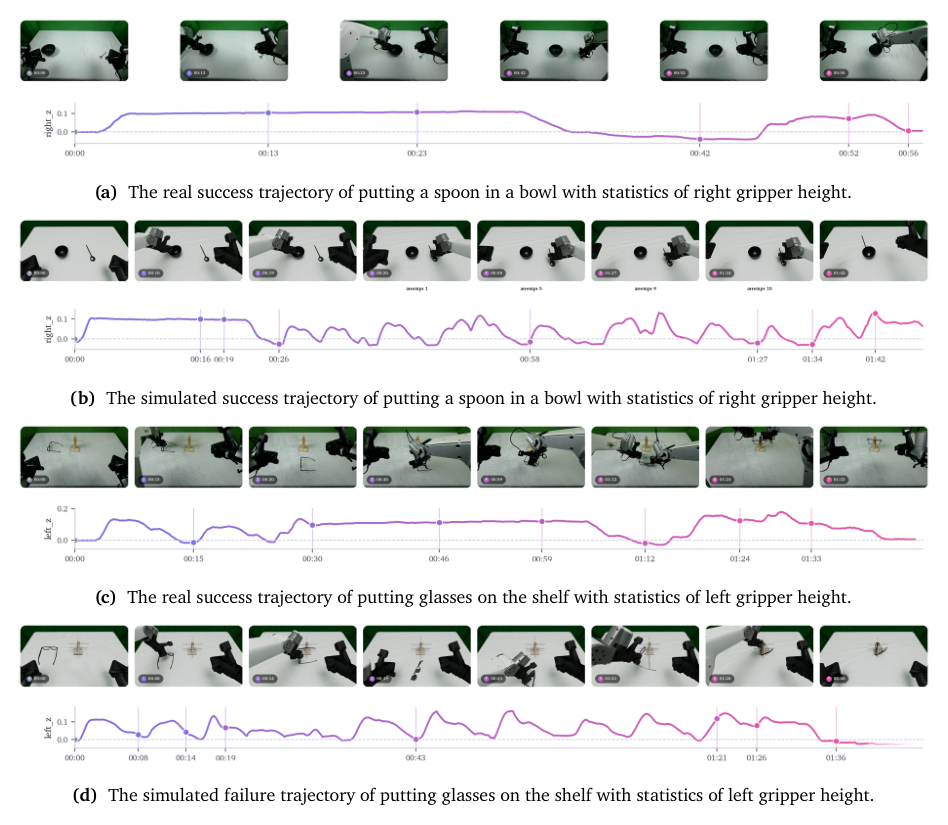
差距在哪,Figure 21 拆得很细:勺子入碗任务真机 100%、仿真 80%——都成功,但方式不同:真机一拿就中,仿真里放好碗后要试 10 次才拿起勺子(从腕相机高度轨迹看得清清楚楚,且几乎每个 episode 都如此);眼镜上架任务真机 70%、仿真 0%——仿真里眼镜一旦放歪、镜腿翻折,策略就进入没见过的分布再也爬不出来;其他精密任务的失败模式类似:真机上靠多次重试扛过 sim2real 差距的余地,在高惩罚的精密任务上消失了——多次重试也换不回成功率。作者的结论很克制:0.84 足以证明仿真环境「有资格评测真机性能」,但 real2sim gap 真实存在(仿真器、控制器、渲染都有份)。
📊 关键实验二:四个通用 policy 的成绩单
Table 1 在全部桌面任务上评了四个模型(同在 ArtiXon Arm-6A 演示上微调约一个 epoch,不给帧级子任务标注,各保留原生训练/动作表示):wall-oss-preview(EEF 控制)、π0.5(EEF)、DreamZero(关节空间)、Wall-OSS-0.5。聚合用分层宏平均——episode → 任务 → 子类 → 大类逐层等权,防止任务多的维度霸占总分。全表太长,摘总分与代表性子维度(每格 ID/OOD):
| 维度 | wall-oss-preview | π0.5 | DreamZero | Wall-OSS-0.5 |
|---|---|---|---|---|
| Reasoning 总分 SR(%) | 67.88 / 36.39 | 21.79 / 14.61 | 5.44 / 3.46 | 6.74 / 4.42 |
| Manipulation 总分 SR(%) | 39.91 / 32.12 | 17.95 / 16.09 | 4.26 / 3.44 | 1.43 / 1.97 |
| 全体总分 SR(%) | 53.90 / 34.26 | 26.12 / 16.13 | 4.85 / 3.45 | 4.08 / 3.20 |
| 全体 progress 分 | 67.25 / 56.63 | 46.19 / 37.75 | 34.21 / 32.12 | 17.85 / 14.10 |
| 语言推理 SR(%) | 82.50 / 49.58 | 54.58 / 25.00 | 3.33 / 5.00 | 12.49 / 7.47 |
| 记忆追踪 SR(%) | 52.25 / 20.25 | 17.75 / 13.75 | 2.00 / 1.00 | 3.75 / 4.50 |
| 精密操作 SR(%) | 34.00 / 16.00 | 6.50 / 2.50 | 3.50 / 2.50 | 0.50 / 0.50 |
三个作者点名的发现,都值得展开:
- OOD 退化是普遍且显著的:最强者 53.9% → 34.3%,语言推理 82.5 → 49.6,记忆追踪 52.3 → 20.3。训练式配置下的成绩会系统性高估真实部署的稳健性。
- 成功率不等于能力:DreamZero 总成功率只有 4.85%,但 progress 分 34.21——大量 episode 在长程任务的后段才死掉。逐子任务完成率进一步显示:ring_to_rod、plug_in_charger、screw 这类接触富集任务成功率近零却有不低的中间进度;而 adjust_temperature、alphabet_word 和一众记忆任务在 OOD 下崩得最狠。「能做出部分正确行为」与「能可靠收尾」是两种能力,DAG 打分把这件事变成了可见的数字。
- 一个诚实的怪现象:Dynamic Operation(转盘抓取)是全表唯一 OOD 显著高于 ID 的维度(wall-oss-preview 成功率 0.00 → 32.50)——ID 配置下四个模型全军覆没(0.00–9.76%),反而 OOD 更好。这类反常是动态任务评测噪声或 ID 配置问题的信号,也提醒我们单一维度的均值要看细则。
🕵️ 关键实验三:让 GPT-6-Astra 直接当 policy
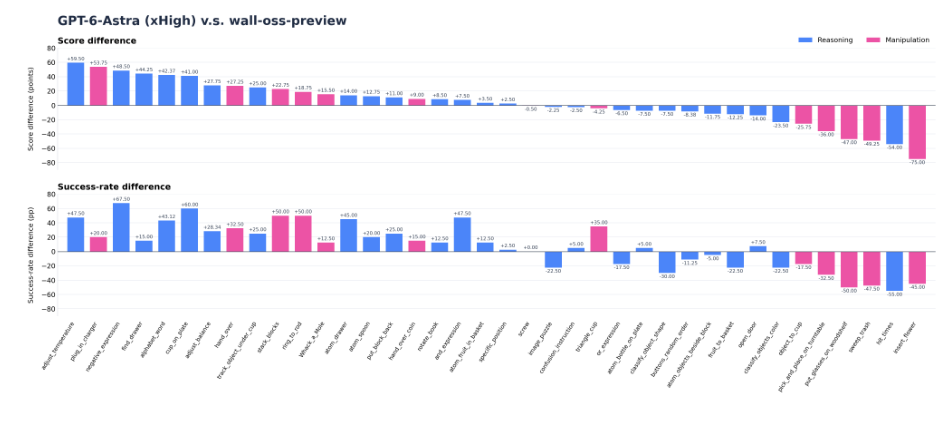
把 GPT-6-Astra(xHigh 推理档)接成显式机器人 policy:每步喂头 + 双腕相机的当前帧与上一帧、本体感知(双臂末端位姿/关节/夹爪)、执行反馈与剩余预算;它输出结构化末端位姿 + 夹爪指令,30 Hz 执行(限速 0.10 m/s、0.50 rad/s,单动作 8 秒超时)。不给深度图、相机标定、物体真值、奖励或在线进度分。在全部 44 个原生 OOD 环境上各跑 10 个评分 episode(模型调用预算与任务时长成正比,⌈100T/60⌉)。
结果(Figure 22):总体 OOD 成功率 36.15%,比 wall-oss-preview(34.26%)高 1.89 pp;但 progress 分 53.74 低于 56.63。能力画像分裂:Reasoning 上 Astra 大胜(成功率 46.96%,+10.57 pp;分数 64.52,+7.55),Manipulation 上大败(25.33%,−6.79 pp;42.96,−13.33)。最大的分数增益在 adjust_temperature(+59.50)、plug_in_charger(+53.75)、negative_expression(+48.50);最大的亏空在 insert_flower(−75.00)、hit_times(−54.00)、sweep_trash(−49.25)。高进度不等于高完成——Astra 在 find_drawer 上拿了 85.00 分但只有 20% 成功率。另外作者如实交代:每次决策块推理超过 30 秒,期间仿真暂停,加上每环境只有 10 个 episode,这些差异应视为描述性而非统计结论。
🚚 关键实验四:移动操作——ID 赢了,OOD 几乎归零
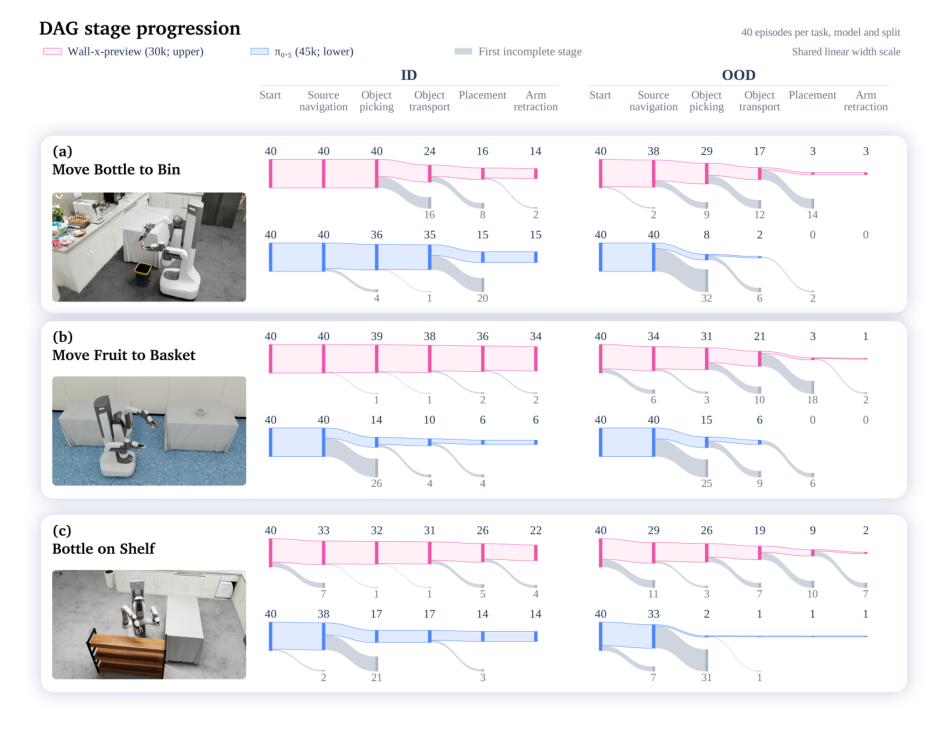
三个移动任务(Move Bottle to Bin / Move Fruit to Basket / Bottle on Shelf)各含 5 个 DAG 阶段:导航到源 → 抓取 → 搬运 → 放置 → 收臂。用 Mana 每任务自动合成约 1000 条成功演示,联合后训练 wall-oss-preview 与 π0.5,每任务每设定 40 个 episode(ID 绿幕棚、OOD 换背景与桌面外观;时限 90/120 秒)。总分(Table 2):wall-oss-preview 58.33% / 5.00%(ID/OOD SR),progress 77.50 / 44.17;π0.5 29.17% / 0.83%,progress 52.83 / 24.83。OOD 的 120 个 episode 里 wall-oss-preview 只完整成功 6 个,π0.5 只有 1 个。
Figure 23 的阶段流比总分有信息量得多:Move Bottle to Bin 上两者 ID 成功率接近(35.0% vs 37.5%),但最频繁的「首个未完成阶段」不同——wall-oss-preview 卡在搬运(16 集)、π0.5 卡在放置(20 集);OOD 下 π0.5 退化到连抓取都过不去(32 集)。Move Fruit to Basket 里 π0.5 的抓取缺陷 ID 时就存在(40 集只完成 14 集);wall-oss-preview 抓取没问题(39 集)但放置完成从 36 集暴跌到 3 集。Bottle on Shelf 更细:9 个 OOD episode 完成了放置,只有 2 个通过最后的收臂节点——因为收臂节点的谓词还要检查物体依然有效地放在架子上。同样的总分背后是完全不同的失败结构,这就是 DAG 级评测的价值。
🧪 关键实验五:自动合成数据 vs 遥操作数据
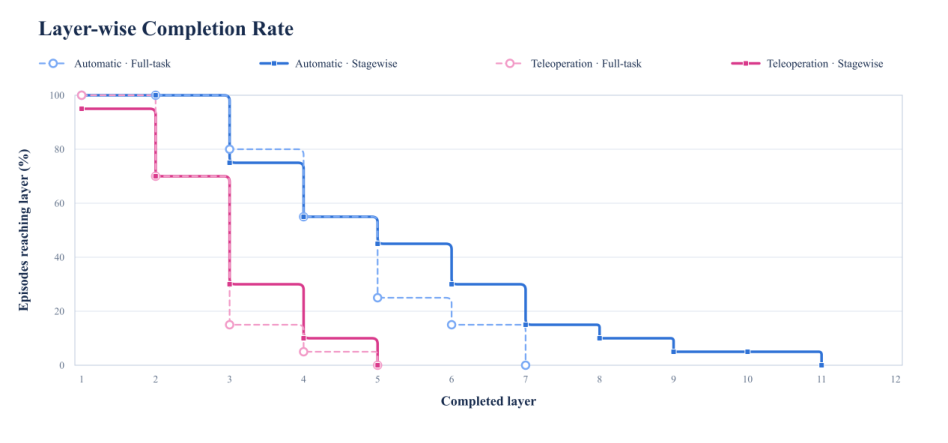
一个直接回应「合成数据到底行不行」的对照实验(Table 3 / Figure 24):在 12 层堆塔挑战(12 块连续堆叠 + 双臂回 home,塔越高对齐越难)上,自动合成与遥操作各出 1398 条完整轨迹、相同训练预算(都从 OpenPI π0.5 初始化、训两个 epoch、20 个闭环 episode 评估、300 秒上限,成功 = 12 层全成 + 回 home)。
| 数据源 | 指令 | checkpoint | 平均层数 | 最多层数 |
|---|---|---|---|---|
| 自动合成 | 整任务 | 55k | 3.75 | 6 |
| 遥操作 | 整任务 | 50k | 1.90 | 4 |
| 自动合成 | 分段 | 40k | 4.40 | 10 |
| 遥操作 | 分段 | 50k | 2.05 | 4 |
两个结论:①同样数据量,自动合成大幅更好(3.75 vs 1.90 层)——原因是时间结构:遥操作轨迹随塔变高花越来越多时间在末端对齐、观察和微调上,定长动作块采样时这些「低运动段」挤占了抓取/放置动作的训练占比;合成轨迹在 DAG 节点层面天然紧凑,还能控制各阶段的覆盖配额。②DAG 分段指令对两种数据都有益,对合成数据更猛(层数 3.75→4.40、最多 6→10 层;第 5 层完成率 25%→45%、第 6 层 15%→30%)——整任务指令让 12 个阶段共享一句话,策略只能靠视觉猜当前该干嘛;分段指令用 DAG 完成边界切分训练段、每段配局部目标,消解了「一句指令对应多种操作」的动作歧义。帧级子任务标注在这里从「省标注钱」变成了「训练收益本身」。
💡 评析:三个亮点,四条边界
三个亮点
- 把「仿真可信」从口号变成了可检验的数字。多数 benchmark 展示任务截图,X2Real 展示的是相关性散点——而且用「零仿真数据训练的模型」做实验设计,排除了「模型在仿真上训练过所以当然像」的循环论证。0.84/0.74 不是满分,但这是少数把「我的考场能预测真机」当成待证命题来做的基准。
- DAG 是全部功能的公共底座。同一个任务图驱动成功判定、帧级标注、10 分制进度、失败归因、自动合成的验收、分段指令训练——一套形式化吃六顿饭。12 层堆塔实验里分段指令的收益(+0.65 层,最多层数 6→10)说明这个设计不只是评测端的便利,而是实打实的训练信号。
- 评测基础设施自觉:三轴正交随机化 + 绿幕棚训练隔离 + 分层宏平均 + 「评测分布可持续演化」(Mana 可以程序化生成新配置),针对的正是「静态基准会被刷穿」的死局。
四条边界
- 刚体与铰接刚体 only:可形变物体、流体、软材料全部缺席(AIG3D 只补长尾刚体)——而现实操作的一大难点恰在布料食物线缆。
- sim2real 相关性只在绿幕棚场景上验证过:0.84 来自与 ManipArena 绿幕棚对齐的 8 个任务复刻,任务是刚体交互为主、模型是自家 wall-oss-0.5;能不能外推到全部 44 个任务和任意模型,论文没有给证据。且精密任务上 0.74/0.84 的差距恰恰说明:越需要仿真评测的精密任务,仿真越不准。
- 任务构建仍是「人工 + agent 辅助」:44 个任务、10 个维度的覆盖虽广,但扩展速度受限于人;全自动化任务生成被列为未来工作。
- 夹爪 only、无触觉:标准夹爪本体、无触觉传感,与灵巧手方向的研究有接口差;评测范式也仍偏静态(作者设想未来引入 agent 分析与 RoboArena 式对抗评测)。
🗺️ 在「仿真评测基准」谱系里的位置
| 路线 | 代表 | 解决了什么 | 与本文关系 |
|---|---|---|---|
| 仿真-真机对应性 | SIMPLER、PolaRiS、REALM、VISER | 成对评测/重建环境验证 sim-real 一致性 | 只拿到 faithfulness,任务面窄 |
| 大而全任务集 | BEHAVIOR-1K、RoboCasa365、RoboTwin 2.0、LIBERO、CALVIN | 任务多样性、长程/语言/双臂 | 只拿到 diversity,分数不锚定真机 |
| sim+real 综合评测 | RoboDojo(同期工作) | 42 任务、五组能力、真机+仿真 | 分布广但没有显式 sim2real 相关性分析——X2Real 的差异化正在此 |
| 世界模型当评测器 | WorldEval、WorldGym、Gemini+Veo 等 | 用学习型环境替代物理仿真 | X2Real 明确选了物理仿真(需要状态访问与规则判分) |
站内延伸:《HexaShell 精读》(在 RoboDojo 官方榜上被官方评测的另一路 agent 打法)、《LoopWAM 精读》(闭环强化同样吃「评测信号密度」的红利)、《UniWAM 精读》、《WorldOracle 精读》(另一把「评测」标尺)、《PrismWAM 精读》、《π0.5开放世界泛化精读》(本文被评模型之一)、《LIBERO 精读》、《DROID机器人操作数据集精读》、《WAM 世界行动模型全景分析》、《什么是世界模型》。
📊 图表总索引
| 图号 | 内容 | 在本文中的位置 |
|---|---|---|
| Fig 1 | 任务分类体系总览(10 维 × 44 任务) | 开篇 |
| Fig 2 | Mana 系统总览(DSL 双闭环) | Mana 平台 |
| Fig 3 | 域随机化示例(Classify by Color) | 公平性 |
| Fig 4 | 本体全家福(五套平台) | 本体 |
| Fig 5 | 数据集构成(~300 小时) | 公平性 |
| Fig 6 | 帧级子任务标注示例 | 公平性 |
| Fig 7 | Policy Space 总览 | 评测协议 |
| Fig 8 | 资产谱(44 刚性类目 / 9 铰接组) | 资产 |
| Fig 9 | 七阶段资产准备流水线 | 资产 |
| Fig 10 | AIG3D 长尾资产合成 | 资产 |
| Fig 11 | 语义场景程序与编译 | 场景编译 |
| Fig 12 | 运行时变化编译与采样 | 场景编译 |
| Fig 13 | 状态对齐回放增广(扫掠包络) | 场景编译 |
| Fig 14 | 可执行任务 DAG(门控/锁存/事件) | Task DAG |
| Fig 15 | DAG 引导的遥操作标注 | Task DAG |
| Fig 16 | DAG 引导的数据合成闭环 | Task DAG |
| Fig 17 | 物理-渲染调度三模式 | 效率 |
| Fig 18 | Sim2real 轨迹对齐(系统辨识) | Sim2real |
| Fig 19 | 8 个 ManipArena 任务数字孪生 | Sim2real |
| Fig 20 | Sim2real 相关性散点(0.84) | Sim2real |
| Fig 21 | 勺子/眼镜任务轨迹分析 | Sim2real |
| Fig 22 | GPT-6-Astra vs wall-oss-preview 差分 | Astra |
| Fig 23 | 移动操作 DAG 阶段流 | 移动操作 |
| Fig 24 | 逐层完成率(合成 vs 遥操作) | 合成 vs 遥操作 |
表格:Table 1 桌面 38 任务四模型全表(ID/OOD);Table 2 移动操作评测;Table 3 合成 vs 遥操作四组对照;附录 Table 4 资产来源统计。附录 A.1 给全部 44 个任务的 ID/OOD 配置与数据来源,A.2/A.3 给资产与回放增广的实现细节。
❓ 自测 Q&A
Q1:0.84 这个数到底是怎么来的、为什么可信? A:选 ManipArena 上最强的 wall-oss-0.5,只用真机演示微调(预训练+微调零仿真数据),在 8 个复刻任务上分别真机评测和仿真评测,把两边的成功率和 progress 分做线性相关。通用任务上 0.96/0.99,算上三个精密任务拉低到 0.74/0.84。关键在实验设计堵住了循环论证——模型从未见过仿真数据。
Q2:精密任务为什么相关性掉下来? A:真机策略靠多次重试能扛过 sim2real 差距,仿真里同样的重试策略会触发分布外状态(眼镜腿翻折后政策就崩了);加上仿真器/控制器/渲染的残余差距在高精度要求下被放大——「越需要评测的环节,考场越不准」,作者把这条路列为未来工作。
Q3:怎么防止 policy 对着评测配置过拟合? A:三件套:训练数据只在绿幕棚标准环境采、与评测配置严格分离;三轴随机化让评测配置空间巨大且可再生成;评测分布本身可持续演化(Mana 程序化生成新配置、新任务变体)——没有有限的「题库」可背。
Q4:Task DAG 和普通的「分步成功判定」有什么区别? A:三点:①偏序而非线性——独立节点不设顺序,比固定步骤表和「顺序/并行」二分递归都更省约束;②门控 + 锁存——前驱不全完成就不评估(防止开局白捡),完成即永久记录(瞬时条件变持久里程碑);③一份图复用到底——评测判分、演示的帧级标注、合成数据的验收、进度打分、失败归因、分段指令切分全部从同一张图导出,语义天然一致。
Q5:自动合成为什么赢了遥操作? A:时间结构。遥操作在难段落(对齐、观察、微调)花大量帧,定长动作块采样后低运动段挤占训练分布;合成轨迹按 DAG 节点生成、天然紧凑,还能显式控制各阶段配额。注意结论的适用边界:这是在精密多阶段的 12 层堆塔上得出的,且分段指令是放大器(两种数据都受益,合成受益更大)。
Q6:这套基准评出的四个模型,谁强? A:wall-oss-preview 全面第一(53.90%/67.25 ID),但 OOD 掉到 34.26%/56.63;π0.5 第二且 OOD 退化更平缓;DreamZero 和 Wall-OSS-0.5 在这套长程 + 随机化的考场上基本没考起来(成功率个位数)。更有信息量的是结构:语言推理 ID 82.5% 说明「听得懂」已不是瓶颈,记忆追踪 OOD 20.25% 和精密操作 16% 说明「记得住、插得准」才是当前通用 policy 的公共短板。
📚 资源与延伸
- 论文:arXiv 2609.27449
- 代码:github.com/X-Square-Robot/x2real
- 项目页:x2robot.com/en/pages/x2real
- 地基:NVIDIA Isaac Lab-Arena(场景/任务/本体三积木)、ManipArena(绿幕棚与相关性实验的来源)、RoboDojo(arXiv 2607.04434,同期 sim+real 旗舰基准)
- 站内延伸:《HexaShell 精读》、《LoopWAM 精读》、《UniWAM 精读》、《WorldOracle 精读》、《PrismWAM 精读》、《Flash-WAM 精读》、《π0.5开放世界泛化精读》、《Cosmos3-世界基础模型精读》、《LIBERO 精读》、《WAM 世界行动模型全景分析》、《什么是世界模型》