写在前面:这篇文章为谁而写
你们现在的处境我完整复述一遍,确认我们说的是同一件事:
- 任务:用 Cosmos 3(WAM,世界行动模型)微调后训练,驱动天机(Tendo)Marvin 力控机械臂抓可乐,最终目标是会议室整理这类服务型任务。
- 现状:摇操采集了100条可乐数据,训了一个月没有可交付的成果,团队在大量零散提问中失去了主线。
- 三个具体症状:
- 只预测动作:推理丝滑,但抓可乐成功率很低;
- 视频+动作联合预测:推理速度慢到不可用;
- 视频质量崩坏:预测"已经抓到可乐"但实际没抓到,甚至把红可乐画成蓝可乐。
这篇文章不是泛泛的科普(那一篇在具身智能入门指南),而是一份针对这个具体项目的调研+诊断+路线图。内容分三层:
- 别人做了什么(第三节):Cosmos 生态里所有公开的后训练落地项目——NVIDIA 官方 Cosmos Policy 的完整配方(含超参、数据量、收敛指标)、Cosmos 3 官方 SFT cookbook、首篇 WAM sim-to-real 论文、已知的视频幻觉病例、1.6 节专门检索的 GitHub 现成项目(完整后训练管线、视频评测、推理加速三类可抄仓库),以及 1.8 节一份真实"RTC+camera-anchor"管线的逐项拆解(做对了什么/损失权重怎么定/头号嫌疑排序)。
- 你们三个症状的病理学(第一节):每个症状对应的病因清单和修法,全部有出处。
- 怎么把项目重新跑起来(第三~十节):100条数据够不够、仿真用什么与MuJoCo 从零搭建全流程、开环闭环怎么测、训练配方怎么抄、推理时怎么又产出未来视频又不慢、从抓可乐到会议室整理怎么分层、以及一份四周重建计划。
写给同样第一次做具身工程、从自动驾驶转过来的你。自驾的很多方法论可以直接迁移(第十一节有映射表),但也有几个必须先纠正的直觉——比如"视频预测得对不对"和"动作抓得准不准"是两件几乎无关的事,这一点是你们当前最大的认知误区。
30秒结论
- “推理时产出未来视频"和"不慢"不矛盾——官方推理本来就出视频,关键看机制。你们要的"并行输出动作+视频"官方叫联合模式:一个latent画布9个槽位(当前观测→动作→未来图像→价值),一次去噪采样全出(源码级拆解见8.1节);官方参数
generate_future_state_and_value_in_parallel=True的真实含义就是"未来与价值从同一次动作采样里顺带提取”。慢的根源是把VAE解码串进了动作返回路径、或步数配错;胡说的根源是未来槽欠训练+CFG过强+不回锚真实帧。解耦视频步数的官方途径是AR接力模式(未来1步),排查清单见8.5节。 - 视频幻觉不是 bug,是预期行为。扩散视频模型在低步数下按"先验"画图——红可乐画成蓝可乐、没抓到画成抓到,说明视频分支在按预训练分布而不是你的观测外推。永远不要用预测视频判断任务成败;Cosmos Policy 的做法是加一个 value 头,用它做 best-of-N 选择。
- 100条数据够"启动",不够"泛化"。行业锚点:Cosmos Policy 真机 ALOHA 四个任务只用了约185条(平均每任务~46条)就做到93.6%;RoboCasa 每任务50条即 SOTA(“6×更少数据”)。但前提是:只留成功片段、相机/光照/物体位姿有变化、接口约定完全一致。100条一模一样的可乐只会训出一个背题的学生。
- 仿真必须做,但用途要摆正:仿真不是拿来"零真机替代"的(sim2real 的 WAM 论文用了每任务800条仿真演示+域随机化,零样本真机也只有35%),而是拿来当回归测试台的——让策略在碰真机之前先在仿真里跑出可复现的成功率曲线;等方法稳定后再升级成"半个数据工厂"(混训 2:1)。从环境四层定位、脚本专家采数据、混合训练、固定种子回归台到域随机化的完整手把手流程,见第五节——你们"仿真抓可乐都完成不了"的问题按 5.1 的 L1→L4 顺序排查,九成是 L1/L2 的接触与时序问题,与模型无关。
- 先建评测,再谈模型。你们缺的不是又一个训练技巧,而是一套开环(动作L1,目标0.010~0.015量级)+闭环(固定种子N次真机试验)的评测管线。没有它,任何改动都无法归因——这正是"一个月一地鸡毛"的技术根因。
- 平台选型:方法开发用 MuJoCo 系(LIBERO/Robosuite,接触物理最准、上手最快),要照片级合成数据再上 Isaac Sim/Isaac Lab 做域随机化。天机 Marvin 没有现成模型就找天机要 URDF(他们 SDK 开放、有 ROS2 接口),转 MJCF 或 USD 都是成熟工具链。MuJoCo 侧的完整搭建实操在第五节。
- 架构上抄两条官方路线二选一:走 Cosmos 3 官方 action-policy SFT(cosmos-framework,有 DROID/LIBERO/RoboCasa 三份开箱配方),或者走 Cosmos Policy 的 latent frame injection(NVlabs/cosmos-policy,有 cookbook + HF 检查点 + 真机 ALOHA 先例)。不要自创架构。
- 从抓可乐到会议室整理是分层问题:先用100条把"抓"打成稳定原子技能(成功率>80%),再谈任务序列(VLM 规划 + 技能调用)。直接上长程任务是当前阶段不可能完成的目标。
- 优先级:动作先行,视频陪跑,价值殿后(8.6节裁决)。任务指标只认动作;NVIDIA 自己的论文路线也是先策略模式93.6%、再价值规划+12.5pp。视频在联合模式下与动作共享采样,会随动作一起变好——设"先把视频做好"为里程碑是错误的,它的正确身份是异步预览+IoU健康度监控(P1)。卡死时的免费实验:拿官方 Cosmos Policy ALOHA 权重跑你们的部署栈,一刀切开"工程问题"还是"模型问题"(7.1节逃生通道)。
- 两个被官方教程矫正的误区(3.8节):①"必须百毫秒推理"——官方 Edge 端侧是1.53秒/块 vs 2.13秒覆盖时长,时延小于块覆盖时长就能连续运动,先重定义你们的"慢";②"照抄官方配置就能训"——官方全量SFT是256张GB200×68小时的事,你们必须走 LoRA+缩 batch,同时抄它的两个便宜细节:动作头全新初始化+5×lr、视觉loss加权对齐动作loss量级(出处见3.8节专栏:Cosmos 3报告§4.2.2+源码,官方带动作配方一律10/10)。
- 你们配置的头号嫌疑(3.9节实战拆解,已按最新配置文档校准):训练是两阶段(Full SFT 33帧画布 → RTC后训练65帧画布),chunk64 的开环时域其实合理(2.13s@30Hz=官方32@15Hz),真正的嫌疑是:双任务混合(193条=93排列可乐+100拿杯子)但任务条件未验证、两阶段间画布从9→17个latent时间点的难度跳变、vision权重1导致视频分支大概率欠训(视频崩是预期内)。已确认做对的:动作头5×分组lr(1e-5/5e-5)、RTC五档随机前缀、camera-anchor。别再怀疑统一LR——分组已实现;下一步先测任务条件与分阶段开环L1,再跑 chunk32+RTC 对照(大概率丝滑与视频负担同时解决)。
- 一版训练要多少步、怎么验证训到位(7.4节,公式+方案):步数与"仿真还是真机"无关,只看样本访问量——锚点1000万(ALOHA:batch 200×5万步);你们阶段二1.4万步@batch16只有2%预算,一版应到 ≈15万优化步@有效batch64(梯度累积拼出来;小数据下epoch显示几百是正常换算,不是过拟合信号)。验证走四道闸:G1开环val L1→0.010
0.015 → G2 val曲线35K步平台 → G3官方loss分项(未来本体0.007/图像0.05~0.09)→ G4回归台SR;顺序判、过闸才看下一道——L1达标但SR低=部署/数据多样性问题,加步数无效。两套可直接抄的配置单(真机193条/仿真500条)在7.4.3。
本文怎么读:问题 → 证据 → 方案 → 执行
全文按一条主线组织,章节顺序就是推荐阅读顺序——觉得"乱"多半是因为从中间任意一节跳着读,前向引用会打架:
| 阶段 | 章节 | 回答的问题 |
|---|---|---|
| 问题 | 一、三个症状的病理学 | 二、100条数据够不够 | 我们卡在哪(症状对号入座)、弹药够不够(文献数字定论) |
| 证据 | 三、Cosmos 生态落地盘点:3.1 Cosmos 3 论文深读(DROID/实验/后训练/Edge checkpoint)→ 3.2 Cosmos Policy → 3.3 官方cookbook → 3.4~3.7 参照物与现成仓库 → 3.8 Edge教程精读+损失平衡出处专栏 → 3.9 真实管线拆解+嫌疑表 | 官方论文/源码/教程到底怎么做的、官方数字是多少,别人的项目抄什么 |
| 方案 | 四~五、仿真(平台→MuJoCo全流程)| 六、评测(开环/闭环)| 七、训练配方 | 八、推理与部署 | 具体怎么改:数据、仿真、训练、评测、部署逐项定案 |
| 执行 | 九、长程扩展 | 十、四周重建计划 | 十一、自驾→具身迁移 | 十二、自测8问 | 十三、资源 | 怎么排期、怎么验收、去哪查资料 |
两条使用说明:
- 官方数字以第三节为准:论文原文与源码级出处集中在 3.1(论文深读)与 3.8(损失平衡出处专栏)两处,其他章节引用官方数字时都会指回这两处。
- 赶时间这样读:30秒结论 → 第一节症状对号入座 → 3.9节嫌疑表(你们配置的逐项体检)→ 第七节训练配方 → 第十节四周计划。其余章节按需查阅。
一、三个症状的病理学:逐个解剖
###1.1 症状一:只预测动作丝滑,但抓不到
“丝滑"说明控制链路是通的(频率、插值、限幅都正常),问题在策略本身的能力或评测口径。按发生概率排序的病因清单:
| # | 病因 | 诊断方法 | 修法 |
|---|---|---|---|
| 1 | 开环就不准(模型根本没学会) | 开环回放测试:拿录好的数据逐步喂观测,比对预测动作与真值动作的L1。收敛目标见3.2节(0.010~0.015量级) | 数据/训练问题:加成功片段筛选、加图像增广、检查归一化统计量、训到收敛 |
| 2 | 归一化/动作空间不一致 | 对比训练端与部署端的 normalization stats、动作表示(绝对/相对、rot6d/欧拉角)、控制频率 | 严格复刻官方配方的动作契约(如 LIBERO 的 frame_wise_relative + quantile_rot),训推共用同一份 stats 文件 |
| 3 | 相机/时序漂移 | 手持标定板做视觉伺服测试:给定像素目标,看末端是否稳定到达 | 固定相机、检查时间戳同步(图像↔本体状态)、重标定手眼 |
| 4 | 夹爪时机与力控参数 | 分段统计:接近成功但夹空?还是根本没对准? | 抓取是接触问题:夹爪闭合时机、预抓取位姿、天机的刚度/力限参数单独调 |
| 5 | 闭环发散(开环准、闭环歪) | 对比开环L1与闭环成功率;观察第一个错误动作出现在第几步 | 减小执行的动作块长度(执行K步就重规划,receding horizon)、提高重规划频率 |
| 6 | 评测口径错误 | “成功"的定义是否冻结?(抓起并保持N秒/放到指定区) | 成功判据写成文档,10~30次试验出成功率+置信区间 |
第一个要建的仪器就是第1行:开环动作回放测试。它把"模型没学会"和"部署链路有问题"一刀切开——这两类问题的解决方案完全相反,混在一起讨论就是死循环。Cosmos Policy 官方评测脚本里 num_open_loop_steps=16 就是干这个的,他们的开源代码可以直接抄。
###1.2 症状二:视频+动作联训就慢
先把账算清楚——慢在哪:
推理一次动作块的开销(朴素做法):
  视频latent去噪 T_video步 × 视频DiT前向  ← 大头,和动作共享主干
  + 动作latent去噪 T_action步 × 前向
  + CFG无分类器引导 ×2 倍
  + 视频VAE解码(如果还要看图)

官方加速答案(Cosmos Policy,见3.2节):
  ① 不对称去噪:动作5~10步、未来1步(AR接力口径;联合模式三段共享一次采样的步数)
  ② 视频/价值在策略模式下可整段跳过(只训[ s ]→[a]也行)
  ③ CFG只开时间步区间(Cosmos3官方: guidance-interval [960,1001])
  ④ 异步服务:动作块流式返回(官方policy server就是异步接口)
  ⑤ 蒸馏:多步→少步→单步(F3A单步38.3仍登顶RoboLab;AHA-WAM-Flash用ODE蒸馏)
更狠的两条路线(WAM 全景分析里详述过,传送门):
- GigaWorld-Policy 的因果设计:架构上禁止"未来视频影响当前动作”,推理时视频分支整个关闭——225ms 对齐 π0.5,成功率反升7%。
- Fast-WAM 的结论:视频共训只发生在训练期,部署时零视频开销,190ms。
给你们的推荐配置:阶段一训练侧全都要(策略/世界/价值三种 loss 都算),推理侧默认低配——动作5步、视频1步并行生成;控制环不为视频阻塞。但注意,“低配"不等于"不许出视频”:推理时产出未来视频是官方既定能力(策略模式的输出就含未来状态,还带异步像素视频接口),关键是用哪种模式出、给谁看、多久出一次——完整的"又出视频又不慢还不胡说"方案见8.1~8.3节。
###1.3 症状三:视频幻觉(红可乐变蓝、没抓到画成抓到)
病理:扩散模型在去噪步数少、观测条件弱时,会被预训练先验劫持。蓝可乐、Robotiq 夹爪(3.5节病例)都是先验泄漏。三个加重因素:CFG 引导过强(把语义类别推过头)、观测条件帧的分辨率/增广与训练不一致、视频分支在你们100条数据上严重过拟合或欠拟合。
正确的心态与用法:
- 不要用预测视频判断任务成败——它是采样,不是测量。这是当前项目最需要传达给全组(尤其是领导)的一条。
- 视频的三个正当用途:a) 训练时的物理监督(让动作分支收敛到符合物理的流形);b) 推理时的受控预览/确认——以当前真实帧为锚、以动作为条件生成"接下来会发生什么”(M1并行预览 / M2前向确认,见8.1~8.2节),这是领导要的"产出未来视频"的合规形态;c) 规划器——采样多个动作块的未来,用 value 头(不是用眼睛看视频)选得分最高的执行。
- 想让视频画得准也有正经手段:提高观测条件帧在训练中的一致性(与部署同分辨率、同增广)、降 CFG、给视频帧在 loss 里适度加权、把成功抓取的片段喂够。但这是优化项,不是关键路径。
- 有一个廉价的定性体检:3.4节的前向预测并排检查(预测未来帧 vs 真机实拍,按接近/抓取/抬起三阶段看)。它用于发现系统性偏差(比如永远画错夹爪),不用于评判成功。
症状对号入座了,下一个问题是弹药:100条遥操数据到底够不够——第二节只用公开文献的数字回答,不靠感觉。
二、100条遥操数据到底够不够:用文献数字回答
这是被问得最多的问题,直接给数字底牌:
| 来源 | 数据量 | 结果 |
|---|---|---|
| Cosmos Policy 真机 ALOHA | 4任务共~185条(最少的任务只有15条) | 真机93.6% |
| Cosmos Policy RoboCasa | 每任务50条 | SOTA(67.1/71.1),“6×更少演示” |
| LIBERO 基准标准口径 | 每任务50条 | 行业通用(π0.5、X-VLA 全按此口径) |
| ACT(经典模仿学习) | 每任务~50条 | 常被引用的"起步线" |
| 数据缩放律(ICLR 2025, arXiv 2410.18647) | 4万条演示的系统研究 | 多样性»数量:环境×物体多样性服从幂律,单点重复有饱和;32个环境×每处50条 → 对全新环境+新物体90%成功率 |
| 仿真合成(2606.31101) | 每任务800条仿真、0真机 | 真机35% |
结论:100条抓可乐,够不够取决于你怎么花它。
- 够启动:单任务、场景基本固定、有强预训练基座(Cosmos 就是),50~100条是行业标准开局。先让模型"见过这个任务",跑通全链路。
- 不够泛化:如果100条全是同一张桌子、同一束光、同一瓶可乐、同一个摆位,模型学到的是"背题"——可乐挪5厘米就抓空。数据缩放律的原文结论:“收集尽量多样的环境,每个环境一种物体”,比在原地重复采样有效得多。
- 质量阀门比数量重要:官方 DROID 配方只用
success子集 + 时间窗过滤;LIBERO 训练前过滤失败演示。**你们的100条里成功片段有多少条?如果只有40条,实际有效数据是40条。**先做这个统计,很多团队死在没筛数据。
给100条数据设计"变化维度"清单(下次采集照这个来,总条数不必大增):
必变(每条至少动一样):
  可乐位置/朝向(桌面撒开摆8~10个点位)
  初始臂位姿(2~3个起始构型)
  光照(开灯/关灯/侧光分批采)
可选变(提升泛化的第二梯队):
  干扰物(纸巾盒、水杯、蓝色可乐同框)
  相机微移(±2cm重新标定后采一批)
  速度风格(快/慢遥操各半,避免只学一种节奏)
冻结不变(接口一致性):
  相机内外参、图像分辨率、控制频率、动作表示与归一化、指令话术
另外两个数据侧的实操建议:①用天机 Marvin Pro 的遥操系统时同步记录力矩/接触信息(他们力控数据是卖点),后续做接触阶段的诊断会用到;②每天采的数据当天做成功标注,别攒一周再标——标注口径(“抓起并保持2秒”)第一天就写死。
###2.1 同一张桌子、同一瓶可乐,位置变化到底多致命?以及"不重采、纯扩增"的路线图
先回答位置问题——致命,而且是泛化失败的第一嫌疑,但要看你们的真实部署分布:
- 如果部署场景就是这张桌子(会议室整理,桌子固定、光照固定,只有可乐的摆放位置变化):那"环境多样性"其实不是刚需,物体位姿多样性才是刚需。模型需要见过桌面上一片"位置×朝向"覆盖区。判据很便宜:压力测试——把可乐摆在训练分布内(采过的点位)和分布外(没采过的点位,比如边缘、角落、转90度)各跑10次闭环。分布内高、分布外塌 → 位置过拟合坐实,修法就是补位置维度的数据(下述路线A或直接补采)。
- 如果193条里可乐的起始位置本来就撒开摆过(桌面8~10个点位):那位置可能不是主因,回头查3.9节的 S0/S1(任务条件、画布跳变)。
“不自己采、把193条扩增成大得多的数据集”——有四条路线,按性价比排序:
| 路线 | 做法 | 动作标签安全性 | 成本/预期收益 |
|---|---|---|---|
| A. 视觉增广(先做,零风险) | 现有AugVideo基础上加:随机亮度/阴影(模拟光照)、轻微透视/裁剪(模拟相机微移)、颜色抖动。你们的16D绝对关节动作表示是关键优势——动作是关节空间的,跟相机怎么看无关,所以视角类增广不会作废动作标签 | 安全(只要不做会破坏左右臂语义的水平翻转) | 几乎零成本,泛化收益有限但稳赚 |
| B. 仿真合成演示(中期主力) | 在MuJoCo/Isaac里搭"桌面+可乐罐"场景(URDF找天机要),用运动规划(抓取位姿采样+逆解)批量生成带完美动作标签的演示:撒点位×朝向×光照×桌面纹理×相机位姿,每类几十条、总量上千条很便宜。先例:WAM sim2real论文每任务800条仿真、零样本真机35%——仿真数据当"预训练/增广"用,真机193条做最终微调,而不是指望纯仿真零样本 | 安全(仿真里动作天然对齐) | 搭场景1~2周,之后边际成本极低;预期把位置泛化从"背题"提到"覆盖区泛化" |
| C. 视频模型当数据工厂(远期,先别指望) | 用视频模型改写现有演示的视角/背景(GigaWorld-0/Aigen同思路)。关键限制:视频可以改,动作标签改不了——只能扩增"视觉分支"的世界知识,不能直接当策略训练数据。适合给 vision 分支做预训练,不适合给动作监督 | 危险(视角变了动作没变=标签污染) | 管线复杂、收益不确定,排在B之后 |
| D. 定向补采(用户说不采,但给个底线参照) | 20~30条"专打分布外点位"的定向数据 | 天然安全 | 如果B的两周工期等不起,这是唯一"本周就能做"的根治手段 |
路线B的具体起步清单:① 找天机要 Marvin 的 URDF/关节限位;② MuJoCo 里先不接视觉,纯运动学跑通"撒点位→规划抓取→录关节轨迹"的批量脚本;③ 加光照/纹理/相机位姿随机化;④ 生成~500条仿真演示与真机193条混合训练(仿真:真机≈2:1起步),对比纯真机基线。这条路线与第四节"仿真当回归测试台"不冲突——同一个仿真环境,既可以造数据也可以当回归台,一鱼两吃。每一步的具体做法(含必调物理参数、采集循环、混训配方、回归台规格、域随机化清单)已在第五节展开成可执行流程。
数据的账算清了,再看别人具体怎么做的:第三节从 Cosmos 3 论文原文(3.1)一路拆到官方教程与真实配置(3.8~3.9),官方数字与出处全部集中在这里。
三、别人是怎么做的:Cosmos 生态落地项目全景盘点
###3.1 Cosmos 3 论文深读:DROID、具身实验与后训练到底怎么做的(arXiv 2606.02800)
这一章要盘点的是"别人拿 Cosmos 生态做成了什么",而开篇这一节先回到源头——Cosmos 3 技术报告本身怎么描述 DROID、怎么做具身实验、怎么做后训练。你们后训练链路的每一个环节(数据、画布、动作头、超参、评测)在论文里都能找到出处。(架构与预训练侧见站内《Cosmos 3 世界基础模型精读》,本节只挖具身/策略这条线。)
3.1.1 训练课程:一个基座、三个阶段,后训练按模态分家
论文的训练全景(§3.2 / Fig.8 口径)先立起来,后面所有实验都是这张图上的格子:
Reasoner线:  预训练(图/视频-文本) ──→ SFT(物理AI任务混合)
                │ 权重初始化
                ▼
Generator线: 图像/视频/音频预训练 ──→ mid-training(引入action+跨域迁移)
                                          │ 产出: Cosmos3-Nano / Cosmos3-Super
                                          ▼
                                     post-training(按模态分别做)
                                          ├─→ Cosmos3-Super-Text2Image
                                          ├─→ Cosmos3-Super-Image2Video
                                          └─→ Cosmos3-Nano-Policy-DROID (策略)
                                    (架构与mid-trained完全相同, 只换权重)
三个关键口径:
- mid-training 才是动作的起点:动作模态在 mid-training 首次引入(机器人、相机运动、自驾、第一人称运动混合训练),产出的 Cosmos3-Nano/Super 才是策略后训练的基座。
- 损失系数从 mid-training 定下:总损失 = 各模态速度 MSE × 模态专属系数,动作项 ×10(§4.2.2 原句与源码拆解见 3.8节"出处专栏")——策略后训练"其余超参沿用 mid-training",意味着这套 10/10 系数被直接继承。
- PT-init vs MT-init 是论文的主线消融:PT-init = 拿预训练权重直接后训练,MT-init = 拿 mid-trained 权重后训练。后面每一个具身实验都在成对对比这两条初始化,结论一致:MT-init 更快更强——这也是"官方发布基座(都是 mid-trained)比裸预训练权重值钱"的论文级证据。
3.1.2 DROID 是什么,Cosmos 3 在四个位置用它
DROID 本体(Khazatsky et al., 2024):大规模真机遥操操作数据集——76k 条轨迹、约350小时、86个任务、564个场景,Franka Panda 机械臂 + Robotiq 2F-85 夹爪,多路相机 + 本体感受状态,跨多机构采集。论文 §4.2.5 直接引用这组数字(你们的 193 条 vs 这 76k 条,量级差 ~400 倍)。
DROID 在 Cosmos 3 里出现在四个位置(别混,这是论文读法的关键):
| 位置 | 角色 | 论文出处 | 具体数字 |
|---|---|---|---|
| ① mid-training 机器人数据 | 动作先验的原料之一 | §3.2.3 / Tab.4 | “Franka Panda"行(含 DROID):67.5K task / 76.3K episodes / 442小时;全表 90.4K task、516.7K episodes、5.36K小时(AgiBot 4.37K小时最大,其余 Google Robot 351h、WidowX-250 100.1h、UMI 67h、UR 35h) |
| ② post-training 策略数据 | Policy-DROID 系列的训练集 | §4.2.5 | nvidia/Cosmos3-DROID,LeRobot v3.0 格式、640×360 |
| ③ 前向动力学实验数据 | FD 基准评测 | §6.2.5 / Tab.18 | 初始帧 + 16步动作 → 预测后续16帧 |
| ④ 运动规划目标来源 | SFT 数据的 motion-plan 标注 | §3.1.2 SFT | 规划目标来自跟踪过的 DROID episodes |
官方数据集的三步闸门(教程 + cookbook 一致口径):
- 滤空闲/非任务帧——
keep_ranges_1_0_1.json窗口过滤:只有窗口起点落在保留区间内的训练窗才被使用,字典里没有的 episode 整条丢弃;打开它=复现发布模型用的约74%窗口集(cookbook Step 3,默认关闭时训全量窗口)。 - 只留成功演示——发布的即是 success 子集。
- 训练时增广——随机裁剪 + 缩放 + 色彩抖动(CPU侧,DROIDLeRobotDataset 图像增广器)。
hf download nvidia/Cosmos3-DROID --repo-type dataset --local-dir /path/to/Cosmos3-DROID
# dir MUST be named droid_plus_lerobot_640x360_20260412 (loader parses schema from dir name)
# DROID_ROOT points at the parent that CONTAINS success/, not .../success
论文的数据处理细节(§3.2.3 Action,工程上都很值钱):
- 伪动作(pseudo-actions):用状态差分生成动作,规避各数据集 PID/低层执行接口的差异——这是把异构机器人数据喂进统一动作 token 的关键一步。
- 成功 + 失败都留(mid-training 层面):让模型见过"非预期的动作后果”;这与 policy SFT 的"只留成功"不矛盾——两层不同策略:打基础看全谱,精调策略只学成功。
- 空闲段不删:空闲步数记进 metadata,由采样器显式平衡活跃/非活跃段——而不是粗暴丢帧。
- 多视角拼画布:多路同步视角拼成一张画布,布局存 metadata(接口契约思想的论文出处)。
- 归一化分两套:mid-training 逐维 normalizer 拉到约 [-1,1];DROID policy 配方是例外——裸关节值、不归一化(3.8节表),少一整类训推不一致风险。
3.1.3 具身实验全景:数据集、平台、指标、结果
论文的具身实验集中在 §6.2.5(另有 FD/ID 与迁移消融),一张表看全:
| 实验 | 平台/数据集 | 协议 | 关键结果 |
|---|---|---|---|
| Robotics 前向动力学(FD) | DROID(真机数据) | 初始帧+16步末端动作→16帧 | 对比 Ctrl-World 22.99dB:PT-init Nano 23.24(打平);MT-init Nano 25.52、Super 26.04(明显超越) |
| 第一人称 FD | HWB 第一人称手部基准 | 相机自运动+手部动作→生成视频 | 对比 LOME 9.36dB:PT 15.22/15.34,MT 16.12/16.19(Nano/Super) |
| Policy:RoboLab | 仿真,RoboLab-120 | 120 语言条件任务 × 3 指令粒度(vague/default/specific)× 难度分层,每任务 10 次 rollout;所有对比模型都是 DROID 微调的现成 checkpoint | specific 39.7% vs π0.5 28.1% vs DreamZero 25.2%;default 36.8%;同款 PT-init 对照只有 30.2% → mid-training 的贡献可量化 |
| Policy:RoboArena | 真机,众包 DROID 平台 | 双盲 A/B 两两对比聚合排名 | 2026-05-30 榜首;定性:能做 pick-place、长程多步、对没见过的物体/任务泛化、失败会重试、抗人为干预 |
| Policy:MolmoSpaces | 仿真,系统性泛化基准 | Combined 两套任务(Pick/Pick&Place/Open/Close + MolmoBot 7任务) | 2026-06-20 All Combined 第一,39.0% oracle SR;同一 checkpoint、零基准调参(对 RoboLab/RoboArena 用的同一套超参) |
| 新 embodiment 快速适配 | LIBERO-10(仿真,多视角) | 每验证任务 50 trials → 每 checkpoint 500 rollouts | @500步:MT 24.6% vs PT 0.0%;@1000:91.4% vs 73.8%;@2000:97.4% vs 95.2% → MT-init 前期碾压,后期追平 |
| 动作数据协同 | mid-training 各动作域 | 域间 transfer map(FD PSNR / ID MSE) | WidowX-250 ← Google Robot +1.39 FD PSNR / +2.29 policy PSNR;Google Robot ← 多个搭档最高 +0.89/+1.44 → 混什么动作域不是随便混,是可测的配方问题 |
平台总结:仿真三件套 = RoboLab(120任务语言泛化)+ MolmoSpaces(系统性变化泛化)+ LIBERO-10(新 embodiment 适配);真机 = RoboArena(社区 DROID 平台众包)+ 论文 Fig.25 的实机 rollout 展示。全部围绕 DROID 生态——训练在 DROID,评测要么 DROID 系真机,要么"给所有基线同样喂 DROID"的公平仿真榜。
3.1.4 后训练怎么做:论文口径(§4.2.5)+ 工程复现四步
论文口径——Cosmos3-Nano-Policy-DROID 是这样炼成的:
- 起点与动作头:从 mid-trained Cosmos3-Nano 续训(另有 PT-init 消融);动作编码器、解码 MLP、embedding tokens 全新初始化;动作参数 5× 学习率。
- 输入:本体感受状态(
use_state=true)+ 三相机画布——腕部 360×640 叠在两个外视 180×320 上 → 540×640。 - 输出:32 个未来绝对关节位置动作 @15Hz + 辅助 RGB 未来视频帧(联合训练)。
- 数据:DROID 官方短指令作 prompt;空闲帧过滤 + 失败演示剔除 + 训练时随机增广。
- 超参:lr 2e-4,其余沿用 mid-training(= 损失系数 10/10,见3.8节出处专栏);梯度裁剪 1.0。
- 推理:4 步采样 + shift 5;CFG 3(CFG 并行);跳过视频 latent 解码提速;Franky 关节控制器执行 32 步 @15Hz;策略服务端跑在 2× RTX Pro 6000。
- 结果:RoboLab / RoboArena / MolmoSpaces 三榜第一(上表)。
工程复现口径——cosmos-framework docs/action_policy_droid_posttrain.md 的四步:
# Step 1: download dataset (dir name MUST be droid_plus_lerobot_640x360_20260412)
hf download nvidia/Cosmos3-DROID --repo-type dataset --local-dir /path/to/droid_plus_lerobot_640x360_20260412
export DATASET_PATH=/path/to/droid_plus_lerobot_640x360_20260412

# Step 2: base ckpt -> DCP (CPU-only re-shard; base can be Cosmos3-Nano or Cosmos3-Edge)
python -m cosmos_framework.scripts.convert_model_to_dcp --checkpoint-path Cosmos3-Nano -o $BASE_CHECKPOINT_PATH

# Step 3: window filter (reproduces ~74% window set of the released model)
hf download KarlP/droid keep_ranges_1_0_1.json --local-dir $FILTER_DIR

# Step 4: launch (TOML holds run-level scalars; registered experiment holds data/action knobs)
bash examples/launch_sft_action_policy_droid_nano.sh
关键旋钮(TOML + 实验注册处逐项):lr 2e-4;global batch 8192 = 32样本/rank × 256 ranks(HSDP 32×8;GB200 参考 64节点×4);10000 迭代;loss_scale 10;长余弦 cycle 100000;grad_clip 1.0;每1000步存档、可断点续训;复现 run 关 eval。三个容易踩的细节:
- 单机8卡怎么跑:保持 global batch 8192 →
replicate_degree=1 + grad_accum=32(TOML 注释原方子)。 - 动作头必须全新:checkpoint 加载时
keys_to_skip_loading跳过action2llm / llm2action / action_modality_embed / action_pos_embed——基座里没有动作接口,加载不到就对了。 - 实验名带 nano 不等于基座必须 Nano:文档明说基座可选 Nano 或 Edge;Edge 教程列的启动脚本是
launch_sft_action_policy_droid_edge.sh(我方克隆的主线仓库是launch_sft_action_policy_droid_nano.sh,换基座改BASE_CHECKPOINT_PATH即可)。
3.1.5 Cosmos3-Edge-Policy-DROID:你们问的那个 checkpoint
它是什么:官方 Edge 端侧教程(3.8节精读的那篇 NVIDIA 博客)的产物——Cosmos3-Edge 基座(4B omni,内含 2B Nemotron reasoner,与 Nano/Super 同一物理世界预训练)+ 同一套 DROID 后训练配方,发布为 HF 检查点 nvidia/Cosmos3-Edge-Policy-DROID。它与论文主角 nvidia/Cosmos3-Nano-Policy-DROID 是同一配方、不同基座的两个产物。
怎么训出来的(教程口径,逐条对齐论文 §4.2.5):
| 环节 | Edge-Policy-DROID 的做法 | 与论文 Nano 版的差别 |
|---|---|---|
| 基座 | Cosmos3-Edge checkpoint(4B,2B reasoner) | 论文主模型用 mid-trained Nano |
| 数据 | nvidia/Cosmos3-DROID,三步闸门同款 | 完全相同 |
| 配置 | Table 1:joint_pos 8D 不归一化、540×640 三相机画布、chunk 32 @15Hz、动作头全新+5×lr、损失平衡(3.8节)、lr 2e-4、global batch 8192、长余弦 cycle 100K、每1K存档 | 完全相同(同一套配方) |
| 训练预算 | 博客正文:"64 nodes of 4× GB200、60K iterations、约68小时(~17.4K GB200-时)";而 Table 1 写 “10K-iteration run"(cookbook 复现 TOML 也是 max_iter=10000) | 两处口径并存:抄配置按 10K-iter 的 Table 1/TOML;评估算力预期按 68h×256 卡的现实 |
| 部署 | Jetson AGX Thor T5000:BF16 权重约 9GB,单块推理 1.53s vs 覆盖 2.13s,OpenPI WebSocket 服务端,TORCHDYNAMO_DISABLE=1 | 论文 Nano 版服务端在 2×RTX Pro 6000 |
| 成绩 | RoboLab 120 任务 22.9% | 论文 Nano 版 36.8%(default 口径)——差距来自基座规格与训练预算,不是配方;这条差距本身校准了"小基座+端侧"的预期 |
复现与部署入口(3.8节教程精读的对应动作):数据 hf download nvidia/Cosmos3-DROID → 基座转 DCP(BASE_CHECKPOINT_PATH 指向 Edge)→ 开 keep_ranges 过滤 → bash examples/launch_sft_action_policy_droid_*.sh → export_model 出 HF safetensors → Jetson 上跑 policy server。
3.1.6 三个 checkpoint 的关系与给你们的三条读法
Cosmos3-Edge (4B基座) ─┐
                       ├─ 同一套DROID后训练配方 ──→ Cosmos3-Edge-Policy-DROID   (端侧版, RoboLab 22.9%)
Cosmos3-Nano (mid-trained) ─┤                                Cosmos3-Nano-Policy-DROID (论文主模型, 三榜第一)
                       │
(PT-init消融: 预训练权重直接后训练 → 各项全面落后 MT-init)
- 你们的两阶段管线 = 论文 post-training 的一个变体。论文三件套"动作头全新初始化 + 5×lr + 沿用 mid 超参(含 10/10 损失系数)",你们已做对前两件——第三件(损失配比)正是3.8节出处专栏 + 3.9节 S2 要你们用日志校准的。
- MT-init 红利你们已经在手:官方发布的基座全是 mid-trained 权重,LIBERO-10 的 24.6% vs 0% 说明这个起点本身值钱——别再从裸预训练权重重训。
- 对内汇报的引用链从此闭环:收敛目标引 §4.2.5,榜单口径引 Tab.19/Tab.20,数据闸门引教程三步,损失系数引 §4.2.2 + 源码(3.8节专栏)——每个数字都有出处,不再"网上看的”。
###3.2 Cosmos Policy——最重要的一份配方(NVIDIA+Stanford,ICLR 2026)
如果这篇文章只读一节,读这节。Cosmos Policy(arXiv 2601.16163)就是"把 Cosmos 视频模型微调成真机策略"的官方原版做法,作者 Moo Jin Kim、Chelsea Finn、Shuran Song、Percy Liang 等,代码在 NVlabs/cosmos-policy,配菜谱在 Cosmos Cookbook,HF 上直接有训好的检查点。
核心方法:latent frame injection(潜变量帧注入)。不动架构,把新模态直接塞进视频扩散的 latent 序列里,按顺序排布:
latent序列: [空帧][当前本体s][当前图像×N][动作块a][未来本体s'][未来图像][价值V]
             ↑条件帧(干净)                ↑目标帧(加噪去噪)

三种训练模式(同一个模型,靠"哪段干净哪段加噪"切换):
  策略模式:  [s]              → [a, s', V]     ← 推理时只跑这个
  世界模式:  [s, a]           → [s', V]
  价值模式:  [s, a, s']       → [V]

batch配比:策略50% / 世界25% / 价值25%
三个对你们直接有用的细节:
- 动作路径不读预测出来的视频。策略模式下动作是从当前观测条件直接生成的,未来图像是"顺带"生成的兄弟输出。所以视频画错不影响动作质量——你们看到的"视频说抓到了但动作没抓到"在这个框架里是正常的,两者本来就解耦。
- 不对称去噪步数(官方推理配置):
num_denoising_steps_action=5,num_denoising_steps_future_state=1,num_denoising_steps_value=1。动作5步、视频1步——视频根本不需要精细去噪,它只是辅助监督;这就是"联合预测又快又能打"的官方答案。 - 可选的规划模式:直接策略已经 SOTA;要更高成功率,就采样多个动作块、用价值头选最好的那个(best-of-N),真机困难任务上再涨12.5个百分点。价值头是视频幻觉问题的正确替代品——用学出来的 value 判断哪次尝试会成功,而不是看生成的视频。
成绩与数据量(直接回答你们"100条够不够"):
| 场景 | 数据量 | 成绩 |
|---|---|---|
| LIBERO(仿真,40任务) | ~2000条(每任务50条) | 平均98.5%,超 π0.5 |
| RoboCasa(仿真,24任务) | 每任务50条 | 67.1%(P2)/71.1%(P2.5),比用300~3000条的方法都高,官方口径"6×更少演示" |
| 真机 ALOHA(4任务) | 总共约185条(叠衬衫15/糖果入碗45/糖果入袋45/茄子摆盘80) | 平均93.6%,加规划再+12.5pp |
训练超参(真机ALOHA口径):batch 200、50K步、学习率1e-4、动作块50、8×H100 跑48小时;推理只要6GB显存。噪声用70% log-normal + 30% 均匀混合分布,推理时 σ∈[4,80];图像训练带增广+JPEG压缩+翻转(trained_with_image_aug=True, use_jpeg_compression=True)。
收敛损失参照(官方给的"训练够了"的量化标准):动作L1 ≈ 0.010–0.015、未来本体L1 ≈ 0.007、未来图像latent L1 ≈ 0.05–0.09、价值L1 ≈ 0.007。你们训练完先对这张表——如果动作L1还在0.05以上,说明还没训到收敛,后面怎么调推理都是白搭。
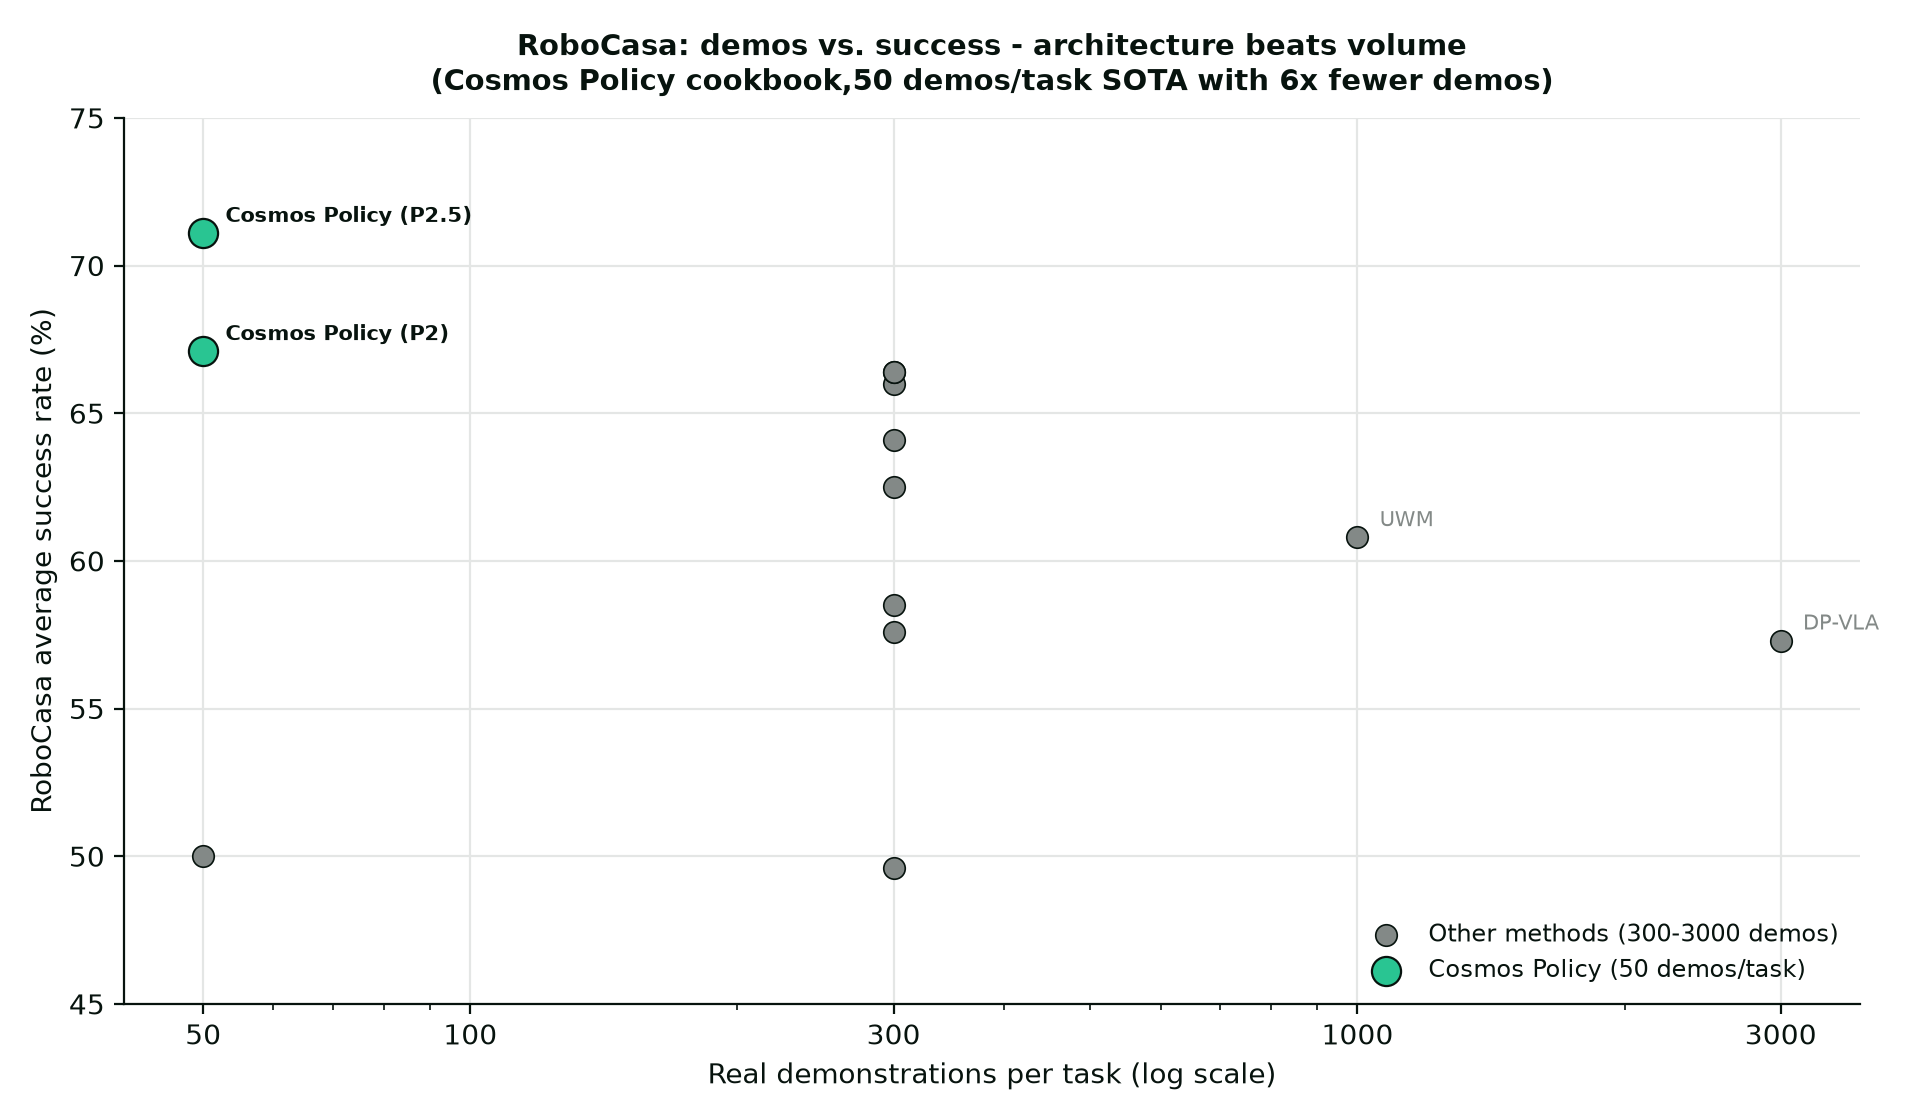
RoboCasa基准:横轴每任务真实演示数(对数),纵轴平均成功率。绿色是Cosmos Policy——每任务仅50条就超过用3000条的DP-VLA。结论:架构与配方比数据堆量更关键,“100条不够"这个假设本身需要先被检验。数据来源:Cosmos Cookbook官方对照表。
Cosmos Policy 这篇论文到底在干嘛?和 Cosmos 3 什么关系?能不能直接用?
三个问题一次讲清。
论文在干嘛:回答一个开题问题——”一个视频世界基础模型,能不能用少量演示后训练成真机策略?“它的答案分四层,层层递进,这就是论文的骨架:
- 方法层:latent frame injection——不动架构、不加外接动作头,把本体/动作/价值全部当作"视频帧"塞进同一个latent序列(3.2节开头那张图)。同一个模型靠"哪段干净哪段加噪"切换策略/世界/价值三种模式。
- 基准层:LIBERO 98.5、RoboCasa 每任务50条即SOTA(“6×更少演示”)——证明配方在仿真里成立,且数据效率碾压外接头路线。
- 真机层:ALOHA 双臂平台、4任务总共185条演示、93.6%——证明配方在真实世界、真实数据噪声下也成立。这是全文最有分量的数字,因为你们的处境(真机+小数据)和这一层一模一样。
- 决策层:训练一个 V(s’) 价值头(用648条多策略混合rollout单独finetune),推理时采8个候选动作块让价值头选优——真机困难任务再涨12.5pp。这一层证明"未来预测"的正确用法是参与决策,不是参与执行。
一句话总结:这是一篇"配方论文”——它不提出新架构,而是把"视频模型→真机策略"的完整工程配方(数据量、超参、收敛指标、部署开关、规划升级路径)第一次系统性地端出来,并配开源代码与权重。
和 Cosmos 3 的关系:同一条血脉的两代。两者都是 NVIDIA(Cosmos Policy 的作者单位含 NVlabs,与 Cosmos 系列同门):
| Cosmos Policy(2025末/ICLR 2026) | Cosmos 3(2026年中) | |
|---|---|---|
| 底座 | Cosmos-Predict2-2B(上一代世界模型,2B参数) | Cosmos3 本体(Edge 4B / Nano 16B,更新一代全模态世界模型) |
| 角色 | 研究原型:验证 latent injection 这条路能走通 | 产品化正统:同思路官方化——action SFT(策略/前向/逆动力学三模式)写进 cosmos-framework |
| 代码 | NVlabs/cosmos-policy(research 代码,ALOHA deploy.py 就是你们8.1节看到的那套) | NVIDIA/cosmos-framework + cosmos cookbook(服务端/客户端、RoboLab、LoRA、量化生态) |
| 真机先例 | ALOHA 185条→93.6%(论文级验证) | 官方 DROID policy 权重已发布;第三方 SO-101 项目在跑(3.7节) |
| 规划/价值 | V(s’) + best-of-N,+12.5pp,论文完整验证 | 模式齐全(FD/ID/WAM),规划细节 cookbook 较薄 |
| 现状 | 研究代码,维护节奏慢 | 主推路线,cosmos-lite 等加速生态都围着它转 |
血缘关系一句话:Cosmos Policy 证明了"latent 注入"这条路能打93.6%;Cosmos 3 是把这条路搬进更新、更强的底座并产品化——你们在 cosmos-framework 里看到的 policy/FD/ID 三种模式,就是 Cosmos Policy 三模式(策略/世界/价值)的工业版命名。不是两个竞争方案,是同一个方法的论文版和工程版。
能不能用 Cosmos Policy?能,但分三种用法:
- 当主线底座?——不推荐,但有一个例外。理由:底座是上一代2B模型、research 代码没有官方服务端/量化生态、真机配置绑定 ALOHA 双臂。例外:如果你们的 Cosmos 3 SFT 反复失败想推倒重来,Cosmos Policy 的 ALOHA 配方是最小的真机验证底座(185条先例、6GB推理显存),而且天机 Marvin 本身就是双臂力控平台——运动学形态恰好是 ALOHA 的近亲。
- 当部署栈的"标准答案"——强烈推荐。你们主线继续 Cosmos 3,但把官方 HF 权重
nvidia/Cosmos-Policy-ALOHA-Predict2-2B在你们的部署栈上跑通:如果官方权重在你们的管线里也出视频乱码/动作偏移,病在部署栈不在模型——这是一个能立刻把"数据问题"和"工程问题"切开的免费实验。 - 当抄写对象——必须抄。8.1节的源码级拆解(latent 画布槽位、INDICES_TO_REPLACE、训推一致性 flags)全部来自 Cosmos Policy 的 deploy 代码;第二阶段的规划升级(V(s’)、best-of-N、AR 接力)也只有 Cosmos Policy 论文给了完整验证。主线用 Cosmos 3 的壳,配方和规划抄 Cosmos Policy 的魂。
###3.3 Cosmos 3 官方 action-policy SFT cookbook——你们该直接抄的起点
你们用的是 Cosmos 3(不是 Predict2),对应的官方配方在 NVIDIA/cosmos 仓库 cookbooks/cosmos3/generator/action/finetune,三份开箱即用:
| 配方 | 基座 | 数据 | 关键超参 |
|---|---|---|---|
| DROID(真机转仿真评测) | Cosmos3-Nano | Cosmos3-DROID success子集(LeRobot格式) | lr 2e-4 cosine、loss_scale 10、全局batch 8192、10000迭代、动作块32、JSON动作prompt |
| LIBERO-10 / all | Cosmos3-Nano | LIBERO_LeRobot_v3 | lr 5e-5、warmup 500、batch 2048、2000/5000迭代、rot6d 10-D、分位数归一化 |
| RoboCasa(移动底盘) | Cosmos3-Nano | RoboCasa LeRobot v3.0 | lr 5e-5、batch 2048、15-D动作(底盘4+模式1+位姿3+旋转6+夹爪1)、chunk 32@20fps |
四个必须抄对的工程细节(抄错了训练直接白给):
- 数据格式:LeRobot v3.0;动作归一化方式(
quantile_rot/None)必须与推理端一致。 - JSON prompt 一致性:DROID 配方的动作用 JSON 序列化(
format_prompt_as_json=True),训练和推理必须用同一种 prompt 格式,官方原文强调 “evaluation must use the matching JSON prompt format”。 - 成功筛选:官方数据集就是
success子集,还附带keep_ranges_1_0_1.json时间窗过滤器——垃圾片段直接不进训练集。 - CFG 只开区间:推理服务端 guidance-interval 只对去噪步 [960,1001] 施加无分类器引导,而不是每步都开——省算力的官方姿势。
部署侧官方也给了完整链路:policy server(流式吐动作块)+ 客户端,客户端接仿真(RoboLab)或真机;动作服务是异步接口(POST /v1/videos 回调动作数据)。Cosmos 3 的三种动作模式(policy / inverse dynamics / forward dynamics)里,policy 模式(图+指令→视频+动作块)就是你们要的,而 Edge 版(Cosmos3-Edge-Policy)就是为实时部署准备的。
###3.4 首篇 WAM sim-to-real 论文——仿真到底能不能救你们
arXiv 2606.31101(Efficient Sim-to-Real Transfer of World-Action Models from Synthetic Priors)是第一篇公开的"世界行动模型零样本 sim2real"工作,直接建立在 Cosmos Policy 上,对你们的三个问题都有参考价值:
- 做法:Cosmos Policy + 大规模域随机化 + AnyTask 自动生成演示(每任务约800条、共约3200条全合成),40×H100 训32轮(约72小时),零条真机数据。
- 结果:Franka Research 3 真机四任务平均**35%**成功率(每任务10次)。论文自称"首个WAM的sim2real成功迁移"。
- 读法:35%不高——这证明仿真能显著降低真机数据依赖,但纯仿真到不了可交付水平(对照组:Diffusion Policy 用10~50条真机数据也能打)。结论:真机100条 + 仿真回归台/数据增广,才是务实组合。
- 顺手学到的评测法:他们用前向预测定性检查——把模型预测的未来帧和真机同时刻相机画面并排对比(接近、抓取、抬起三阶段),肉眼看预测是否跟得上真实执行。这是介于开环和闭环之间的低成本体检,你们应该立即采用。
###3.5 视频幻觉的公开病例——你们不是一个人在踩坑
- Say, Dream, and Act(arXiv 2602.10717):同样是拿 Cosmos-Predict2 做真机操作,论文明确记录了幻觉病例——模型把机器人的夹爪画成了 Robotiq 两指夹爪,原因是预训练数据里这种夹爪太多。和你们"红可乐变蓝可乐"是同一性质:低步数扩散按语义先验补全,而不是忠实重建观测。
- 该文的解法也值得抄:①先用"空间指代能力"筛选视频基座(它试了 Cosmos-2B/14B/DROID版/Wan,选最优再改);②latent 空间对抗蒸馏把视频模型压成少步去噪;③动作模型单独用 Qwen2.5-VLM + LoRA(r=64)训练,真实轨迹和想象轨迹混训。真机训练只用了1000迭代——小步快跑。
- 你们要建立的心智模型:视频预测是"采样"不是"测量"。同一个观测采样十次会画出十种未来(包括三种颜色的可乐)。它的价值在训练时提供物理监督、在推理时可选地做 best-of-N 规划,唯独不在"当成绩单"。
###3.6 同生态的其他参照物
- GigaWorld-0 / GigaBrain-0(GigaAI):世界模型不当策略也不当仿真器,当数据工厂——合成(视频,动作)对,VLA 只吃合成数据就能真机叠衣服、倒果汁(本地有逐图精读)。给你们的启示:如果真机数据采集成本高,“合成数据+小规模真机微调"是已被验证的第二条腿。
- GR00T-Dreams / DreamGen:视频模型生成未来轨迹→自动转演示,NVIDIA 生态里"视频→数据"的另一条管线。
- AnyTask:上面 sim2real 论文用的自动演示生成器,仿真演示量产工具。
- 你们的 arm 厂商**天机(Tendo/广东天机智能)**本身就有配套:Marvin Pro 遥操数采平台(3头+2腕相机、Jetson Orin、VR遥操 KernelMind-Apex)、Fusion 运动控制 API(位置/力/刚度全开放)、ROS2/Python/C++ SDK。数采质量和接口文档直接找天机官方拿,别自己从零摸。
###3.7 GitHub 现成项目盘点:别人已经跑通的完整管线(2026-10 实测检索)
前面讲的是论文,这一节讲仓库——你点名要的"别人 GitHub 上用 Cosmos 微调机械臂的现成项目”。以下全部是 2026-10-10 当天用 GitHub API 实测检索/核对过的,按"和你们的相关度"排序。
第一梯队:照着搭就能用的完整工程(重点抄这三个)
| 仓库 | 是什么 | 和你们的关系 |
|---|---|---|
| kabilankb/so101-cosmos-nano-policy | Cosmos3-Nano 在 SO-101 机械臂上的完整后训练+服务+评测管线:train → merge → export → serve → warmup → evaluate 全链路,一个 CLI(so101 doctor/train/checkpoints/...)打通两个互不兼容的 Python 环境(服务端 cosmos-framework py3.13 持有策略、Isaac Lab Kit python 跑仿真),LoRA 配方 + 数据集筛选文档,单次 SFT 约48h | 最接近你们要的东西:真臂微调→部署→仿真的全流程现成代码。它 README 里那句话直击你们的痛点:“图像布局、动作空间、夹爪约定、归一化、视角描述——这些两边都不检查的东西,就是为什么所有 flag 必须集中在一个被测试过的地方”(= 本文《接口契约》的工程化版本) |
| codemasterzhao/cosmos3-so101-armnet-eval | 用官方 cosmos-framework 跑 Cosmos3 Edge 前向动力学模型在 ArmNetBench SO-101 数据集上的开环/teacher-forced rollout,动作敏感性探针 + SAM3 掩码 IoU 视频质量评测 | 两个独家价值:①**“推理时产出未来视频"的现成实现**——动作块自回归链(chunk k 以 chunk k−1 生成的最后一帧为条件),20Hz 拼接成视频;②把"视频画得对不对"变成了可计算的数字(SAM3 IoU + 质心距离),你们和领导再也不用靠肉眼吵架 |
| xxxxyu/cosmos-lite | Cosmos3 策略的推理加速运行时:低比特量化产物 + RTX 4090 优化 runtime + RoboLab 复现评测(120任务×10次闭环) | 直接回答你们的"慢”:Edge 4B BF16 单请求 p50 582ms → GenW8A8 量化 331ms;Nano 16B 2403ms → 959ms(量化后成功率不降反微升:31.50→31.67)。它默认采样器就是 2步 UniPC + guidance 3——官方量级的少步推理在 RoboLab 上是站得住的 |
第二梯队:官方核心仓库(Star 数为2026-10-10快照)
NVIDIA/cosmos (12012★)          ← Cosmos3官方主仓:cookbooks里有action SFT三配方
nvidia-cosmos/cosmos-predict2.5 (1378★) ← 世界基础模型本体
NVlabs/cosmos-policy (887★)     ← 真机ALOHA 93.6%那篇的代码
nvidia-cosmos/cosmos-predict2 (792★)
NVIDIA/cosmos-framework (561★)  ← 推理/训练框架,第三方项目的公共底座
NVlabs/RoboLab (558★)           ← 官方仿真评测平台(闭环成功率)
nvidia-cosmos/cosmos-cookbook (478★) ← 后训练脚本合集
第三梯队:周边弹药库
- zhiheng-ma/awesome-video-action-models:Video Action Model 论文精选清单——找"别人怎么用视频模型出动作"的路线图。
- 视频数据增广三件套(把 Cosmos 当数据引擎用,对你们100条数据扩多样性质子有用):userdarius/cosmos-aug(Edge 迁移外观增广,给 GR00T/LeRobot 数据集造变体)、Miical/EmbodiedDataTransfer(Cosmos 生成机器人视频变体建增强数据集)、hkolla1611/SO-101-Video-Augmentation(LeRobot + PAIDF + Cosmos Transfer 2.5 管线)。
- vnmoorthy/once:Show a robot once——口述任务→Cosmos 生成→Isaac 演练的一次性教学,“真机少采"的激进路线。
- naveentnj/cosmos-embodied-ai:Cosmos Edge WAM 的模块化仿真评测框架;vigorlee/wave-go(107★):Cosmos3-Edge 混合长程导航在宇树 Go2 上的落地(导航侧参照,不是机械臂)。
- 官方 HF 成品:
nvidia/Cosmos3-Nano-Policy-DROID、nvidia/Cosmos3-Edge-Policy-DROID、nvidia/Cosmos3-DROID数据集——别从零训 DROID 基座,从成品检查点起步。
结论:你们要抄的三件事
- 管线结构抄 so101-cosmos-nano-policy:服务端/仿真端分离、单 CLI 入口、接口 flag 集中管理——这正是你们缺的"接口契约"的代码形态。
- 视频评测抄 cosmos3-so101-armnet-eval:前向动力学自回归出视频 + SAM3 IoU 打分,让"未来视频"既有产出又有质量数字。
- 推理提速抄 cosmos-lite:量化(GenW8A8)+ 2步 UniPC,4090 上亚秒级——比学术蒸馏路线近得多,今天就能试。
###3.8 官方教程精读:Cosmos 3 Edge 端侧部署(NVIDIA 官方博客,2026-08-19)
NVIDIA 官方博客《Post-Train NVIDIA Cosmos 3 Edge for On-Device Robot Control》是目前唯一一篇官方手把手的"Cosmos3→真机策略"端到端教程(后训练→Jetson Thor 服务端→receding-horizon 控制→RoboLab 闭环评测)。逐条汲取如下——它对你们的价值不亚于 Cosmos Policy 论文,因为它是工程版。
这篇教程在干嘛:把 4B 的 Cosmos 3 Edge(内含 2B Nemotron reasoner 的 omni 模型,与 Nano/Super 同一物理世界预训练)后训练成 DROID 策略,直接跑在机器人本体的 Jetson Thor 上(BF16 权重约 9GB,无需数据中心 GPU),RoboLab 120 任务闭环 22.9%(对照:Nano 36.8%)。
配置表逐行拆解(Table 1,DROID Edge 口径——多处直接矫正你们的做法):
| 官方设置 | 数值 | 对你们的启示 |
|---|---|---|
| 动作空间 | joint_pos 8维绝对关节位置(7关节+夹爪) | 关节空间动作天然有界 |
| 归一化 | 裸关节值,不归一化 | 用关节空间就别做归一化——少一整类训推不一致风险(对照你们:若天机用关节位置控制,这是最简路线;若用末端位姿才需要归一化) |
| 动作头 | 全新初始化:encoder+MLP+embedding tokens,5×学习率 | 基座本来没有动作接口,后训练新建;动作头要单独给高学习率——你们若全网统一lr,动作头很可能欠训 |
| 损失平衡 | 视觉 flow-matching loss 加权去对齐动作 loss 的量级 | 这就是8.5节角度4的官方答案:不是拍脑袋设权重,而是让两个 loss 量级匹配,防止单方主导——你们"联训就慢/视频抢戏"的病根药方。它出在哪篇论文/哪段源码、官方精确数值是多少,见下文"出处专栏” |
| 观测画布 | 腕部360×640 叠在两个外视180×320 上 → 540×640 | 画布几何官方口径:固定排布+固定分辨率,写进接口契约 |
| 动作块 | 32步 @15Hz(≈2.13秒运动) | 见下面的延迟哲学 |
| 训练规模 | global batch 8192(HSDP 32×8=256 ranks);官方验证 run 64节点×4=256张 GB200、约68小时(~17.4K GB200时);配置表为10K迭代(长余弦 cycle 100K,每1K存checkpoint) | 残酷的现实检查:官方全量SFT是256张GB200级别的事。你们照抄配方必须配套改造:LoRA(so101 项目路线,~48h单机可跑)或大幅缩 global batch + 调 lr——直接抄 batch 8192 是不存在的选项 |
| 数据闸门 | Cosmos3-DROID:7.6万条成功轨迹、350小时、86任务、564场景;三步准备:过滤空闲帧 → 只留成功演示 → 训练时随机裁剪/缩放/色彩抖动 | 与7.2节一致,补上"过滤空闲/非任务帧"这一具体闸门 |
| 协议 | 服务端说 OpenPI WebSocket 协议(DROID 生态通用),客户端 openpi_client 直连 | 你们的客户端不用自己写协议——官方 action_policy_server_robolab + openpi_client 即插即用 |
出处专栏:损失平衡的加权计算出在哪篇论文(论文→源码→教程三级证据)
直接回答你们的问题:论文级出处是 Cosmos 3 技术报告(arXiv 2606.02800)§4.2.2 “Training objective”,不是 Cosmos Policy;完整的加权计算实现写在 cosmos-framework 源码里;上面表格那句"Vision flow-matching weighted to match action loss"是教程层的浓缩。三级证据全部可点开核对:
| 层级 | 出处 | 原文/证据 | 说了什么 |
|---|---|---|---|
| 论文层 | Cosmos 3 报告 §4.2.2 | “The total loss in mid-training is the sum of per-modality velocity MSEs weighted by modality-specific loss scales, with action losses scaled by 10× to compensate for the smaller per-element MSE of normalized action vectors.” | 总损失 = 各模态速度MSE × 各自模态损失系数 之和;动作项×10,去补归一化动作向量更小的逐元素MSE——“按模态分别加权"就是论文白纸黑字的方法 |
| 论文层(衔接) | 同报告 §4.2.5 Robot Policy Post-Training | “We use a learning rate of 2×10⁻⁴ with other hyperparameters following the mid-training setup.” | DROID 策略后训练继承 mid-training 的损失系数——论文的 loss scale 10 + action×10 就是官方策略配方的出身(§4.2.5 同段还写明动作参数 5×lr,与上表对应) |
| 源码层① | model_config.py 默认值 | action_loss_weight: float = 10.0 + 官方注释 “please adjust this value according to loss_scale to balance the action loss with the video loss” | 框架把调参指令直接写在配置默认值上:动作权重要按视觉 loss_scale 配平 |
| 源码层② | omni_mot_model.py 总损失拼装处 | 开发者注释(Yihuai):“In case the video loss is too large (1.5) and covers the action loss (0.05), we scale up the action loss to match the video loss to improve action precision.” | 为什么需要这套加权的原始数字:video 1.5 vs action 0.05,差30倍,不加权动作头被视频项压死 |
| 源码层③ | action_policy_droid_nano.py DROID配方 | loss_scale = 10.0 + 注释:“loss_scale multiplies only the vision term, balancing it against the action loss (action_loss_weight=10) so both heads train at comparable gradient magnitude” | 官方验收标准写死在注释里:加权后两个头的梯度量级可比——“对齐量级"的准确含义 |
| 教程层 | 本节 NVIDIA 博客 Table 1 | “Loss balance: Vision flow-matching weighted to match action loss” | 表格里那一行的原句出处 |
总损失公式(对着源码逐行核对):
L_total = loss_scale        × L_v   (视觉 flow-matching: 视频走loss_scale,
                                      图像项若image_loss_scale非None则单独覆盖)
        + action_loss_weight × L_a   (动作 flow-matching)
        + 各专属项        (sound/lidar/radar 有专属scale, 为None时回落到loss_scale)
        + 辅助loss        (load balancing等, 不参与这套模态缩放)

官方默认:  action_loss_weight = 10.0     (nano/Edge 一致)
           视觉 loss_scale    = 1.0  (Nano纯视觉SFT) → 10.0 (Edge基座+全部动作后训练配方)
验收标准:  加权后的两个模态项梯度量级可比 (源码注释原话 comparable gradient magnitude)
官方数值谱系——所有带动作的配方清一色"10/10”,没有一家是"10/1”:
| 配置 | 视觉 loss_scale | action_loss_weight | 出处 |
|---|---|---|---|
| Cosmos3-Nano 基座默认(纯视觉SFT,无动作项) | 1.0 | 10.0 | nano_model_config.py |
| Cosmos3-Edge 基座(Cosmos3-Edge.yaml) | 10.0(image_loss_scale=None→图像继承10) | 10.0 | edge_model_config.py 注释"Edge delta (nano=1.0)" |
| DROID policy SFT 配方(教程同款) | 10.0(只覆盖视频项;图像项保留1.0) | 10.0 | action_policy_droid_nano.py L244-247 注释 “Weight the vision flow-matching loss 10x in the total loss (the NANO default is 1.0)” |
| LIBERO / RoboCasa 配方 | 10.0(image_loss_scale=None→图像也继承10) | 10.0 | action_policy_libero*.py / action_policy_robocasa_nano.py |
| 论文 mid-training(§4.2.2) | “loss scale 10” | ×10(“compensate for smaller per-element MSE”) | Cosmos 3 报告 |
为什么必须对齐——模态量级不对称是论文记录在案的:Cosmos Policy(arXiv 2601.16163)附录报了收敛时的原始指标:动作 L1 0.010~0.016 vs 未来腕部图像 latent L1 0.068~0.097(差5~10倍),并明说 “The magnitudes of these losses imply that the model more quickly learns to predict actions, proprioception, and values than images”——不同模态天然不在一个量级,共享主干的梯度会被大的那项牵着走,这正是"平衡"要解决的问题(Yihuai 注释里 30 倍的 video/action 是更极端的实例)。
落到你们的配置(与3.9节的 r 判定法合起来用,三步):
- 对齐官方档位:官方带动作配方 = loss_scale 10 / action_loss_weight 10;若你们沿用框架默认 action_loss_weight=10(3.9节按此推算),你们基线的视觉系数1只有官方口径的 1/10,曾试的 vision=5 也还没到官方档位——第一步把视觉 loss_scale 拉到与动作权重同档。
- 再按日志校准:抄到"10/10"只是起点,验收标准是加权后梯度量级可比——拉~1000步原始loss算
r=L_v/L_a(判定公式见3.9节),画加权后的两条曲线确认同数量级、动作项不被压死。 - 改完看两个信号:阶段二 vision loss 是否还在降(视觉欠训修复没有)、动作L1 是否不退化(没有反向被压)。
损失平衡的三级出处到此闭环。教程的第二大贡献在推理侧——先纠正对"慢"的定义:
延迟哲学——对"太慢"症状的根本性矫正(本节最重要的一条)
Edge 在 Jetson AGX Thor T5000 上每个动作块推理约1.53秒,而一个动作块覆盖约2.13秒的运动——推理时延 < 动作块覆盖时长,就能连续运动:执行当前块的前16步(15Hz)期间下一块已在算,重规划用真实测得的关节位置(state-conditioned)从"手臂实际在哪"续起,自带纠偏。
翻译给你们听:官方端侧方案根本不是"百毫秒级实时",而是1.5秒级推理照样连续干活。你们把"推理慢到不可用"重新定义一下——如果1.5秒能连续动,那"慢"的真正问题只剩:①是否阻塞了动作下发(串行解码视频之类,8.5节角度1);②是否低到无法在关键节点重规划(接触瞬间)。按这个标准重新测你们的延迟,大概率"慢"的问题会缩小一半。
教程里另外三条直接可用的情报
- 官方服务端开一个开关就返回"想象的 rollout 视频"(原文:starting the server with video decoding enabled returns the policy’s imagined rollout alongside the actions)——领导要的"推理产出未来视频"在官方边缘部署路径里就是一等公民选项,与动作同响应返回。8.2节 M1 的合法性再添官方背书。
- 部署彩蛋:Thor 上要
TORCHDYNAMO_DISABLE=1(eager 模式)——官方 Triton 轮子缺 sm_110a kernel。你们若未来跑 Jetson(注意:天机 Marvin Pro 数采平台本身就用 Jetson Orin AGX 64G,Edge 的 9GB BF16 理论上塞得下),这类坑提前记下。 - 基座选型校准预期:Edge(4B)在 RoboLab 120 任务大杂烩上也只有 22.9%——官方基线在多任务泛化上本来就不高。你们的任务是单任务专精(抓可乐),有100条针对性数据,应该远高于这个数字才对;反过来,如果你们的仿真回归台在单任务上还达不到50%+,说明确实有工程/数据问题,不是"模型本来就菜"。
Aigen 案例:教程附赠的合成数据视角
用 Cosmos 后训练生成杂草/作物的多样化合成图像,除草系统只用1%真实数据训练即达到强性能——对应你们阶段二的"视频模型当数据工厂"路线(GigaWorld-0同款思路)。
给天机项目的三条落地建议(从本节直接推出)
- 动作空间走关节位置+不归一化(如果任务允许)——把训推不一致风险砍掉一大块,这是官方 DROID 口径。
- 损失权重抄官方做法:视觉 loss 加权对齐动作 loss 量级,而不是拍一个固定系数——官方带动作配方一律 loss_scale 10 / action_loss_weight 10,出处与公式见上文"出处专栏"。
- 训练规模务实化:全量 SFT 别想(256×GB200),走 LoRA + 小 global batch + 对照收敛损失表(3.2节)判断是否训到位;官方每1K存checkpoint的习惯照抄,方便挑早停点。
差距分析:为什么官方 demo 视频效果好,而你们"100条 + chunk 64 + 全量微调"不行(结合本教程逐条对)
| 维度 | 官方 Edge 教程 | 你们的配置 | 差距的含义 |
|---|---|---|---|
| 数据构成(你们问的"混采") | Cosmos3-DROID:7.6万条成功轨迹、350小时、86个任务、564个场景,Franka+Robotiq 单 embodiment;三步闸门(滤空闲帧→只留成功→增广)。参照 Cosmos Policy ALOHA 小数据先例也是4任务混合(15/45/45/80条)——官方小数据成功从来不是"单场景+单物体+单姿态" | 193条双任务混合(93排列可乐+100拿杯子/瓶子,见3.9节)——比"单任务100条"健康一档(对齐ALOHA的多任务混合精神),但大概率仍是同一张桌子/同一物体家族 | 任务多样性及格了,环境/位姿多样性仍存疑。两个动作:①验证任务文本确实进了CFG条件(否则两任务互相稀释,3.9节S0);②可乐起始点位做分布内/外压力测试(2.1节)——位置过拟合是抓取任务的第一杀手 |
| 训练方式 | 全量微调,但合法性建立在76k条数据+256×GB200上 | 全量微调 + 100条 | 官方全量的前提你们不具备。100条上全量微调=灾难性遗忘(物理先验被冲掉→视频胡画)+死记硬背(挪5cm就抓空)双风险。100条的正确姿势是 LoRA基座+全量训动作头(7.1节配置),或至少把 backbone lr 压到1e-5量级+重增广+早停 |
| 动作头 | 全新初始化 + 5×学习率 | ?(待查你们config) | 5×lr 的含义见7.1节:新模块从零开始需要大步长,预训练基座需要小步长防遗忘——单一 lr 无法同时满足两边,这可能就是"动作丝滑但不准"的一个来源 |
| chunk 长度 | 32 @15Hz(≈2.1秒覆盖) | 64 @30Hz(≈2.1秒覆盖,见3.9节实战拆解) | 两维评价:开环时域两者相同,不是问题;真正的代价在 latent 空间——画布65像素帧经 VAE 时间压缩后 17个latent时间点 vs 官方9个(见8.1节⚠框),视频外推难度与注意力开销约2×,是慢/视频崩的共同放大器。降 chunk 作为对照实验(一次重训看视频质量与延迟变化) |
| 算力 | 256×GB200、batch 8192 | 小得多 | 无法照抄官方步数/batch;用 LoRA+收敛损失表判断"训到位没有",别用"跑了多少小时" |
| 预期校准 | demo 视频是精选案例;RoboLab 120任务闭环只有 22.9% | 看demo觉得"应该能行" | 好看的视频≠配方随便抄都能成功。官方视频好是因为它在76k条数据上训练;把官方demo当验收标准是误读。你们单任务+100条的合理预期:仿真回归台单任务SR应显著高于官方多任务均值,否则就是有工程/数据问题 |
按影响排序的修改清单(细化版见3.9节嫌疑表)
① 先测开环动作L1——一条命令,把"模型没学会"和"部署链路歪"一刀切开,所有后续决策的分水岭;② 若欠收敛坐实:梯度累积把有效batch提到64+、总步数对标ALOHA量级(1000万样本访问),全量改"LoRA基座+全量动作头"(或极小 backbone lr)控制遗忘;③ chunk 64→32 作为对照实验(时域等值,砍的是17→9个latent时间点的视频难度与延迟);④ 数据过闸门(滤空闲帧、只留成功)+ 按第二节的变化维度清单补多样性——这一步不做,前几步的效果也会打折;⑤ 动作头单独5×lr;⑥ 损失权重先拉原始值算 r=L_v/L_a 再定(判定公式见3.9节),勿拍系数。你们如果有具体的训练文档/config,逐行对这几条即可定位主因。
###3.9 实战管线逐项拆解:一个"两阶段 + RTC + camera-anchor"真实配置在教什么(匿名案例)
拿到了一份与你们几乎同构的真实训练/推理配置文档(基于 Cosmos3-Edge 的自研管线,驱动双臂平台,LeRobot/Parquet 数据;为避免暴露内部信息,配置名与路径匿名化,只保留技术参数)。这一节把它逐项拆开,与官方配方对齐——它恰好是前面所有论断的活标本,也修正了我们前两轮的几个假设(数据不是100条单任务,是 193条双任务混合;训练是两阶段结构;动作头其实已经带5×lr;当前基线 vision 权重是1不是5)。
管线画像:两阶段训练 + RTC 推理
数据(更正后的事实)
  193个episode,30FPS,LeRobot/Parquet:
    93条 "排列可乐罐" + 100条 "拿起杯子/瓶子"   ← 双任务混合,配置未按任务过滤
  三路相机: cam_high + 左腕 + 右腕
  state: 16D (左臂7关节+左夹爪1+右臂7关节+右夹爪1)
  action: 16D双臂绝对关节动作,pad到64D,只监督前16维
  每样本: 65帧连续视频 + 64个未来动作,stride=8重叠切窗

阶段一: 普通 Tianji Full SFT
  基座:  Cosmos3-Edge (32-step版, 33帧画布/32动作) → Full SFT → .pt checkpoint
  (文档未披露本阶段超参; 与阶段二共用数据集)

阶段二: Native RTC 后训练 (resume_weights_only=True: 只载权重,优化器/调度器全新,从0步重来)
  画布:  65帧/64动作 → Wan VAE x4 → 17个latent时间点
  RTC前缀: 随机 P ∈ {0,4,8,12,16}
    动作: 前P步作干净条件,后64-P步为预测目标
    视频: 前P+1个原始帧(=(P+1)/4个latent)作重叠条件,其余latent为生成目标
    (P=0:1帧/1latent; P=16:17帧/5latent ← 推理时用的就是P=16)
  camera-anchor: vision条件只锚定第0个latent(当前真实帧)
  损失:   total = 10 x raw_action_flow + 1 x raw_vision_flow
  学习率: 基座1e-5 / 动作模块5e-5 (5x分组!已实现)  warmup 200, grad clip 1.0
  batch:  4/GPU x 4 x A800 = 全局16, 12 epochs (~1176步/epoch)
  可训:   freeze_vlm_backbone=False 但 freeze_non_moe_vlm_backbone=True
          → MoE生成分支全量训 + 动作projector/modality embedding全量训
            (注意: 不是LoRA! 基座生成分支是全参微调)
          VAE与非MoE理解分支冻结
  保存:   每500步+每epoch, 最多留4个
  显存备注: 65帧样本很吃显存, 不够时单卡batch降1~2(全局batch随之减小,需梯度累积补偿)

推理侧
  模式:  4步UniPC联合生成 → 64动作+未来视频latent, 每步回写clean前缀+vision锚
  执行:  execute_horizon=44, 第44步时发下一chunk请求
  RTC:   前缀=上一chunk的 previous_actions[44:60] (16步,对齐训练P=16档)
  发布:  30Hz异步; 预算: 覆盖2.133s, 理想上限533ms, 硬上限667ms
  已知缺口: 自适应RTC参数未接线; 视频配置分裂; CUDA Graph未开; 安全开关未设
先说这份管线里做对了什么(别把孩子和脏水一起倒)
按行业标准看,这份配置的工程品位其实高于平均水平,值得先说清楚,否则后面改坏了就可惜了:
- RTC 前缀训练=推理一致,且覆盖完整。训练时前缀随机取 {0,4,8,12,16} 五档(覆盖冷启动到最深续接),推理用 P=16 档——这是 π0.5/GR00T 一脉的"原生动作分块流式"做法,训推契约在这条轴上是严格对齐的。五档随机比"只用0/16"更稳健。
- camera-anchor = 我们8.3节反幻觉原则的正确实现。vision 只锚定当前真实帧(latent 0),历史预测视频不进条件——这正是"永远回锚真实观测、不链式幻觉"的官方/论文共识(keyframe re-anchoring 同思路)。你们的"视频崩"症状反而不是这条设计导致的。
- 异步执行 + 时间预算表。把 chunk 覆盖、请求时刻、尾部硬上限算成一张表贴在配置注释里——这就是3.8节"延迟哲学"的正确姿势(覆盖时长>推理时延即可连续运动)。2.133s覆盖 vs <667ms硬上限,预算逻辑成立。
- 推理端服务器做预处理 + 数据集统计量 unnormalize。归一化契约由服务端持有训练期统计量统一处理,客户端只管发关节命令——训推一致性风险从结构上砍掉一大块(1.1节病因2的预防针)。
- 冻结策略 + 分组学习率都做对了。VAE 与非MoE理解分支冻结、MoE生成分支全量训;学习率 基座1e-5 / 动作模块5e-5 = 正好5×分组——官方教程"fresh action heads + 5×lr"的正确实现(7.1节那条配置他们已经落地了)。保守的1e-5基座lr对小数据是合理选择。
- 增广齐全(颜色/裁剪/CFG dropout 0.1)——ALOHA 先例反复证明的"小数据+扩散必配重增广"没丢。
- 两阶段训练结构本身是好设计。先 Full SFT 建任务能力(33帧画布),再 RTC 后训练适配流式部署(65帧画布)——比单阶段端到端硬啃更稳,checkpoint 也可回溯。问题不在结构,在两阶段之间的画布长度跳变(下一框分析)。
两阶段之间发生了什么:chunk 32→64 的动机与代价
文档明确写了动机:阶段一的普通模型"不够丝滑",所以升级到 chunk 64。这个推理链值得单独拆——
"chunk 32 不够丝滑"的三种可能病因(症状相同,修法完全不同):
  a) 块边界跳变: 每个chunk交接处动作不连续 → 正解就是RTC前缀(他们阶段二已加!)
  b) 覆盖不足:  32/30Hz=1.07s覆盖,若推理延迟接近或超过它 → 运动断续
                 正解是压延迟或加长覆盖,chunk64(2.13s)确实解这个
  c) 动作本身欠准: 开环L1就没训好 → 加大chunk只会把错误外推得更远

他们的实际操作: a)和b)的解法(RTC + chunk64)一次性全上了
风险: 混杂变量——如果加了RTC后变丝滑了,分不清是RTC的功劳还是chunk的功劳;
      而chunk64把视频任务从9个latent时间点拖到17个(难度~2x,官方从未验证)
更干净的实验设计:阶段一 checkpoint 就位后,跑三条平行对照——① chunk32 + 朴素推理;② chunk32 + RTC(画布仍33帧/9 latent,但交接由前缀条件平滑——大概率丝滑问题的正解,且视频任务不加倍);③ chunk64 + RTC(现状)。三条各训一次(阶段二本来就是轻量后训练),用开环L1 + 边界处动作跳变幅度 + 真机成功率三个指标裁决。大概率②就够,且比③好训得多。
另外注意一个结构风险:resume_weights_only=True 意味着阶段二优化器全新、从0步重来,且学习率只按"从头训"的 warmup 走——对"在已收敛权重上做画布适配"这种任务,更稳妥的做法是更低的峰值lr+更短的warmup。如果阶段二的动作L1长期降不到阶段一的水平,这是第一个该查的超参。
“视觉loss加权去对齐动作loss量级"到底什么意思(你们直接问的)
先把三个概念钉死,再给可执行的判定方法。(这个加权计算的完整出处——Cosmos 3 报告 §4.2.2、cosmos-framework 三段源码注释、官方数值谱系——见3.8节"出处专栏”,本节只讲怎么算。)
① flow-matching loss 是什么:训练时给 latent 加随机噪声(随机时间步 t),网络预测"速度场"(从噪声指向数据的方向),loss = MSE(预测速度, 真实速度)。动作分支和视觉分支各算一个这样的MSE,各自独立。
② 为什么两个loss不能直接相加:动作 latent 和视觉 latent 的天然数值尺度不同(维度、方差、VAE缩放系数都不一样)。哪个原始loss更大是经验问题,不是先验问题——必须看日志。共享主干收到的梯度 = 10×∇L_action + w_v×∇L_vision,哪一项大,主干就优先给谁打工。
③ “对齐量级"的正确操作(官方原文 “Vision flow-matching weighted to match action loss” 的完整含义):
步骤: 拉最近~1000步训练日志,取两个原始loss的均值
  L_a = mean(raw_action_flow_loss)     -- 加权前
  L_v = mean(raw_vision_flow_loss)     -- 加权前
  r   = L_v / L_a                      -- 原始量级比

若要均衡:    w_v = w_a / r   例: w_a=10, r=4 → w_v=2.5 (不是拍脑袋的5)
若要动作优先(P0阶段): 让加权后 10xL_a >= w_vxL_v, 即 w_v <= 10/r
验收: 训练曲线上画"加权后的两条loss",肉眼看是否同数量级、动作项不被压死
你们的权重要求证(当前基线 vision=1,曾有 vision=5 的实验变体)。把两种配置分开说:
- 基线 10/1:动作项几乎独占梯度(除非 raw_vision > 10×raw_action)。这个方向符合"动作先行"的P0原则,但有个副作用正好对上你们的症状三——vision 权重1 + 17个latent时间点的高难视频任务 + 阶段二只有12个epoch的适配预算,视频分支大概率欠训练 → 推理时视频崩是"预期内"的。视频崩在这里不一定是bug,可能是配置的必然后果。
- vision=5 变体:如果当时是为了"把视频训好看"而加权重,方向就反了——视频在193条数据上变好看通常是记住训练场景(幻觉面反而更大),且动作项份额从10:1被稀释到10:5。判断方法不变:拉原始loss算 r=L_v/L_a;若要"动作优先且视频可用”,正确区间是
w_v ∈ [1, 10/r],再配合"视频只做异步预览、不进决策"的用法(8.6节裁决)。
一个免费的交叉验证:查最近的 checkpoint,把 vision 权重临时调回量级匹配值做200步短训,对比动作L1——如果动作L1明显变好,坐实"视觉项压过动作项"。
头号嫌疑排序(按这份管线的具体证据)
| 排名 | 嫌疑 | 证据与机理 | 定量判据(先测再改) |
|---|---|---|---|
| S0 | 双任务混合但任务条件未验证 | 数据实为193条双任务(93排列可乐+100拿杯子/瓶子),配置不过滤、注释还停留在"只保留93条"。若任务文本没真正进条件(prompt缺失/两任务共用同一句指令),模型学的是两个行为的平均——两头都不像 | 检查LeRobot的task字段是否进了CFG文本条件;分别对两类任务测开环L1——若都差且相近,优先查这个 |
| S1 | 阶段二画布跳变适配不足 | 阶段一33帧/9 latent → 阶段二65帧/17 latent,视频任务难度翻倍;optimizer全新、lr按"从头训"配置(1e-5/5e-5 + warmup200),适配预算仅12 epoch。阶段一checkpoint是否收敛也未验证——如果阶段一动作L1就没达标,阶段二在沙子上盖楼 | 分别测阶段一/阶段二checkpoint的开环动作L1(对照0.010~0.015)。阶段一达标、阶段二变差 → 坐实画布跳变,优先试 chunk32+RTC 对照 |
| S2 | 损失配比未做量级校验 | 基线10/1方向正确但从未对照原始loss验证;vision5变体如果是为"视频好看"而加则方向反了 | 拉原始loss算 r=L_v/L_a,画加权后两条曲线;视频欠训与否看阶段二的vision loss是否还在降 |
| S3 | chunk 64 → 17个latent时间点 | 动机是"chunk32不够丝滑",但丝滑问题的正解可能只是RTC前缀(与chunk长度解耦);17 latent难度≈官方9的2倍,官方从未验证 | chunk32+RTC 对照组(画布不变长,只靠前缀平滑交接)——大概率即丝滑又少一半视频负担 |
| S4 | 4步UniPC过于激进 | 官方 Cosmos Policy 动作5~10步;cosmos-framework FD默认30步;4步是否可用取决于速度场质量(S1/S2决定) | 同一checkpoint做 4/8/16步开环L1消融;若4步明显差先回退8步 |
| S5 | 画布分辨率疑似偏离预训练档位 | 逐路256×256方形缩放(可能挤压宽高比)+自定义拼接布局;官方管线一律 letterbox 到预训练tier尺寸。分布外输入=先验劫持温床 | 逐路 letterbox 到tier尺寸后短训对比 |
| S6 | 无验证集切分(报告未见) | 过拟合不可见。stride=8重叠切窗让相邻窗高度相关,有效多样性更低 | 按episode切10~15%做val(两类任务都要覆盖),监控动作/视觉L1的val曲线 |
| S7 | 工程卫生(配置自陈) | 自适应RTC参数未接线、视频配置分裂未合并、CUDA Graph未开、安全开关未设、存档最多留4个(回溯余地小) | 逐条清账 |
怎么读这张表:S0 是一票否决项,五分钟查完,先查它(任务文本没进条件的话,后面全部白测);然后 S1 的"分阶段测开环L1"是所有决策的分水岭;S2/S4 用已有 checkpoint 即可验证(零训练成本);S3 的 chunk32+RTC 对照组是性价比最高的重训实验;S5/S6 是数据与画布卫生;S7 清欠。注意旧版嫌疑表里的"训练暴露量只有ALOHA的2%“在两阶段结构下要打折扣——阶段一可能已经训到位了,该测的是阶段一/阶段二各自的L1,而不是拿阶段二的步数直接对标。
答疑:官方 DROID 教程是"这么多数据然后零样本泛化"吗?
不是,别被demo视频误导。分三层说清楚:
- 训练=大规模全量监督SFT:Edge 教程是在 Cosmos3-DROID 7.6万条成功轨迹、86任务、564场景上全量SFT(256×GB200×68小时),不是小数据、不是零样本训练。
- 评测=跨域泛化:RoboLab 120任务评测(22.9%)是"真机DROID训练 → 陌生仿真任务测试"的跨域零样本评测,数字也不高——官方用它校准预期,不是炫技。
- 小数据先例属于另一条线:真正对应你们100条场景的,是 Cosmos Policy 的 ALOHA 配方(185条、4任务、真机93.6%),基座还是更小的2B。你们的项目在血统上属于ALOHA线,不属于DROID线——路线选择、预期校准、对标的收敛指标都应以ALOHA先例为准。
本周行动清单(从这份管线直接推出)
- S0五分钟检查:任务文本(“排列可乐”/“拿杯子”)确实作为CFG条件进模型了吗?两类任务的开环L1分开测了吗?
- 分阶段测开环动作L1:阶段一checkpoint和阶段二checkpoint各测一次(对照0.010~0.015)——定位问题出在任务学习还是画布适配。
- 拉原始loss算 r=L_v/L_a,把加权后两条曲线画进同一张训练图;看阶段二的vision loss是否已经躺平(欠训证据)。
- 同一checkpoint做 4/8/16步UniPC消融(零训练成本),选定部署步数。
- 切val集:按episode切10~15%,两类任务都要覆盖。
- 规划 chunk32+RTC 对照组(阶段二轻量重训):大概率同时解决丝滑问题与视频负担减半。
- 位置泛化压力测试(见第二节末尾):把可乐摆在训练分布外的3~5个位置跑闭环,成功率塌不塌一测便知。
- (若S1坐实阶段二适配不足)梯度累积补偿全局batch、评估LoRA基座+全量动作头作为并行实验。
证据链齐了,开始动手:第四~八节是方案(仿真 → 评测 → 训练 → 推理逐项定案),第九节以后是执行(长程扩展、排期、验收、查资料)。
四、仿真怎么做:平台地图与正确预期
###4.1 先回答"仿真有没有用”——有用,但不是你们以为的那种用
公开证据链摆在一起:
| 路线 | 代表工作 | 结论 |
|---|---|---|
| 仿真只做方法开发,真机做最终训练 | Cosmos Policy(LIBERO/RoboCasa调方法 → 真机ALOHA部署) | 最稳,真机93.6% |
| 纯仿真训练 + 域随机化 → 零样本真机 | 2606.31101(每任务800条仿真演示) | 首个WAM sim2real成功,真机35%——可用但不可交付 |
| 世界模型当数据工厂(非仿真器) | GigaWorld-0/GigaBrain-0 | 合成数据训练的VLA真机干活成功 |
| 不用仿真,纯真机小数据 | Cosmos Policy ALOHA、ACT、LeRobot生态 | 50~185条可打,行业主流 |
给你们的定位:仿真不是用来替代那100条真机数据的,而是解决你们当前三个更痛的问题:
- 回归测试台:训练/推理代码改一行,先在仿真里跑N次成功率,确认没退化再上真机。没有它,真机试错一次几十秒+人工复位,迭代速度差一个数量级。
- 隔离变量:真机上"抓不到"有标定、时序、接触、模型十个变量缠在一起;仿真里物理是确定的、状态全知,能干净地回答"是不是模型的问题"。
- 后续的数据增广:等方法稳定后,再上域随机化/合成演示(对照3.4节的35%路线和GigaWorld-0路线),降低对真机采集的依赖。
不建议的预期:指望高保真仿真复现"夹爪夹可乐"的接触物理再训出策略——瓶身滑移、夹爪胶垫形变这类细节 sim2real 差距极大,投入产出比最低。
###4.2 平台怎么选:MuJoCo 还是 Isaac Sim?
这是你问的"issasim"(Isaac Sim)与 mujoco 的选型问题。2026年的社区共识(附对比依据):
| 维度 | MuJoCo(+Robosuite/LIBERO) | Isaac Sim / Isaac Lab |
|---|---|---|
| 物理 | 接触丰富任务金标准(软接触模型,抓取/插拔迁移最稳) | PhysX硬接触,需调solver参数 |
| 上手 | pip install mujoco 即用 | 需特定GPU+驱动、10GB+下载、Omniverse运行时 |
| 渲染 | 功能性、不照片级 | RTX光追照片级,域随机化生成训练图很强 |
| 并行 | MJX可GPU并行(约75K steps/s/4090) | 4096环境~150K steps/s,大规模RL占优 |
| 生态 | OpenVLA/π0/Octo 的评测架几乎全是 MuJoCo 系;LIBERO、Robosuite 是基准 | 人形/移动机器人 sim2real 主流;GR00T 体系;URDF→USD导入 |
| 新势力 | mjlab(Isaac Lab式API + MuJoCo Warp GPU物理) | — |
你们的选型建议(分阶段):
- 阶段一(现在):MuJoCo 系。目的就是建回归台。任务建模从简:桌面+可乐(圆柱体)+夹爪,物理参数标个大概即可——因为你用它测的是策略逻辑与接口,不是接触保真度。LIBERO 的任务套件(130任务、语言条件)是现成模板,甚至可以直接拿它的评测协议。
- 阶段二(方法稳定后):Isaac Sim/Lab 做照片级域随机化,或干脆用合成数据引擎(GigaWorld-0/AnyTask 路线)产数据。判断标准很简单:真机失败案例里"视觉泛化"(换个光、换个桌布就懵)占大头时,才值得上 Isaac。
- NVIDIA 官方参照:Cosmos 3 的策略评测客户端就是 RoboLab(NVlabs 出品,仿真基准),policy server 出动作、RoboLab 跑闭环——你们可以原样搭一套当回归台。
###4.3 天机 Marvin 臂的仿真模型怎么办
天机是新兴厂商,MuJoCo Menagerie / Isaac 资产库里大概率没有现成的 Marvin 模型。工具链是成熟的,按顺序试:
- 找天机要 URDF/SDK:他们官网明确 Marvin SDK 开放(Python/C++/ROS2),工业臂行业惯例 URDF 是交付物之一;一拖二控制器、Fusion API 都是现成接口。
- URDF → MJCF:mujoco 的
mujoco_mjcf转换器 /urdf2mjcf工具,Menagerie 里每个模型都是这么来的;先只转臂+法兰,夹爪用 Franka/Robotiq 的成熟模型近似。 - URDF → USD:Isaac Sim 的 URDF Importer,一键带碰撞与惯性。
- 相机必须对齐:仿真相机的内外参、安装位(第三人称+腕部)要和真机部署完全一致——否则回归台测出的泛化是假的。
- 控制接口对齐:真机用什么控制模式(关节位置/末端位姿/阻抗),仿真就用什么,频率一致(比如20Hz)。
本章只给了平台地图与预期管理;从零搭出一个能抓可乐的 MuJoCo 环境、批量造数据、混进训练、再到域随机化 sim2real 的完整手把手流程,全部在下一章。
五、MuJoCo 仿真训练全流程:把"抓可乐"先在仿真里跑通
你们的原话是"仿真测的抓可乐任务都完成不了"。这一章把问题拆开:先定位失败卡在哪一层,然后走完 环境搭建 → 数据采集 → 训练 → 闭环评测 → 域随机化与 sim2real 五步。目标很务实:两周内搭出一条"仿真里成功率可复现"的回归台(第六节的评测体系有了执行载体),再谈把仿真数据混进真机训练。
5.1 先分层定位:你们的仿真抓可乐卡在哪一层
仿真里任务"完成不了"有四种完全不同的病因,修法互不相通。在写任何训练代码之前,先用脚本专家把前三层验完:
L1 资产层   模型能加载吗?夹爪能闭合吗?可乐会不会被"穿透"?      ← 纯物理,不涉及模型
L2 控制层   撒点位→张开→下降→闭合→停顿→抬升 的脚本能抓起来吗?   ← 脚本专家成功率
L3 接口层   录制的脚本轨迹喂给策略重放,动作回放误差≈0吗?        ← 开环重放一致性
L4 策略层   策略(哪怕随机权重)能输出合法动作吗?训练后SR爬升吗?   ← 前三层过了才怀疑模型
- L1/L2 不过就去训策略 = 用模型给仿真器的 bug 背锅。行业经验:新手搭的抓取环境第一次脚本抓取成功率经常不到一半,原因全是接触参数/夹爪建模/时序问题,与学习无关。
- 放行标准:脚本专家(关节路点回放或运动规划)在同一套随机种子下 ≥95% 抓起成功率(抓起 = 可乐离桌≥5cm 并保持1秒),才允许进入 L3/L4。这就是第四节"仿真隔离变量"的实操化:真机上十个变量纠缠的问题,在这里被拆成四层各测各的。
5.2 环境搭建:从 URDF 到能抓可乐的 MJCF 场景
5.2.1 资产清单(最小可用集)
| 资产 | 来源建议 | 关键参数 |
|---|---|---|
| Marvin 臂 | 找天机要 URDF → mujoco_mjcf 转 MJCF(流程见4.3节) | 关节限位、控制模式与真机一致 |
| 平行夹爪 | Franka hand / Robotiq 2F-85 的 MuJoCo Menagerie 模型 | 指垫摩擦、闭合行程、指尖几何 |
| 可乐罐 | 自建圆柱体:radius 33mm、height 122mm、mass 0.35kg | 质量别用默认 1kg——“夹不起/一抬就滑"的头号来源 |
| 桌面 | 带摩擦的厚板 | 桌高与真机对齐(写进后续域随机化范围) |
5.2.2 五个必调的物理/控制参数(抓取失败高发区)
<!-- (1) finger-pad friction: default 0.5 almost always slips on cylinders -->
<geom name="finger_pad" type="box" friction="1.2 0.005 0.001" .../>

<!-- (2) gripper drive: tendon force must be enough to pinch hard -->
<tendon><general name="grip" tendonrange="0 0.05" gear="50" limited="true"/></tendon>

<!-- (3) contact solver: thin fingers vs cylinder, default iters may jitter -->
<option solver="Newton" iterations="50" tolerance="1e-10"/>

<!-- (4) control rate aligned with real robot:
     30Hz policy -> timestep 0.002 x decimation 15 -->
<option timestep="0.002"><!-- physics dt; decimation=15 -> 30Hz control --></option>

<!-- (5) controller mode: real robot uses absolute joint-position targets,
     so use position actuators in sim with kp matched to real (~80).
     Do NOT switch to OSC operational-space control: interface mismatch
     makes the regression bench measure the wrong thing. -->
- 相机:第三人称 + 腕部(与你们真机配置完全一致的路数),内参/安装位姿按真机标定值填,渲染分辨率用你们训练分辨率(如 256×256)。内外参不一致的回归台,测出的泛化是假的(4.3节的强调,这里是落地版)。
- 观测/动作契约:观测 = 多视角 RGB + 本体关节角/夹爪开度;动作 = 与真机同维的绝对关节位置目标(你们是 16 维)。在仿真 wrapper 里就把归一化/反归一化配平——与真机推理服务端用同一套契约,这是 L3 层能通过的前提。
5.2.3 一分钟冒烟测试(四条全过再往下)
① 模型加载不报错;② GUI 里夹爪开合正常;③ 随机撒点位的脚本抓取肉眼可行;④ 保存/回放一条 episode 状态无 NaN。
5.3 仿真数据采集:三条路与你们该走的配方
| 路线 | 做法 | 产量 | 适用 |
|---|---|---|---|
| A. 脚本专家/运动规划(推荐起步) | 撒点位 → 逆解/路点 → 张开→下降→闭合→停顿→抬升;2606.31101 的 AnyTask 管线即此路线 | 一天可产数千条 | 先过 L2 层 + 造第一批训练数据 |
| B. 仿真遥操 | mujaco viewer/SpaceMouse/键盘在仿真里人遥操(robosuite 的 DataCollectionWrapper 现成支持) | 人速,约 100 条/小时 | 脚本覆盖不了的灵巧段 |
| C. 真机数据迁移 | 真机 193 条直接转格式进训练 | 已有 | 与 A/B 混合 |
你们的推荐配方(两条公开先例夹出的可行区间):2606.31101 用每任务 800 条仿真演示 + 域随机化做到零真机迁移(真机 35%,“可用但不可交付”);LeRobot 社区的 SO-101 仿真抓放项目只用 105 条仿真人工演示就训出 ACT、仿真闭环 SR 66.7%——几百条量级即可训出"仿真里可用"的策略。
- 先用路线 A 产约 500 条确定性成功演示:撒点位覆盖桌面 5×4=20 个位置 × 若干朝向/初始姿态扰动;只收成功 episode。
- 格式与真机数据同构:LeRobot(parquet+mp4)或你们真机管线在用的格式;图像键名、动作维度、归一化统计量字段与真机数据严格对齐——这样 5.4 节混合训练时不需要第二套 dataloader。
- 轨迹字段记全:多视角图像、关节角、夹爪、任务文本(“抓起可乐”)——为任务条件验证(3.9节 S0 风险)留钩子。
- 成功判据写死在采集脚本里:
can_height >= 0.05 and hold_time >= 1.0s,不达标直接丢弃——对应官方"只留成功"闸门(7.2节)。
采集循环伪代码(路线A):
for seed in range(500):
    reset(seed)                        # 可乐撒点、光照/相机轻微扰动
    plan = motion_plan(grasp_pose)     # 或查表关节路点
    for a in plan: env.step(a)         # 30Hz 绝对关节目标
    if success(env): save_episode()    # 成功闸门
    else: discard()
5.4 训练流水线:仿真数据怎么喂进 Cosmos3
数据备齐后,训练配方与真机完全同构(第七节的配置照用),只改三处:
- 数据混合比例:仿真:真机 = 2:1 起步(500 sim + 约 193 real),并保留一组纯真机基线做消融。分工:仿真数据管"位置/姿态覆盖”,真机数据管"接触与视觉真实感"——各扬其长。
- 域随机化先上视觉档(5.7 节):纹理、光照、桌面材质在采集时就随机——否则模型学到的是"那张贴图",混训价值大打折扣。
- checkpoint 选择看两条曲线:仿真闭环 SR(5.5 节回归台)+ 真机开环动作 L1。仿真 SR 涨、真机 L1 不动 → 过拟合仿真物理,回去加动力学随机化;两条都不动 → 模型/配方问题,与数据无关。
参照量级:2606.31101 用 Cosmos Policy 在 40×H100 上训 32 epoch(约 72 小时)消化每任务 800 条。你们的 LoRA 路线单卡/双卡可跑;一版要多少步、怎么验证训到位,见7.4节的步数预算表与收敛四道闸——按闸门早停,不看墙钟时间。
5.5 闭环评测台:固定种子回归测试
没有闭环台,“改一行代码 → 上真机 → 等失败"的循环会让迭代速度卡死。最小可用设计:
| 要素 | 规格 |
|---|---|
| episode 集 | 固定 20 个种子(5 个训练分布内 + 15 个分布外位置),种子写死进 json |
| 成功判据 | 可乐离桌≥5cm、保持≥1s、中途掉落算失败 |
| 指标 | 成功率 + 首次成功步数(越少 = 动作越果断) |
| 通过门 | 任何代码/权重变更:仿真 SR 不低于基线 −5pp 才允许上真机 |
| 频率 | 每个 checkpoint 自动跑一遍;mjlab/MJX 并行后 20 episodes 是秒~分钟级 |
- 这就是把自驾的"封闭测试集回归"搬到操作:真机试错一次几十秒 + 人工复位,仿真回归一次几秒无人值守。
- 与第六节开环 L1 的分工:开环测"学没学会”,闭环测"敢不敢部署"——两个都要,闭环是最终裁判。
5.6 仿真抓可乐失败排查清单(按命中率排序)
脚本专家都抓不起来时,按这个顺序查:
- 夹得死吗:手指闭合后可乐被"挤出"或"滑落"——加指垫摩擦(1.0+)、检查 tendon gear、指尖几何别穿模。
- 够得着吗:撒点位是否在臂工作空间边缘 + 奇异位形附近——先限制在桌面中心约 30×20cm 区域。
- 抬得起吗:可乐质量是否超过夹爪额定夹持力对应值;kp 太软抬升必掉。
- 时序对吗:闭合后要停顿约 0.3s 再抬(真机遥操的习惯动作,脚本里也要有)——立刻抬是新手脚本失败的第一时序原因。
- 判定苛刻吗/宽松吗:是否夹爪碰到可乐就算成功(假阳性),或差 1cm 就判失败(假阴性)——统一为"稳定举 1s"。
- 渲染/观测错位吗:相机外参没对齐真机、图像上下颠倒、RGB/BGR 通道错——策略阶段"看着对但抓不到"一半死在这里。
5.7 域随机化与 sim2real:让仿真数据真的喂得动真机
仿真里 95% 的脚本 SR,直接拿数据训真机策略,大概率重蹈 2606.31101 的 35% 真机天花板。把仿真从"回归台"升级成"半个数据工厂",随机化按两档上:
第一档:视觉域随机化(先上,成本低收益大)
- 纹理:桌面/背景/可乐贴图从程序化 + 照片库采样(WAM 论文三件套之一)。
- 光照:强度、色温、方向随机;偶尔加阴影/反光。
- 相机位姿:平移 ±2cm、旋转 ±5° 扰动——治"标定差 1cm 就抓空"。
第二档:动力学域随机化(治接触迁移)
- 可乐质量 ±30%、摩擦 0.6~1.4、桌面高度 ±2cm、关节 kp ±20%。
- mjlab 的
EventTermCfg(startup / reset / interval 三档时机)可声明式配置;MuJoCo 原生在 reset 时改model.body_mass等字段同样够用。
sim2real 对齐清单(缺一不可)
(1) 相机内外参 + 安装位       ← 第一位,错了全白训
(2) 控制频率/模式/绝对值契约(30Hz 关节位置目标)
(3) 动作归一化统计量:仿真与真机合算还是分开算?→ 合算并写进配置注释
(4) 任务文本条件:抓可乐/拿杯子的文本确实进了 CFG(3.9节 S0 在仿真同样存在)
现实预期(与第四节口径一致)
| 阶段 | 目标 | 参照 |
|---|---|---|
| 现在 | 脚本专家仿真闭环 SR≥90%,策略 SR 可复现 | 本章 5.5 |
| 阶段一 | 仿真混真机训练:真机 SR 超过纯真机基线 | 5.4 节 2:1 消融 |
| 阶段二 | 加强动力学随机化后提高仿真数据占比 | 2606.31101 路线 |
| 不指望 | 零真机数据、纯仿真达到可交付 SR | 35% 天花板,文献共识 |
一句话:仿真先当考场(回归台),再当半个数据工厂(混合训练),永远不当替身(零真机)——这是第四节结论在操作层面的完整落地。
六、开环与闭环:评测体系这么建
你们问"什么叫开环测试闭环测试"——这是自驾同学秒懂的概念,直接对齐定义:
###6.1 开环测试(offline,不执行)
做法:把录好的数据(观测序列)逐步喂给模型,预测动作块,与人类遥操的真值动作比对。不碰机器人。
- 指标:动作L1/MSE(分维度:位置/旋转/夹爪)、按时间步的误差曲线(第1步准不准 vs 第16步漂多少)。
- 判定基准:对齐 Cosmos Policy 官方收敛值——动作L1 ≈ 0.010~0.015(归一化后)。
- 回答的问题:“模型学到没学到”。开环不过关,闭环必失败,别浪费真机时间。
- 加餐:3.4节的前向预测并排检查(预测未来帧 vs 实拍),看系统性幻觉。
- 工程形态:一个脚本,
model.eval_on_dataset(split=val),10分钟出表——这是你们第一周要交付的东西。
###6.2 闭环测试(online,真实执行)
做法:策略实际驱动机械臂,观测→预测→执行→再观测(receding horizon:执行动作块的前K步就重新规划)。
- 仿真闭环:固定任务集 × 固定随机种子 × 每任务50次(Cosmos Policy/LIBERO 惯例:10任务×50次=500次,3个种子取平均)。出成功率曲线随训练步数的变化——这就是回归台。
- 真机闭环:每任务10~30次起(5次以下的数字没有统计意义),成功判据提前写死(如"抓起→举起10cm→保持2秒不掉"),记录:
- 总成功率 + 失败模式分布(下面的分类表)
- 分阶段成功率:到达接近位 / 夹爪对准 / 闭合抓住 / 抬起保持——瓶颈立刻现形
- 失败模式分类表(每次试验打一个标签,这是最重要的数据资产):
F1 感知错位   模型输出显示它"以为"可乐在哪(看动作起始方向/可视化)
F2 规划漂移   接近对了但轨迹中途歪
F3 夹爪时机   位置对了,闭合早了/晚了/没闭合
F4 接触失败   已夹住但提起时滑脱(力控/刚度/夹持力问题)
F5 时序/延迟   动作块执行与观测错拍
F6 指令/语义   走向了别的物体(语义 grounding 错)
100次真机试验的失败分布,比100次"再摇操几条数据"值钱得多。先测再采:如果 F3/F4 占大头,问题在夹爪时机与力控参数,加数据没用;如果 F1 占大头,才是数据/感知的问题。
###6.3 三档体检节奏
| 档位 | 频率 | 内容 | 成本 |
|---|---|---|---|
| 开环L1 | 每次训练后 | val集动作L1 + 前向预测并排图 | 10分钟 |
| 仿真闭环 | 每次改推理代码后 | 固定种子50次×任务 | 半小时 |
| 真机闭环 | 每个候选checkpoint | 10~30次×任务 + 失败标签 | 半天~一天 |
先跑通左边两档,真机试验才值得花。
七、训练配方决策:模型、数据、训练怎么定
###7.1 架构决策树(不要自创,二选一)
选路线A:Cosmos 3 官方 action-policy SFT(cosmos-framework)
  适合:你们已经在Cosmos3上开工、算力有限、要官方背书
  抄:cookbooks/cosmos3/generator/action/finetune 三配方之一
  要点:LeRobot v3.0格式、JSON prompt训推一致、success子集、
        lr 5e-5~2e-4、batch按卡数用grad_accum对齐官方全局batch
  部署:官方 policy server(异步) + RoboLab/真机客户端

选路线B:Cosmos Policy latent frame injection(NVlabs/cosmos-policy)
  适合:想要官方真机先例(ALOHA 93.6%)、想要value头做best-of-N规划
  抄:Cosmos Cookbook 的 Cosmos Policy recipe + HF检查点对照
  要点:batch50/25/25、动作5步视频1步、混合噪声σ∈[4,80]、
        收敛损失对照表(动作L1 0.010-0.015)

消融必做的一组(一次训练回答"视频要不要"):
  A0 纯动作(只训[ s ]→[a])
  A1 动作+视频(策略/世界两种模式batch混合)
  A2 A1 + value头(留着以后做best-of-N)
  比较开环L1 + 仿真闭环成功率 —— 用数据回答领导的"两个都要预测"
- 卡死时的逃生通道(强烈建议先做):把官方权重
nvidia/Cosmos-Policy-ALOHA-Predict2-2B(3.2节那篇论文的成品)接到你们的部署栈上跑一遍。官方权重在你们管线里也出乱码/偏动作 → 病在部署栈,修工程;官方权重正常、你们自己的 checkpoint 不行 → 病在数据或训练,修配方。一次实验把"工程问题"和"模型问题"彻底切开——这比继续盲调自己的 checkpoint 划算得多。
全量微调 vs LoRA:100条数据下的生死选择(“LoRA 是啥"一次讲清):
全量微调(full FT): 解冻基座全部权重一起更新。
  官方Edge教程就是这个——但它有76k条数据+256张GB200兜底。
  数据不够时的两大风险: ①灾难性遗忘(物理先验被100条冲掉,
  视频胡画) ②死记硬背(记住桌子和这瓶可乐,挪5cm就崩)。

LoRA(低秩适配): 冻结基座权重W,只训练插在层里的低秩矩阵B·A
  (rank通常16~64,可训练参数<1%)。"用1%的参数适配新任务,
  保住99%的预训练知识"。大模型时代的标配(LLM/diffusion通用)。
  对你们的含义: LoRA只学"天机臂怎么动",不重写"物理怎么运行"
  ——100条数据下过拟合与遗忘风险都小一个量级,迭代也快。

推荐配置(100条数据的务实组合):
  基座DiT → LoRA(rank 16~64, 只挂attention/FFN的线性层)
  动作头/本体embedding → 全量训练(本来就全新初始化,5×lr)
  VAE/T5 → 完全冻结
  ← 3.7节 so101-cosmos-nano-policy 的路线,单机~48h可复现
###7.2 数据流水线(照官方闸门做)
原始遥操bag ──①成功筛选(官方叫success split)──②时间窗截取(keep_ranges类:
掉帧/复位段剔除)──③转LeRobot v3.0 ──④算归一化统计量(train/val分开!)
──⑤图像增广配置定稿(aug/JPEG/flip,训推一致)──⑥冻结接口四件套:
相机参数|控制频率|动作表示+归一化|JSON prompt格式
                                            ↑
                          任何一项改动 = 模型作废重训,登记版本
- 100条先过①:统计成功片段数。<60条就先补采或重新标注,别急着训。
- 训练/验证切分:留15~20%做 val,开环L1在 val 上算(全训集算会自欺欺人)。
- 参考量级:Cosmos Policy 真机 ALOHA 用 batch 200 / 50K步 / lr 1e-4 / chunk 50,你们数据量相近可以直接平移起点;用 Cosmos3 官方配方则按 LIBERO 口径(lr 5e-5、warmup 500、batch 2048 等效、2000~5000迭代)缩放。
###7.3 训练期关键开关
| 开关 | 推荐起点 | 依据 |
|---|---|---|
| 动作块长度 chunk | 16~32(LIBERO16 / DROID·RoboCasa32;cosmos3框架画布长度=chunk+1,chunk64=生成65帧未来视频,是官方最大值的2倍——慢/视频崩/开环漂的第一嫌疑人,见8.1节) | 太长=开环漂移+画布爆炸,太短=重规划频繁 |
| 控制频率 | 与遥操一致(20fps是官方常用值;Edge教程用15Hz) | 训推一致铁律 |
| 未来视频loss权重 | 视觉 flow-matching loss 加权去对齐动作 loss 的量级(3.8节官方Edge做法),而不是拍固定系数;阶段一可再单独消融 | 症状二的直接对策;官方口径 |
| 动作头初始化 | 全新初始化(encoder+MLP+tokens)+ 5×学习率(3.8节官方做法) | 基座没有现成动作接口;全网统一lr会欠训动作头 |
| 归一化 | 关节空间动作 → 不归一化(官方DROID口径);末端位姿才需要 | 砍掉一整类训推不一致风险 |
| 图像增广 | 开(随机裁剪/缩放/色彩抖动 + JPEG压缩) | Cosmos Policy/Edge教程都这么防过拟合 |
| EMA | 开 | 扩散训练标配 |
| 训练步数判定 | 见7.4节:步数预算表 + 收敛四道闸;每1K存checkpoint挑早停点 | 3.2节数值 + Edge教程习惯 |
###7.4 训练预算与收敛判定:一版要多少步、训没训到位怎么验证
你们问"仿真训练一版需要多少步数?真机的步数呢?"——步数与"仿真还是真机"无关,只跟数据量和有效batch有关。先把公式立住,再给验证方法和两套可直接抄的方案。
7.4.1 步数公式与锚点表
优化步数 = 样本访问量 ÷ 有效batch
样本访问量 = 优化步数 × 有效batch   ← 真正的训练预算,与仿真/真机无关
有效batch = 单卡batch × 卡数 × 梯度累积次数(小卡靠累积拼出大batch)
| 训练一版 | 数据量 | 官方/先例步数 | 样本访问量 |
|---|---|---|---|
| 真机 ALOHA(Cosmos Policy 原版,3.2节) | 185条 | batch 200 × 5万步,8×H100 48h | 1000万(“训到位"锚点) |
| 你们真机阶段二(3.9节配置) | 193条 | batch 16 × 12 epoch ≈ 1.4万步 | ≈23万 = ALOHA的2% ← 欠训练头号嫌疑 |
| 官方 Cosmos3 DROID SFT(3.8节) | 7.6万条 | batch 8192 × 1万迭代 | 8190万(大规模SFT量级,不是你们的) |
| 仿真(第五节500条路线) | 500条 | 有效batch 64 梯度累积 ≈ 15万步 | 1000万 |
| 仿真快速基线 ACT(SO-101 先例) | 105条 | 5万步,loss 4.4→0.09 | — |
三个容易踩的坑:
- epoch 数会吓人:小数据下按样本访问折算,500条仿真数据要显示约 200 epoch、你们193条到1000万样本约500 epoch——这不是过拟合信号,epoch只是换算单位,裁判是下面的四道闸。
- 你们阶段二1.4万步@batch16是预算问题:要到锚点需约 10倍预算;12 epoch 的"适配预算”(S1嫌疑)本质就是样本访问只给了2%。
- 别混淆两种"步数”:
优化步(gradient step) = 一次参数更新。预算单位: 样本访问量 = 步数 × 有效batch。
env步(sim步)          = 仿真环境走一步。采数500条×300步=15万env步(分钟级);
                        回归台20种子×300步≈6千env步(秒级), 天天跑无压力。
7.4.2 “训到位"四道闸:每道都有数字
| 闸门 | 怎么测 | 达标线 | 不过的含义 |
|---|---|---|---|
| G1 开环动作L1(val集) | 6.1节脚本,每1K步跑 | 0.010~0.015(3.2节官方收敛表);>0.05 = 明显欠训 | 欠训或训推不一致 → 加预算/查接口 |
| G2 val曲线平台 | 记录val L1随步数曲线 | 连续 3~5K步不再下降(波动<5%) | 还在降 = 预算没给够,继续跑 |
| G3 官方loss分项参照 | 训练日志 | 动作L1 0.010 | 哪个分项不达标 = 哪条分支欠训,对照loss权重调 |
| G4 闭环回归台SR | 5.5节固定种子 | 脚本专家≥95%的场景,策略SR≥90%且加步数不再涨 | L1达标但SR低 = 部署链路/数据多样性问题,不是步数问题(转8.5节排查树) |
三种"看着不对"的判别表(别把三种病混成一种药):
| 现象 | 判定 | 动作 |
|---|---|---|
| train L1降、val L1也降,但 L1 > 0.015 | 欠训 | 按7.4.1拉到1000万样本锚点 |
| train L1降、val L1平/升 | 过拟合 | 立即停,按val挑checkpoint;加增广、LoRA rank调小 |
| L1 全达标、闭环 SR 低 | 部署/接口/多样性 | 8.5节排查树 + 2.1节位置压力测试;加步数无效 |
判定顺序永远是 G1→G2→G3→G4:每道闸只回答一个问题,过了才看下一道;G4不过时回头查的是工程与数据,禁止用"再训几万步"当万能药。
7.4.3 两套具体训练方案(直接抄)
方案一:真机193条(你们现在要跑的一版)
配置:  基座LoRA(rank 32) + 动作头/本体embedding全量 + VAE/T5冻结
lr:    基座 1e-5 / 动作头 5e-5 (官方5×分组), warmup 200~500
batch: 你们4×A800 单卡16×4卡=全局16 -> 梯度累积×4 补到有效batch 64
预算:  ~15万优化步 = 1000万样本访问 (≈ 现在阶段二的10倍;
       12 epoch远远不够, 按样本访问对齐而不是按epoch数)
chunk: 32 与 64 各跑一组对照 (时域等值, 见S3嫌疑)
存档:  每1K步存checkpoint, 保留最近20个 + G1里程碑点
早停:  G1达标 且 G2平台 触发即停, 按val L1挑最优, 不必跑满15万
时长:  so101 先例单机~48h量级 —— 这是"天级"预算, 不是小时级
必做:  纯真机基线一组; 后续 +500条仿真(2:1) 是另一版实验, 别混在本版
方案二:仿真500条(第五节路线的训练侧)
配方:  与方案一同构(同一个config, 只换数据路径) —— 这就是"格式同构"的红利
冒烟:  先用ACT等轻量策略跑5万步, 仿真SR能爬 -> 环境与数据没问题,
       再上Cosmos3重训 (把"环境bug"和"大模型训练"解耦)
预算:  同1000万样本锚点; 500条下epoch显示~200属正常换算
增广:  采集时就带视觉域随机化(5.7节), 否则这1000万样本在背贴图
验收:  先过G4回归台, 再谈与真机2:1混训
执行顺序(一周内):① 先对现有checkpoint测 G1(零成本,定"欠训"还是"部署歪”)→ ② 欠训则按方案一重训(预算天级,每1K有checkpoint)→ ③ 每1K步过G1/G2,触发早停 → ④ 拿最优checkpoint过G4回归台 → ⑤ G4过了才开 chunk32对照/仿真混训这类增量实验。没过G1之前做的任何消融(A0/A1/A2、chunk、loss权重)都是在欠训模型上比噪声。
八、推理与部署:产出未来视频与低延迟如何兼得
领导的要求——推理时必须产出未来视频——正面回答如下。结论先说:这不是要跟低延迟对立的需求,而是官方设计里的既定能力;真正要管理的是"怎么出、给谁看、多久出一次"。
8.1 策略模式联合输出:源码级拆解(你们跑的就是这个)
领导要的"并行输出未来动作+未来视频",官方实现叫联合模式(generate_future_state_and_value_in_parallel=True,规划开关全关:ar_future_prediction=False)。下面按 NVlabs/cosmos-policy 源码(cosmos_utils.py / deploy.py)一步一步讲清楚它到底怎么运转——你们做不好,大概率就是这四步里某一步和官方不一致。
第1步:把所有模态拼进一个"latent 画布"。模型的输入输出不是"图像"也不是"向量",而是一个 T′=9 的latent帧序列(LIBERO 口径,源码注释原样):
画布槽位: [0空帧][1当前本体s][2当前腕相机][3当前第三人称]
          [4动作块a][5未来本体s'][6未来腕相机][7未来第三人称][8价值V]
           ──条件段(喂干净帧)──  ───────目标段(加噪,模型要生成的)───────
RoboCasa/ALOHA多一路相机,画布变成11槽,结构相同。
动作a不是"另外接的头",它就是画布里的一个槽位——
展平后reshape成(chunk_size×动作维度),源码里是均值化提取。
⚠ 两代画布的关键差别(chunk 长度的第一放大器,查配置必看):上面的9~11固定槽是 Cosmos Policy(latent injection) 的设计——未来只有一个帧位。而 cosmos3 框架(你们的路线A) 的画布是真实视频帧序列,源码 build_action_batch:target_frames = action_chunk_size + 1——画布像素帧数随 chunk 线性增长。再经 Wan VAE 时间压缩×4 后进入注意力的是 latent 时间点 ≈ chunk/4 + 1:
chunk 16 (LIBERO官方)  → 17像素帧 →  5个latent时间点
chunk 32 (DROID官方)   → 33像素帧 →  9个latent时间点   ← 官方上限
chunk 64 (本项目案例)  → 65像素帧 → 17个latent时间点   ← 约2×DROID的算力与视频任务难度
chunk 的正确评价维度有两个:①开环时域 = chunk/控制频率——64@30Hz=2.13秒,恰好与官方32@15Hz相同,这一维不是问题;②latent时间点数——17 vs 官方9,视频外推难度与序列注意力开销约翻倍,这一维才是问题(视频崩/先验劫持的放大器)。官方配方从未验证过>32——建议把 chunk 降到32、控制频率相应调整作为对照实验,一次重训就能看到视频质量与推理延迟的变化。
第2步:一次去噪,三样全出。model.generate_samples_from_batch(..., num_steps=动作去噪步数)——一个采样调用对整个画布去噪:条件段保持干净作为锚,目标段从纯噪声出发被去出来。动作、未来本体、未来图像、价值是同一次采样的不同槽位,不是三次采样排队跑。这就是"并行"的准确含义(ALOHA 真机部署配置:num_denoising_steps_action=10,一次出全部)。
第3步:从同一个输出张量里分槽切结果(源码逻辑):
动作:   取槽位4的latent → 展平 → reshape(chunk×dim) → 多份取均值
        → unnormalize_actions(用dataset_stats反归一化) → 立即可以下发执行
未来视频: 取槽位6/7的latent →【关键】先把槽位0/1/4/5替换回原始干净latent
        (INDICES_TO_REPLACE,否则VAE解码出乱码) → VAE解码 → 像素帧
价值:   取槽位8的latent → (v+1)/2 → clip到[0,1] → 标量分
第4步(可选,规划才用):AR 接力模式。把 ar_future_prediction/ar_value_prediction 打开后不再是"一次全出",而是三段接力:先出动作(10步)→ 以生成的动作为条件再出未来(num_denoising_steps_future_state,可设1步)→ 以未来为条件出价值(1步);配 best-of-N=8、3份未来集成、5份价值集成、以及单独微调的 planning checkpoint(官方用648条混合策略rollout专门训 V(s’))。这是"视频步数与动作步数解耦"的唯一官方途径,也是视频真正参与决策(+12.5pp)的形态。
三个耦合矛盾——联合模式天生的病根(理解了这三个,你们的症状就都不奇怪了):
- 步数耦合:联合模式只有一个去噪步数旋钮。想视频1步省算力?动作也变1步,抓取精度崩。想动作10步保精度?视频跟着10步,慢。“又快又准"在联合模式内部无解——要么接受"视频搭动作的便车多花几个attention的零头”,要么切AR模式让视频走自己的1步调度,要么蒸馏。
- 算力耦合:画布按视频规格设计(480p、多相机、16通道latent),动作只占9槽里的1槽。一次采样的绝大部分FLOPs花在图像latent上——如果你们的领导其实只需要动作准+偶尔看一眼预览,联合模式是在为视频付全价。
- 质量耦合:未来图像槽训练不充分时,先验劫持发生在同一个DiT的注意力里(红可乐变蓝、没抓到画成抓到)。它至少污染预览质量;是否拖累动作段,取决于你们的loss配比——这必须用消融回答,不能靠猜(见8.5节A0/A1)。
结论没有变但更准确了:官方推理本来就产出未来视频(联合模式从同一次采样里顺带出,规划模式专门出),你们要回答领导的不是"能不能出",而是"以什么代价出、质量怎么量化"。
8.2 视频的四种生产模式(按用途选,可同时开)
| 模式 | 条件 | 去噪步数 | 产出时机 | 用途 |
|---|---|---|---|---|
| M1 并行预览(联合模式顺带出,或 AR 接力1步出) | 当前真实帧 + 正在执行的动作块 | 搭动作采样的便车(联合)或 1步(AR) | 每次重规划同采样顺带产出 | 给人看的"接下来1.5秒会发生什么"——demo、远程监督、领导汇报的主产出物 |
| M2 前向确认(FD 模式) | 当前真实帧 + 已选定的动作块 | 1~5步 | 关键节点才跑(抓取前、放置前) | “这个动作会导致什么"的执行前确认;以动作为条件,锚定在真实观测上,最不容易跑偏 |
| M3 规划采样(best-of-N) | 候选动作块 × K 个 | 1步 × K | 关键决策点,K 路可并行 | value 头给每个候选的未来打分选优(官方实测 +12.5pp)——视频真正"参与决策"的形态 |
| M4 离线高清(cinema 模式) | 全链路 | 20~30步 | 不进控制环,秒级 | demo 视频、数据引擎造样本、失败复盘质检——要"画得好看"就在这里花钱 |
对应到你们的三个症状:慢 = 把 M4 的步数和串行方式用在了 M1 的位置;幻觉 = 用了"自由想象”(无动作条件、不回锚真实帧)却当成 M2 的确认信号来解读。M1~M3 都是"以当前真实帧为锚、以动作为条件"的受控生成——每个重规划周期都用真实观测重新锚定,红可乐就没机会漂成蓝的。
8.3 又快又不胡说的七个工程要点
快(针对症状二):
- 不对称去噪:动作5步、视频1步(官方值);cosmos-lite 实测 2步 UniPC 在 RoboLab 上成功率不掉——推理步数的"安全下限"比你想象的低。
- 量化:cosmos-lite 的 GenW8A8 把 Edge 4B 压到 331ms、Nano 16B 压到 959ms(4090,p50,含策略请求全流程)——工程侧一天能落地,比蒸馏近得多。
- 异步解耦:M1/M2 视频走异步回传,控制环只等动作块;M4 永远离线跑。
- 分级出视频:M1 每周期都出(1步、免费),M2 只在抓/放关键帧出,M3 只在决策点出——出视频的频率跟着风险走,不跟着"领导要看"走。
准(针对症状三,反幻觉五条):
- 真实帧回锚:每个生成周期以最新真实观测为条件帧,禁止让连续生成的帧当长链条条件(漂移主因;3.7节 cosmos3-so101 的自回归链每 chunk 只回锚一次,且有 teacher-forced 对照模式可量化漂移)。
- 以动作为条件:优先用 M2 的
p(s'|s,a),不用无动作条件的自由想象——“如果执行这个动作会发生什么"有确定的因果锚,先验没有可乘之机。官方 FD 配置甚至 guidance 1.0(无 CFG)——CFG 正是把语义类别(红→蓝)推过头的元凶,预览类生成可以关掉。 - 给视频质量一个数字:抄 cosmos3-so101-armnet-eval 的 SAM3 掩码 IoU + 质心距离——在你们自己的数据上给预测视频打分,“这版视频比上版好还是坏"从嘴仗变成报表;再配3.4节的前向预测并排图做人工抽检。
8.4 延迟预算表(从官方数字反推的可行配置)
先立一个官方口径的延迟哲学(3.8节 Edge 教程,矫正"必须百毫秒"的误区):Edge 在 Jetson Thor 上单块推理约 1.53秒,而动作块覆盖约 2.13秒运动——推理时延只要小于动作块覆盖时长,执行前缀+重规划就能连续运动(官方循环:执行32步中的前16步@15Hz,期间下一块算完;重规划用真实关节位续起)。所以重新定义你们的"慢”:真正要消灭的不是绝对延迟,而是①阻塞动作下发的串行环节(角度1)、②关键节点(接触瞬间)等不起的重规划空窗。按这个标准重测,“慢"的问题通常缩小一半。
| 组件 | 参考值 | 手段 |
|---|---|---|
| 动作去噪 | 5步(Cosmos Policy官方) | 不要默认20~50步 |
| 视频去噪 | 1步(M1并行)/ 2步(cosmos-lite实测) | 与动作同前向并行;M4才用高步数 |
| CFG | 只开时间步区间(官方 [960,1001]);FD预览可 guidance 1.0 | 省一半引导开销 + 消语义幻觉 |
| VAE解码 | M1/M2 按需解码(要给人看才解) | latent 阶段不影响动作路径 |
| 服务形态 | 异步流式(官方policy server / /v1/videos;Edge服务端开 video decoding 即随动作返回想象rollout) | 动作块先回传,视频帧异步补 |
| 量化 | GenW8A8:Edge 582→331ms,Nano 2403→959ms | cosmos-lite 现成产物 |
| 上限手段 | 蒸馏单步(F3A路线)、Edge版基座 | 阶段二再上 |
重规划节奏:执行动作块的前 K 步就重新观测规划(K=chunk的1/2~1/4是常用起点)。chunk 越长越"开环”,越短越"闭环”——症状一里的第5号病因就在这里调。
升级路线(阶段二):M3 best-of-N——一次生成 N 个候选动作块及其未来,value 头打分选优(官方实测+12.5pp)。这是"视频/未来预测真正参与决策"的形态,比让像素视频直接参与执行靠谱一个量级;M1/M2/M4 三种视频则从头到尾服务"看得见、可质检"的需求。
8.5 联合输出做不好怎么办:七个角度的排查树
症状=「联合模式出动作+出视频,但要么慢、要么视频胡说、要么动作不准」。按下面七个角度逐个过,每个角度都给了"怎么查"和"怎么修"。建议打印出来当排查表用。
角度1:时序结构——你们的推理脚本是不是把三样东西串行挡在了一起(最常见的工程病)
- 查:在推理函数里打三段计时——
采样去噪 / VAE解码视频 / 反归一化+传输。官方联合模式的动作返回路径里没有VAE解码(动作从latent直接reshape);如果你的代码是"采样→解码视频→再返回动作",视频解码(多相机、几十帧、可能秒级)就全进了控制环的关键路径。 - 修:采样结束立刻返回动作下发执行,VAE解码扔到后台线程/异步接口(官方 policy server 的
/v1/videos就是异步语义)。预览帧晚200ms到屏幕没有任何关系,动作晚200ms到机械臂就有关系。 - 加分项:双卡
--cfg-parallel把 CFG 的条件/无条件两次前向拆到两张卡;量化上 cosmos-lite 的 GenW8A8(Edge 582→331ms)。
角度2:步数配置——三个旋钮是不是被当成了一个(最容易被忽略的配置病)
- 查:打印
num_denoising_steps_action / num_denoising_steps_future_state / num_denoising_steps_value。联合模式下这三个旋钮实际只有第一个生效(三段共享一次采样);很多人的"视频很慢"其实是动作步数被设成了视频默认的20~50步。 - 修:动作步数对齐官方(5~10);视频想要独立的1步调度→切AR接力模式(
ar_future_prediction=True);都不行→阶段二蒸馏。 - 画一张你们自己的"步数-质量-延迟"三点曲线:动作步数∈{2,5,10,20} × 开环L1 + 视频IoU + 单请求p50——甜点在哪一目了然,和领导讨论用这张图。
角度3:画布与解码正确性——手写pipeline的经典雷区
- 查:VAE解码前有没有做 INDICES_TO_REPLACE(把空帧/本体/动作槽替换回原始干净latent)?多相机在画布里的排布顺序、分辨率、letterbox几何(3.7节 so101 项目的教训:推理路径会resize但不会letterbox,喂错几何整个模型都在看错误的画面)与训练是否逐位一致?
- 修:这属于《接口契约》的画布章节;从官方 repo 抄解码函数,不要自己重写。
角度4:训练侧——联合模式的loss账本
- 查:三条loss曲线是否分别记录(动作L1 / 未来latent / 价值)?对照官方收敛值:动作L1 0.010
0.015、未来图像latent 0.050.09、价值~0.007。哪条没收敛,病就在哪条。 - 修:batch配比对齐官方50/25/25(只训策略模式→未来/价值槽欠训练→先验劫持);loss权重失衡时动作被视频带偏或视频全是先验——官方的加权系数与出处见3.8节"出处专栏"(loss_scale 10 / action_loss_weight 10),你们的具体档位用3.9节的 r 判定法 + 8.6节的A0/A1/A2消融定。
- 一个残酷的事实:价值头不是SFT顺带出来的。官方规划用的 V(s’) 是拿648条多策略混合rollout单独finetune的。你们若打算做best-of-N,价值数据要单独准备。
角度5:训推一致性flags——deploy.py整整一页纸不是白写的
- 查:把官方部署开关逐个对照你们的训练配置:
trained_with_image_aug / use_jpeg_compression / flip_images / normalize_proprio / unnormalize_actions / dataset_stats_path / chunk_size / 视角顺序 / T5文本embedding(官方用预计算缓存) / format_prompt_as_json / guidance-interval / seed与deterministic。任何一个错位的表现都是"动作偏一点+视频怪怪的",且症状随机、极难肉眼定位。 - 修:启动时把完整推理配置打印进日志,和训练config做机器diff,不一致直接拒绝启动。这是3.7节 so101 项目"所有flag集中在一个被测试过的地方"的同样教训。
角度6:评测拆三段——联合输出必须拆开测,否则永远无法归因
| 段 | 指标 | 怎么跑 |
|---|---|---|
| 动作段 | 开环动作L1(目标0.010~0.015) | val集回放,10分钟 |
| 视频段 | SAM3掩码IoU + 前向预测并排图 | 抄3.7节 so101-armnet-eval |
| 价值段 | 排序一致性:采8个候选,value排序 vs 真实成功率排序的相关性 | 每个checkpoint在仿真里跑N次 |
- 消融矩阵(回答"联合到底伤不伤动作"):A0 纯动作(只训[ s ]→[a])/ A1 联合(现有配置)/ A2 联合+价值。比较动作L1与仿真闭环SR:A1≈A0→视频没拖累动作,放心优化视频;A1<A0→联合训练在伤动作,先降未来帧loss权重或减少世界模式batch占比。
角度7:阶段策略——别让一个模型同时背三个KPI
- 阶段1(现在~第2周):联合模式只承诺两件事——动作达标 + 异步预览视频(M1)。领导看的视频用它,动作质量用开环L1说话。视频幻觉照8.3节五条治理(回锚、降CFG、IoU量化),但不阻塞抓取成功率的爬坡。
- 阶段2(第3
4周+):要"视频参与决策"再上AR接力 + planning checkpoint + best-of-N;要"好看的汇报视频"用M4离线2030步渲染。决策视频和展示视频从此分家,两个KPI互不拖累。
如果只做三件事:①打三段计时,VAE解码挪出关键路径(角度1);②打印推理配置与训练config做机器diff(角度5);③跑A0/A1消融+三段分测(角度6)。这三件做完,“到底哪里出了问题"就会从一个哲学问题变成一张具体的表。
8.6 优先级裁决:先动作,后价值,视频陪跑
你们问"是不是预测未来动作更简单可行、应该先做好?"——是的,这个直觉是对的,而且有论文级证据背书。裁决如下:
为什么动作先行是对的:
- 任务指标只认动作。抓可乐成不成功由动作块决定;视频画得再准,动作偏5厘米就是失败。开环动作L1(10分钟可测)和闭环SR是唯二的硬指标,视频IoU是健康度指标。
- NVIDIA 自己的路线图就是这个顺序。Cosmos Policy 论文的四层骨架(3.2节):先把策略模式做到93.6%(阶段一,纯动作达标),再用648条额外rollout训价值头做规划+12.5pp(阶段二)。价值头和规划是论文的第4层,不是第1层——连原作者都是动作先赢、决策后补。
- 动作的失败可归因,视频的失败不可归因。动作L1高→数据/归一化/训练问题,路径清晰;视频模糊/幻觉的成因是一坨(先验、CFG、欠训练、回锚),优化它投入产出比低且不解除"抓不到"的警报。
- 联合模式下动作和视频共享采样——先把动作调准的过程中,视频会自动跟着变好(同一个DiT、同一批数据、loss都在降)。不存在"先做好视频才能做动作"的依赖关系,只存在反向的健康度信号。
三件事的优先级排序(建议贴墙):
| 优先级 | 事项 | 验收标准 | 投入 |
|---|---|---|---|
| P0 | 动作:数据过闸门→配方复现→开环L1收敛→闭环SR爬坡 | L1 0.010 | 全员主力,第1~4周 |
| P1 | 视频陪跑:联合训练不砍(loss都算)、异步预览(M1)、IoU健康度监控、反幻觉五条治理 | IoU报表不崩、不阻塞动作KPI、领导随时能看预览 | 1人兼职,随P0走 |
| P2 | 价值/规划:AR接力+V(s’)+best-of-N | value排序与仿真成功率相关性达标后再上真机 | P0闭环SR平台期后启动 |
一个反直觉提醒:不要把"先把视频做好"设为里程碑。视频质量是伴随指标(P1),把它设成里程碑会导致团队在不可归因的像素问题上空转——这正是你们过去一个月的症状之一。反过来,当 P0 的闭环SR爬到平台期(比如仿真70%、真机50%卡住),P2 的价值头就是打破平台的正确武器(官方+12.5pp就是在最难的设置下测的),那时视频+价值才从陪跑转为主攻。
给领导的一句话版本:“我们按 NVIDIA 论文自己的路线走:第一阶段动作达标(视频以异步预览形式照常产出、用 IoU 打分监控质量),第二阶段上价值头做 best-of-N 规划提升成功率——视频从头到尾都在产出,只是它的 KPI(IoU)和动作的 KPI(成功率)分开考核、分阶段投资。”
九、从抓可乐到会议室整理:长程任务怎么搭
直接上"会议室整理"是当前阶段的错题。正确拆法(RoboDojo 这类基准的 Long-Horizon 维度全员低分已经说明:长程是全行业未解题,别把自己往枪口上撞):
第1层  任务规划(VLM/规则,非本文模型)
       整理会议室 → [收可乐, 收纸杯, 擦桌, ...] 任务列表与顺序
第2层  技能库(每项是一个独立微调的策略,本文的Cosmos3 WAM)
       抓可乐   ← 你们现在在这里,先打到>80%成功率
       放入筐   ← 第二个微调任务(复用同一模型,加数据)
       避障移动 ← 移动底盘/另一套技能
第3层  原子能力(稳定复用)
       接近|对准|夹取|抬起|放置 每段可诊断可重试
执行框架: 每个技能 = 开环达标 → 闭环N次达标 → 进技能库;
         调度器只在技能之间做序列与错误恢复(失败重试/换策略)
- 共性底座:所有技能共用同一个 Cosmos3 微调模型(多任务混训),不要每技能一个模型——数据格式统一后这是顺手的事。
- 验收节奏:单技能仿真+真机达标才进下一层;每层的失败都能归因到具体技能。
- 这个路线的现实收益:两周内交付"稳定抓可乐 demo”,一个月内"抓+放"两技能串联——比直接憋"会议室整理大招"对团队士气和领导预期都健康。
十、项目管理:四周重建计划
你们一个月没进展的技术根因我认为就三条:没有评测(无法归因)、接口不冻结(每次实验变量不唯一)、决策靠零散提问(没有成文的实验设计)。对应重建:
第0件事(第1周,最优先)——三件基建交付:
- 开环评测脚本(10分钟出动作L1表+前向预测并排图);
- 仿真回归台(MuJoCo/RoboLab 选一个,固定种子50次成功率;MuJoCo 侧从环境到回归台的搭建流程见第五节);
- 一页纸《接口契约》:相机、频率、动作表示、归一化、prompt格式、成功判据——全员签字级冻结。
第1~2周:跑通路线A或B的官方配方(先原样复现,再改自己的数据)。官方配方在自己的数据上复现不出近似行为 → 问题在数据管道,不在模型。同时出8.5/8.6节 A0/A1/A2 消融的第一版结论——前提是G1已达标(7.4节):欠训模型上比消融是在比噪声。
第3~4周:诊断-修复循环。按2.1病因表逐项排除,真机试验带失败标签;数据补采只在"F1感知类失败占主导"时进行(对照第二节的变化维度清单)。
流程纪律(回应"团队过度依赖AI零散提问"):
- 每个实验先写三行:假设 / 改动 / 判据(开环L1还是闭环SR,预期方向)。三行写不出实验就不做。
- 本文当 checklist 用:提问前先查第几节;仍要问外部(AI/供应商)时,把三行+数据管道+日志一起给,禁止"该怎么办"式裸问。
- 每周一张状态表:开环L1趋势 / 仿真SR趋势 / 真机SR+失败分布 / 阻塞项 owner。领导看这张表,不看形容词。
十一、自驾 → 具身:你的经验迁移地图
你做 MOT 世界模型、Flow-GRPO 的背景,迁移到这个项目非常对口,但有五件事要想清楚:
| 自驾里的你 | 这个项目里的对应 | 迁移判断 |
|---|---|---|
| 世界模型当教师模型(SimWAM 用 Flow-GRPO + NAVSIM) | 视频分支当训练期物理监督 | 直接迁移——你们"视频只在训练期参与"的消融,本质就是你做过的事 |
| 轨迹蒸馏(少步/单步出轨迹) | 动作5步/单步蒸馏(F3A、AHA-Flash) | 直接迁移,你有 Flow Matching 蒸馏经验,这就是第八节的上限手段 |
| 开环L2/闭环碰撞率的口径意识 | 开环L1/闭环SR、成功判据冻结 | 直接迁移——你们现在最缺的"评测文化"你在自驾已经有了 |
| 数据合成与增广(CARLA/游戏引擎) | 仿真回归台 + 合成演示 | 思路同构,但注意操作任务的接触物理比自驾感知更难sim2real |
| 批量离线回放评测 | 开环回放脚本 | 一天就能写完,别拖 |
不能直接搬的三个直觉:①自驾的"世界模型可以端到端出规划"不等于"WAM推理必须出视频"——效率结论相反(见2.2);②自驾感知的评测金标准(mAP/PDMS)在操作里没有对应物,只有任务成功率是硬通货;③自驾数据是海量天然流,具身数据是稀缺人工滴灌——在自驾养成的"先堆数据"直觉要改成"先筛质量与多样性"(第二节)。
你在这个项目里的比较优势:训练配方的严谨性、指标口径意识、蒸馏与 RL 后训练。建议主动认领:开环/闭环评测脚本、A0/A1/A2 消融设计、延迟压测——这三件恰好是当前最缺的。
十二、自测8问
- 为什么"视频画错"和"动作抓空"不能互相定罪?——Cosmos Policy 策略模式下动作从当前观测直接条件生成([s]→[a,…]),不读预测视频;视频是1步去噪的兄弟输出,按先验采样。判断成功要用 value 头或真机判据,不能看视频。
- 100条可乐数据,第一件要统计的事是什么?——成功片段有多少条(官方只训 success split)。<60条先补采/重标,别训练。
- 仿真在你们项目里的第一用途是什么?——回归测试台(第五节5.5的固定种子回归台),不是零真机替代;方法稳定后再按5.3/5.7升级成半个数据工厂(仿真:真机≈2:1混训)。你们现在"仿真抓可乐都完成不了",先按5.1的 L1资产→L2控制→L3接口→L4策略 顺序定位,九成问题在 L1/L2。
- 开环动作L1多少算训到位?——对齐 Cosmos Policy 收敛值0.010~0.015(归一化后);同时看 val 集与前向预测并排图。完整验证链是7.4节的四道闸(G1 L1 → G2 val平台 → G3 官方loss分项 → G4 回归台SR),步数预算一版≈15万优化步@有效batch64(≈1000万样本访问)。
- 领导坚持"推理时必须产出未来视频"怎么落地?——顺着要求给四模式(8.1
8.2节):M1 并行预览(联合模式同采样顺带出,或AR接力1步出,给人看)/ M2 前向确认(FD 模式30步,不进控制环)。配8.3节反幻觉五条(真实帧回锚、动作为条件、关 CFG、SAM3 IoU 打分)——视频要出、要准、要可量化,三者都给得出。p(s'|s,a),关键节点出,最准)/ M3 best-of-N 规划(value 选优 +12.5pp)/ M4 离线高清(20 - 联合模式(一次出动作+视频)做不好,第一刀切哪里?——三件事(8.5节排查树):①推理函数里打三段计时(采样/VAE解码/传输),VAE解码挪出动作返回路径;②把全部训推 flags 打印进日志与训练 config 机器 diff;③跑 A0/A1 消融(纯动作 vs 联合)+ 动作L1/视频IoU/价值排序三段分测。“到底哪里坏了"三天内变成一张具体的表。
- 先把未来视频做好,还是先把未来动作做好?——动作(8.6节裁决)。任务指标只认动作;视频与动作在联合模式下共享采样、随动作一起变好;NVIDIA 论文自己的顺序也是先策略模式(93.6%)再价值规划(+12.5pp)。视频的合规身份:联合训练保留 + 异步预览 + IoU健康度监控(P1),不设"视频做好"里程碑。价值头(P2)等动作闭环SR到平台期再上——那是打破平台的武器。
- 我们 chunk=64、100条数据、全量微调——哪条最可疑?——全量微调+欠训练最可疑,chunk 居中(3.9节实战拆解):①先测开环动作L1(判"没学会"还是"部署歪”);②100条上全量微调生成分支 → 换 LoRA基座+全量动作头(7.1节),或极小 backbone lr;③chunk64 开环时域其实合理(2.13s@30Hz=官方32@15Hz),但 latent 时间点17 vs 9(约2×视频难度),作为对照实验降到32;④100条单场景 → 数据闸门+多样性(第二节)。“LoRA”=冻结基座只训低秩小矩阵(<1%参数),保先验防遗忘——100条数据量级下比全量微调安全一个量级。
十三、资源与延伸阅读
GitHub 现成项目(3.7节详评,直接抄工程):
- 完整后训练管线:kabilankb/so101-cosmos-nano-policy(train→merge→export→serve→evaluate 单 CLI,双环境架构,LoRA 配方)
- 前向视频 rollout + 视频质量评测:codemasterzhao/cosmos3-so101-armnet-eval(SAM3 IoU 打分,HF
ishika/armnet-so101-edge-generator-fd-15k) - 推理加速 runtime:xxxxyu/cosmos-lite(GenW8A8 量化:Edge 582→331ms、Nano 2403→959ms @4090,2步 UniPC + RoboLab 复现)
- 论文弹药清单:zhiheng-ma/awesome-video-action-models;数据增广:cosmos-aug、EmbodiedDataTransfer、SO-101-Video-Augmentation
一手配方(按优先级):
官方端到端教程:Post-Train Cosmos 3 Edge for On-Device Robot Control(3.8节精读:训练规模现实、损失对齐、延迟哲学、OpenPI 服务端、Jetson 部署)
Cosmos 3 技术报告 arXiv 2606.02800(3.8节出处专栏的论文级来源:§4.2.2 模态损失系数 + action×10、§4.2.5 策略后训练继承mid-training超参)+源码三连:loss权重默认值与调参注释 | 总损失拼装处 | DROID配方 loss_scale=10 注释
Cosmos Policy Cookbook(latent frame injection 完整配方) | 论文 arXiv 2601.16163 | 代码 NVlabs/cosmos-policy
NVIDIA/cosmos 的 Cosmos3 action SFT cookbooks(DROID/LIBERO/RoboCasa 三配方 + policy server + RoboLab 客户端)
部署:
run_policy_with_cosmos_framework.md(异步 policy server、guidance-interval、JSON prompt 约定);HF 检查点nvidia/Cosmos3-Nano-Policy-DROID、nvidia/Cosmos3-Edge-Policy-DROID数据格式:LeRobot v3.0;数据缩放律 arXiv 2410.18647
仿真合成零样本迁移:arXiv 2606.31101 | 视频幻觉病例与蒸馏:arXiv 2602.10717
仿真平台:RoboLab | LIBERO | Robosuite | Isaac Lab | mjlab | 天机官方 SDK(tianjizn.com 下载中心)
仿真流水线零件(第五节的工具箱):MuJoCo Menagerie(现成夹爪/机械臂 MJCF)| robosuite 人工演示采集文档(DataCollectionWrapper→HDF5)| mjlab 域随机化文档(EventTermCfg 声明式配置)| SO-101 仿真抓放数据集先例(105条演示→ACT→仿真SR 66.7%)
合成数据路线:GigaWorld-0(本地逐图精读)
站内延伸:
- WAM世界行动模型全景分析(架构流派、效率军备、榜单——本文的上游地图)
- Cosmos 3 世界基础模型精读(基座本身怎么读)
- 具身智能入门指南(自驾转具身的8周路径)
- SimWAM代码完整解读(世界模型当教师的Flow-GRPO实现,你最熟的那套)
- FLUX 3 Action 精读(蒸馏配方的完整样本)
信息来源说明:本文一手来源为 NVIDIA Cosmos Cookbook/官方仓库、Cosmos Policy 论文与 Cookbook、arXiv 原文(编号已标注)、天机官网与公开报道;榜单与数字均标注了出处与口径。项目建议部分(消融设计、四周计划、失败分类)是基于这些一手材料的工程推断,欢迎按你们的实际约束裁剪。