0. 写在前面:我们需要一份"会晒黑的评测"
现阶段启用的 benchmark 大多默认天气晴朗、光照良好、纹理干净,视觉端到端模型的感知在这个"温室"里表现优秀。但当复用习惯了晴天的视觉 planner 进入真实世界——阴雨路面积水反光、雪天车道线被覆盖、黄昏光照死黑——它的 No-at-fault Collision 和 Drivable Area Compliance 往往断崖式下跌。“能不能开"和"换了个风格还能不能开"是两种能力。
课题组这一轮想做的,就是用 Cosmos(NVIDIA 的世界基础模型)做光照/天气/纹理的风格迁移(rain / snow / 日夜 / 模糊),在不改变场景拓扑、导航指令和 agents 语义的前提下,把同一份 NAV 场景"换皮”,得到一组视觉域被扰动、但语义标签不变的评测集,然后再跑纯视觉 end-to-end 模型在 NAV 上的 PDMS。这样我们拿到的不只是一个数字,而是一张"模型在位姿、外观扰动下的鲁棒性画像",可以回答:哪个模型在风格漂移下最硬?哪个只在晴天强?
0.1 选型逻辑:为什么是这 11 个
入选标准明确,缺一不可:
- camera-only(纯视觉):必须只吃相机输入,不能依赖 LiDAR 点云。这样"风格迁移只改图像"才能干净地、真实地作用到模型输入上。
- NAV 可跑:官方有 NAV 相关权重或可复现配置,能进入我们的批量评测管线(Agent API 封装)。
- 论文开源:能从 arXiv 拿到原文架构与打分细节。
- 覆盖技术谱系:从规则化生成型(LTF)到高分辨率稀疏语义 (SparseDriveV2)、proposal 中心式(iPad)、扩散/飞流式(DrivoR、Drive-JEPA、DriveLaW)、再到 VLA 语言世界模型(ChainFlow-VLA、AutoVLA、ReCogDrive、DriveVLA-W0)——我们想测的是"在哪一种范式上,风格迁移造成的伤害最小"。
于是,最终敲定了下面 11 个:SparseDriveV2、iPad、DrivoR、ChainFlow-VLA、AutoVLA、ReCogDrive、DriveVLA-W0、Drive-JEPA、DriveSuprim、DriveLaW、LTF(Latent TransFuser)。
下面我会给每个模型:一句话定位 → 架构解读(附 arXiv 原文架构图)→ 官方资源(仓库/HF)→ 评测配置 → NAV 得分 → 在我们风格迁移评测里值得画的重点。
1. SparseDriveV2(感知-规划稀疏联合)
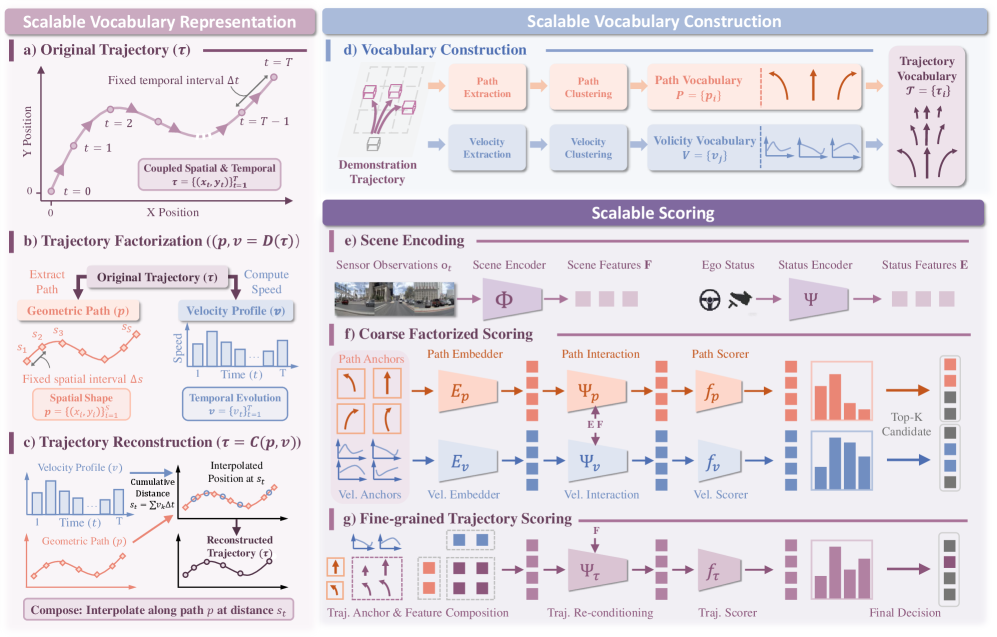
一句话定位:把高阶"时空轨迹"分解为"几何路径 + 速度谱",用稀疏 vocab 打分选出最优,属于 generation/selection 范式的稀疏语义代表。
- arXiv: 2603.29163(修正:原表误写 2603.29159)
- 官方仓库: github.com/swc-17/SparseDriveV2
- 权重: HuggingFace
wenchaosun/SparseDriveV2 - 论文图 1(架构):
架构解读
宏观:一句话看全流程
六路相机 ➜ ResNet-34 骨干 ➜ 稀疏感知(实例/地图 query)➜ 把时空轨迹"因式分解"成【几何路径 × 速度剖面】两张子词表 ➜ 笛卡尔积组合出 26 万+ 条超密集候选 ➜ 粗打分筛 top-K + 精打分选优 ➜ 最高分轨迹下发
这个模型本质上回答了打分式(Scoring-based)规划的一个核心矛盾:“词表要密(覆盖好)就得大(打分贵)”。别人在两条路上二选一——VADv2/Hydra-MDP 用静态大词表(4096/8192 条)、DiffusionDrive 用动态生成词表——SparseDriveV2 选择把"轨迹"这个对象拆开,用组合爆炸白嫖词表密度。
细节:三块板逐个拆
① 词表构造(可扩展词表表示)
- 一条时空轨迹 $\tau=\{(x_t,y_t)\}_{t=1}^T$ 被无损分解成两个正交部件:
- 几何路径 $p=\{(x_i,y_i)\}_{i=1}^S$:沿路径等弧长 $\Delta s$ 采样的空间点序,只含形状、不含时间;
- 速度剖面 $v=\{v_t\}_{t=1}^T$:等时间间隔的标量速度序列,只含快慢、不含空间。
- 两者来自对训练集真实轨迹的 K-Means 聚类:$N_p=1024$ 条路径锚 + $N_v=256$ 条速度锚。
- 组合算子 $\tau=\mathcal{C}(p,v)$ 沿路径插值累加位移,可无损重构完整轨迹 → 得到 $N_p \times N_v = \textbf{262,144}$ 条候选,是此前 Hydra-MDP 8192 条的 32 倍,而记忆开销仍是两张紧凑子词表。
- 为什么能拆:方向盘管"几何形状"、踏板管"速度曲线",两者物理上就是可解耦的控制变量,分开建表信息不丢。
② 打分(可扩展打分策略)——打分成本与词表大小解耦的关键:
| 阶段 | 打分对象 | 复杂度 | 作用 |
|---|---|---|---|
| 粗粒度分解打分 | 每条路径 $p_i$、每条速度 $v_j$ 各打一次 | $O(N_p+N_v)$ | 快速筛掉垃圾候选 |
| 精粒度组合打分 | 只对保留下来的 top-K 组合轨迹 | $O(K)$,K≈64 | 时空一致的精细评估 |
打分器输入是路径/速度嵌入与场景条件(实例 query、地图 query)的跨注意力交互,学的是"这条路符不符合当前路况、这个速度跟不跟得上前面",而不是背模板。
③ 训练与推理细节
- 训练分两阶段:coarse 打分用真值轨迹的 L2 距离度量做老师监督;精打分只对 top-K 回归,避免 26 万条全算。
- 推理:场景特征 → 分解 → 全路径/全速度粗打分 → top-K(K≈64)组合轨迹精打分 → 分数最高一条下发控制。
- 消融(Table 6)证明:词表 size 从 1024→16384 单调上升不饱和;粗-精两阶段比全量精算既省算力又不掉点。
- 关键缺陷(官方 Figure 5):强依赖导航/全局路由信号,供给不完整时词表再密也会"几何合理但方向错误"——这是任何静态词表范式的硬边界。风格迁移视角就落在这里:路径锚点对车道线/障碍遮挡敏感,风格一旦把语义打掉,词表再好也可能推错区域。
关键要点速览
| 维度 | 内容 |
|---|---|
| 范式 | Scoring(静态超密词表) |
| 视觉骨干 | ResNet-34 |
| 场景表示 | 稀疏实例/地图 query(SparseDrive 一脉) |
| 动作头 | 双词表笛卡尔积 + 两级打分 |
| 辅助任务 | 感知-规划联合(稀疏) |
| 最硬创新 | 路径×速度因式分解 |
| 风格迁移风险点 | 依赖导航信号 + 车道线语义 |
评测配置与得分
- NAVSIM v1 (navtest) PDMS:92.0(ResNet-34 后端)——表格里高于 DiffusionDrive 88.1、DriveSuprim(R34)89.9,与 iPad 91.7 略高/持平。
- NAVSIM v2 EPDMS: 随着路径锚点数从 1024→16384,EPDMS 从 85.02 提升到 87.35(内存从 9.5GB 涨到 38.9GB),说明 factorized vocab 规模直接决定上限。
| #Anchors | EPDMS | Memory (MB) |
|---|---|---|
| 1024 | 85.02 | 9531 |
| 4096 | 86.33 | 15513 |
| 16384 | 87.35 | 38877 |
风格迁移视角:SparseDriveV2 是稀疏语义的强代表,但它的前置感知依赖网络是否在高泛化性上保持语义稳定(路径锚点对车道线/障碍遮挡较敏感),在风格偏移下"几何路径"需要持续被推到正确区域,值得重点观察。
2. iPad(Iterative Proposal-centric,自拍式规划)
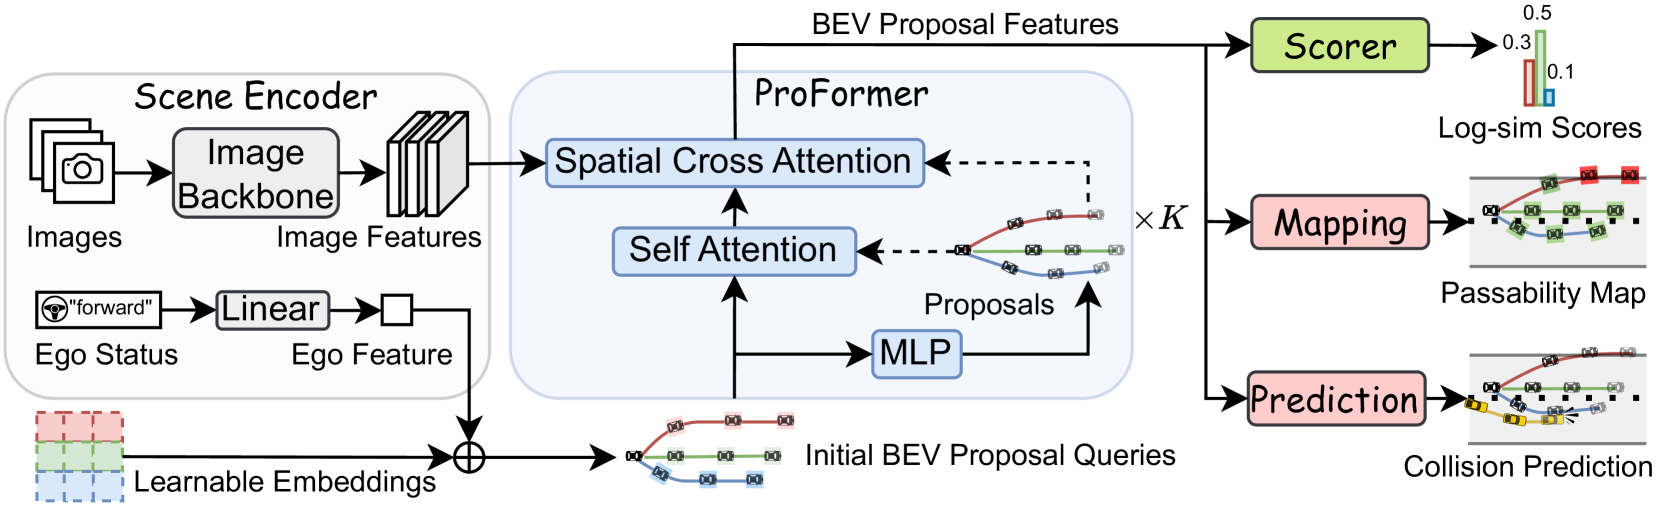
一句话定位:把"一次性生成"换成了"用 proposal 迭代自拍"——场景编码器 + ProFormer(proposal-centric BEV)+ 多轮 refinement,NAV 上 PDM 随 proposal 数/迭代数/数据对数增长。
- arXiv: 2505.15111
- 官方仓库: github.com/Kguo-cs/iPad
- 权重: 官方提供 Google Drive 下载(仓库内入口)
- 论文图 2(框架总览):
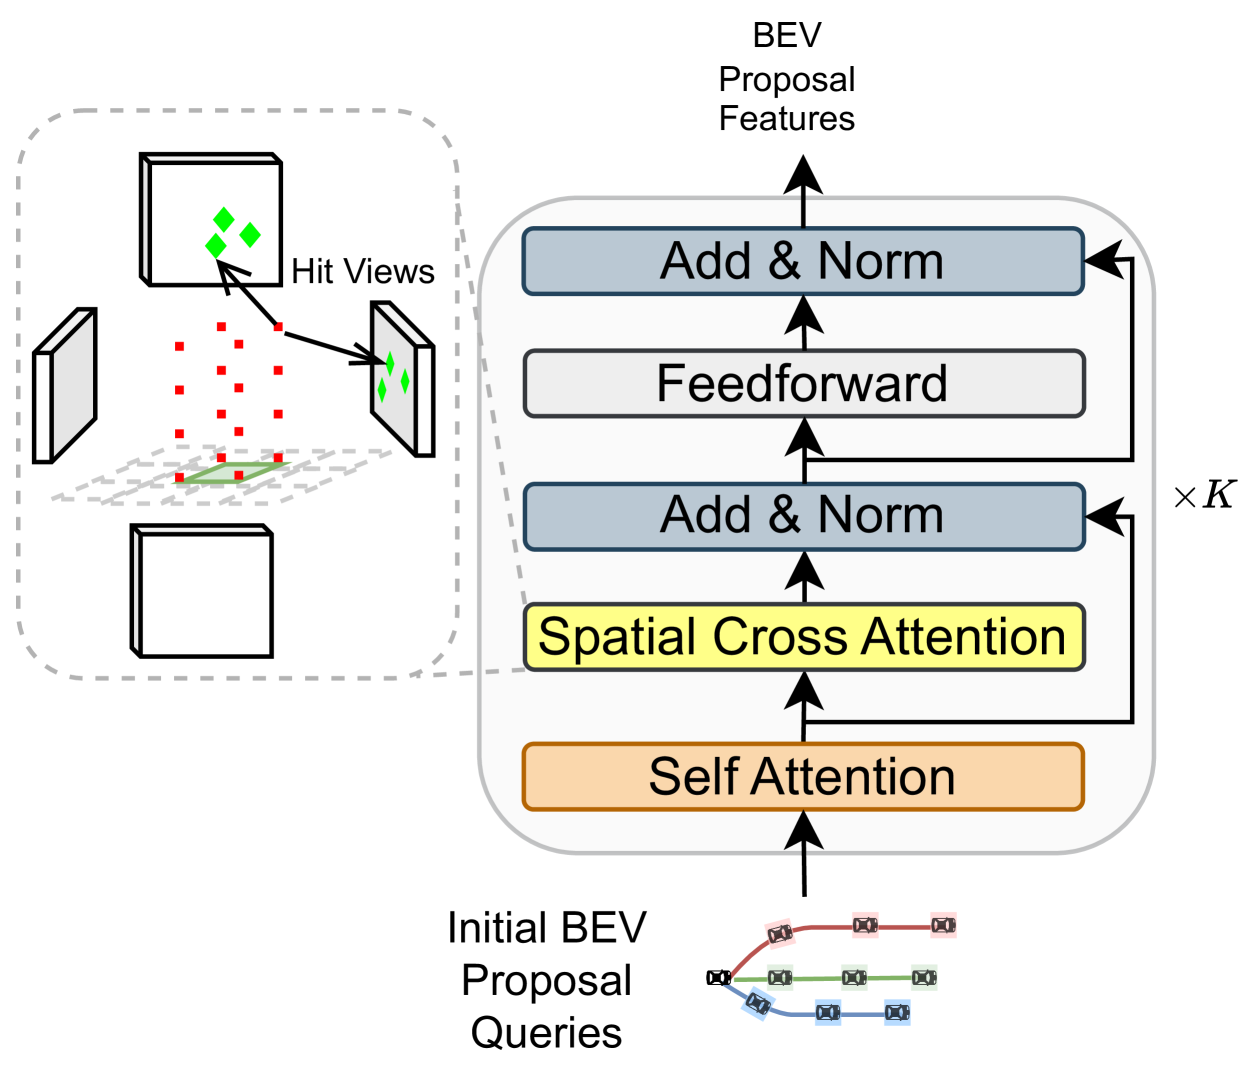
- 论文图 5(ProFormer 详解):
架构解读
宏观:一句话看全流程
环视 6 相机 + 自车状态 ➜ Scene Encoder(ResNet-34)提取多视角特征 ➜ ProFormer 用自车状态初始化 N 个 BEV 提案 query,迭代 K 轮【预测轨迹→锚定图像特征→精炼查询】➜ Scorer 给每个提案轨迹打分 ➜ Proposal-Centric Mapping/Prediction 两个辅助任务 ➜ 分最高轨迹输出
iPad 的哲学是**“规划应当成为架构的中心组织原则”,而不是下游任务。它批判密集 BEV 范式的两个病:① 算力随网格分辨率平方增长**(UniAD 200×200 网格 A100 只能跑 4.5 FPS);② 因果混淆——模型把计算浪费在与决策无关的远处建筑/树木上。所以它用 N 个稀疏提案替代密集网格,按需提取与规划相关的特征。
细节:四个组件逐个拆
① Scene Encoder:6 路相机共享 ResNet-34 提取多尺度特征 $\mathbf{F}_i\in\mathbb{R}^{C\times H'\times W'}$;自车状态(速度/加速度/方向盘转角)经两层 MLP 编码成自车特征 $\mathbf{e}$,用于提案初始化、与车姿对齐。
② ProFormer(核心创新)——“预测-锚定-精炼"迭代循环:
- 初始化:$\mathbf{q}_j^{(0)}=\text{Embed}_j+\text{MLP}_{\text{init}}(\mathbf{e})$,用不同可学习嵌入保证提案多样性、自车状态保证与当前驾驶对齐;
- 提案预测:轻量 MLP 从每轮 query 解码出候选轨迹 $\tau_j^{(k)}=\{(x_t^{(j,k)},y_t^{(j,k)})\}_{t=1}^T$;
- 锚定注意力:把轨迹路点 $(x_t,y_t)$ 用相机内外参反投影到图像平面,作为 deformable attention 的参考点去聚合对应相机特征——注意力只发生在"将要开去的地方”;
- 查询精炼:$\mathbf{q}_j^{(k+1)}=\text{FFN}(\text{DeformAttn}(\mathbf{q}_j^{(k)},\mathbf{F})+\mathbf{q}_j^{(k)})$,残差 + FFN 更新;
- 迭代:重复 K 轮(论文默认 K=3,另测 K=1/5),轨迹越修越准、特征越来越聚焦。
- 复杂度:$O(N\cdot K\cdot M\cdot T)$,提案 6~12 个 vs 密集网格 200×200,差两个数量级。
③ Scorer:轻量 MLP 对每个精炼提案输出标量分数,用边际排序损失 $\mathcal{L}_{\text{scorer}}=\sum_{j\neq j^*}\max(0,\,s_j+\Delta-s_{j^*})$($\Delta=0.5$)训练,让最优轨迹显著高于其他;推理时取最高分。
④ 提案中心辅助任务——极简但精准:
- Mapping:预测提案轨迹每个路点是否在可行驶区域内(通航性),BCE 损失;
- Prediction:只预测与该提案"最可能碰撞的前 2 个物体"的未来轨迹,L1 损失。
- 相比 UniAD 的全场景检测/追踪/建图/占用 6 任务,iPad 只有 2 个、且完全围着规划转——“少即是多”,消融显示去掉它们 PDMS 掉 1.4 点,算力却极大节省。
训练与推理要点
- 总损失 $\mathcal{L}=\lambda_1\mathcal{L}_{\text{plan}}+\lambda_2\mathcal{L}_{\text{scorer}}+\lambda_3(\mathcal{L}_{\text{map}}+\mathcal{L}_{\text{pred}})$,权重 1.0/0.5/0.1。
- 消融:去掉迭代精炼 93.2→91.5;换回等效密集 BEV 掉 2.2 点且算力×5+——证明"稀疏提案+迭代"在性能效率上双赢。
- 缩放曲线:提案数 6→12 涨 1.4 点、12→24 仅 +0.6(饱和);迭代 1→3 涨 3.8 点、3→5 仅 +0.7。默认 N=6,K=3 配 52.4 FPS,N=12,K=5 达 93.2 PDMS。
- 完整:NAVSIM PDMS 91.1(N=6)/93.2(N=12),计算量只有 UniAD 的 1/10;Bench2Drive 闭环 DS 44.7。
风格迁移视角:iPad 的整个收敛过程依赖 deformable attention 能稳定锚到"车道线/可行驶区域/交互物"的语义。一旦 Cosmos 风格迁移把车道线视觉打碎,ProFormer 的锚定注意力可能锚不到该锚的东西——但它的多轮迭代自校正机制可能产生"收敛容错"。是本次评测对扰动鲁棒性的最大黑马候选。
关键要点速览
| 维度 | 内容 |
|---|---|
| 范式 | proposal-centric 迭代规划 |
| 视觉骨干 | ResNet-34 + 自车 MLP |
| 场景表示 | N 个稀疏 BEV 提案(非网格) |
| 动作头 | Scorer 从 K 轮迭代提案中选优 |
| 辅助任务 | 提案级通航性 + Top-2 碰撞预测 |
| 最硬创新 | “预测-锚定-精炼"迭代循环 |
| 风格迁移风险点 | 锚定注意力对语义缺失敏感,但多轮迭代容错 |
评测配置与得分
- NAVSIM v1(camera, ResNet-34): 各子分数 NC 98.6 / DAC 98.3 / TTC 94.9 / Comf. 100 / EP 88.0,PDMS 91.7。
结果:proposal 数/迭代数/训练数据三者都呈对数增长 PDM——论文 Figure 3 的 Scaling Law。消融里"加 Proposal Refinement + ProFormer + proposal-centric BEV + proposal-centric prediction"逐步把 PDMS 从 78.5 拉 91.7。
风格视角:iPad 的 proposal self-correction 依赖图像里的可行驶区域和交互物件都能被 deformable attention 稳定 Query 到,一旦风格赶走了车道线/交通灯语义,iteration 是否有"收敛容错"值得重点看——它可能是"对扰动鲁棒"的最大黑马。
3. DrivoR(轨迹与打分双解码端 Transformer)
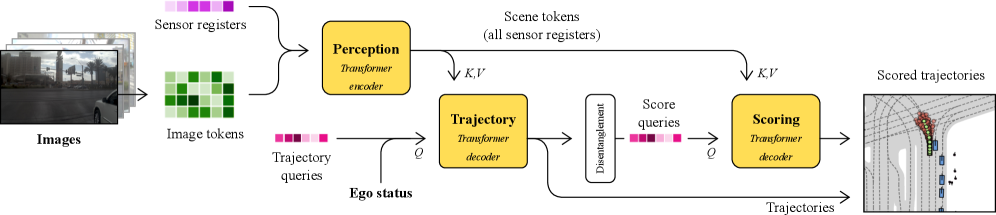
一句话定位:纯视觉的标准 three-block(1 编码 + 2 解码)Transformer,用 DINOv2 初始化 + scene tokens / sensor registers + 多轨迹最优点成绩,NAV 跑的 state-of-the-art 纯视觉基线。
- arXiv: 2601.05083
- 官方仓库: github.com/valeoai/DrivoR
- 权重: GitHub Releases(仓库内入口)
- 论文图 1(架构):
- 论文图 2(编码/解码块):
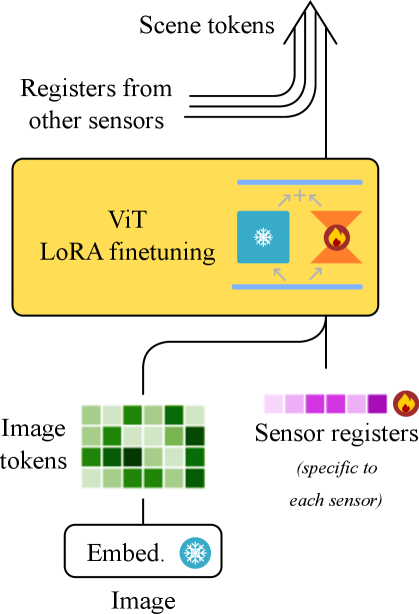
架构解读
宏观:一句话看全流程
环视相机 ➜ DINOv2 初始化的 ViT-S + 每相机 R=4 个可学习 register token(LoRA 微调)➜ 压缩成 ≤24 个 scene token ➜ 轨迹解码器(K=32 个轨迹 query + 自车状态交叉注意力,WTA 训练)出 32 条候选 ➜ 评分解码器(梯度分离)逐条给出 5 个可解释子分 ➜ 选最高分轨迹
DrivoR 的野心是"最简单架构做到最强纯视觉基线”:没有 BEV、没有检测头、没有轨迹词典、没有多任务训练——三个 Transformer 模块搞定一切。它回答的问题是"什么样的视觉表示最适合自动驾驶":答案是紧凑、结构化、相机感知的寄存器 token。
细节:三个模块逐个拆
① 感知编码器(含 sensor register 的 ViT)
- 从 DINOv2 预训练 ViT 出发:除了 patch token,每相机额外加 R=4 个可学习寄存器 token(每相机独立参数,互不干扰)。寄存器通过自注意力从 patch token 汇聚"与驾驶相关"的视觉信息,每个寄存器自动分化成一条信息通道(一个盯前车、一个盯车道线、一个盯红绿灯)——区别于 CLS token 的"笼统全局特征"。
- 压缩比:R=4 时把 6144 个 patch token 压到 24 个 scene token,1/256 压缩率(消融:无 registers 仅 CLS 只有 89.2;R=4 达 93.7,R=8 饱和)。
- LoRA 微调:冻结 ViT 权重、只训每层注意力里的低秩增量 $\Delta W=BA$(秩 8-16)+寄存器 token,参数量几乎不增(ViT-S 共 ~22M,LoRA 仅 ~0.5M),且能避免驾驶数据小导致的过拟合(全量微调反而 91.8 < 93.7)。
② 轨迹解码器
- K=32 个可学习轨迹 query + 编码后的自车状态(速度/加速度/转角,MLP 编码)作为 Q,以 scene token 为 K/V 做交叉注意力,每条 query 输出未来 T 步航点 $\tau_i=\{(x_t,y_t,\theta_t)\}$。
- WTA(winner-take-all)训练:K 条候选"打架",只有离真值最近的"胜者"吃到回归梯度,其余查询被迫去找别的可行驾驶模式 → 多模态自动涌现。消融:去掉 WTA 会坍缩到平均轨迹(90.3)。
③ 评分解码器
- 与生成器共享结构,但关键在一条线:
StopGradient(梯度分离)。否则生成器和评分器会互相"作弊"(生成器只出简单轨迹→评分器给简单轨迹高分→一起摆烂)。分离后各司其职:生成器覆盖所有模式,评分器客观评估。 - 每条轨迹输出 5 个可解释子分:
[s_safety, s_comfort, s_efficiency, s_progress, s_legality],分别对应碰撞/安全距离、加加速度/横向加速度、效率、前进进度、交规合法——每个分数可用独立 λ 加权,推理时无需重训即可调驾驶风格(λ_safety↑保守、λ_efficiency↑激进、λ_comfort↑舒适)。 - 监督信号是数据集提供的 oracle 评分(由仿真器规则计算)。
效率与缩放
- 每帧 24 个 scene token 做 KV,交叉注意力复杂度 $O(K\times24\times d)$,远低于 $O(K\times6144\times d)$。A100 上前向 ~110ms(0.5GB 显存),总 ~6FPS,三模块可 pipeline 并行。
- 缩放规律:ViT-S 22M→ViT-L 300M,PDMS 只从 93.7→94.0(+0.3),但延迟 ×7——寄存器 token 的信息容量有限,大 backbone 收益递减,这是"最小模型接近最优"的典型。
- 消融(Table 4):DINOv2 初始化 90.0 vs ImageNet-21k 87.5 vs 随机 70.1;多轨迹 1→128 从 80.1 拉到 90.0(128 封顶);联合训练 > 两阶段(评分反馈能反哺生成)。
风格迁移视角:DrivoR 对视觉特征压缩依赖极深(寄存器是"把整图读进 24 个 token"),Cosmos 风格迁移一旦把视觉分布推开,24 个寄存器能否仍装下"语义稳定"的驾驶信息是最大敏感点;但它的多轨迹 + 解耦双打分器对扰动有一定去钝性。
关键要点速览
| 维度 | 内容 |
|---|---|
| 范式 | 生成-打分解耦(Generation + Disentangled Scoring) |
| 视觉骨干 | DINOv2 ViT-S + R=4 寄存器,LoRA 微调 |
| 场景表示 | 每帧 24 个 scene token(1/256 压缩) |
| 动作头 | K=32 轨迹 query + WTA,评分解码器 5 子分选优 |
| 辅助任务 | 无(纯粹三模块) |
| 最硬创新 | register 压缩 + 梯度分离的打分器 |
| 风格迁移风险点 | token 压缩对视觉域敏感;多轨迹+打分有容错 |
| 效率 | ~40M 参数,110ms/帧,0.5GB 显存 |
评测配置与得分
DrivoR 的关键结论来自其对 navval(val set) 的报道:
| 初始化 | Random | ImageNet 21k | DINOv2 |
|---|---|---|---|
| PDMS (navval) | 70.1 | 87.5 | 90.0 |
- NAVSIM v2 navhard-two-stage(EPDMS): DrivoR (ViT-S) 45.3;加 185k SimScale 数据可达 52.3。
- 场景 token 数影响:16/64 场景 token 性能逼近 250 倍 token 数。
- 轨迹数:1→8→64→128,PDMS 80.1 到 90.0(大轨迹数收益递减,128 封顶)。
| 核心消融 | PDMS |
|---|---|
| DINOv2 初始 | 90.0 |
| ImageNet-21k 初始 | 87.5 |
| 无 registers/压缩 | 88.2 → 90.0 |
| 1 轨迹 vs 8/64/128 轨迹 | 80.1 → 90.0 |
| disjointed scoring | 90.0 |
风格视角:DrivoR 对视觉编码器依赖很大,官方强调"Registers + DINO"。如果 Cosmos 风格迁移把视觉分布推开,ViT-based registers 应该是敏感点;但它的多轨迹 + 打分器解耦可能在扰动下有去钝性。是"图像域鲁棒性"重点考察对象。
4. ChainFlow-VLA(自回归 Chain + Flow 飞集 + VLM)
一句话定位:把 “DiffusionDrive / LEAD-drive” 的无序扩散、结合 VLM 语言指导,做出"自回归轨迹生成(Chain)" + “DiT 增量精化(Flow)” + “VLM 推理引导"的三段式 VLA 规划,是 NAV 上最"爆"的一篇。
- arXiv: 2605.23270
- 官方仓库: github.com/AFARI-Research/ChainFlow-VLA
- 权重: HuggingFace
AFARI-Research/ChainFlow-VLA - 论文图 2(整体架构):
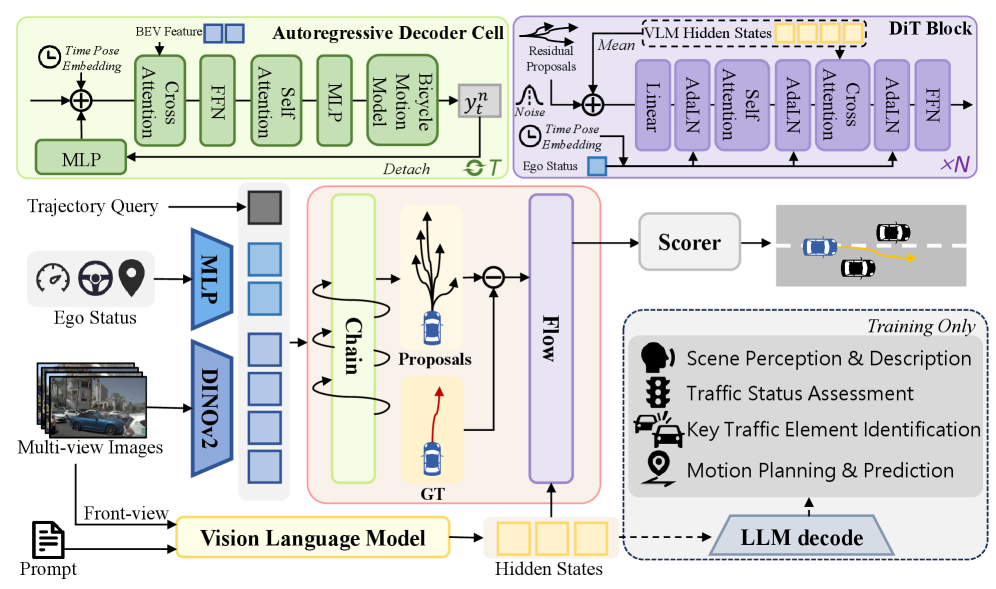
架构解读
宏观:一句话看全流程
图像与自车状态 ➜ 视觉骨干提取场景特征 ➜ ① Chain:自回归逐步生成 K 条"因果式"轨迹 proposal(Bicycle 运动学推进)➜ ② Flow:对每条 proposal 用 DiT refiner 只修"残差”(而非从噪声重建整条)➜ ③ VLM:输出推理 token 作为去噪引导条件 ➜ 最终轨迹集 + 打分选优
ChainFlow 直击扩散规划的两个痛点:无序性(DiffusionDrive 类一次性铺所有 future,缺少"先发生→后发生"的因果次序)和整条重建浪费(从头去噪不如在"已合理的基底"上精修)。它把三者缝起来,是"最纯的视觉迭代流"——论文明确把 DrivoR 当 baseline 0 号,逐步叠组件加分之。
细节:三个组件逐个拆
① Chain(自回归轨迹生成)
- 不一次性铺完所有 future,而是按时间步自回归生成:$P(Y^{\mathrm{AR}}\mid\mathcal{O})=\prod_t P(y_t\mid y_{
- 用 Bicycle 运动学模型推进状态,保证每一步在物理可行域内,得到 $K$ 条因果轨迹 proposal $\{Y^{(k)}_{\mathrm{AR}}\}_{k=1}^K$。
- 消融价值:+chain 比纯 DrivoR baseline(93.7)高 0.3(94.0)——把"无序出整条"变"有序逐步出"本身就有收益。
② Flow(DiT 增量精化 refiner)
- 不做"噪声→整条轨迹"的标准扩散,而是只修 proposal 的残差:$P(\Delta Y_k \mid Y^{(k)}_{\mathrm{AR}}, h_{\mathrm{VLM}})$——以 AR 提案为基底去噪它的偏移量,效率高得多。
- Transformer(DiT)作主干,步数/块数可调;消融显示 12 block vs 8 block 几乎无差异(94.72 vs 94.64)→ 选少即可,白赚效率。
- +DiT:94.0→94.1(+0.4 累计)。
③ VLM 语言指导
- VLM 读图 + 状态 → 输出推理表征 $h_{\mathrm{VLM}}$,作为 Flow refiner 的条件/引导信号注入去噪过程(不是参与生成 token,而是 conditioning)。
- +VLM:94.1→94.8(+1.1 累计),是三个阶段里涨幅最大的一块——说明自回归的表征 + 残差精化到达瓶颈后,语言理解带来的"该往哪修"的常识是有实打实增益的。
- 插件属性:作者还在 DiffusionDrive(88.1→88.9)和 iPad(91.7→92.7)上各自套 ChainFlow 验证兼容性——是一个即插即用的插件而非绑定模型。
风格迁移视角:ChainFlow 的命门有二——① 视觉骨干(DrivoR 后端)的 scene token 在"扰动图像"下还给不给得出稳定条件;② VLM 语言引导本身对域漂移的稳定性。它把这两块同时放大成关键变量,是评测中最值得盯"VLM 编译是否跨域稳定"的对象。
关键要点速览
| 维度 | 内容 |
|---|---|
| 范式 | 自回归 Chain + Flow 精化 + VLM 引导(VLA) |
| 视觉骨干 | DrivoR 同款 VLM+ViT 后端 |
| 场景表示 | scene token / 视觉 token |
| 动作头 | AR proposal → DiT 残差 refiner → 打分 |
| 辅助任务 | 无显示辅助(VLM 推理充当理解) |
| 最硬创新 | “残差去噪”(改 proposal 而不重建)+ VLM conditioning |
| 风格迁移风险点 | scene token 稳定性 + VLM 跨域推理 |
| PDMS | 93.7(base)→ 94.8(全家桶) |
评测配置与得分(NAVSIM 主消融)
| ID | Chain | DiT | VLM | PDMS ↑ |
|---|---|---|---|---|
| 0 | ✗ | ✗ | ✗ | 93.7 |
| 1 | ✓ | ✗ | ✗ | 94.0 (+0.3) |
| 2 | ✓ | ✓ | ✗ | 94.1 (+0.4) |
| 3 | ✓ | ✓ | ✓ | 94.8 (+1.1) |
- 在 DiffusionDrive 上兼容:88.1 → +ChainFlow 88.9;iPad 91.7 → +ChainFlow 92.7。
- DiT 12 block vs 8 block:94.72 vs 94.64(几乎无差异,选少即可)。
风格视角:ChainFlow 明确把 DrivoR 定为 baseline 之一(ID 0 = DrivoR),所以它是"最纯的视觉迭代流" ——VLM 语言指导在风格迁移时可能保持推理稳定,但前提是它依赖的视觉 backbone 在"扰动图像"下还能给出可靠的 scene tokens。这就把"VLM 的跨域稳定性"放大成关键变量。
5. AutoVLA(VLA + 自回归 action token + GRPO / RFT)
一句话定位:走"VLA 世界模型"路线的代表——用预训练小 VLM 做 backbone,把轨迹离散成 driving tokens 预测,再用 GRPO(RL)直接优化 PDMS;关注"Fast/Slow Thinking"两种推理模式。
- arXiv: 2506.13757(修正:用户表中"2605.13757"有误)
- 官方仓库: github.com/ucla-mobility/AutoVLA
- 权重: HuggingFace
Zewei-Zhou/AutoVLA - 论文图 3(模型与训练流程):

架构解读
宏观:一句话看全流程
多相机图像 + 系统提示 + 导航指令 ➜ 预训练小 VLM(Qwen3 系)骨干:视觉→token 与文本/指令 token 拼成一个序列 ➜ 自回归 next-token 生成【可选 CoT 推理 token → 动作 token】➜ codebook 查表反量化成连续可行轨迹 ➜ 最终用 GRPO 微调决策"想不想"
AutoVLA 的统一哲学:把"思考"和"动作"塞进同一个自回归生成模型——视觉、语言、动作三个空间共用一套 token 流。它瞄准 VLA 的三个通病:VLM 直出语言动作常物理不可执行、推理和规划分家导致流水线长、永远慢思考导致实时性差。
细节:三个核心创新逐个拆
① 物理动作 token 化(Action Tokenization)
- 从 VQ-VAE 思路出发:用 codebook(动作码本) 对训练集所有真实轨迹做聚类,得到 K 个"可行动作原型"。
- 连续轨迹(未来 8 时刻的 x/y/θ)→ 量化成 codebook 里最近的 token id;推理时自回归生成 token id,再查表反量化回连续轨迹。
- 因为原型全来自真实人类驾驶,生成的轨迹天然物理可行——规避了"VLM 直出’左转 30 度’式语言动作不可执行"的坑。与 OpenVLA/FAST tokenizer 同思路,但强调"可行"不是任意分箱。
② 快慢思考双模式(Dual Thinking)
- SFT 同时喂"轨迹-only"和"CoT+轨迹"两种样本,让同一模型长出两种性格:
- 快思考:直接自回归出动作 token,无任何推理文字——适合常规场景,低延迟;
- 慢思考:先出一段 CoT token(描述场景→关键物体→意图→最佳动作)再出动作 token——适合长尾、歧义、博弈场景。
- 推理时由路由策略决定走哪条;慢思考在施工区/博弈场景显著占优,常规场景与快思考持平。
③ GRPO 强化微调(自适应推理)
- 光有双模式还不够:模型会"不管简不简单都慢慢想"。用 GRPO(组内相对策略优化) 逼它在简单场景少想:
- 每个 prompt 采样一组候选(含/不含 CoT),用可验证奖励(安全/PDMS/推理成本)打分;
- GRPO 用组内相对优劣做基线,不依赖独立 critic,稳定且省显存;
- 奖励同时惩罚两种错:简单场景硬慢思考(省),复杂场景快思考出错(罚)。
- 训练后模型学会自适应:只在值得展开时才展开推理。
评测要点
- NAVSIM v1(3 cam)PDMS 89.1,+锚点 92.1(表 14 Best-of-N);DriveVLA-W0 论文把它当主要对比对象。
- 四个关键结论:动作 token 化显著降碰撞率;慢思考在长尾立功;GRPO 后推理 token 变少、延迟降低且规划不降反升;CARLA 闭环能处理动态交互。
- 软肋:监督仍然稀疏(动作 token + 可选 CoT),无世界模型那种像素级稠密信号,PDMS 上限略低于 DriveVLA-W0(93.0)且依赖多相机。
- 它的"自适应推理 + 稀疏监督"和 DriveVLA-W0 的"稠密世界模型"不互斥——未来的交汇点是两套思想拼一起。
风格迁移视角:AutoVLA 的成败几乎全压在"语言世界模型 + 推理"上。它的强项本来就是链视觉→推理/规则,对低级纹理依赖小——风格漂移时可能最抗打,但注意 SLOW 思考的 CoT 依赖的视觉 token 一旦被风格污染,推理链可能整体带偏。必须重点看的 VLA 对照组。
关键要点速览
| 维度 | 内容 |
|---|---|
| 范式 | 自回归 VLA(快慢思考) |
| 视觉骨干 | 预训练小 VLM(Qwen3 系) |
| 场景表示 | 视觉 token + 文本/指令 token 统一序列 |
| 动作头 | codebook 动作 token(离散→反量化连续) |
| 辅助任务 | 可选 CoT(快慢思考) |
| 最硬创新 | 物理可行 codebook + GRPO 自适应推理 |
| 风格迁移风险点 | CoT 链可能被污染视觉带偏;总体对纹理依赖低 |
| PDMS | 89.1 / 92.1(+锚点) |
评测配置与得分
- NAVSIM v1(camera, 3x): NC 98.4 / DAC 95.6 / TTC 98.0 / Comf. 99.9 / EP 81.9,PDMS 89.1。
- RFT/GRPO 后(同表 BiF): 能达到更高水平(表 14 中 Best-of-N 提升至 92.1,97.1、87.6 EP 等)。
风格视角:AutoVLA 的成败几乎全压在"语言世界模型 + 推理"之上;事实证明它在空间推理、交通规则上很强,但对视觉的低级纹理依赖小——纯视觉漂移到来时,它可能是最抗打的一档,也是必须重点看的 VLA 对照组。
6. ReCogDrive(VLM + 扩散规划 + 三阶训练)
一句话定位:典型"感知-认知-动作"三级 VLM 驱动:VLM 给出认知(trajectory/reasoning),扩散 planner 在认知 token 条件下去噪生成轨迹,三阶训练(预训练、IL、RL)逐步提稳。
- arXiv: 2506.08052(修正:用户表中"2605.08052"有误)
- 官方仓库: github.com/xiaomi-research/recogdrive
- 权重: HuggingFace 集合
owl10/recogdrive - 论文图 1(总览):

- 论文图 3(训练管线 + 模型架构):
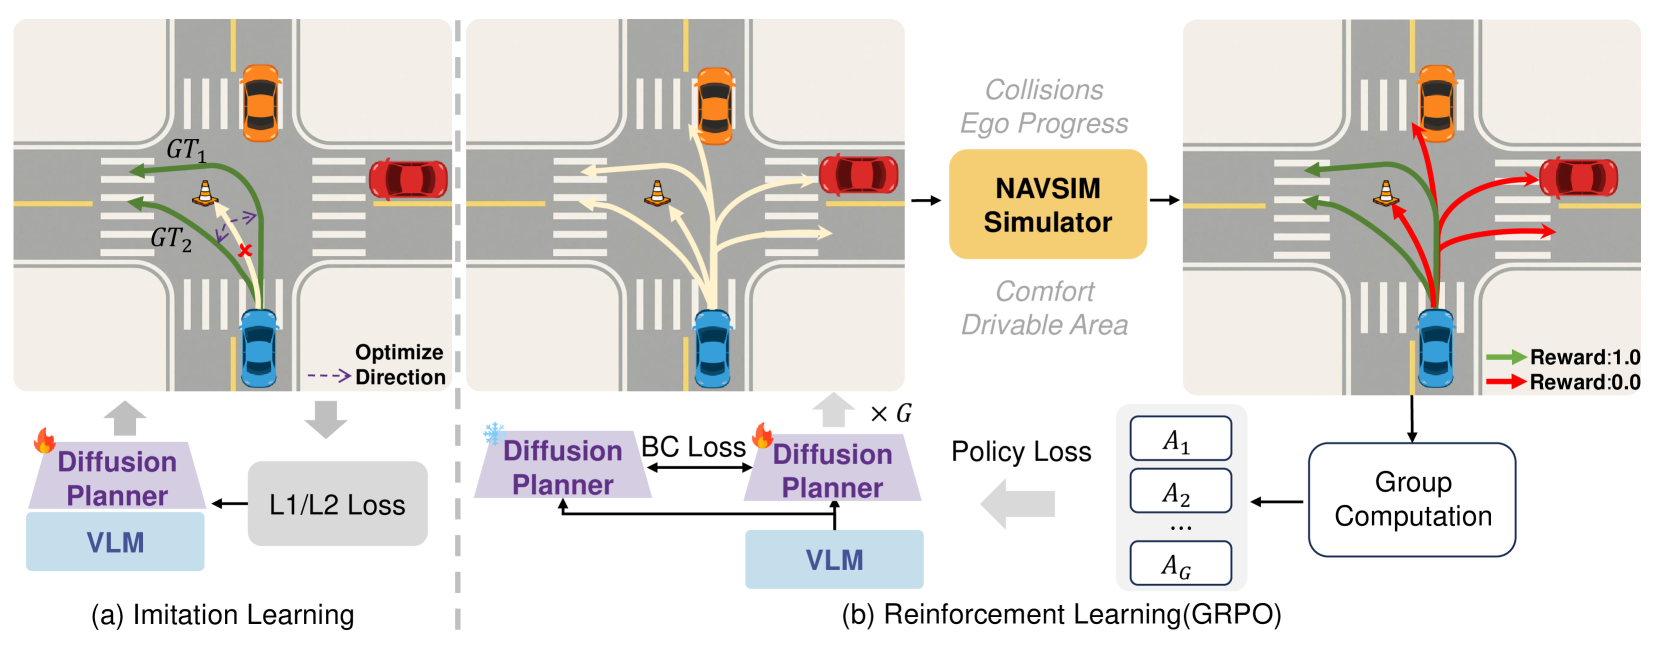
架构解读
宏观:一句话看全流程
环视 6 相机 + 导航指令 ➜ 共享视觉编码器(ViT)提特征 ➜ VLM(Qwen2.5-VL 系)自回归生成 CoT:关键目标→场景描述→驾驶推理→高层行为 ➜ VLM 最后一层隐状态当"认知 token" ➜ 注入扩散规划器,从噪声去噪生成连续平滑轨迹 ➜ DiffGRPO 强化学习安全优化
ReCogDrive 的招牌是**“三分天下”:认知(VLM 负责想清楚)、规划(扩散负责开得动)、优化(DiffGRPO 负责练出安全)。核心矛盾它点得极准:“VLM 会想但不会开”**——VLM 能把场景描述得头头是道,但让它直接输出方向盘角度,不是格式错就是数值不合理(模态错配)。所以它让 VLM 出"认知表征"、让扩散模型"翻译"成动作,而不是让 VLM 直接出文本动作。
细节:三个模块逐个拆
① 层级化数据流水线(让 VLM 真懂驾驶)
- 三阶段:生成(用驾驶数据自动产大规模 VQA 标注)→ 精炼(更强模型过滤修正)→ 质量控制(多维评估保留高质量认知标注)。
- 数据不是简单"图+轨迹",而是包含推理链的顺序认知标注:先看到什么→分析什么→做什么决策,模拟人类司机的认知顺序。
② VLM 认知层 → 认知 token
- 输入环视 6 路相机 + 导航指令,自回归生成四段 CoT:关键目标检测、场景描述、驾驶推理(“因为前车减速,所以我要准备变道”)、高层行为选择(跟车/变道/停车/加速)。
- 关键设计:不把文本 token 当轨迹,而是取 VLM 最后一层隐状态作为"认知表征"注入扩散规划器——绕开文本 tokenizer 的"离散化瓶颈"。消融显示:隐状态注入相比文本解码轨迹,推理提速 7.8×、轨迹平滑度 +35%。这是和 DriveVLM(让 VLM 直接出文本+轨迹)最大的区别。
③ 认知引导的扩散规划器
- VLM 认知表征作为条件注入扩散模型,从噪声 $q(\mathbf x_t|\mathbf x_{t-1})=\mathcal{N}(\sqrt{1-\sigma_t^2}\,\mathbf{x}_{t-1},\sigma_t^2\mathbf{I})$ 去噪生成连续轨迹;DiT 主干 $\mathbf{x}_{t-1}=D_{\mathrm{act}}(\mathrm{DiT}_\theta(z_t;F_h;S_{ego};t))$ 融合历史、自车状态、VLM 特征。
- 生成的轨迹物理平滑可执行——规避 VLM 文本坐标的精度问题。
④ DiffGRPO 强化学习
- 在扩散去噪过程中引入 GRPO 组内比较:同一场景采样 $G$ 条候选轨迹,各自得奖励 $R(\tau_i)$,组内优势 $A_i=(R(\tau_i)-\bar{R})/(\sigma_R+\epsilon)$,用 PPO-clip 式更新去噪网络。扩散"天然多模态生成" + GRPO"从候选中挑好"完美契合。
- 奖励设计三向权衡:$\mathcal{R}=\mathcal{R}_{\text{safety}}+\lambda_c\mathcal{R}_{\text{comfort}}+\lambda_e\mathcal{R}_{\text{efficiency}}$——安全(无碰撞指示 + TTC)、舒适(负 jerk/横向加速度)、效率(沿参考路径进度 − 偏离)。
- 训练三阶段:① 认知预训练(50K VQA,8×A100 约 2 天)→ ② 规划器联合训练(30K 专家轨迹,1 天)→ ③ DiffGRPO(离线预热 1 轮 + 在线仿真,3 天)。
- 消融:去掉扩散规划器 PDMS 91.2→86.1、碰撞率翻倍;去掉 DiffGRPO 碰撞率 2.1%→3.5%;去掉认知数据长尾场景塌陷最严重。
评测要点
- NAVSIM v1(3 cam)PDMS 89.6(NC 98.2/DAC 97.8/TTC 95.2/C 99.8/EP 83.5),另一配置(R34)90.8。
- 闭环 Bench2Drive DS 78.2 / 成功率 56.8% / 碰撞率 2.1%,闭环增益比开环更显著——正是 RL 的功劳。
- 完整表格中 Qwen2.5-VL 底座 + 扩散头 + DiffGRPO,是本评测里"认知-动作解耦最彻底"的 VLA。
风格迁移视角:ReCogDrive 的成功依赖两条腿——VLM 的认知文本和扩散的噪声鲁棒。风格迁移若把图像推到 VLM 训练分布之外、或改变噪声分布,轨迹去噪可能"跑偏"。属于"纯视觉 + VLM"中鲁棒敏感中等档。
关键要点速览
| 维度 | 内容 |
|---|---|
| 范式 | VLM 认知 + 扩散规划 + RL(三分天下) |
| 视觉骨干 | Qwen2.5-VL(ViT) |
| 场景表示 | VLM 认知 token(最后一层隐状态) |
| 动作头 | 扩散规划器(DiT) |
| 辅助任务 | 层级化 VQA/CoT 数据(训练侧) |
| 最硬创新 | 认知-动作解耦 + DiffGRPO |
| 风格迁移风险点 | VLM 认知 + 扩散噪声分布双敏感 |
| PDMS | 89.6 / 90.8 |
评测配置与得分
- NAVSIM v1(camera, 3x): NC 98.2 / DAC 97.8 / TTC 95.2 / Comf. 99.8 / EP 83.5,PDMS 89.6。
- 另一结果 ReCogDrive(R34)EP 87.3 → PDMS 90.8(与 DriveVLA-W0 邻近配置)。
风格视角:ReCogDrive 和 iPad 一样,成功依赖 VLM 的认知文本 + 扩散的噪声鲁棒;风格迁移如果把图像推到 VLM 之外、或 diffusion 的噪声分布改变,轨迹去噪可能"跑偏"。是纯视觉 + VLM 的"鲁棒敏感中等"代表。
7. DriveVLA-W0(世界模型 + MoE VLA)
一句话定位:把 VLA 从"只有动作监督"升级为"原生预测未来"——AR World Model(视觉 token)+ Diffusion World Model(连续未来)两条线,再用 MoE 把大 VLA + 轻量 Action Expert 联合优化效率。
- arXiv: 2510.12796
- 官方仓库: github.com/BraveGroup/DriveVLA-W0
- 权重: HuggingFace
liyingyan/DriveVLA-W0 - 论文图 2(架构):
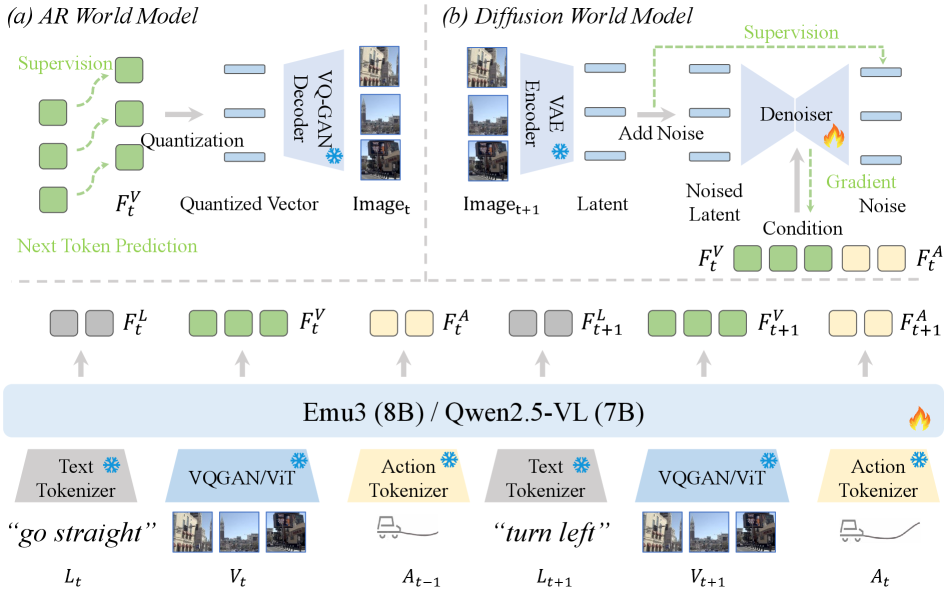
架构解读
宏观:一句话看全流程
前视相机 + 语言指令 + 历史动作 ➜ 深度交错的 token 序列进 VLA 骨干(Emu3-8B 或 Qwen2.5-VL-7B)➜ ① AR/DiT 两条世界模型分支额外预测"未来图像"提供像素级稠密监督 ➜ ② 轻量 Action Expert(500M,Joint Attention 耦合)负责逐帧出轨迹 ➜ 推理时世界模型分支旁路,只走动作通路
DriveVLA-W0 要治 VLA 路线的"监督赤字":给 7-8B 大模型,却只用几维轨迹点监督——“请了博士只让他抄左转右转”。解决办法朴素但极有效:除了预测动作,还预测未来图像,用每一时刻每个像素的稠密信号逼模型学懂物理动力学。
细节:三块板逐个拆
① VLA 基线(深度交错的序列设计)
- 三类输入编码后交错拼接:$S_t=[L_{t-H}, V_{t-H}, A_{t-H-1},\dots,L_t,V_t,A_{t-1}]$——语言指令(VLM tokenizer)、前视图像、历史动作(FAST tokenizer 离散化)。
- 两个骨干变体:VLA(VQ) 用 Emu3-8B(图像量化成离散视觉 token)、VLA(ViT) 用 Qwen2.5-VL-7B(连续视觉特征)。
- 动作预测用标准交叉熵 $\mathcal{L}_{\text{Action}}$。
② 双世界模型分支(核心创新)
| 维度 | AR 世界模型 | Diffusion 世界模型 |
|---|---|---|
| 适配骨干 | Emu3-8B(离散视觉 token) | Qwen2.5-VL-7B(连续特征) |
| 做法 | 未来图像编码成离散 token,next-token 预测 | 隐空间潜扩散去噪生成未来帧 |
| 预测目标 | 下一帧视觉 token 序列 | 下一帧图像潜表示 |
| 损失 | 交叉熵 | MSE 噪声预测 |
| 总目标 | $\mathcal{L}=\mathcal{L}_{\text{Action}}+\alpha\mathcal{L}_{\text{WM-AR}}$ | $\mathcal{L}=\mathcal{L}_{\text{Action}}+\beta\mathcal{L}_{\text{WM-Diff}}$ |
- 关键细节:两者都预测下一帧而非当前帧——因为条件里已有当前帧全部特征,重建当前帧就是抄作业,只有预测未来才逼出预测性动力学。
- 推理时世界模型分支被旁路,只走动作通路保证实时;图像生成只在可视化/反事实分析时启用。它是"严师只在训练时出场"。
③ MoE 动作专家(Action Expert)
- 大 VLM 太重不宜实时控制,加一个仅 500M 的 Action Expert,与 VLA 骨干组成 MoE。
- Joint Attention:两个专家各算 Q/K/V,沿 token 维拼接做联合自注意力,输出再拆分路由回各自专家——深度交融但不串扰。
- 三种动作解码器(论文各变体):query-based(可学习 query + MLP 直接回归轨迹)、autoregressive(自回归离散 token)、flow matching(沿直线路径流到真实轨迹)。
评测与缩放要点
- NAVSIM v1(单目前视)基础 PDMS 88.4;NuPlan 预训练 + NAVSIM 微调后 90.2(6VA/2VA)。
- 序列设计(表中 NC/DAC 攀升):VA/VA 83.3 → 2VA/2VA 84.2 → 6VA/2VA 85.6,更长动作序列 + 更长视野持续提升 PDMS(微调后到 88-90)。
- 世界模型放大数据缩放律:同样数据量下,有 WM 稠密监督的 VLA 缩放斜率显著更陡——单位数据转化出更多的 PDMS(论文核心论点)。
- 对比 AutoVLA:AutoVLA 是"稀疏监督+自适应推理"(92.1),DriveVLA-W0 是"稠密监督"(93.0 AR 单相机更高)——前者管"想不想"、后者管"监督够不够密",不互斥。
风格迁移视角:DriveVLA-W0 用世界模型"想象未来",理论上不依赖逐像素局部感知——前提是世界模型生成的"未来视频"在风格漂移下仍保持连贯(雨雪夜里它脑补的未来还像不像真的)。值得把"world model 未来连贯性"单列为评测指标。
关键要点速览
| 维度 | 内容 |
|---|---|
| 范式 | VLA 世界模型(稠密监督) |
| 视觉骨干 | Emu3-8B / Qwen2.5-VL-7B |
| 场景表示 | 深度交错视觉-语言-动作序列 |
| 动作头 | 500M Action Expert(Joint Attention)+ 三种解码器 |
| 辅助任务 | 双世界模型预测未来图像(训练时) |
| 最硬创新 | 世界模型稠密监督放大数据缩放律 |
| PDMS | 88.4(基础)/ 90.2(NuPlan 预训练) |
| 风格迁移风险点 | 世界模型未来帧在风格漂移下的连贯性 |
评测配置与得分
- NAVSIM v1(camera,单相机): 基础 PDMS 88.4;NuPlan 预训练 + NAVSIM 微调后 90.2(表 6 的 6VA/2VA 配置)。
| 序列设计 (pretrain/finetune) | NC | DAC | PDMS |
|---|---|---|---|
| VA/VA | 96.8 | 92.7 | 83.3 |
| 2VA/2VA | 97.3 | 93.2 | 84.2 |
| 6VA/2VA | 98.3 | 93.8 | 85.6 |
- 更长 action 序列与更长视野持续提升 PDMS(NAVSIM 微调后到 88-90)。
风格视角:DriveVLA-W0 用 world model 去"想象未来",在漂移下理论较稳(不依赖逐像素局部感知);值得把"world model 能否在雨/雪/夜里保持未来连贯"列为测评指标。
8. Drive-JEPA(联合世界模型预测 + JEPA 视觉预训练)
一句话定位:把 V-JEPA 式自监督视频预训练搬到驾驶规划上,配合多轨迹发散蒸馏(MTD)和多模态伪标签,走 camera-only 且全图不依赖 LiDAR,取得高性能。
- arXiv: 2601.22032
- 官方仓库: github.com/linhanwang/Drive-JEPA
- 权重: HuggingFace 数据集
datasets/LinHanWang/Drive-JEPA - 论文图 2(总览):
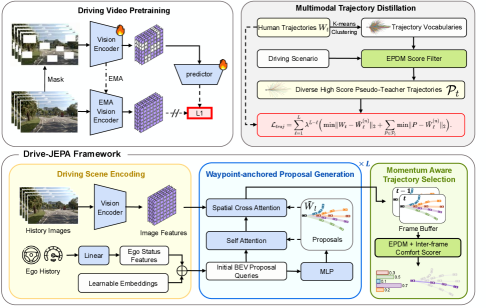
架构解读
宏观:一句话看全流程
驾驶视频流 ➜ V-JEPA 自监督视频预训练学 ViT encoder(预测隐表征而非重构像素)➜ Transformer decoder 用双重注意力(WADA:轨迹 query + 世界 token query)做感知/未来预测 ➜ MTD 多轨迹发散蒸馏保证多模态 ➜ 从记忆缓存 + 未来预测接口选优出轨迹
Drive-JEPA 走的是"预测型自监督“路线:不学像素、不学语言,只学"隐空间的表征一致性”。它把 Meta 的 V-JEPA 那套"预测未来抽象表征"搬到驾驶规划上——核心信仰是**“世界比你看到的更有意义”,与其重建像素不如预测理解**。
细节:三块板逐个拆
① 视频预训练(V-JEPA 式)
- 自监督目标:$\min \|P_\phi(\Delta, E_\theta(x))-\text{sg}(E(y))\|$——用 patch mask + 预测器 $P_\phi$ 在一个视角的隐表征上预测另一个视角/未来的隐表征,stop-gradient 防崩溃。
- 产出:一个通用的 ViT encoder(无需任何驾驶标注即可预训练),对底层视觉语义特征更通用——这正是它对风格迁移 invariance 的理论支柱。
- 预训练数据:大规模驾驶视频(非人工标注),这也是它 ViT-L 能上 93.7 的底气。
② 感知/世界模型(双注意力接口)
- Transformer decoder + 可学习 query 同时做两件事:目标/未来预测 query(感知)与世界 token query(未来状态)。
- 双 WADA(World-Aware Dual Attention):两路 query 分别与当前视觉记忆、预测的未来隐表征做交互——把"我看到什么"和"我猜接下来怎样"耦合进同一注意力。
- 记忆缓存(memory)跨帧维护场景状态,token 间既有当前观测又有演化记忆。
③ MTD(Multimodal Trajectory Distillation)
- 用多个 pseudo-teacher 轨迹(可能来自不同模型/不同采样)蒸馏,让 proposal 学习多模态分布,避免 WTA/BC 常见的 mode collapse(全坍缩到一种驾驶模式)。
- 相当于"多专家软标签蒸馏",是它多轨迹能力的关键。
评测要点
- NAVSIM v1(camera)ViT-S 89.0(NC 98.7/DAC 96.2/EP 82.9/TTC 95.5)、ViT-L 93.7。
- 同表对比:Epona 86.2 < DriveSuprim 89.9 < iPad(R34) 91.1 < Drive-JEPA(R34) 91.5 < Drive-JEPA(ViT-L) 93.7——同一模型换 backbone 从 91.5→93.7,说明 JEPA 预训练对视觉骨干的依赖是"锦上添花"而非"雪中送炭",但天花板很高。
风格迁移视角:JEPA 预训练暗示"对视觉语义底层特征更通用、对纹理/域漂移 invariance 更好"——这是我们最想验证"预训练范式 vs 域漂移"假设的真正对照组:如果风格迁移下它掉得最少,就证明"预测型自监督"比"监督/语言对齐/VLA"天然硬。
关键要点速览
| 维度 | 内容 |
|---|---|
| 范式 | JEPA 预测型自监督 + 世界模型 |
| 视觉骨干 | V-JEPA 预训练 ViT(S/L) |
| 场景表示 | 记忆缓存 + 世界/目标双 query token |
| 动作头 | Transformer decoder + MTD 多模态蒸馏 |
| 辅助任务 | 视频预言(自监督,无标注) |
| 最硬创新 | 隐表征预测(非像素)自监督 |
| 风格迁移风险点 | 预期抗漂移最佳(待验证) |
| PDMS | 89.0(ViT-S)/ 93.7(ViT-L) |
评测配置与得分
- NAVSIM v1(ViT-S, camera):NC 98.7 / DAC 96.2 / EP 82.9 / TTC 95.5 → PDMS 89.0。
- NAVSIM v1(ViT-L, camera):可达 PDMS 93.7。
| 方法 | 后端 | 输入 | PDMS |
|---|---|---|---|
| Epona | ResNet | camera | 86.2 |
| iPad (R34) | ResNet | camera | 91.1 |
| DriveSuprim (R34) | ResNet | camera | 89.9 |
| Drive-JEPA (R34) | ResNet | camera | 91.5 |
| Drive-JEPA (ViT-L) | ViT-L | camera | 93.7 |
风格视角:因为 JEPA 用 V-JEPA 自监督(而非纯有监督/纯 VLM),它对视觉语义的底层特征更有通用性——理论上对风格迁移的 invariance 较好,是我们最想验证"预训练范式 vs 域漂移"假设的模型。
9. DriveSuprim(Top-K 粗到细 + 旋转增强 + 候选蒸馏)
一句话定位:聚焦"Selection(候选选择)“范式,用 coarse-to-fine 两步选择最 top 的轨迹,并用旋转数据增强打破"直行偏置”,配合蒸馏。
- arXiv: 2506.06659(修正:用户表"2606.06659"有误)
- 官方仓库: github.com/William-Yao-2000/DriveSuprim
- 权重: HuggingFace
alkaid-2000/DriveSuprim - 论文图 2(架构):
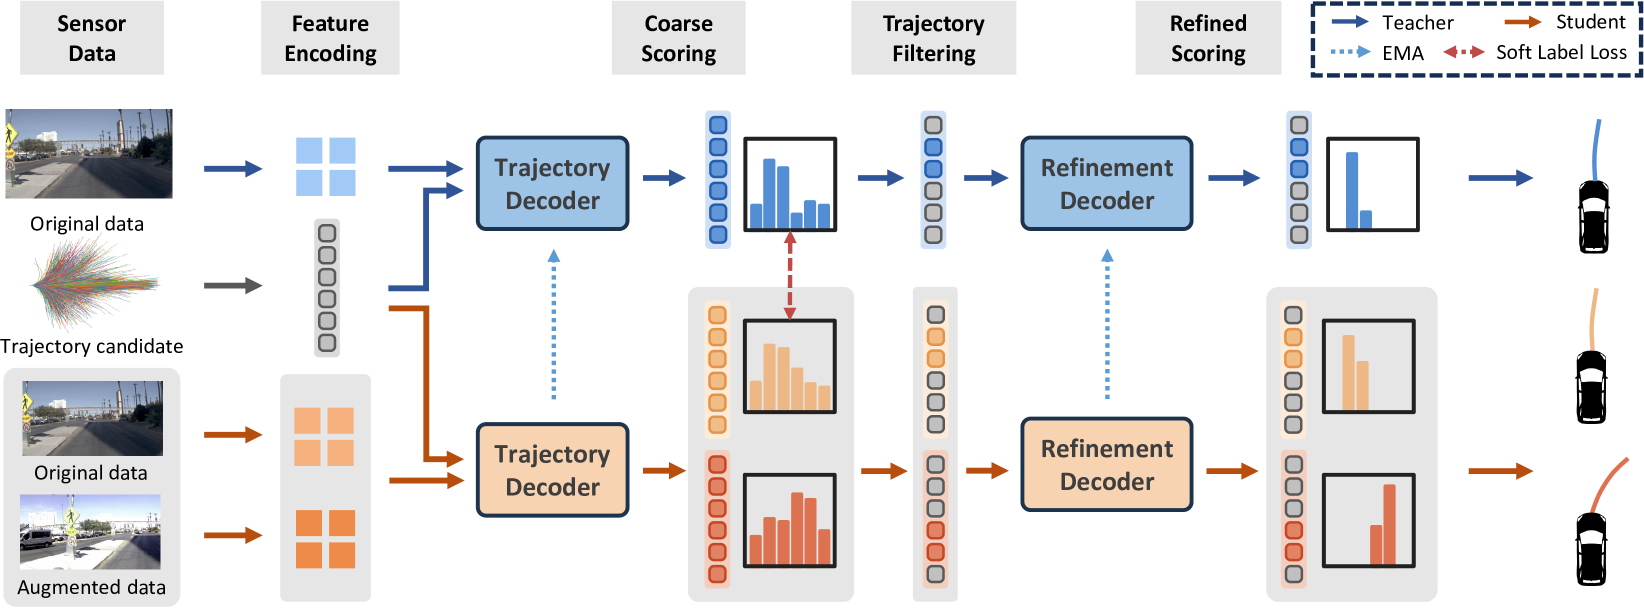
架构解读
宏观:一句话看全流程
相机图像 ➜ 视觉骨干(ResNet-34 / EVA-ViT-L)提特征 ➜ ① coarse 阶段:在大候选池上逐子项打分、筛出 top-K(区分 hard negatives)➜ ② refine 阶段:RefineDec 对 K 条候选细修 ➜ 用旋转数据增强消除"直行偏置" + soft label 蒸馏 → 输出最优轨迹
DriveSuprim 是"把 Selection 做到极致"的模型——它不信"让模型直接生成轨迹",而信"多修不如多选":专注 coarse-to-fine 两步选择 + hard negative 区分,再用增强和蒸馏把候选质量天花板抬高。
细节:三个机制逐个拆
① 粗选(coarse)
- 在大 candidate 池上,用 metric score 逐子项打分(对照 NC/DAC/TTC 等),筛出 top-K(在线性扫描里保留最有希望的轨迹)。
- 关键在区分 hard negatives:从"分数还行但实际不能走"的轨迹里学出真正辨别力,否则打分器只会给"看起来不错"的平庸轨迹高分。
② 精选(refine)
- 用 RefineDec(refinement decoder) 对 coarse 保留的 top-K 候选做细修——不是重新生成,而是把曲率、可达性、与导航的贴合做精调。
- 两级配合下,score 精度远高于单级打分。
③ 关键技巧:旋转增强 + soft 蒸馏
- 旋转数据增强:训练数据里"直行"占绝对多数,导致转向场景模型「转向丢失」。把图像按角度旋转后重新关联轨迹,人为制造转向多样性,破掉直行偏置。消融显示这是恢复急弯能力的关键。
- soft label 蒸馏:把 teacher 判定的高分轨迹作为软标签回归(而非 one-hot),让粗选/精选都对齐到"分数分布"而不是"单条答案"——更平滑、更好泛化。
- 总损失:$L = L_{\text{ori}} + L_{\text{aug}} + L_{\text{soft}}$(原始轨迹 + 增强轨迹 + 软标签)。
评测要点
- NAVSIM v1(R34, camera)PDMS 89.9;换 EVA-ViT-L 后 → 93.5——backbone 从 R34 升级到 CLIP 蒸馏 ViT-L 提升 3.6 点,说明 Selection 的天花板受视觉特征质量钳制。
- 在 Drive-JEPA / DrivoR 横向对比表里,DriveSuprim(R34) 89.9 < iPad(R34) 91.1,但 EVA-ViT-L 版本追到 93.5,和 DrivoR 93.7 同级。
风格迁移视角:它的增强只针对"旋转/方向偏置",对"风格/纹理"替换是否敏感,取决于 coarse selector 在风格污染后的图像上还能不能挑出对冲的 top-K——如果 K 里全是"看似高分实则走歪"的候选,coarse-to-fine 也无救。
关键要点速览
| 维度 | 内容 |
|---|---|
| 范式 | Selection(coarse-to-fine) |
| 视觉骨干 | ResNet-34 / EVA-ViT-L |
| 场景表示 | 图像特征 → 轨迹大候选池 |
| 动作头 | 粗选 top-K + RefineDec 精修 |
| 辅助任务 | 无显示辅助(纯轨迹选择) |
| 最硬创新 | hard-negative 区分 + 旋转增强 + soft 蒸馏 |
| 风格迁移风险点 | coarse selector 对纹理污染的选优能力 |
| PDMS | 89.9(R34)/ 93.5(EVA-ViT-L) |
评测配置与得分
- NAVSIM v1(R34, camera): PDMS 89.9;NAVSIM v1(EVA-ViT-L 后端):PDMS 93.5。
风格视角:DriveSuprim 是把"选择"做到极致的模型,它的增强(旋转)对方向偏置有用,但对"风格/纹理"替换是否敏感——取决于它的 coarse selector 是否仍能挑出对冲的 top-K。如果 K 内全部被风格污染,coarse-to-fine 也无救。
10. DriveLaW(时空一致的世界模型 + Flow 生成)
一句话定位:离线 video-in + flow matching 世界模型 + DiT 动作,用 “Noise Reinjection” 恢复由扩散丢失的结构/时间一致性,再生成轨迹。
- arXiv: 2512.23421
- 官方仓库: github.com/xiaomi-research/drivelaw
- 权重: HuggingFace
tz2026/DriveLaW - 论文图 1(总览架构):
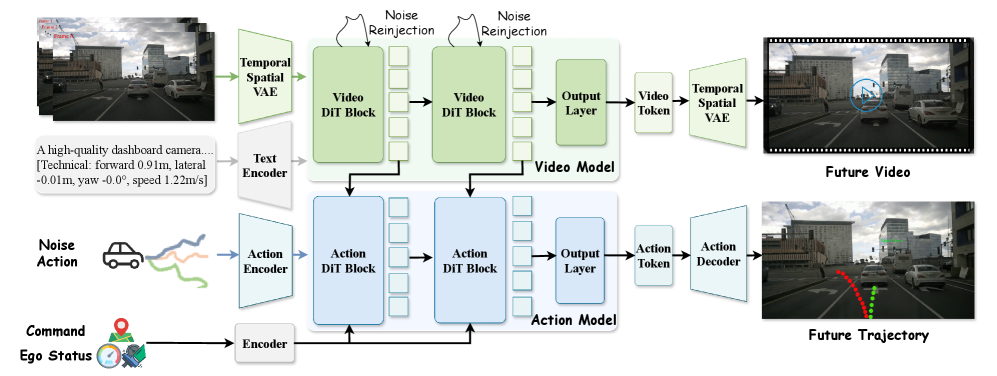
架构解读
宏观:一句话看全流程
历史观测(图/动作)➜ 统一编码进 latent world(隐空间世界状态)➜ 通过 Diffusion/Flow 预测未来本质 ➜ Noise Reinjection 把扩散丢失的结构/时序一致信息"再注入" ➜ DiT action 头在隐世界条件下生成轨迹
DriveLaW 是世界模型家族代表,和 TADV2/扩散规划的不同在于:它几乎不直接吃图像原始像素去逐帧规划,而是先建一个"latent world"(隐空间的世界状态),再在这个世界状态上推演未来、生成动作。代价是把"视觉域 → 世界模型"的链路变成全系统最脆弱的一环。
细节:三个机制逐个拆
① latent world(统一世界状态)
- 把历史观测(图像 + 动作序列)编码到统一的隐空间状态,作为模型对"当前世界"的压缩理解。
- 一切预测(未来帧、未来动作)都以这个 latent 而非原始像素为条件——这是它和"逐像素 BEV"路线的根本分界。
② Noise Reinjection(噪声重新注入)
- 扩散/Flow 在预测未来时,会因为去噪的随机性丢失时间/空间一致性(生成的未来帧"散架")。
- 修复:$L' = L_t + \sigma'_t \cdot M \odot \varepsilon_t$——用 mask $M$ 在需要保留结构的位置重新注入恰当幅度的噪声,逼迫模型把结构信息从"丢弃"改成"显式利用",恢复未来帧的时空一致。
- 这是 DriveLaW 的招牌工程:扩散不是"无中生有",而是要"保结构地延展"。
③ DiT / Flow Matching 动作头
- $f_\theta(a_t,t) = \text{DiT}_{\text{act}}([h_{\text{act}};t] \mid h_{\text{ctx}}, \{f_i\})$,以隐世界上下文 $h_{\text{ctx}}$ 为条件生成动作;
- Flow Matching 损失 $L_{FM} = \| f_\theta(a_t,t) - (a_0-\varepsilon)\|$——沿噪声→干净轨迹的插值直线学习向量场,比扩散步数少、更稳定。
评测要点(视频预训练缩放)
| Video P.T. | PDMS |
|---|---|
| 0 (scratch) | 85.9 |
| 76k | 87.0 |
| 3.8M | 87.8 |
| 7.6M | 89.1 |
视频预训练数据量从 0→7.6M,PDMS 85.9→89.1 单调上升——DriveLaW 的强项高度依赖大规模无标注视频预训练,世界模型的缩放律明确。
风格迁移视角:DriveLaW 的世界模型"雨雪后的未来帧真实"是主要脆弱点——风格迁移改变图像视觉分布,latent world 未来推演是在"错误视觉基础上的想象",且它没有 JEPA 那种自监督底子托底。正好命中我们评测最核心的"视觉域 → 世界模型"链路,是本评测设计的主要靶子之一。
关键要点速览
| 维度 | 内容 |
|---|---|
| 范式 | 世界模型 + Flow/扩散 |
| 视觉骨干 | latent world 编码器(非逐像素) |
| 场景表示 | 统一隐空间世界状态 |
| 动作头 | DiT action + Flow Matching |
| 辅助任务 | 视频预训练(离线) |
| 最硬创新 | Noise Reinjection 保时空一致 |
| 风格迁移风险点 | 世界模型未来帧对视觉域极敏感 |
| PDMS | 89.1(7.6M 视频预训练) |
评测配置与得分(视频预训练缩放)
| Video P.T. | PDMS |
|---|---|
| 0 (scratch) | 85.9 |
| 76k | 87.0 |
| 3.8M | 87.8 |
| 7.6M | 89.1 |
风格视角:DriveLaW 是世界模型家族的代表,几乎不直接吃图像原始像素——它是靠 latent world 生成未来。如果风格迁移改变图像视觉分布,世界模型的"雨雪后的未来帧真实"就成了主要脆弱点——正好命中我们评测里最核心的"视觉域 → 世界模型"链路。
11. LTF / Latent TransFuser(官方纯视觉 NAV 基线)
一句话定位:NAVSIM 官方 image-only 基线的代表——TransFuser 的 latent 变体,用 latent positional embedding 替代 LiDAR BEV,是 NAV 基准里经过官方验证的纯视觉 baseline。
- arXiv: 2406.15349(NAVSIM 论文本身)
- 官方仓库: 官方 github.com/autonomousvision/navsim(
navsim_baselines目录,ltf) - 权重: HuggingFace
autonomousvision/navsim_baselines(ltf)
架构图:LTF 是 TransFuser 的 latent 变体,其体系架构图沿用 TransFuser 架构(见
static/images/transfuser/fig2_architecture.png)。其特点是把 TransFuser 的 LiDAR BEV 通道替换成 latent positional embedding,从而 camera-only 化。
架构与配置
宏观:一句话看全流程
环视相机图像 + 自车状态 ➜ 多相机独立 CNN 特征 ➜ 融合模块(原本 TransFuser 用 LiDAR BEV 做融合锚,LTF 用 latent positional embedding 替代)做尺度级 Transformer 融合 ➜ 全局向量 ➜ MLP + GRU 自回归逐 moment 出差分 waypoint ➜ PID 控制
LTF 是 TransFuser 的 latent 变体,NAVSIM 官方 image-only 基线。它保留 TransFuser 的骨架(C 层尺度融合研究),只把 LiDAR BEV 通道换成 latent positional embedding——从而 camera-only 化。它属于"经典 CNN/Transformer 融合"路线,不依赖 VLA、不依赖世界模型,是我们评测的下界锚(控制组最低参考)。
细节:三个要点
- TransFuser 的遗传:多相机图像 → CNN backbone → 在多个尺度上做自注意力融合(latent variant 用 latent PE 表示空间位置,替代 LiDAR 深度通道)。比"后融合"(分别检测再合并)强,因为融合发生在特征级。
- 动作头:融合后的全局向量 → MLP → GRU 自回归地逐步预测差分 waypoint(每个下一时刻的相对位移),再由规划下游转成控制。
- 辅助任务(TransFuser 传统):深度估计、语义分割、HD 地图、车辆检测四个辅助监督帮感知更"正交地"学——但为 image-only 时深度监督改为 latent 版本。
- 地位:NAVSIM 官方用它当 image-only baseline,官方仓库
navsim_baselines直接可跑,无需超参;所有偏置对照(DrivoR Table S4.T1 里同为 83.8 LTF baseline)都能用它对齐统计口径。
评测要点
| 数据(真实照片相机) | NC | DAC | TTC | Comf. | EP | PDMS |
|---|---|---|---|---|---|---|
| LTF (camera) | 97.4 | 92.8 | 92.4 | 100 | 79.0 | 83.8 |
可见 NC/TTC 都很高、EP(里程进度)拖后——典型的"不敢快/不敢超车"保守型规划打分形状。
风格迁移视角:它是整个评测里最朴素的纯视觉模型——图像一旦被风格污染,它没有 token 压缩(DrivoR)、没有提案容错(iPad)、没有语言/世界模型兜底(VLA/DriveLaW),最能直接反映"一个朴素 camera-only 模型在 Cosmos 风格下到底能差到哪"。它的下界就是整个评测的"地板线"。
关键要点速览
| 维度 | 内容 |
|---|---|
| 范式 | 经典 CNN+Transformer 融合(TransFuser latent 化) |
| 视觉骨干 | ResNet-34 类 CNN + latent PE |
| 场景表示 | 尺度级融合特征(无 BEV/无 token 压缩) |
| 动作头 | GRU 自回归差分 waypoint |
| 辅助任务 | 深度/语义/地图/检测(latent 版) |
| 最硬创新 | latent PE 替代 LiDAR BEV(官方纯视觉基线) |
| PDMS | 83.8(官方 image-only baseline) |
风格视角:因为它就是官方最简单纯视觉基线,风格迁移下它最能体现"一个朴素 camera-only 模型在 Cosmos 风格下到底能差到哪、以及提升空间多大",是我们整个评测的下界锚。
12. 横向对比表 & 选型建议
12.1 全模型横向对比(NAVSIM v1 navtest / val)
| 模型 | arXiv | 类别 | 视觉后端 | 仓库 | PDMS (相机) |
|---|---|---|---|---|---|
| SparseDriveV2 | 2603.29163 | 稀疏 vocab 分解 | ResNet-34 | github+HF | 92.0 |
| iPad | 2505.15111 | proposal 迭代 | ResNet-34 | github/GD | 91.7 |
| DrivoR | 2601.05083 | Transformer 三块(enc+2 dec) | ViT-S (DINOv2) | github | 90.0 (val) |
| ChainFlow-VLA | 2605.23270 | Chain + Flow + VLM | DrivoR 后端 | github+HF | 94.8 |
| AutoVLA | 2506.13757 | VLA + GRPO | VLM | github+HF | 89.1 |
| ReCogDrive | 2506.08052 | VLM + Diffusion | ResNet-34 | github+HF | 89.6 / 90.8 |
| DriveVLA-W0 | 2510.12796 | World Model + MoE VLA | VLM | github+HF | 90.2 |
| Drive-JEPA | 2601.22032 | JEPA + 多模态蒸馏 | ViT-S / ViT-L | github+HF | 89.0 / 93.7 |
| DriveSuprim | 2506.06659 | coarse-to-fine 选择 | R34 / EVA-ViT-L | github+HF | 89.9 / 93.5 |
| DriveLaW | 2512.23421 | 世界模型 + Flow | latent world | github+HF | 89.1 |
| LTF | 2406.15349 | TransFuser latent | ResNet-34 | navsim 官方 | 83.8 |
注:各模型论文所用评测集(navtest / navval)与 backbone 略有差异,分数仅供横向参考,跨行直接对比需注意统计口径。
12.2 给课题组的评测排期建议
我的观点(供组长参考,选型已定):
- 如果你想验证"哪类范式最抗视觉风格漂移":非 VLA 的强纯视觉组合(iPad / DriveSuprim / Drive-JEPA / DrivoR)值得优先看——它们对"像素→具体语义"的依赖较重,风格一旦把语义视觉打碎,这类最容易暴露差距,能放大"迁移"的观感。
- 如果你想验证"世界模型 / VLA 的泛化是否缓解漂移":AutoVLA、ReCogDrive、DriveVLA-W0 / DriveLaW。它们的强项本来就是"链视觉 → 推理/未来",如果它们对风格偏移抗性好,会是一个强信号:VLA/世界模型天然鲁棒。
- LTF 必须当基线放进去——它就是官方 image-only baseline,整个评测需要一个"无超参下界"。
总之一句话:因为我们已经敲定这 11 个,以下是"评测排序"的建议(不是改选型):
评测建议:按 3 队列跑
- 队列 A(纯视觉基线):LTF、DrivoR / SparseDriveV2
- 队列 B(proposal/扩散范式):iPad、ChainFlow、Drive-JEPA、DriveSuprim
- 队列 C(VLA/世界模型):AutoVLA、ReCogDrive、DriveVLA-W0、DriveLaW
对每个模型,在 NAV 天气/风格迁移下跑出 {PDMS, EPDMS, 每子项,以及关闭 vs 开启风格的两级差距},然后归一化到"风格鲁棒指数 Σ_{天气≠晴} ΔPDMS",就能得到我们评测的核心输出。
13. 下一步(评测管线怎么看)
具体我们评测还要落地行动:
- 搭 Agent API 封装:给 11 个模型写统一的
Agentwrapper(输入→轨迹输出),统一输出到 NAVSIM 的EgoPlanner输入。 - Cosmos 风格迁移流水线:先固定"同一场景"(scene-id),对 camera 做 rain/snow/daycycle,闭环到 PDMS。
- 统计口径:PDMS = NC × DAC × (5·EP+5·TTC+2·C)/12(当 NC、DAC 满分时 EP 是唯一连续变量),重点盯 NC、DAC 两个乘性项在迁移下的塌陷。
- 输出:每模型一张 “style 热力矩阵”(× 天气 × 难易度),最终汇总成"模型 × 通用鲁棒性"雷达图 —— 这就是我们新 benchmark 最有价值的产出。
14. 个人疑问:这些"VLA"到底在干什么?VLM 和 ResNet/DINOv2 差在哪?VLM 就更好吗?
写完上面 11 个模型后,我自己绕不开的一个疑问是:这 11 个模型里既有纯 ResNet-34、又有 DINOv2、又有世界模型,名字里还混着 4 个 “VLA”——它们到底凭什么分成两类?“VLA” 的 L 到底是什么?用 VLM 就比用 ResNet 高级吗? 这个疑问不解决,对比表只是堆数字。下面把话一次说透。
14.1 先把这 11 个模型的"视觉端到底是谁"钉死
我读论文时一个现实的痛点是:不少 VLA 论文从不点名自己视觉塔的型号(只写 “a pretrained VLM”),而官repo 常常又是重度改动过的。结合本文各模型论文原文与已核实的开源仓库,11 个模型的"视觉端"实况如下:
| 模型 | 表面类别 | 视觉端到底是什么 | 有没有 LLM / 语言空间 |
|---|---|---|---|
| SparseDriveV2 | 稀疏打分 | ResNet-34(经典 CNN 特征提取) | ❌ 无 LLM,纯几何打分 |
| iPad | proposal 迭代 | ResNet-34 Scene Encoder | ❌ 无 LLM |
| DrivoR | 寄存器 Transformer | DINOv2 初始化的 ViT-S(自监督视觉预训练) | ❌ 无 LLM |
| ChainFlow-VLA | “VLA” | DrivoR 同款视觉后端 + VLM 语言指导 | ✅ LLM 参与语言指导 |
| AutoVLA | VLA | 预训练 VLM 骨干(UCLA 自称 “小 VLM”) | ✅ 显式 CoT + 动作 token |
| ReCogDrive | VLA | VLM 认知模块 视觉塔 + 扩散规划器融合 | ✅ VLM 出认知 token |
| DriveVLA-W0 | VLA/世界模型 | VLM 骨干 + AR/Diffusion 世界模型 | ✅ 隐式预测式 CoT |
| Drive-JEPA | JEPA | V-JEPA 自监督视频预训练 ViT(S/L) | ❌ 无 LLM,纯预测型表征 |
| DriveSuprim | coarse-to-fine | ResNet-34 / EVA-ViT-L(CLIP 蒸馏视觉塔) | ❌ 无 LLM |
| DriveLaW | 世界模型 | latent world 编码器 + DiT(非 VLM,纯世界模型流) | ❌ 无 LLM |
| LTF | 官方基线 | TransFuser 系 (ResNet 融合) | ❌ 无 LLM |
一眼可见:4 个 “VLA” 不是"视觉塔不同",而是"视觉塔上面叠加了一个 LLM(语言空间)"。视觉塔本身彼此同源——ResNet、ViT、甚至 EVA/SigLIP 这类 CLIP 蒸馏塔,VLM 里也在用。
14.2 先补个课:ViT 是什么?
上面一直在说"ResNet、ViT、视觉塔",但 ViT(Vision Transformer,视觉 Transformer) 这几个字对第一次看的人来说是最大的一道坎,这里用三句话说透:
它是什么:ViT 就是"把图像当句子读"的模型。把一张图切成固定大小的小块(比如
16×16像素一个 patch,224×224 的图切成 14×14=196 块),每块展平成一个向量,再像 Transformer 处理文字一样,让这些小块的向量互相做 自注意力(self-attention)——每个小块根据其他所有小块的信息更新自己,从而"看懂"整张图的上下文关系。公式上它和 GPT/大语言模型完全同一族(都是 Transformer),只是输入从"文字 token"换成了"图像 patch token"。为什么它重要:2020 年谷歌提出 ViT 时颠覆了 CV——以前图像必须靠 CNN(卷积,如 ResNet,滑窗扫描提取局部特征);ViT 第一次证明纯 Transformer 不用卷积也能达到同样水平,且越大越强、天然和 LLM 同构。这正是今天几乎所有 VLM/VLA 都选"ViT 系视觉塔"(DINOv2、CLIP/SigLIP、EVA 全是 ViT)而不是纯 CNN 的根本原因——图塔和语言塔同构,才能无缝拼进一个模型。
在本文里看到它的地方:DrivoR 的"DINOv2 初始化的 ViT-S"、Drive-JEPA 的 V-JEPA ViT、DriveSuprim 的 EVA-ViT-L,以及 4 个 VLA 内部嵌的视觉塔——全是 ViT。以及表格里出现的
ViT-S / ViT-L中的 S/L 指 Small / Large 两个尺寸档(参数量几十 M vs 几百 M),这套命名沿自语言模型。
一句话记忆:ResNet = 用"扫描仪"看图像(卷积),ViT = 把图像拆成词用"阅读理解"看(Transformer),而 VLM/VLA 全都站在第二条路上。
14.3 普通视觉 backbone 和 VLM 到底差在哪(说人话版)
把两者拆开,一共就三个差异:
“看"的部分其实差不多。不管是 ResNet、DINOv2 的 ViT,还是嵌入式在 VLM 里的 InternViT / SigLIP / EVA,干的都是同一件事:把图像 patch 编码成特征 token 序列。区别只在预训练方式不同——有的是监督分类(ImageNet 预训练 ResNet),有的是自监督(DINOv2、V-JEPA 自己跟自己比),有的是图文对齐(CLIP/SigLIP 让图塔和文塔空间对齐)。但这三者都属于”普通视觉 backbone",都不带推理。
区别的核心:有没有"语言空间"这个中间层。普通 backbone 的特征往下直接喂给动作头(回归/打分/扩散),中间产物是不可读的几何特征。VLM 则是在视觉塔和输出之间塞了一个在互联网级图文数据上预训练的 LLM——图像 token 和文本 token 一起进 LLM,LLM 既能"描述场景"(可读),又能"推理该不该动"(常识),最后要么吐语言决策、要么吐动作 token。
“预训练知识量"完全不同。ResNet/DINOv2 只在(相对)窄的图像/视频域上学特征;LLM 在大规模语言+图文上预训练,自带世界知识、常识、因果与规则理解。这就是 VLM 相对普通 backbone 唯一实在的"增量”:多了一个会推理、懂常识的大脑袋。
一句话:普通 backbone = 图塔;VLM = 图塔 + LLM。视觉能力来源可以一样,“会不会想"才是分界线。
14.4 VLM 就更好吗?——分数说明根本不是
把本文分数摊开,VLM 在开环 PDMS 上不但没赢,多数还更差:
- 无语言/无 LLM 阵营:TransDiffuser 94.85、CLOVER 94.5、DrivoR 93.7、Drive-JEPA 93.7、DriveSuprim 93.5、SparseDriveV2 92.0、iPad 91.7 —— 全线 91+,天花板 94.85。
- VLA 阵营:AutoVLA 89.1(+锚 92.1)、ReCogDrive 89.6/90.8、DriveVLA-W0 90.2 —— 最高也只有 90.8。
理由很硬:(1) 语言 tokenizer 是离散的,把连续轨迹切成 token 有量化误差,开环指标天然吃亏,ReCogDrive 的扩散头、EMMA 的坐标 token 苦难都是佐证;(2) LLM 又大又慢,推理/部署成本高;(3) 开环 PDMS 基本是"几何+规则"打分,不太需要常识,正是普通背书的强项。
所以 VLM 的战场不在开环排行榜,而在:
- 长尾/未知场景(没见过的障碍、烂天气、逆光——需要常识兜底而不是匹配训练分布);
- 可解释性与安全审计(能说一句"前方车道被雪覆盖,我沿车辙走"给规控/监管看);
- 闭环决策质量(跟车博弈、换道时机这类"靠想不靠抄"的能力)。 这正好是这篇 Bench2Drive / Cosmos 迁移评测该盯的地方——VLM 的"溢出"能力在分布外才体现,开环高分测不出来。
14.5 为什么叫 VLA 却不一定"说人话”?—— L 是训练遗产,不是运行义务
“VLA” 这四个字母(Vision-Language-Action)指的是架构声明:模型里有一个 LLM 骨干,哪怕推理时不吐一个语言 token。所以"名字带 VLA"≠“运行中在说人话”。L 的参与可以分三档,你拿这篇文章的 4 个模型就能对号入座:
| 等级 | L 参与方式 | 例子 |
|---|---|---|
| ① 显式 L | 推理时真的输出语言决策/CoT,“想给谁看就给谁看” | AutoVLA(慢思考模式)、DriveVLM 家族 |
| ② 隐式 L | 语言不用现形,但 LLM 在 token 层做隐性推理(隐式 CoT / 认知 token) | DriveVLA-W0(预测式 CoT)、ReCogDrive(认知 token) |
| ③ 遗产式 L | 只用 VLM 的预训练视觉塔+整体初始化,推理纯出动作 token,语言彻底不上线 | 相当一部分轻量 “VLA” 实际如此 |
关键认知:“VLA” 是"一个滑杆",不是"一个阵营"。L 的作用是预训练图文数据给的全局表示强度,而不是"推理时嘴巴动了没"。你甚至可以理解成:叫 VLA 的模型,本质是"图塔 + 一个能记常识的大模型 + 一条动作输出",L 参与几成是个工程选择。
14.6 那么 L 在自动驾驶里到底有什么用?(能说清的用途只有这几个)
- 导航指令跟随——“前方 300 米右转"这种自然语言指令,普通 backbone 根本没有入口,LLM 天然能解。
- 规则/常识注入——红灯停、让救护车、路权判断这类"文字级规则”,LLM 预训练里见过,SFT 一点就通。
- 长尾兜底与可解释性——模型可以"描述+推理+决策"三段式输出,出问题可归因、可对法规问责。
- 强迁移先验——海量图文预训练的表示,在某些分布外/域漂移场景的鲁棒性优于纯 ImageNet/自监督特征(这正是 Cosmos 迁移评测想验证的假设)。
- 慢思考/自适应——AutoVLA 用 GRPO 把"想不想"交给模型,让它"该想才想",是对部署成本的工程妥协。
而"L 的代价"也不含糊:token 自定义精度、慢、贵、开环分数被稀释——这也是为什么 ReCogDrive 会把动作交给扩散头、DriveSuprim/SparseDriveV2 干脆不走 LLM。
14.7 一句话理解框架(送给自己,也送给读者)
遇到任何模型先问三个问题:① 视觉塔是谁(ResNet / DINOv2 / CLIP系 / 视频自监督)?② 塔上面有没有 LLM(有语言空间 / 无)?③ 如果有,L 参与几成(显式 CoT / 隐式 token / 只有预训练遗产)?
用这套框架重新看本文 11 个模型:SparseDriveV2、iPad、DrivoR、Drive-JEPA、DriveSuprim、LTF 是"纯图塔队"(无非"自监督还是超分辨率塔"的区别);ChainFlow-VLA、AutoVLA、ReCogDrive、DriveVLA-W0 是"图塔+LLM 队",分水岭只在 L 参与几成;DriveLaW 是"不带 LLM 的世界模型队",独立一档。 这样再看那张 91+/93+ 开环高分表,就不会再困惑"VLM 怎么没霸榜"——它们在等分布外和闭环的考试,不在开环这一场。
15. 再补一个坑:感知到底在感知什么?“稠密 BEV"和"稀疏语义"是什么?为什么有的模型"只用相机”?
这个坑我掉进去过很久,趁这次把它彻底填平。你的疑惑我复述一遍:“大家好像都有’感知’,但有的稠密 BEV、有的稀疏语义,有的又搞检测/建图/运动预测/占位一堆任务,有的却只用相机就完事——感知到底是为了得到什么?它们之间是什么关系?”
先说结论:你把三条不相干的线捆在一起了,它们其实是三件独立的事——① 用什么传感器看(输入)、② 脑子里用什么结构表示场景(中间表示)、③ 显式吐出哪些理解结果(输出任务)。 下面一条条拆。
15.1 第一条线:传感器(输入)——“只用相机"是指这个
- camera-only(纯视觉):只吃摄像头图像,如本文 11 个模型全部如此。图便宜、图泛化、图能"看到颜色/文字/语义”。
- camera + LiDAR:再加激光雷达点云。几何精确(直接给 3D 距离),但贵、怕雨雪、缺语义(不知道"那是一块没信号的牌子")。
- LiDAR-only / 多模态:工程车量产更常见,评测榜少见。
关键澄清:“只用相机"说的是输入通道,不是"不需要感知”。相机照样要感知——只是感知的难度更高(要从 2D 像素猜 3D 距离)。别再以为"只用相机=没有感知"。
15.2 第二条线:中间表示——“稠密 BEV” 和 “稀疏语义” 是两种"脑子里的地图"
这是你问题里最大的坎,也是核心。所有感知模型都要回答同一个问题:“把多路相机的 2D 像素,变成’模型好用的场景表示’”。答案分两大流派:
稠密 BEV:把世界摊成一张"格子纸"
- 全名:Dense BEV(Bird’s Eye View,鸟瞰图)。就是把自车周围(比如前后各 50m、左右各 50m)的矩形区域划成一个个规则小格子(如 200×200,每格 0.5m),每个格子里存一个特征向量,表示"这个位置有什么"。
- 怎么做(两种主流做法):
- LSS(Lift-Splat-Shoot)派:先把每个像素"抬升"成一根根视锥线(猜测深度),再按外参把这些视锥线"摊"到地面上对应的格子里(splat),同格累加得到特征 → 一张
200×200×C的稠密特征图。 - BEVFormer 派:不逐像素抬升,而是每个格子学一个"查询"(query),靠可变形注意力去多相机图像上采样自己要看的东西,再按时序自注意力融合上一帧 → 同样得到
200×200×C稠密特征图。
- LSS(Lift-Splat-Shoot)派:先把每个像素"抬升"成一根根视锥线(猜测深度),再按外参把这些视锥线"摊"到地面上对应的格子里(splat),同格累加得到特征 → 一张
- 特点:像地图一样铺满全场——每个位置都有格子,天然适合"哪里能走/哪里被占"这种位置问答;一格一信息,密集但算力按面积平方涨,远处格子往往是浪费。
稀疏语义 / 稀疏查询:只要"重要的点"
- 全名:Sparse Queries / Sparse Tokens。不再铺满格子,而是只维护 N 个"有意义的点"(N 通常 100~900 个),每个点是一个可学习 query,代表"一个潜在的物体/车道线/区域中心"。
- 怎么做:像 DETR 那样,用 N 个初始化 query 在图像特征上做注意力,逐步"收敛"到 N 个真正的物体上;每个 query 自己带位置、类别、状态,且能跨帧持续追踪同一个对象(自带 ID)。
- 代表:Sparse4D、SparseDrive、DrivoR 的 register token。
- 特点:算力跟"场景里有多少东西"成正比,而不是跟"场地面积"成正比;但问题在于——它必须先"猜"哪里有东西(靠 query 迭代),网格之外没 cover 到的地方可能漏检。
一张表分清
| 维度 | 稠密 BEV | 稀疏语义/query |
|---|---|---|
| 场景表示 | 规则网格,每个格子一个特征 | 离散 N 个可学习 query |
| 算力 | 跟场地面积平方走 | 跟场景物体数走 |
| 优势 | 全覆盖、好做"位置问答"、省脑筋 | 高效、自带实例 ID、跨帧稳 |
| 劣势 | 远格子浪费算力、网格分辨率死板 | 要"猜哪里有东西",可能漏 |
| 代表 | LSS、BEVFormer、UniAD/VAD 的感知层 | Sparse4D、SparseDrive、DETR 系 |
记忆钩子:稠密 BEV 像"铺满全城的监控摄像头"(哪里都看,浪费但稳);稀疏 query 像"只派探子盯着关键目标"(省力但要探子找得到)。
15.3 第三条线:输出任务——检测/建图/运动预测/占位,它们是从哪来的?
这是你第二个坎:“为什么有的信息从稠密 BEV 得到、有的从稀疏语义得到?”
答案是:任务本身对"位置型 vs 实例型"的需求不同,选择什么表示最顺手就用什么——两边常常混用。
| 任务 | 它要回答什么 | 稠密 BEV 的玩法 | 稀疏语义的玩法 |
|---|---|---|---|
| 检测(物体在哪) | 前方有车/人/桩,框在哪 | 在稠密特征图上做 anchor/heatmap 回归 | query 直接回归每个框(DETR 路线) |
| 建图(道路结构) | 车道线、路沿、中心线形状 | 每个格子分类"是否车道线"→连线成图 | 专门的 map query 直接生成折线 |
| 运动预测(别人会去哪) | 旁边那车未来 3 秒轨迹 | 占位流:稠密预测"每个格子未来有没有东西在动" | 对每个实例 query 出 K 条轨迹 |
| 占位/占用(occupancy) | 每个体素/格子未来有没有障碍 | 天生就是稠密的——逐格预测被占概率 | SparseOcc 类用稀疏 query 预测稀疏占用 |
| 规划(我开哪) | 未来 3 秒自车轨迹 | 稠密特征做 cost / 打分 | 稀疏特征做打分 / 生成 |
重点:不是"BEV 只能出检测、稀疏只能出轨迹"——两边都能出任何任务,只是哪个更顺手。稠密擅长"哪里被占"(占位几乎必须稠密);稀疏擅长"每个个体是谁、持续盯它"(追踪/多模态轨迹)。所以像 SparseDrive 这类模型其实是"稀疏为主体",但为了算运动/占用也常悄悄再补一点稠密/网格结构。
15.4 那感知到底"为了得到什么"?——把它想成"给规划端一个可用的世界理解"
剥掉任务名,感知统一在做一件事:
把"几路摄像头的 2D 像素 + 自车运动状态"压缩成一份"模型能用来做决策的世界理解"——这份理解至少要回答:车在哪、路在哪、谁要动、哪里能走、危险在哪。
- 有了它,规划头(不管打分/扩散/VLA)才有东西可以"想"。
- 有的模型显式把这理解拆成可读任务(检测框、车道线、轨迹、占位——比如 UniAD、SparseDrive),好处是可解释、可分开调、可审计,坏处是模块串行可能出错。
- 有的模型隐式不吐出任何任务,直接在"图像→轨迹"之间自己学出这层理解(比如 DrivoR、大部分扩散/VLA 模型),好处是简单、端到端、少误差累积,坏处是你看不到它到底理解了啥(黑盒)。
所以"有的感知复杂、有的简单"不是理解深度不同,而是"把理解显式吐出来 vs 藏在网络内部"的工程选择不同。 理解一定都在,只是可见不可见。
15.5 回到本文 11 个模型,把这三条线标清楚
| 模型 | 传感器 | 中间表示 | 显式感知任务 |
|---|---|---|---|
| SparseDriveV2 | 相机 | 稀疏 query 为主 | 显式(感知-规划联合,路径+速度打分) |
| iPad | 相机 | 介于两者(proposal 中心 BEV) | 显式(proposal 迭代即预测) |
| DrivoR | 相机 | 稀疏(ViT 特征→register token) | 隐式(无显式任务输出) |
| ChainFlow-VLA | 相机 | 稀疏视觉 token + VLM | 隐式 |
| AutoVLA | 相机 | 稀疏视觉 token | 隐式 |
| ReCogDrive | 相机 | 稀疏认知 token + 扩散 | 半显式(认知 token 即理解) |
| DriveVLA-W0 | 相机 | 稀疏视觉 token + 世界模型 | 隐式(世界模型预测未来) |
| Drive-JEPA | 相机 | 稀疏(V-JEPA 自监督特征) | 隐式 |
| DriveSuprim | 相机 | 稀疏(图像特征→轨迹选择) | 隐式 |
| DriveLaW | 相机 | latent world(隐空间) | 隐式 |
| LTF | 相机 | TransFuser 融合(BEV 风格) | 半显式(辅助任务) |
15.6 给你的最后一张图(一个统一的视角)
三个"为什么"一句话收尾:为什么有的稠密有的稀疏?——因为"格子纸"适合位置问答、“探子"适合实例追踪,按任务挑。 为什么有的显式一堆任务有的啥都不吐?——因为显式可审计、隐式更简洁,是工程取舍。 为什么都"只用相机”?——那只是说输入只用相机,感知该有的理解一个不少,只是更难罢了。
本文基于 2025-2026 arXiv 原文、官方仓库与 NAVSIM 官网数据整理,所有分数以论文原文为准(不同论文同一基线存在 ±0.2~1 的统计差异)。数据截止 2026 年 8 月。